1. 问题与动机
一句话:WeGR 让一个小型生成模型根据用户的搜索词,直接“写出”商品的编号,用它替掉微信电商搜索里一大部分传统召回通道。
传统电商搜索像一条流水线:倒排索引、向量检索等几路召回各自捞一批候选,合并后再交给粗排、精排逐层筛选。每多一路召回,就多一份维护成本,后面的粗排也要多算一批商品。生成式召回换了个思路:给每个商品分配一串短的离散编码,叫语义 ID(Semantic ID,下文简称 SID),然后让模型像写句子一样逐个生成这串编码。生成出来的编码对应哪件商品,就召回哪件。
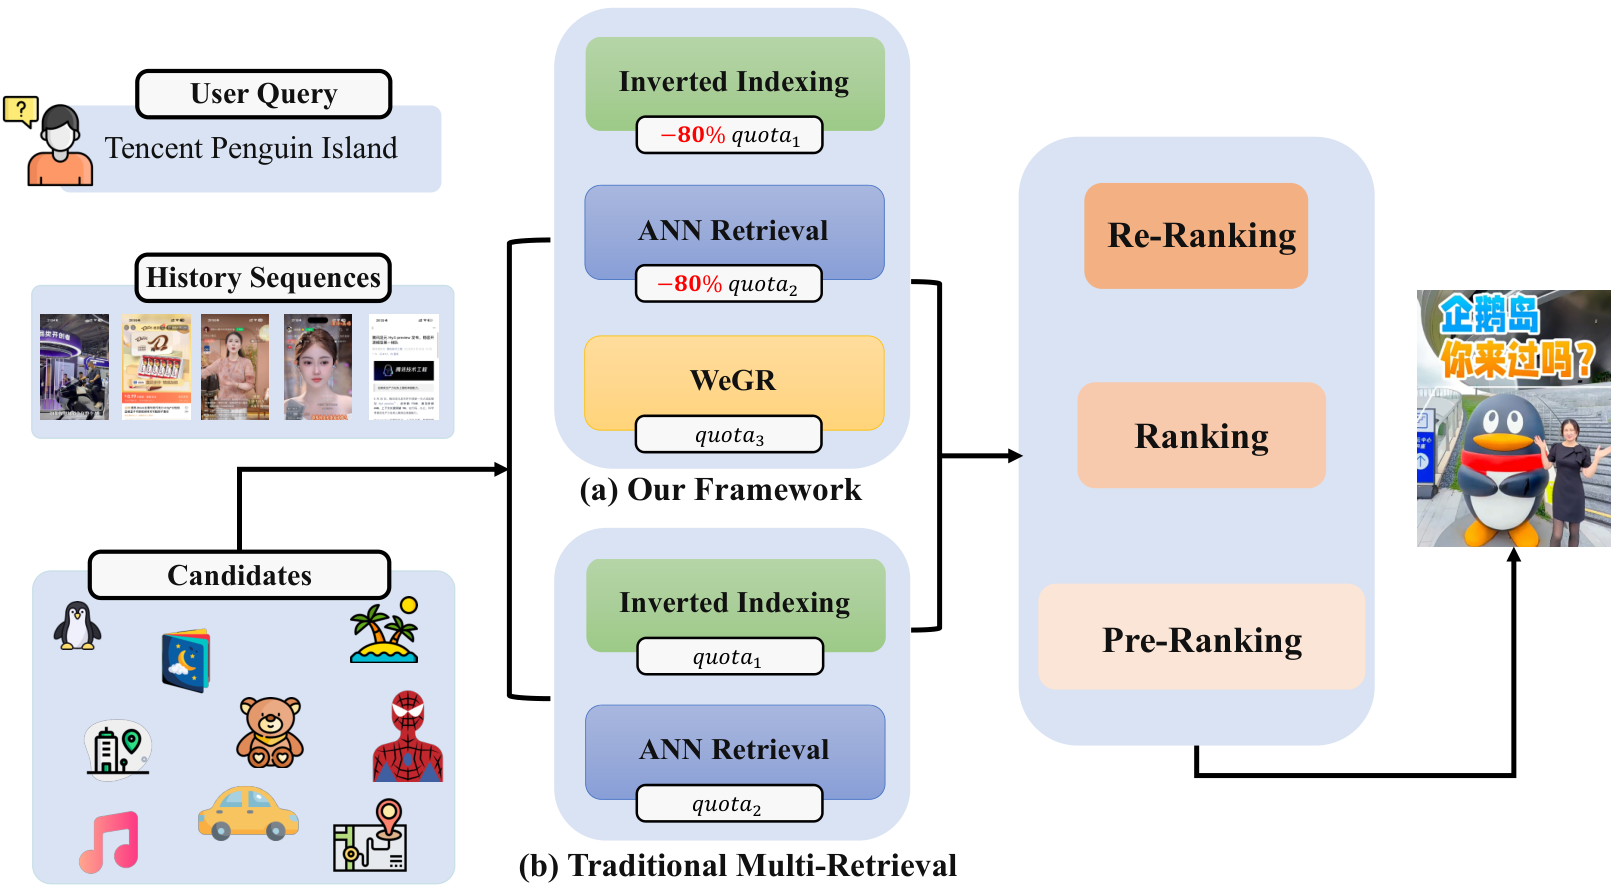
作者认为这条路要走通,得先解决两个问题。
第一,编号本身要好。SID 一般靠逐层聚类得到。如果只按商品文本聚类,“经常被一起点击”这类行为信息就进不来;如果端到端地学,又容易出现大量编码几乎没人用的情况,作者称之为码本坍缩。编码用不满,相似商品就挤在同一个编号下,模型很难分清。
第二,强化学习的奖励太稀疏。用户点了某件商品,模型只有把整串编码完全写对才拿得到奖励。采样 8 次很可能一次都不中,这一组样本就学不到任何东西。
2. 方法:先把编号做好,再用反馈慢慢教
整体框架分两块,见下图。上半部分是编号器 CoCo-VAE,下半部分是训练策略 DHPO。
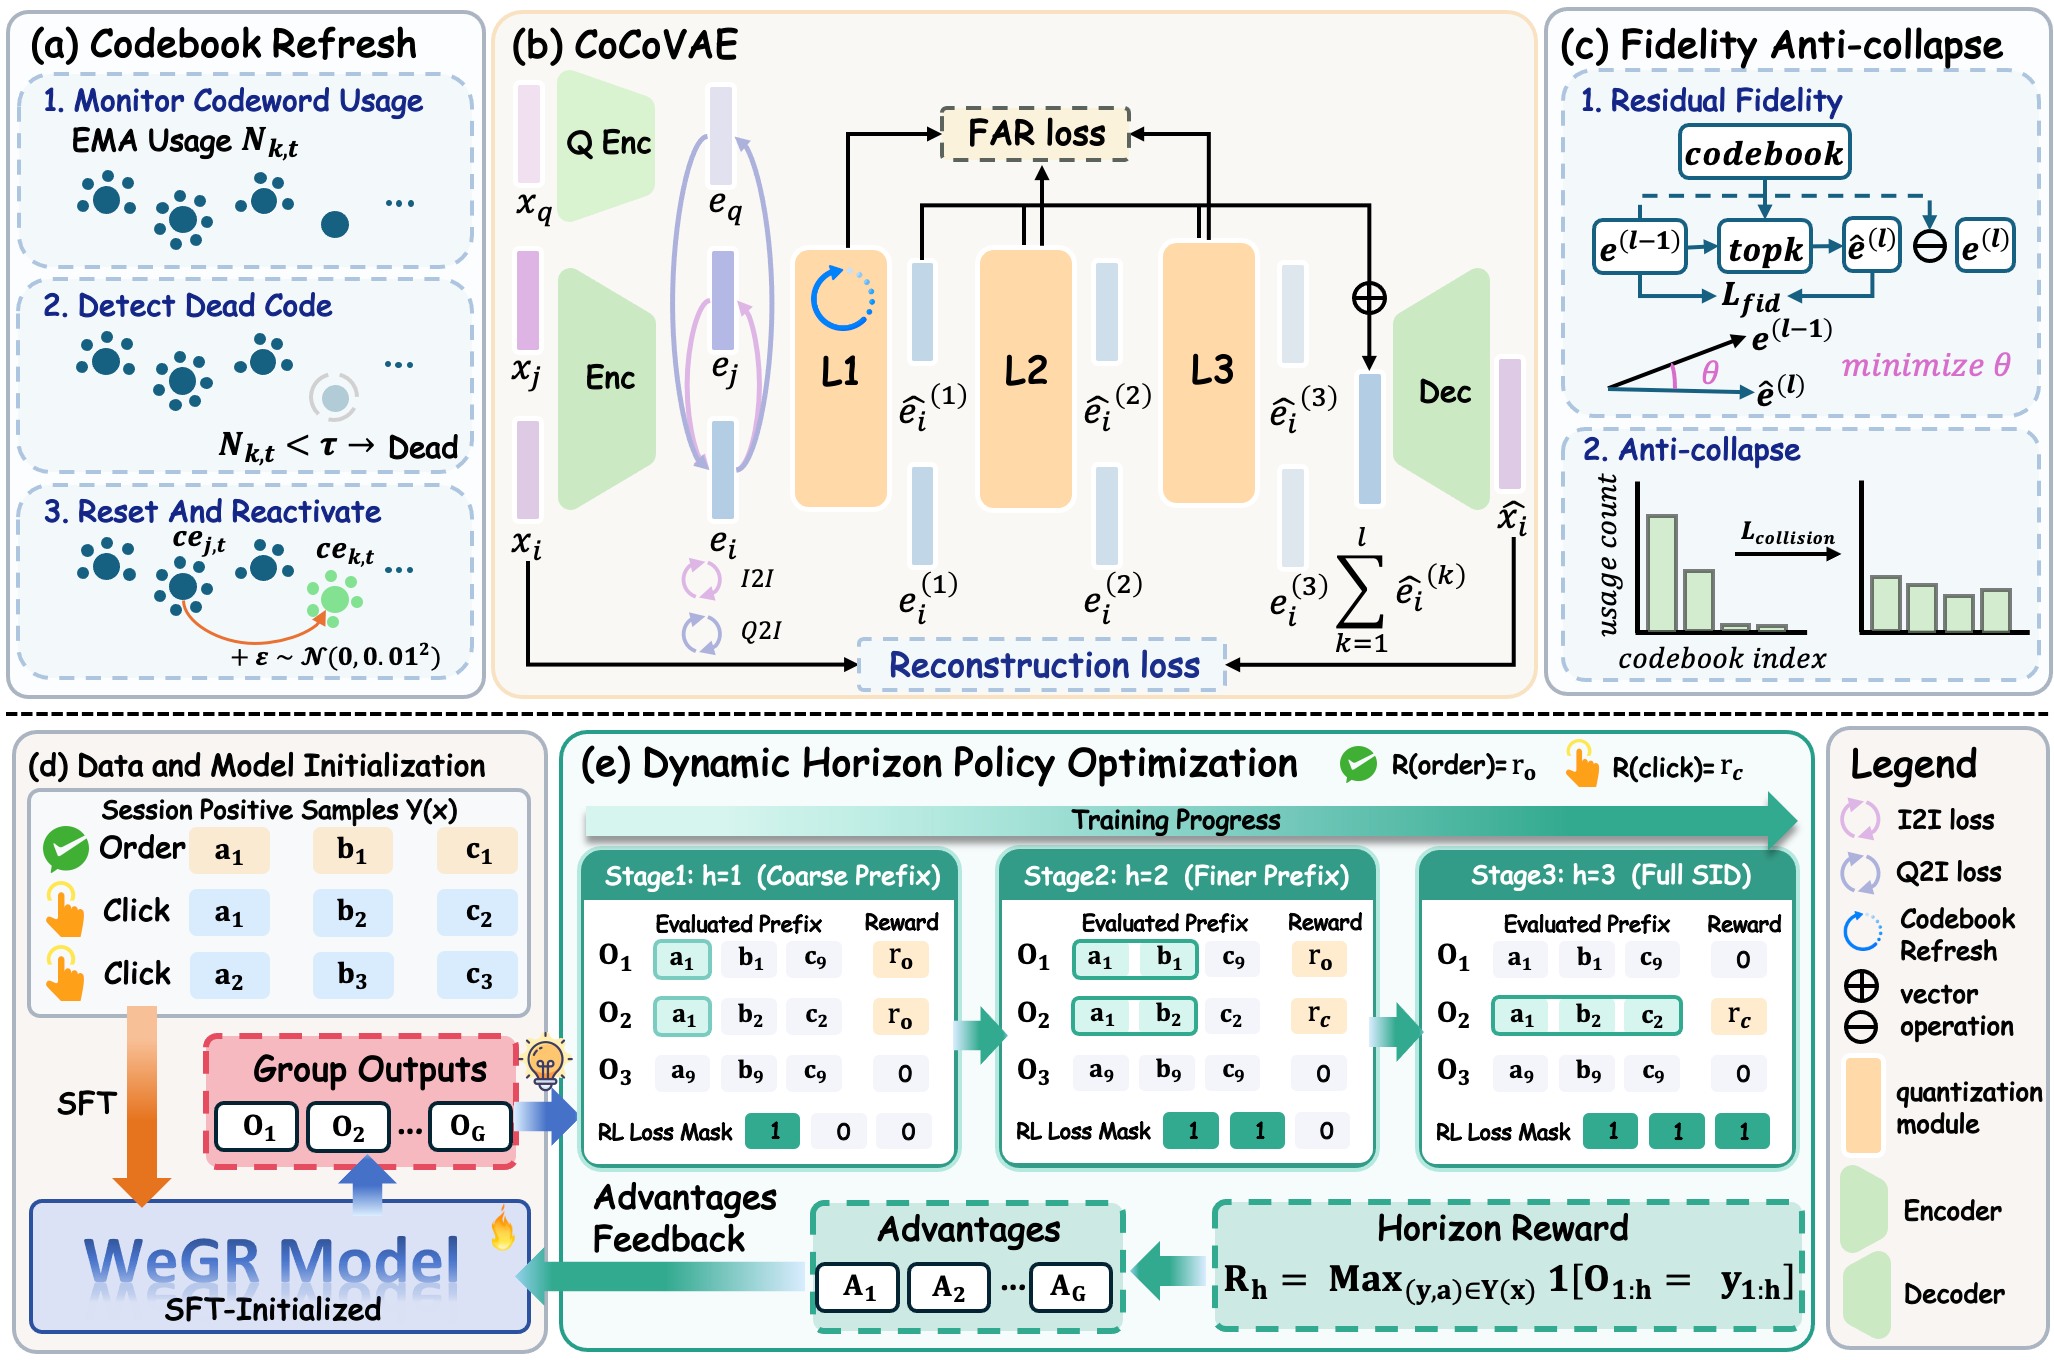
编号器 CoCo-VAE。 它用三层残差量化给商品编号:第一层定大类,后两层逐步细分,三层码本大小分别是 16384、128、128。行为信号只在连续向量阶段加入:同一个搜索词下被点击的商品、经常一起被点的商品,向量会被拉近。作者特意没有在离散编码上强迫它们共用编号,怕把本来不同的商品硬塞到一起。
为了让编码用得均匀,作者做了两件事。一是码本刷新:只在第一层,统计每个编码最近的使用次数,长期闲置的就用活跃编码加一点噪声重新初始化。之所以不动后两层,是因为深层频繁重置会打乱残差分解。二是防坍缩正则:一项要求量化后的结果尽量还原原始向量,另一项惩罚不同商品落到同一编码上的概率。
生成模型。 骨干是 GPT-2 Small。选这么小的模型,是为了满足线上延迟。
训练策略 DHPO。 这是文章最有意思的部分。它的想法很朴素:整串写对太难,那就先只检查第一个码。只要生成的第一个码和用户真正点过的某件商品对得上,就给奖励,点击记 1 分,下单记 2 分。训练每过 300 步,检查的长度加 1,直到覆盖完整编码。
这里有个关键细节:奖励只确认了前 h 个码是对的,所以模型也只更新这 h 个位置,后面没被验证的部分不动。否则模型会把“大类猜对了”误当成“整件商品猜对了”。此外,作者还加了一项多正例监督学习:同一次搜索里用户点过的所有商品都当作正确答案。这样即便一组采样全没中,模型也还有稳定的学习信号。线上每天先做一轮监督学习,再做强化学习。
3. 核心贡献
- 编号器把行为信息和编码均衡放在一起解决。 离线实验中,点击 HR@6(前 6 个结果里命中用户点击的比例)从最强基线 RQ-Kmeans 的 0.2641 提到 0.2759。
- 奖励检查范围和参数更新范围同步变长。 这样做不需要额外训练一个打分模型。作者解释,打分模型是在旧召回结果上训出来的,对生成模型新探索到的长尾商品不一定靠谱。
- 监督学习给强化学习兜底。 后面的消融会看到,少了这一项,强化学习反而会把模型越训越差。
4. 实验结果
离线数据来自 2026 年 6–7 月的微信电商搜索日志,共 31 天,前 30 天训练,最后一天测试。
| 方法 | 点击 HR@6 | 订单 HR@6 |
|---|---|---|
| RQ-Kmeans + 监督学习 | 0.2641 | 0.4051 |
| CoCo-VAE + 监督学习 | 0.2759 | 0.4103 |
| 直接用 GRPO | 0.2588 | 0.3910 |
| GRPO + 多正例监督 | 0.2764 | 0.4160 |
| DHPO | 0.2810 | 0.4217 |
最值得注意的是第三行。直接套用 GRPO 这种常见强化学习方法,结果比只做监督学习还差。原因就是前面说的奖励稀疏:大多数采样拿不到分,模型学到的主要是噪声。加上多正例监督后效果回升,再加上动态视野又往上提了一截。
编号器的消融也说明了问题。去掉“还原原始向量”那一项,点击 HR@6 掉到 0.2437,比去掉任何一种行为信号都伤得重。换句话说,行为信息再多,编码空间本身不健康也白搭。
线上 A/B 测试从 6 月 22 日跑到 8 月 4 日,分三个版本逐步推进。V1.0 只是把 WeGR 作为新的一路召回加进去;V1.1 和 V1.2 则分别砍掉其他召回通道 60% 和 80% 的候选。结果是砍得越多,效果越好。V1.2 订单量提升 2.539%。
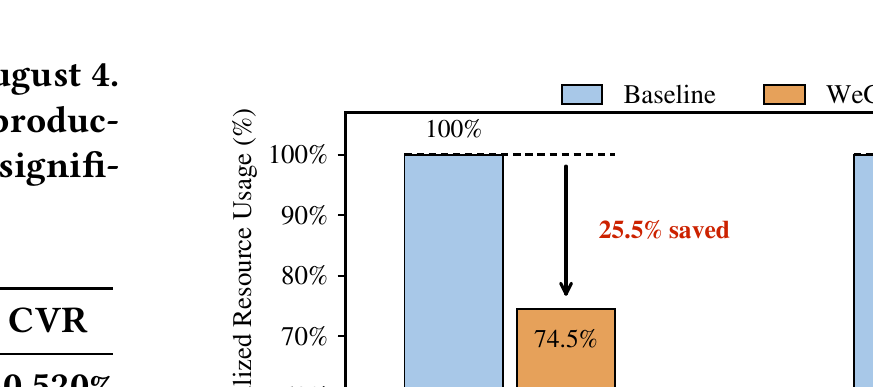
资源方面,进入粗排的候选减少了约 38%,CPU 和 GPU 都省下四分之一左右。省下的比例小于候选减少的比例,因为请求解析等固定开销还在。
5. 局限
论文没有单独的局限性章节。作者自己提到,不同频次搜索词的收益差别很大,原因还没搞清楚:中频词的点击率有提升,订单却基本没变。另外,直播搜索上的迁移实验只验证了 DHPO 这一个环节,不代表整套系统都能直接搬过去。
还有几点论文没交代清楚:训练样本量、batch size 和硬件都没公开;离线数据的时间窗口和线上实验有重叠,外部读者没法独立核对。
6. 对我们有什么用
最值得带走的是 DHPO 的思路。只要你的物品 ID 是分层的,就可以先在粗粒度上给奖励,再逐步细化,并且只更新已经被验证的部分。这在内容社区里同样成立:先学会召回对的话题,再学会召回对的帖子。
另一个启发在上线节奏上。WeGR 没有一上来就替换旧系统,而是先作为一路召回并行跑,确认有效后再一步步削减旧通道的配额。帖子的生命周期比商品短得多,编号多久重建一次、重建后线上索引怎么平滑切换,是社区场景要额外想清楚的问题。