目录 · 6 节
1问题与动机:一段历史,为什么要反复算2方法:共享历史,保留候选自己的判断3核心贡献:算力分配和复用边界一起设计4实验:效果与效率要分别看比较对象5局限:状态维护并非免费6工业实践意义:先找到重复计算在哪里把用户历史提前算成一份可复用的记忆,每个候选再按自己的需要读取,推荐模型就能少做大量重复计算。LinkedIn 的 TransX 围绕这条思路,同时改模型和训练、服务系统。它讨论的不只是长序列怎样处理得更快,还包括新增算力究竟应该放在哪里。
1. 问题与动机:一段历史,为什么要反复算
同一用户一次请求里会出现很多候选,相邻请求又往往共享大部分历史。如果模型把历史和当前候选绑在一起处理,历史越长、候选越多,重复工作就越大。直接增加模型容量,会把更多计算压进必须快速返回的线上链路。
另一种做法是提前算好用户向量。但单一向量可能把不同兴趣揉在一起,难以回答某个具体候选与哪些行为有关。TransX 保留一组可供读取的行为记忆,让历史处理可以共享,又让每个候选保留自己的读取方式。
这里有两个相关但不同的问题:哪些计算可以复用,新增计算放在哪个模块更划算。作者将模型拆成三个部分,分别研究编码器、记忆容量和候选融合的收益,而不是只报一个模型总规模。
2. 方法:共享历史,保留候选自己的判断
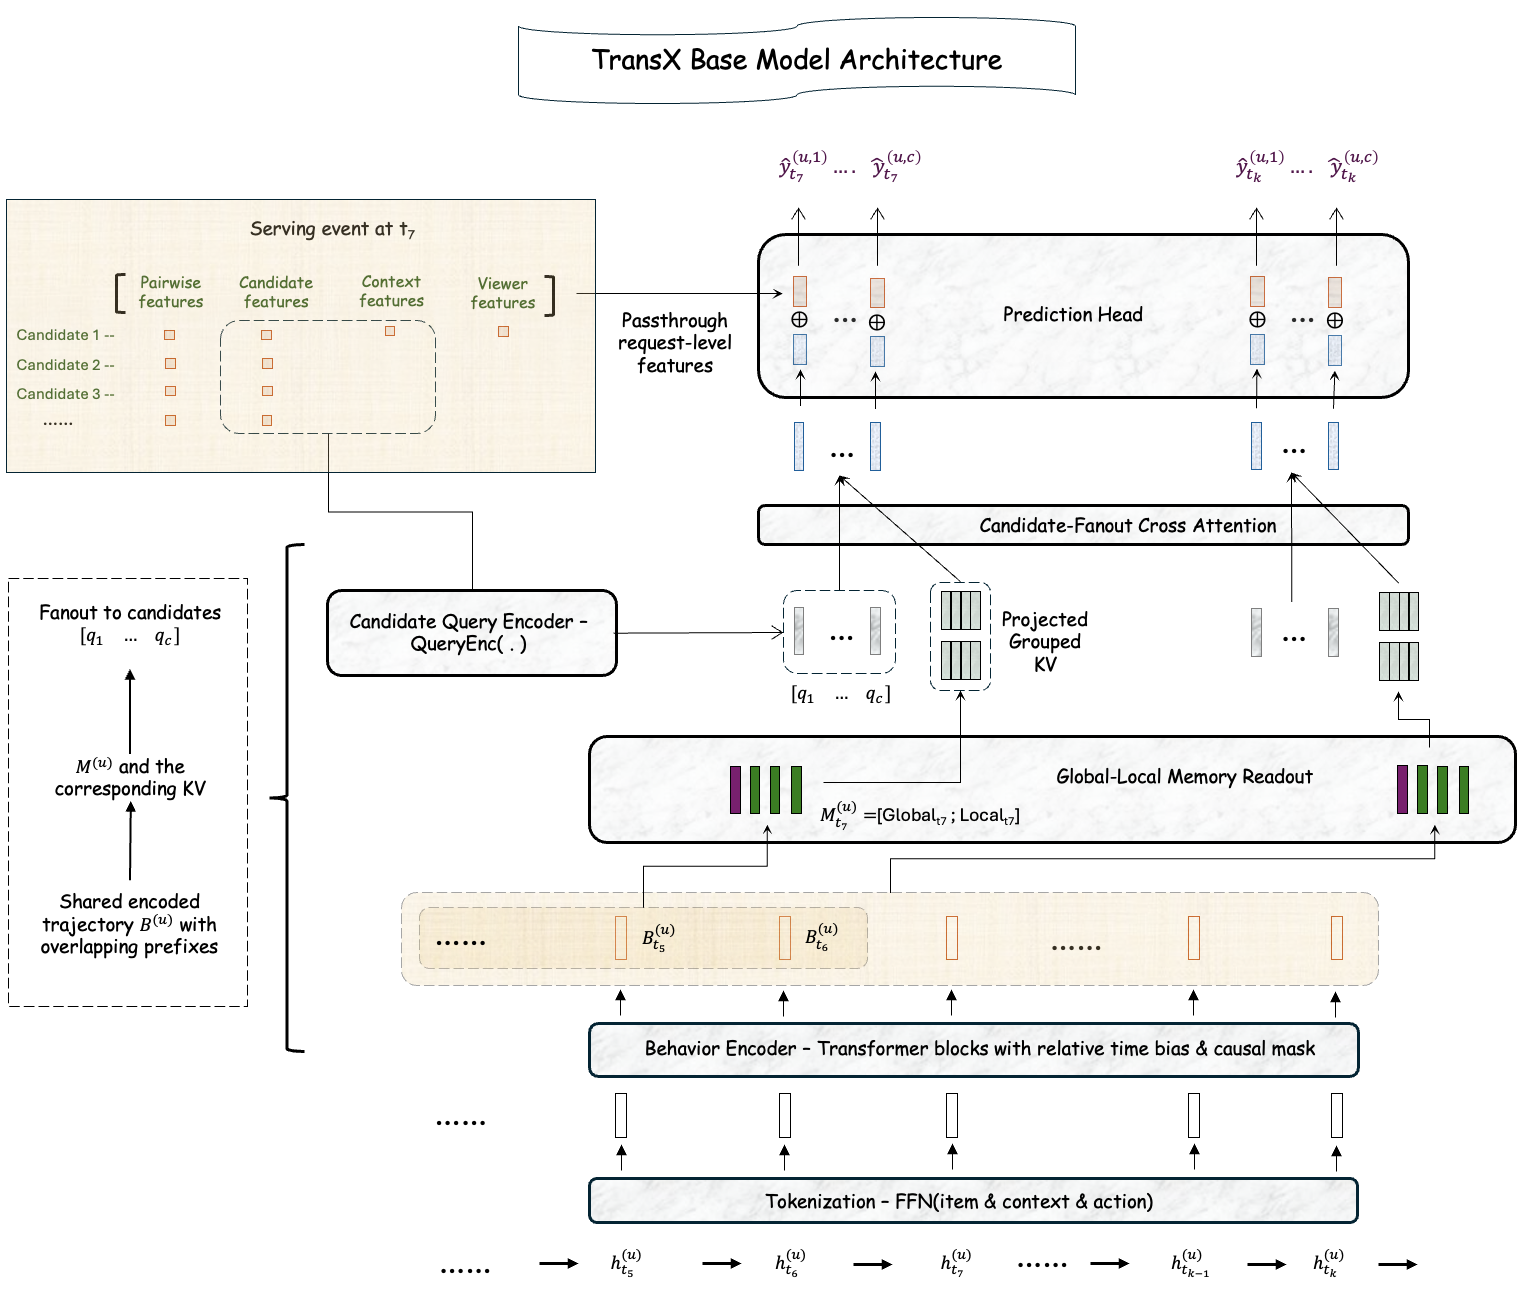
首先,因果编码器按时间处理行为。因果意味着预测某次曝光时,只能看到当时已经发生的行为。训练可以共享一条轨迹的计算,但不能把之后的点击泄露到之前的样本中。论文把每次请求对应的时间截点作为状态提取边界。
其次,系统在边界处构造全局与局部相结合的记忆。局部部分保留最近的行为,全局部分概括更早的历史。这样,读者可以把它理解成“近期明细加长期摘要”,而不是把长历史粗暴截短。记忆被投影成键和值,供后续注意力读取;这就是文中反复出现的记忆 KV。
最后,每个候选生成自己的查询,读取同一份记忆。候选之间共享历史表示,却不必共享最终兴趣判断。融合层可以多次读取,让候选逐步聚焦相关行为,再把结果与预测特征一起交给点击、转化等输出头。
训练也遵循相同边界:同一条行为轨迹只编码一次,在多个请求截点提取不同的记忆,再分给各自候选。候选损失的梯度汇总回共享轨迹。这种复用与在线缓存不同,它减少的是训练中重叠历史的重复计算。
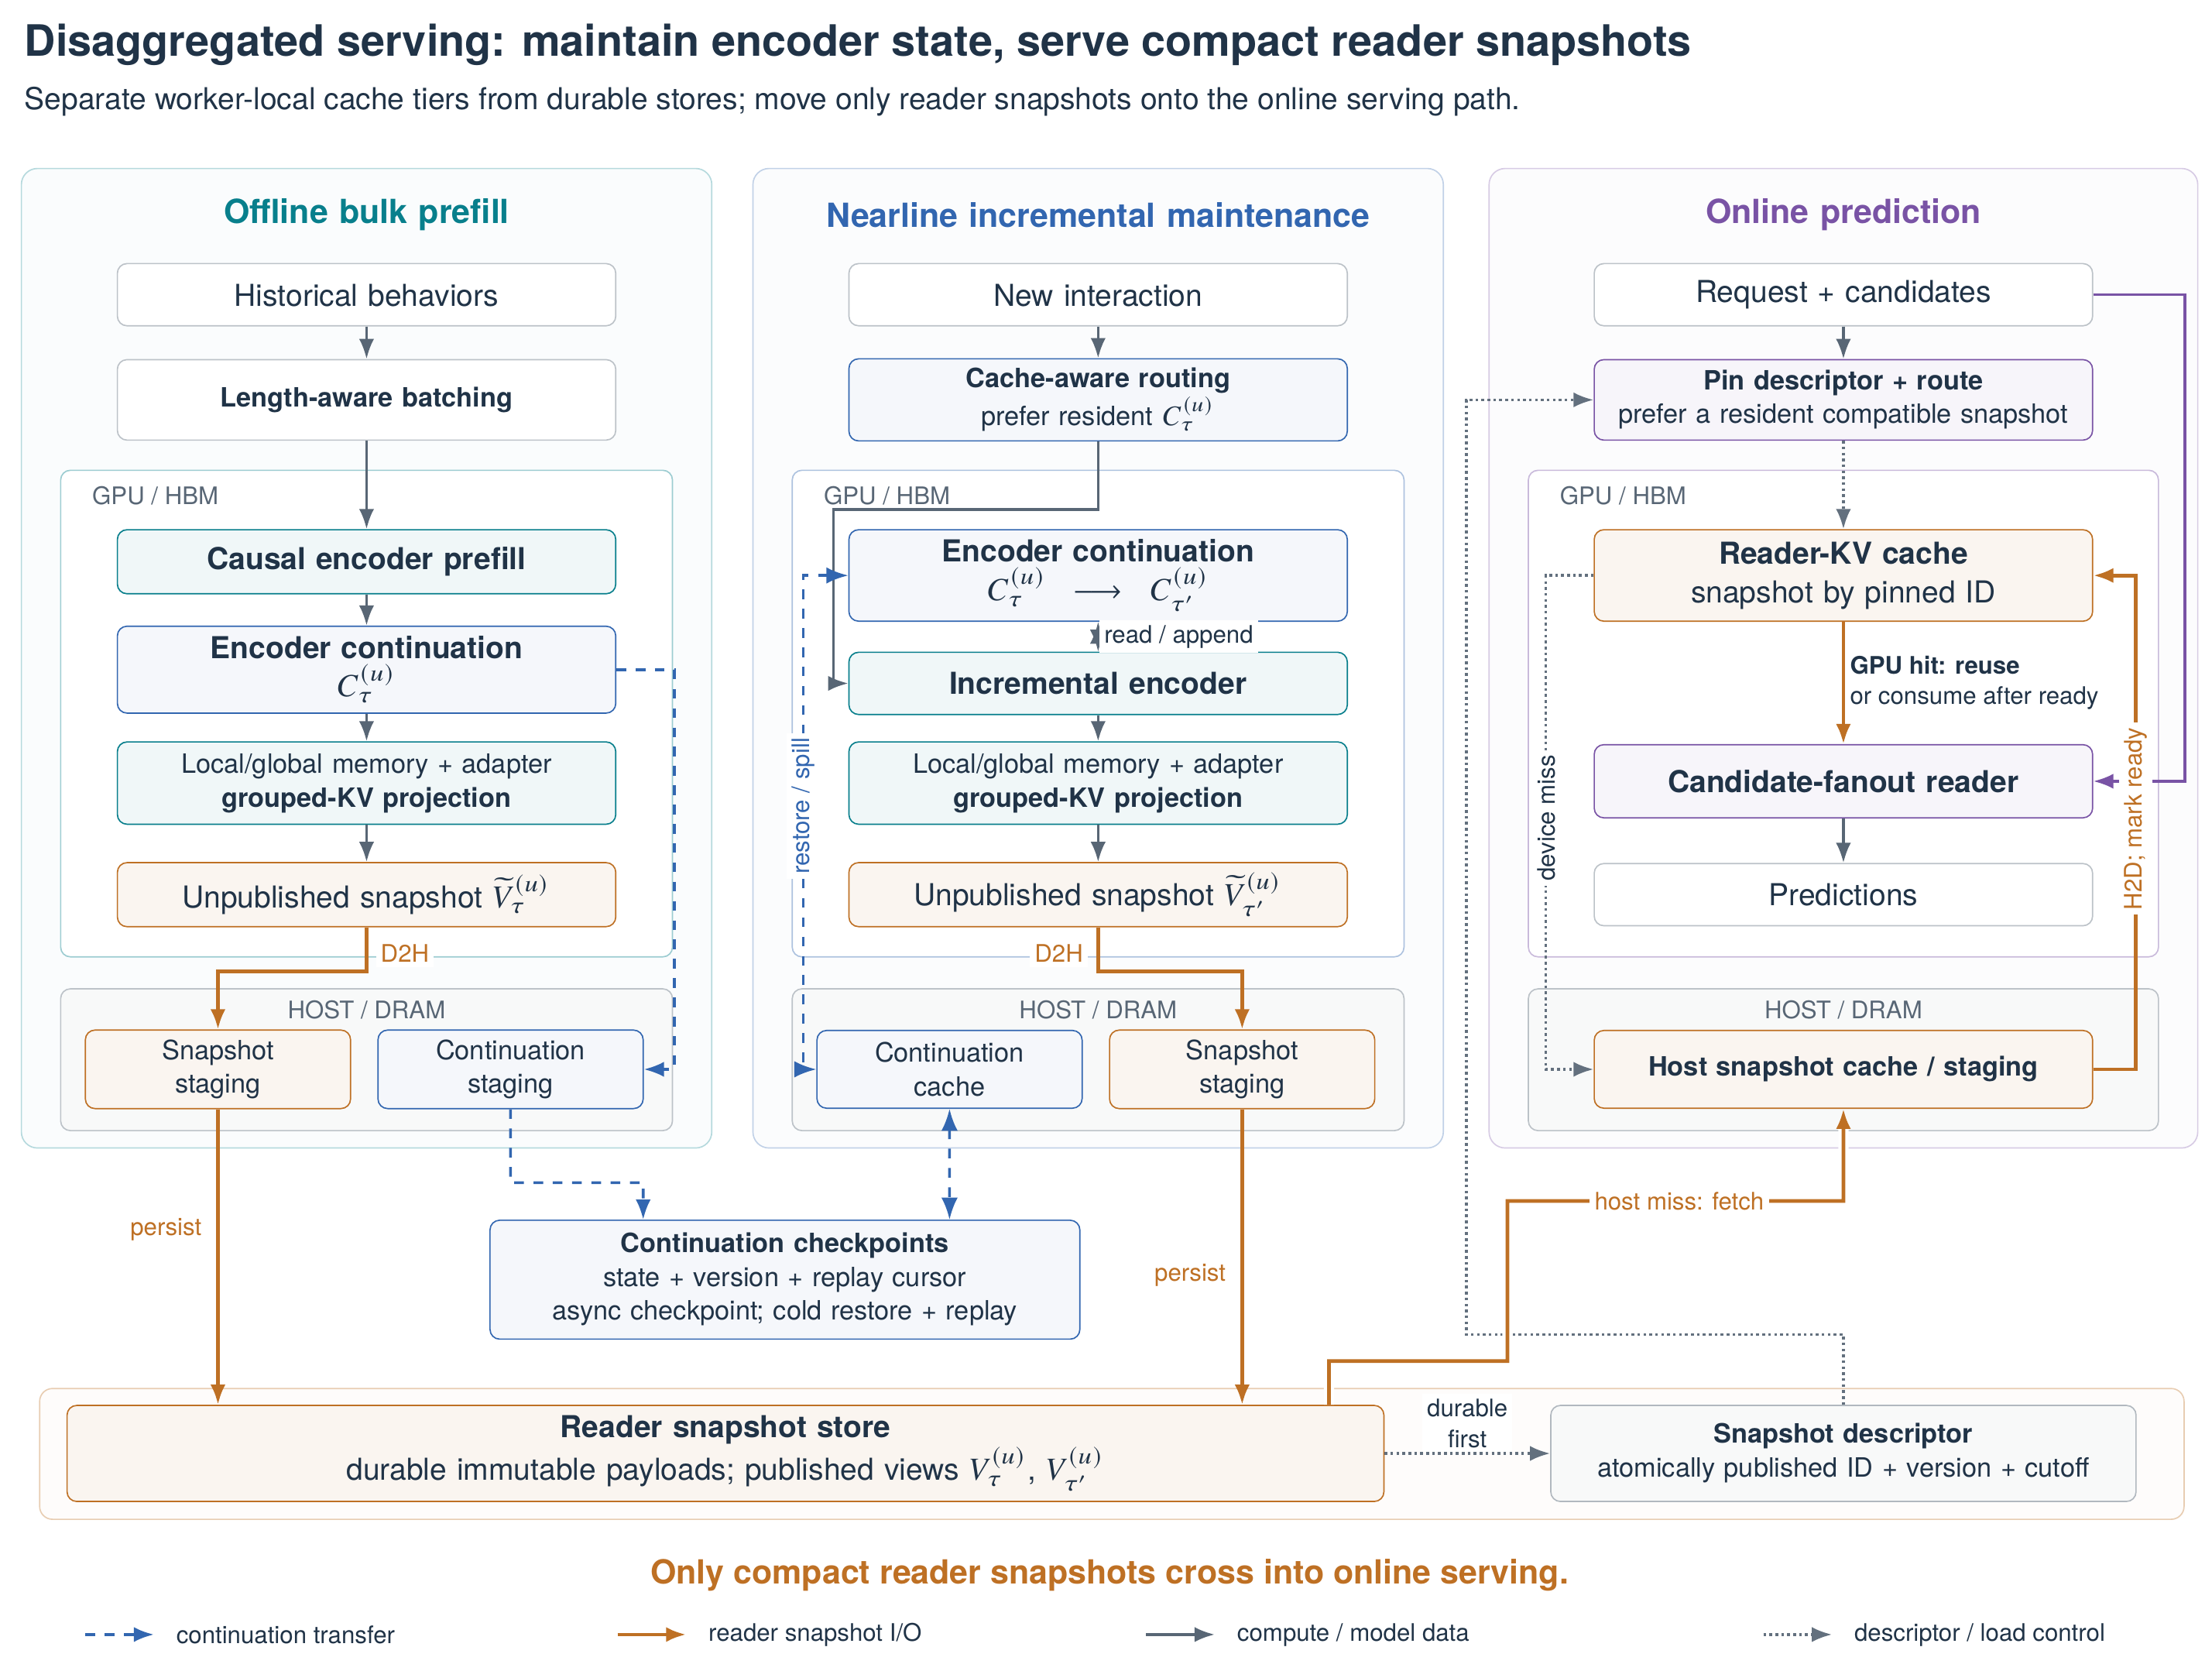
服务分成三个时钟。离线任务吞吐优先,负责批量预填充;近线任务跟进行为变化,推进编码状态并发布新记忆;在线请求只取兼容的记忆快照,完成候选融合和预测。近线编码器的续算状态,与线上读出的行为记忆不是同一个对象,前者不能直接当作线上缓存。
不可变快照是这个分工能落地的关键。请求读取时固定一个版本,更新任务随后发布新版本,也不会把正在打分的请求切到半新半旧的状态。由此,状态兼容、回收和缓存命中成为模型正确性的一部分。
3. 核心贡献:算力分配和复用边界一起设计
论文最有价值的观察,是不同模块扩容的收益并不相同。在记忆分辨率与融合能力固定时,编码器加深可能很快收益递减。监督更充分时,把计算分配给候选融合往往更有吸引力。这是论文研究条件下的经验,不是适用于所有推荐系统的普遍定律。
第二个观察是,模型变大并不必然要求同比扩大记忆分辨率。记忆接口能保持相对紧凑,意味着更重的历史编码可以留在后台,而不强迫每个在线请求搬运更大的状态。这个接口同时决定了模型表达、网络传输与缓存成本。
同一记忆还可以服务不同任务。作者从点击和转化预训练出发,再训练面向召回和偏好排序的读取器、输出头。生成式召回与列表生成也有离线探索,但本文的线上结论只属于基础、召回和排序三个生产变体。
4. 实验:效果与效率要分别看比较对象
| 对照范围 | 观察项 | 原文结果 |
|---|---|---|
| 基础模型对生产 HSTU | 点击率相对变化 | +6.02% |
| 召回变体对生产召回模型 | 点击率相对变化 | +2.96% |
| 排序变体对生产排序模型 | 转化相对变化 | +1.33% |
| 相同训练条件,对朴素 FSDP | 监督目标吞吐 | +84% |
| 相同流量和服务目标,对共置服务 | 总服务成本 | 降低近 80% |
前三行来自独立线上实验,控制组和产品触点各不相同,不能把这些数当作变体间的直接排名。基础模型还有持续五周的保留组观察,作者报告收益得以维持。论文按历史丰富度分组后,也观察到不同用户群都有正向结果。
成本比较尤其容易误读。“降低近八成”比较的是同一框架的解耦服务与共置服务;它不同于对生产模型的点击率比较。论文还做了匹配每请求计算量的对照,在质量接近时获得更高的硬件吞吐。这些实验分别回答模型效果与计算复用的问题。
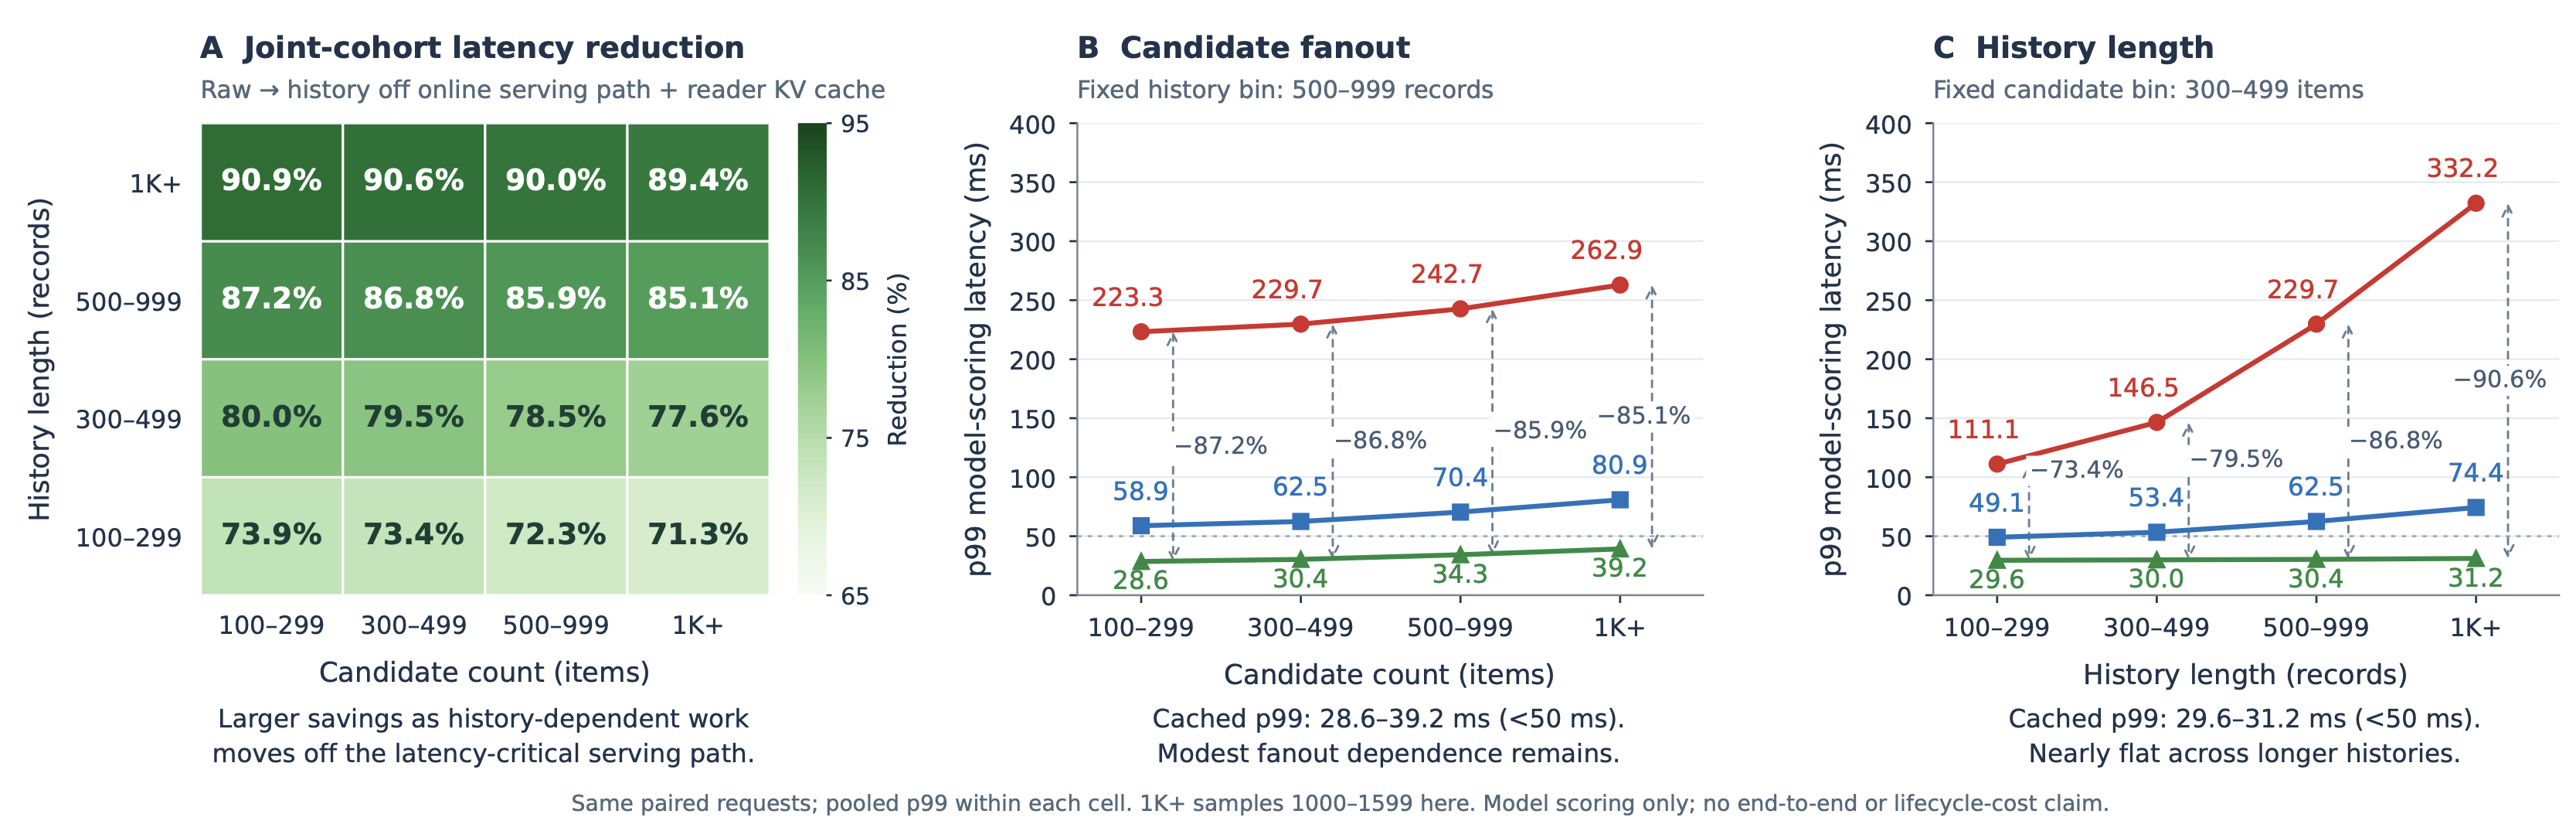
图中最值得看的是曲线形状。历史从短变长,缓存后的延迟不再跟着明显上升;候选数增加,融合计算仍会增加。这与架构的计算边界吻合:重历史处理已经移走,候选相关工作依旧留在线上。
新鲜度实验说明缓存并非没有价格。记忆越陈旧,点击收益会下降;近线更新滞后要作为独立服务指标。单看 GPU 利用率或缓存命中率,不能说明用户最近一次行为是否及时影响排序。
5. 局限:状态维护并非免费
作者明确指出,扩容规律依赖数据、监督密度、架构族和部署范围。实验无法证明某种模块永远比另一种模块值得扩容,也无法仅凭曲线确定收益递减的唯一机制。
记忆状态带来存储、新鲜度、版本兼容和恢复成本。论文披露了端到端资源项目,但省略部分绝对成本,且不构成完整生命周期成本核算。模型每天更新时,状态重建和双版本并存也会消耗资源。
共享骨干也可能限制任务。某项召回或排序目标若需要历史编码器没保留的信息,单换读取器不一定足够。生成式变体仍处于离线迭代,不能用生产变体的结果替它们背书。
6. 工业实践意义:先找到重复计算在哪里
对有长历史的社区内容排序,最直接的试验是测量同一用户在相邻请求和多个候选间重复了多少编码工作。让候选读取缓存记忆的原型,与原始请求内编码方案保持输入、标签和计算预算可比,才能判断收益来自哪里。
扩容实验可以分别扫描历史编码与候选融合的容量,同时按历史丰富度分组记录效果。业务不必照搬完整系统,仍可借用这种实验设计,避免把全部预算都压在更长历史或更深编码器上。
服务侧需要把记忆年龄、版本不兼容率、回退比例和恢复耗时,与延迟、点击率一起记录。快照发布与请求固定版本的规则,应和模型接口共同设计。这样,缓存既是性能工具,也是一份可检查的数据契约。