 已录用 SIGIR-AP 2026
目录 · 6 节
1一、问题与动机:文章边界为什么重要2二、方法:先理解文章,再组合用户兴趣3三、核心贡献:不仅是减少截断4四、实验结果:短历史更突出,长历史接近稠密基线5五、局限:评测范围与工程边界6六、工业实践意义:适合怎样做一个试点把用户读过的文章分别编码,再学习怎样合并,能让新闻推荐保留不同兴趣,也避免把长历史硬塞进一段文本。LSNR沿用稀疏检索的词表空间,但为用户单独设计聚合器。它最有说服力的结果来自短历史:即使只剩一次阅读,没有截断问题,模型仍然受益。
一、问题与动机:文章边界为什么重要
新闻推荐的输入不是一篇长文,而是一组发生在不同时间的阅读。把它们直接拼接,会让金融、体育、娱乐混在同一条查询里。模型既要理解内容,又要猜哪篇文章代表当前兴趣,还可能只看到前面的一部分。
稀疏推荐基线STAR采用这条拼接路线。它输出的向量中,大部分词项权重为零,因此可以接入倒排索引。倒排索引按词项查找文章,不必扫描所有候选;这让文本检索系统已有的工程积累能用于个性化推荐。但原有用户表示容易成为瓶颈。
作者把问题拆成两层:文章自己表达什么,用户如何组合这些文章。前者可以离线完成,后者才需要随用户改变。这个拆分也让长正文的价值不再取决于它能否挤进整段历史的上下文窗口。
二、方法:先理解文章,再组合用户兴趣
文章编码器为每篇文章生成两种表示。一种是词表上的稀疏权重,描述文章与哪些词相关;另一种是连续的稠密向量,供用户聚合器判断文章之间的关系。稀疏权重不仅包含原文出现的词,也可以包含模型补出的相关词。
这种词项扩展使用SPLADE,即把语言模型输出映射到词表,再用激活和池化保留重要维度。它不要求文档包含查询的每个字面词,仍能通过共享语义词项完成匹配。候选文章只需缓存稀疏表示;历史文章的稠密表示则参与兴趣聚合。
用户端先让文章的稠密向量相互交流,再计算每篇历史文章的重要性权重。这里没有把位置编码当作默认必需品:作者实际比较后发现,显式加入位置并未改善这两个新闻数据集的结果。它学习的是这组阅读的组合,而不是强制强调严格顺序。
接下来有两条路径。第一条直接加权求和历史文章的稀疏向量,保留可以追溯到单篇阅读的词项。第二条先合并稠密兴趣,再映射回词表,补充只有在整体阅读组合中才显现的兴趣。两条结果相加,得到最终的稀疏用户向量。
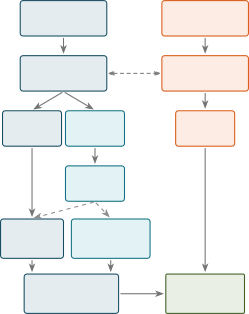
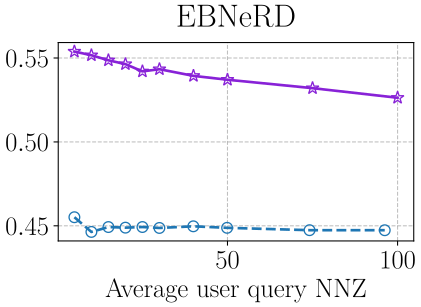
两条路径共享注意力权重和词表投影,因此不是简单地再堆一套独立网络。训练还分别约束文章和用户的非零词项数量,避免稀疏向量越学越密。服务时只保留用户权重最高的30个词项,这个数是论文使用的默认剪枝设置。
最终打分就是用户向量与候选向量的内积。重要的工程边界由此清楚了:文章编码在离线索引端完成;在线侧主要负责用户聚合、剪枝和检索。它没有要求每个用户与每篇文章都重新跑一次语言模型。
三、核心贡献:不仅是减少截断
论文真正提出的是一套面向多篇阅读的用户编码方法。单独编码文章解决了输入长度问题,双路聚合则解决不同兴趣怎样合并的问题。两者不能混为同一项改进,否则很难判断模型为什么有效。
为拆开这两个解释,作者构造只保留一篇历史文章的评测。此时STAR和LSNR看到相同文章,不存在历史拼接截断。LSNR仍有优势,表明文章表示的学习方式和用户级训练信号也发挥了作用。
另一项贡献是同时报告稀疏性、索引体积与查询耗时。论文没有把“更小的索引”直接写成“更快的检索”。这对工程判断很关键:存储成本、候选排序质量和在线延迟是不同指标,需要分别衡量。
四、实验结果:短历史更突出,长历史接近稠密基线
实验使用英文MIND与丹麦语EBNeRD的small版本。因为官方测试集没有公开标签,作者按常见做法用官方验证集测试,再从训练数据中划出调参部分。下表展示曝光候选列表内的NDCG@10,数值越高越好。
| 方法 | MIND完整历史 | EBNeRD完整历史 | EBNeRD单篇历史 |
|---|---|---|---|
| STAR | 0.3815 | 0.4704 | 0.4656 |
| NRMS | 0.4256 | 0.5290 | 0.4880 |
| NAML | 0.4247 | 0.5312 | 0.4889 |
| LSNR | 0.4234 | 0.5200 | 0.5022 |
相对STAR,MIND完整历史的增幅约为11%。但与稠密模型比较,结论更克制:完整历史时LSNR接近MIND上的强基线,在EBNeRD上仍落后。它的突出优势是短历史,并非所有条件下都胜出。
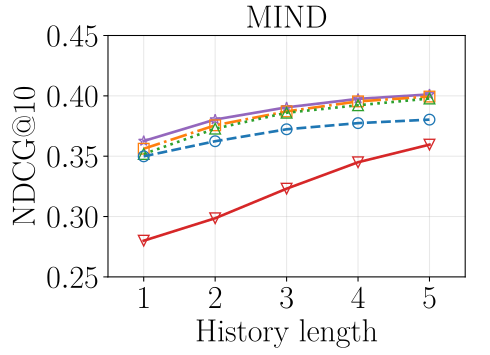
消融还支持双路设计:单独保留词项聚合或整体语义扩展,都不如两者合并。聚合方式也不是随便换一个池化就一样,学习得到的注意力在测试条件下优于平均、最大值和时间衰减等替代方案。
效率方面,EBNeRD索引从稠密基线的31.84 MB降到LSNR的2.41 MB。但同一测量中,稠密基线延迟更低。作者也报告了稠密索引在召回与延迟折中上的优势,因此这里的主要卖点是紧凑表示。
五、局限:评测范围与工程边界
作者明确指出,完整历史下它没有全面超过强稠密推荐器。两个数据集规模有限,覆盖的也是两个新闻语种;文章更短、互动结构不同的社区内容,未在这份实验里得到同等验证。
准确率与全库检索效率还用了不同评测范围。主表在曝光日志记录的候选文章中排序,全库检索只用于索引和延迟测量。因此,主表并不是全库候选召回率的证明,也不能据此计算线上点击提升。
另一个作者披露的问题是初始化并不完全一致。MIND上的STAR使用检索预训练检查点,LSNR从普通BERT开始,方向上更有利于STAR,但依然使比较少了一项严格控制。
本文补充一个实际注意点:词表维度可以查看,不代表每个高权重词都能直接解释成用户真实意图。论文自己也提醒,扩展词的权重不一定具有严格的语义解释,用户画像编辑功能尚未得到直接评测。
六、工业实践意义:适合怎样做一个试点
对于已有倒排索引的内容平台,可以新增一条稀疏个性化候选通路:文章文本离线编码,用户端按阅读记录聚合,观察与现有稠密通路的互补召回。社区短文本未必像新闻正文那样受截断影响,试点重点应放在用户兴趣分离是否带来收益。
评估时按历史长度分桶,分别查看新访客、偶尔访问和高活跃用户。保留单篇历史这一控制组,能区分“少截断”与“用户编码更好”两个解释,也能避免总体平均值掩盖冷启动人群的变化。
工程上把索引体积、用户聚合成本和尾延迟分别记录。服务配置可以从论文的用户剪枝设置出发,画出本地质量与非零项数量的曲线;稀疏索引是否值得接入,取决于平台真正缺的是内存、召回互补还是响应时间。
原文:https://arxiv.org/html/2610.23510v1 。图与结果均来自全文的方法、实验和结论章节;实践建议为本文分析。