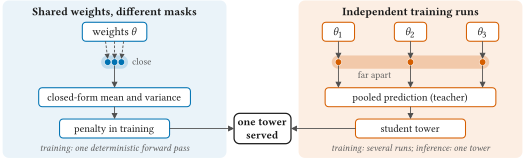
点击率模型可以把“多跑几次再互相学习”改成一次前向计算,再把多种训练结果的共识压进同一个网络。FLMNet 想保留集成带来的泛化收益,同时维持单塔上线。论文把两种容易混在一起的差异拆开:同一个网络在不同遮挡下的分歧,以及不同随机种子训练出来的网络之间的分歧。
1. 问题:自蒸馏究竟在约束什么
推荐排序通常把用户、物品和上下文的离散字段变成向量,再学习字段之间的交互。字段组合远多于训练样本,网络很容易记住偶然共现。一个常用补救是 dropout,即训练时随机遮挡一部分单元,让模型少依赖特定路径。
进一步的自蒸馏,会让不同遮挡下的预测靠近它们的平均预测。这里的老师也是网络自己。已有工作观察到效果,但没有充分解释收益来自更强约束,还是来自采样本身。若每一步都需要多次前向,训练成本也会增加。
作者先问:假设抽取无限多种遮挡,目标最后会变成什么?答案是平均打分对应的标签损失,加上衡量各次预测分歧的一项惩罚。这个分解解释的是训练目标,不是整个训练轨迹,也不保证测试准确率必然提高。
2. 方法:让分歧变成可计算的量
第一步是明确“平均”发生在哪里。论文推导采用 logit,也就是 sigmoid 转成点击概率之前的分数。平均分数再转概率,和直接平均概率并不一样。作者的精确结论有指定的汇聚形式,不能直接套到所有名字叫自蒸馏的损失上。
损失中的分歧可以写成一个凸函数的平均值,与平均输入处函数值的差。这种差叫 Jensen gap。各次预测越一致,它越小。直观上,网络需要依赖多种遮挡都支持的规律,减少仅在某条路径上成立的记忆。
第二步是让门控读取干净输入。门控决定哪些特征交互应该被放大。如果它读取已经被随机遮挡的中间状态,遮挡不仅改变数值,还会改变后续处理规则;多层随机量因此互相依赖,简单的均值、方差计算不再可靠。
FLMNet 把字段局部门控接到未遮挡的输入上。这样,遮挡路径与控制路径之间的依赖被限制,模型才能计算预测分数的统计量。推理时仍是一座字段交互网络,并没有把多个塔全部部署出去。
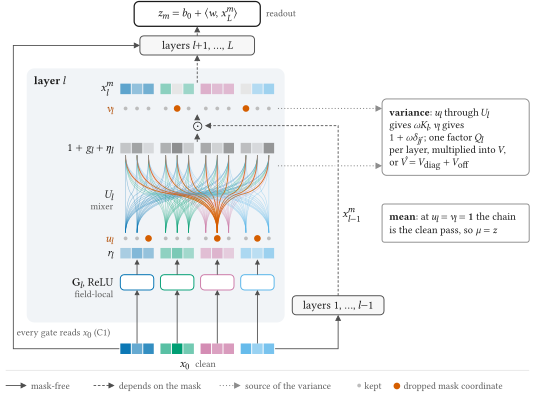
第三步是近似分歧本身。知道均值和方差,并不等于知道原分布的全部形状。作者用具有相同方差的高斯分布替代遮挡分布,再用三个积分节点估计惩罚。网络训练时不实际抽遮挡,而是在一次前向中同时得到打分和惩罚所需信息。
这里有三个层次需要分清:目标在无限遮挡下的分解、特定网络条件下的矩计算,以及训练时使用的近似惩罚。论文还检查了方差截断和高斯替代的误差。把这些都称为“精确闭式训练”,会夸大结论。
最后处理跨种子分歧。不同初始化和数据顺序,仍会训练出不完全一致的塔;无限遮挡也不会消除这种差异。作者汇聚多个已训练模型的分数,再蒸馏给一个学生。训练需要多个老师,上线只保留学生。
3. 核心贡献:区分两种集成收益
论文的贡献不只是又搭了一个交互模块。它把自蒸馏的目标解释为预测分歧约束,并设计了一种能支持该解释的网络结构。控制路径是否受到遮挡,成为可检查的架构条件。
闭式惩罚处理同塔内部的遮挡分歧;多种子蒸馏处理跨训练轨迹的分歧。两项收益在实验中大体能叠加,所以它们不完全是同一件事。这个拆分也让训练预算更容易分配:单次训练加强正则,还是额外训练老师,是两种不同投入。
不过,单次前向不等于训练一定更快。统计量及其梯度也要计算,跨种子老师更需要额外训练。论文报告成本,而不是用前向次数代替真实耗时,这一点值得保留到工程复现中。
4. 实验:提高了多少,靠什么提高
主实验覆盖五个广告和推荐基准,并比较十七类已有模型。下面摘取广告任务的测试均值;两个数据集的 AUC 都越高越好。这里展示绝对值,避免把很小的绝对变化说成很大的业务收益。
| 模型 | Criteo AUC | Avazu AUC |
|---|---|---|
| FinalNet | 0.8151 | 0.7607 |
| QNN 单头 | 0.8153 | 0.7572 |
| FLMNet-CF | 0.8162 | 0.7617 |
| FLMNet-KD | 0.8169 | 0.7620 |
CF 是闭式惩罚版本,KD 再加入跨种子蒸馏。Criteo 上两步都有收益。论文也比较同一骨干上的随机正则,降低“换骨干带来效果,却把功劳记给损失”的混淆。
更有解释力的是惩罚开关实验。作者在训练中途开启或关闭惩罚,观察训练和验证损失差距的增长。惩罚开启时,过拟合发展变慢;过早开启也会拖慢早期学习。因此,它并非一个越早越强越好的约束。
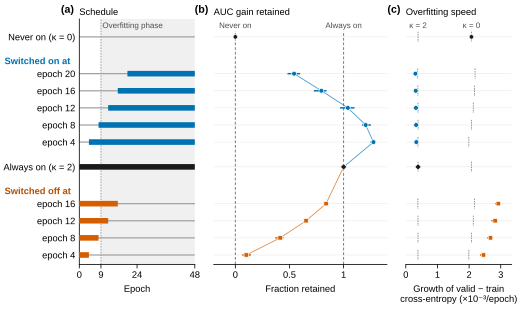
这项时间实验只在 Criteo 和固定学习率下完成。图支持“主要抑制过拟合”的解释,但不支持把某个开启轮数直接当成通用参数。不同数据规模、调度和早停策略,都可能改变合适时机。
5. 局限:哪些条件不能省略
作者明确列出三点边界。闭式统计量依赖指定的结构条件;训练用高斯代理近似真实分歧;跨种子分歧没有闭式解,学生能收回多少收益只能测量。更换门控输入后,公式还是否可靠,必须重新检查。
实验协议也影响结果解读。Avazu 的验证和测试数据经过重新划分,论文披露了历史模型选择和重新训练的处理。部分蒸馏学生共享老师集合,不能把它们视作完全独立的重复实验。公开基准领先也没有自动给出线上 CTR 增幅。
再补充一个工程问题:多老师的训练预算由离线承担。对于频繁更新的模型,老师训练、预测缓存和学生训练的周期,需要纳入新鲜度成本。单塔服务节省的资源,和更新速度付出的资源,应放在同一张账上。
6. 实践意义:怎样放进排序迭代
对已有 CTR 网络,最直接的入口是检查自蒸馏损失和门控接线。记录老师如何汇聚,检查随机遮挡是否进入控制分支;这样才能判断论文的分解哪些部分适用。
复现实验可以固定骨干、字段向量维度和训练预算,比较无惩罚、随机正则和闭式惩罚。报告配对种子差值,并同时画出训练与验证损失。目标是识别收益来自抑制过拟合,还是来自不同模型容量或不同早停点。
若线上预算只容纳一座塔,可以把多种子蒸馏作为独立实验。除 AUC 外,保留概率校准、延迟及更新周期指标。对社区点击排序,内容和用户分布会持续变化,学生多久需要重新蒸馏,与单次离线领先同样影响可用性。
来源:原文第 3–5 节、结论和附录 B;框架与机制图均来自作者的 arXiv HTML。