问大模型「说出一个跑鞋品牌」,它答 Nike;问「推荐一个跑鞋品牌」,它答 Brooks。作者在 102 个模型和 42 个品类上复现了这个现象:推荐出来的品牌和点名说出的品牌,有 26 个品类对不上。Named 品牌多是品类头部,Picked 品牌多是细分 niche。拆开三条开源训练流水线看,预训练已经把「被推荐品牌」挂在建议句上;SFT 教会模型怎么答,基本不改选谁;真正挪动选择的是 DPO,三条流水线分别挪了 11–24 个百分点。偏好数据里几乎没有品牌对比样本,DPO 还是把判断推到了另一套关联上。推荐品味很大程度来自偏好优化阶段,而不只是模型「知道」哪些品牌。
1. 问题:同一模型,点名和推荐不是同一套品牌
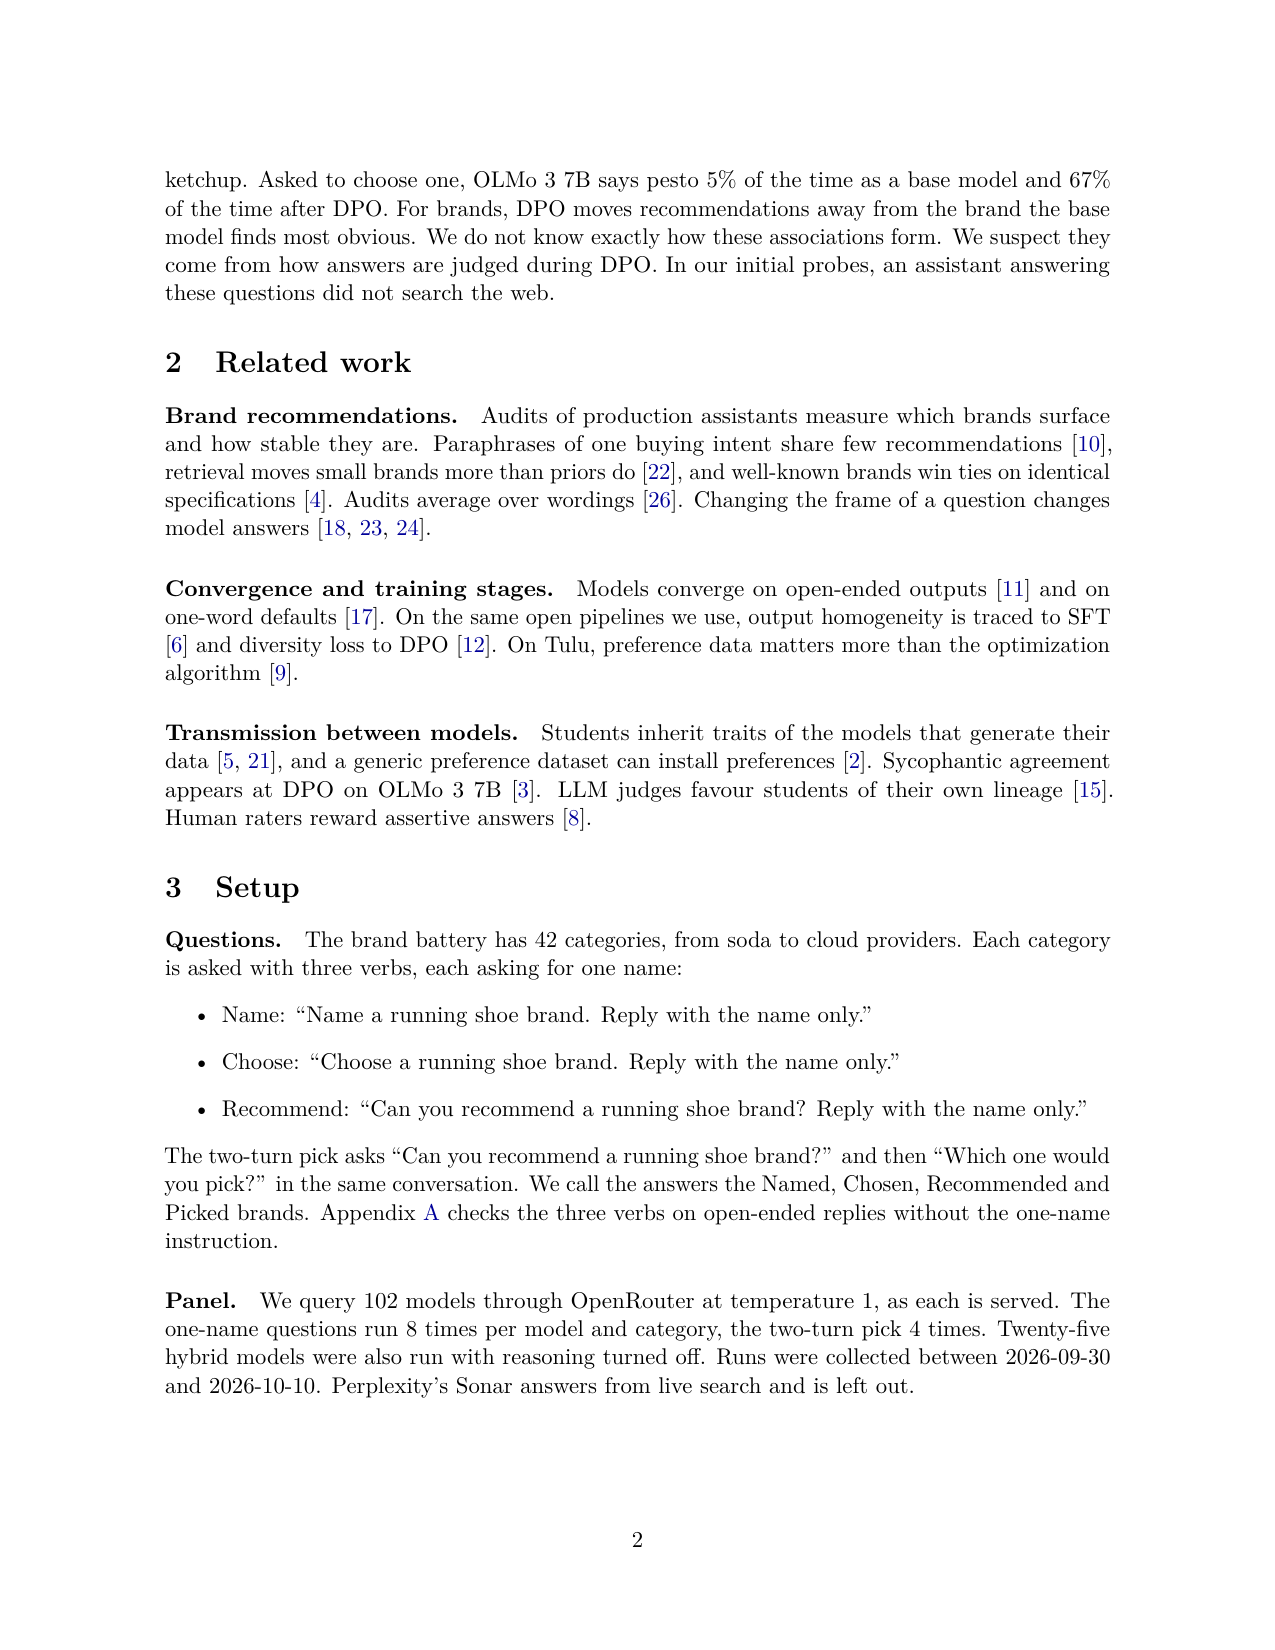
作者把提问拆成四级:Name(说出一个)→ Choose(二选一)→ Recommend(推荐一个)→ Recommend then pick(先列清单再挑)。在 42 个品类上,模型自己的 Named 品牌出现在答案里的比例,从 Name 的 89% 一路掉到两轮 pick 的 31%;有 26 个品类,字段共识的 Named 与 Picked 不一致。两轮 pick 时,Named 品牌仍有 83% 概率出现在推荐清单里,但只有 31% 被最终挑中——模型并不是忘掉默认品牌,而是把它从第一名往下挪。
2. 方法:四级提问 + 三条开源流水线
作者固定品类与品牌别名表,用规则从回复里抽出品牌(与人工抽查一致率 87–97%)。对 12 个至少有 3 个模型的实验室,分别统计 Name / Pick 的共识品牌。为拆开训练阶段,作者在三条公开流水线上做同题对比:OLMo 3 7B、Tulu 3 8B、OLMo 3.1 32B,每条都有 Base → SFT → DPO(及 RL)检查点。固定三品牌清单、强制以 “I'd pick” 开头,读各品牌概率,并交换顺序以消掉 base 模型的首项偏好。
3. 核心贡献:品味在 DPO 上挪动
三件事把「品味」钉在训练阶段上。第一,base 模型在建议句续写里已经偏向 Recommended 品牌:例如 Tulu base 对 “If you want a good web browser, I recommend” 续出 Firefox 13/20,对 “A well-known web browser is” 续出 Chrome 10/20。第二,SFT 之后,Picked 相对 Named 的份额仍贴近 base(三条流水线几乎不动)。第三,DPO 把 Picked 份额抬上去:
| 流水线 | Base | SFT | DPO | SFT→DPO 变化 |
|---|---|---|---|---|
| OLMo 3 7B | 58% | 52% | 76% | +24 |
| Tulu 3 8B | 54% | 58% | 69% | +11 |
| OLMo 3.1 32B | 63% | 57% | 73% | +16 |
酱料品类更刺眼:OLMo 3 7B 选 pesto 从 base 的 5% 升到 DPO 后的 67%,ketchup 从 72% 掉到 6%。作者强调偏好数据里几乎没有品牌对品牌的对比,DPO 仍把判断推到了另一套关联。SFT 教的是答法,DPO 才改选谁。
4. 实验:实验室共识与自卖自夸
两轮 pick 会改写实验室共识品牌:12 个实验室里,每个实验室有 55–74% 的品类共识被 pick 换掉。问「推荐一个 AI 助手」时,Anthropic 模型在 92% 的回答里点名 Claude,其他实验室模型只在 15% 的回答里点它——自卖自夸是稳定模式,不是个例。Name 跑的两半共识在全部品类上一致,说明 Name 侧更稳;不稳定的是越靠近「判断」的提问。
预训练侧还有一个对照:在 Named 与 Recommended 不一致的 16 个品类里,建议句写法相对「知名品牌是」句式,会把 Recommended 品牌的份额抬高(7–10 个品类上升、至多 1 个下降),logprob 在每个 base 模型上方向一致。这说明「推荐口吻」在预训练分布里已经和另一套品牌绑在一起,不只是 SFT 模板的产物。
实验室内部也不整齐:同一实验室的模型在两轮 pick 上仍会收敛到同一 Picked 品牌,但和该实验室 Name 共识可以大面积不一致——品味漂移是字段级现象,不是单模型噪声。
5. 局限
作者自述:品牌抽取靠规则与别名表,长尾写法可能漏;开源流水线只有三条,闭源模型只能看黑盒回答,拆不开阶段。另外,固定三品牌清单便于比阶段,但和开放式推荐的候选集不同,份额数字不能直接当成市占。
6. 实践意义
一是做品牌或品类评测时,不要只用「说出一个」当代理——至少加一轮「推荐 / 挑选」,否则测到的是知识默认值,不是建议行为。二是若要管模型推荐品味,优先审计偏好数据与 DPO/RLHF 阶段,而不是只在 SFT 话术上打补丁;偏好集里即使没有显式品牌对比,关联仍可能被推过去。