长上下文解码被增长的 KV 注意力拖住。稀疏注意力用确定性 top-k 会丢掉残余注意力质量,用采样又方差大,混合仍与稠密有差距。Stratified Sparse Attention(SSA)按层把稀疏预算分给确定性利用与随机探索,缩小极端稀疏下的稀疏-稠密鸿沟。50× 稀疏时,相对最强实用基线,RULER 等上 32K 从 81.8%→84.2%、128K 从 63.8%→69.3%,分别收回稠密性能的 94% 与 85%;百万上下文解码相对 FlashInfer 最高 2.96×。极端稀疏下要分层补残余注意力质量,而不是只抠 top-k。
1. 问题
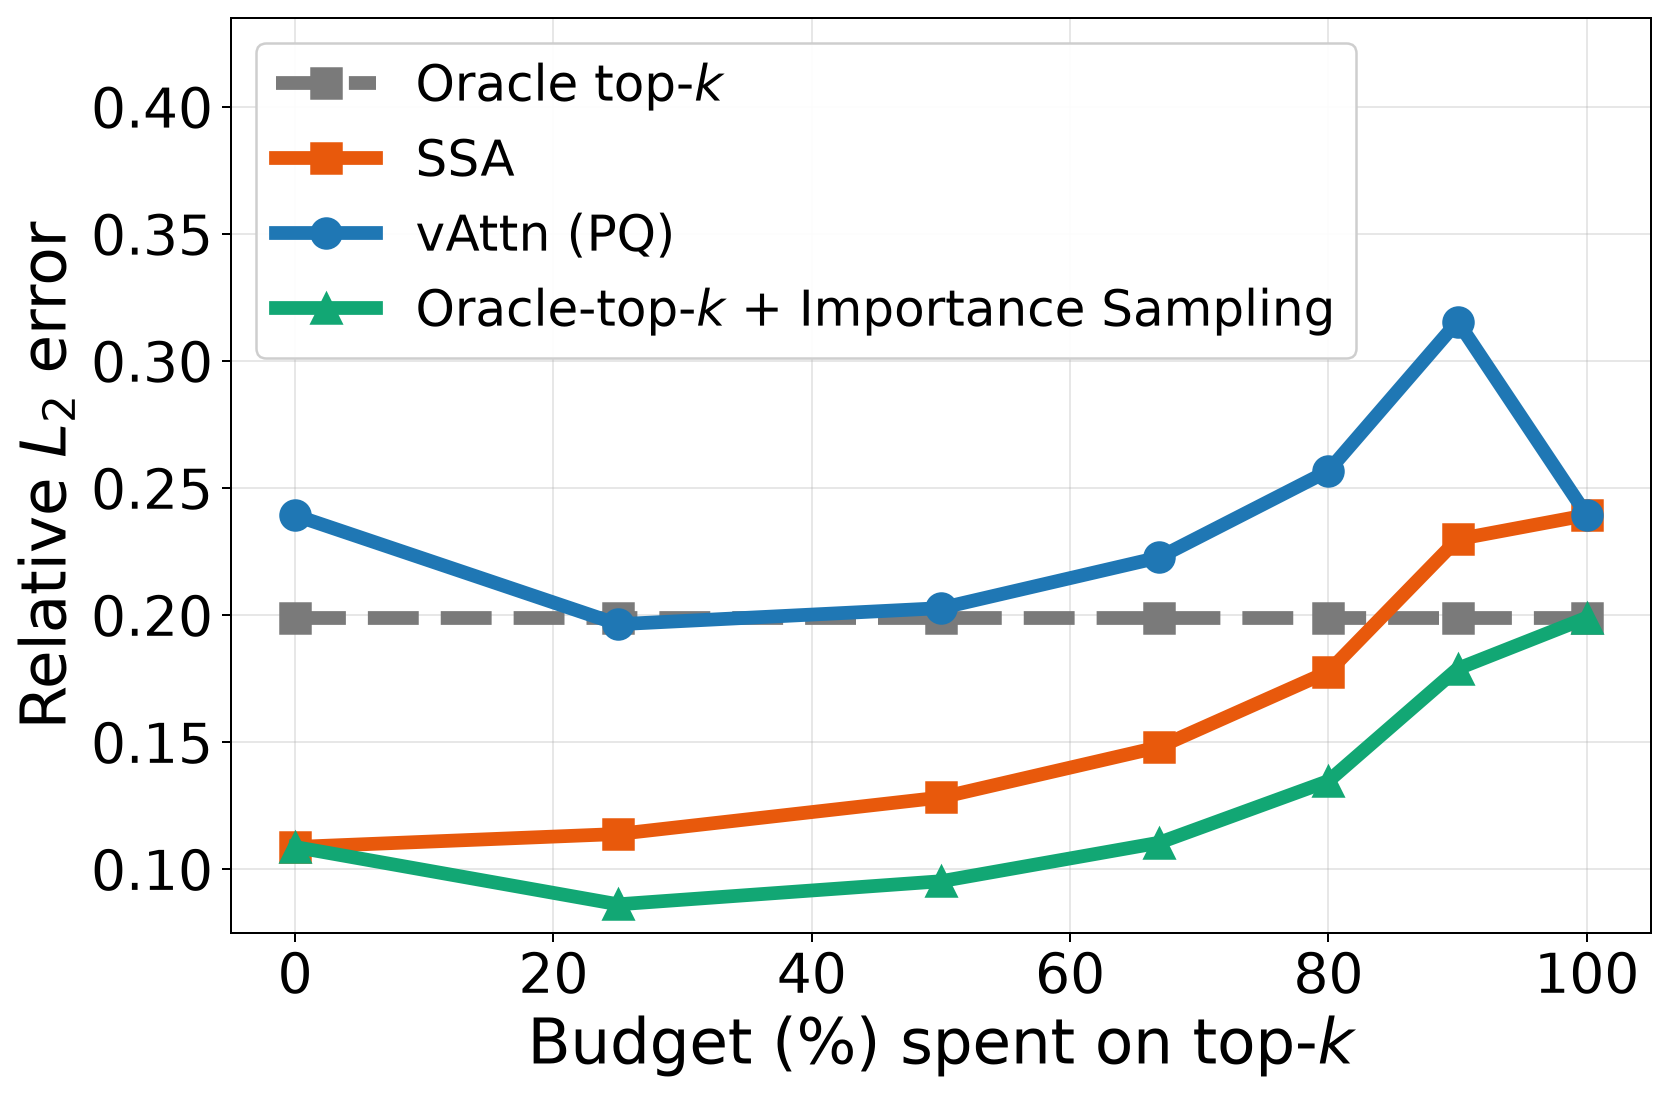
只取 top-k 丢残余质量;纯采样方差大;top-k+均匀采样仍有稠密缺口。需要在固定预算 k 下更好分配「必定取」与「随机探」。
2. 方法
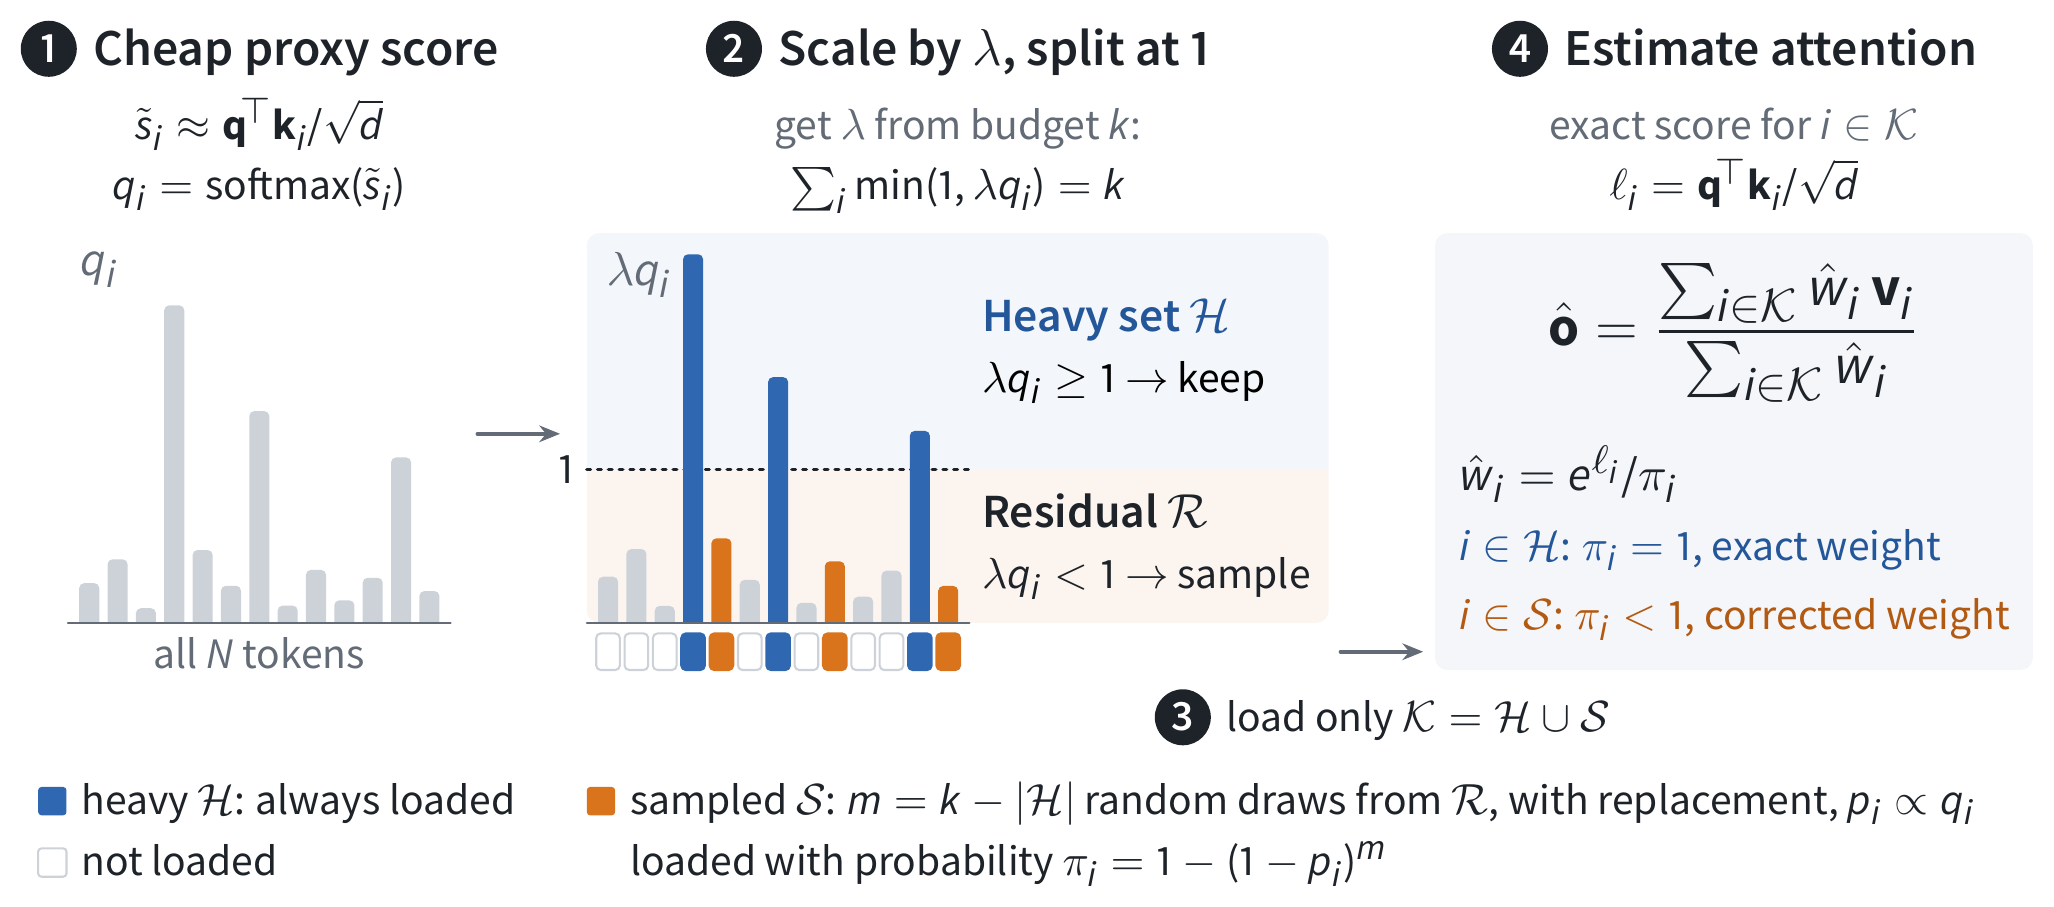
三阶段:用代理分数把预算在 token 上分成确定段与采样段;对采样段按分层/概率抽取以覆盖残余质量;用定制 CUDA 核减少内存流量。均匀采样与纯 top-k 是特例。
3. 核心贡献
在极端稀疏比下系统性地缩小 sparse–dense gap,而不是只报加速比。加速只有在质量贴住稠密时才算数。
4. 实验
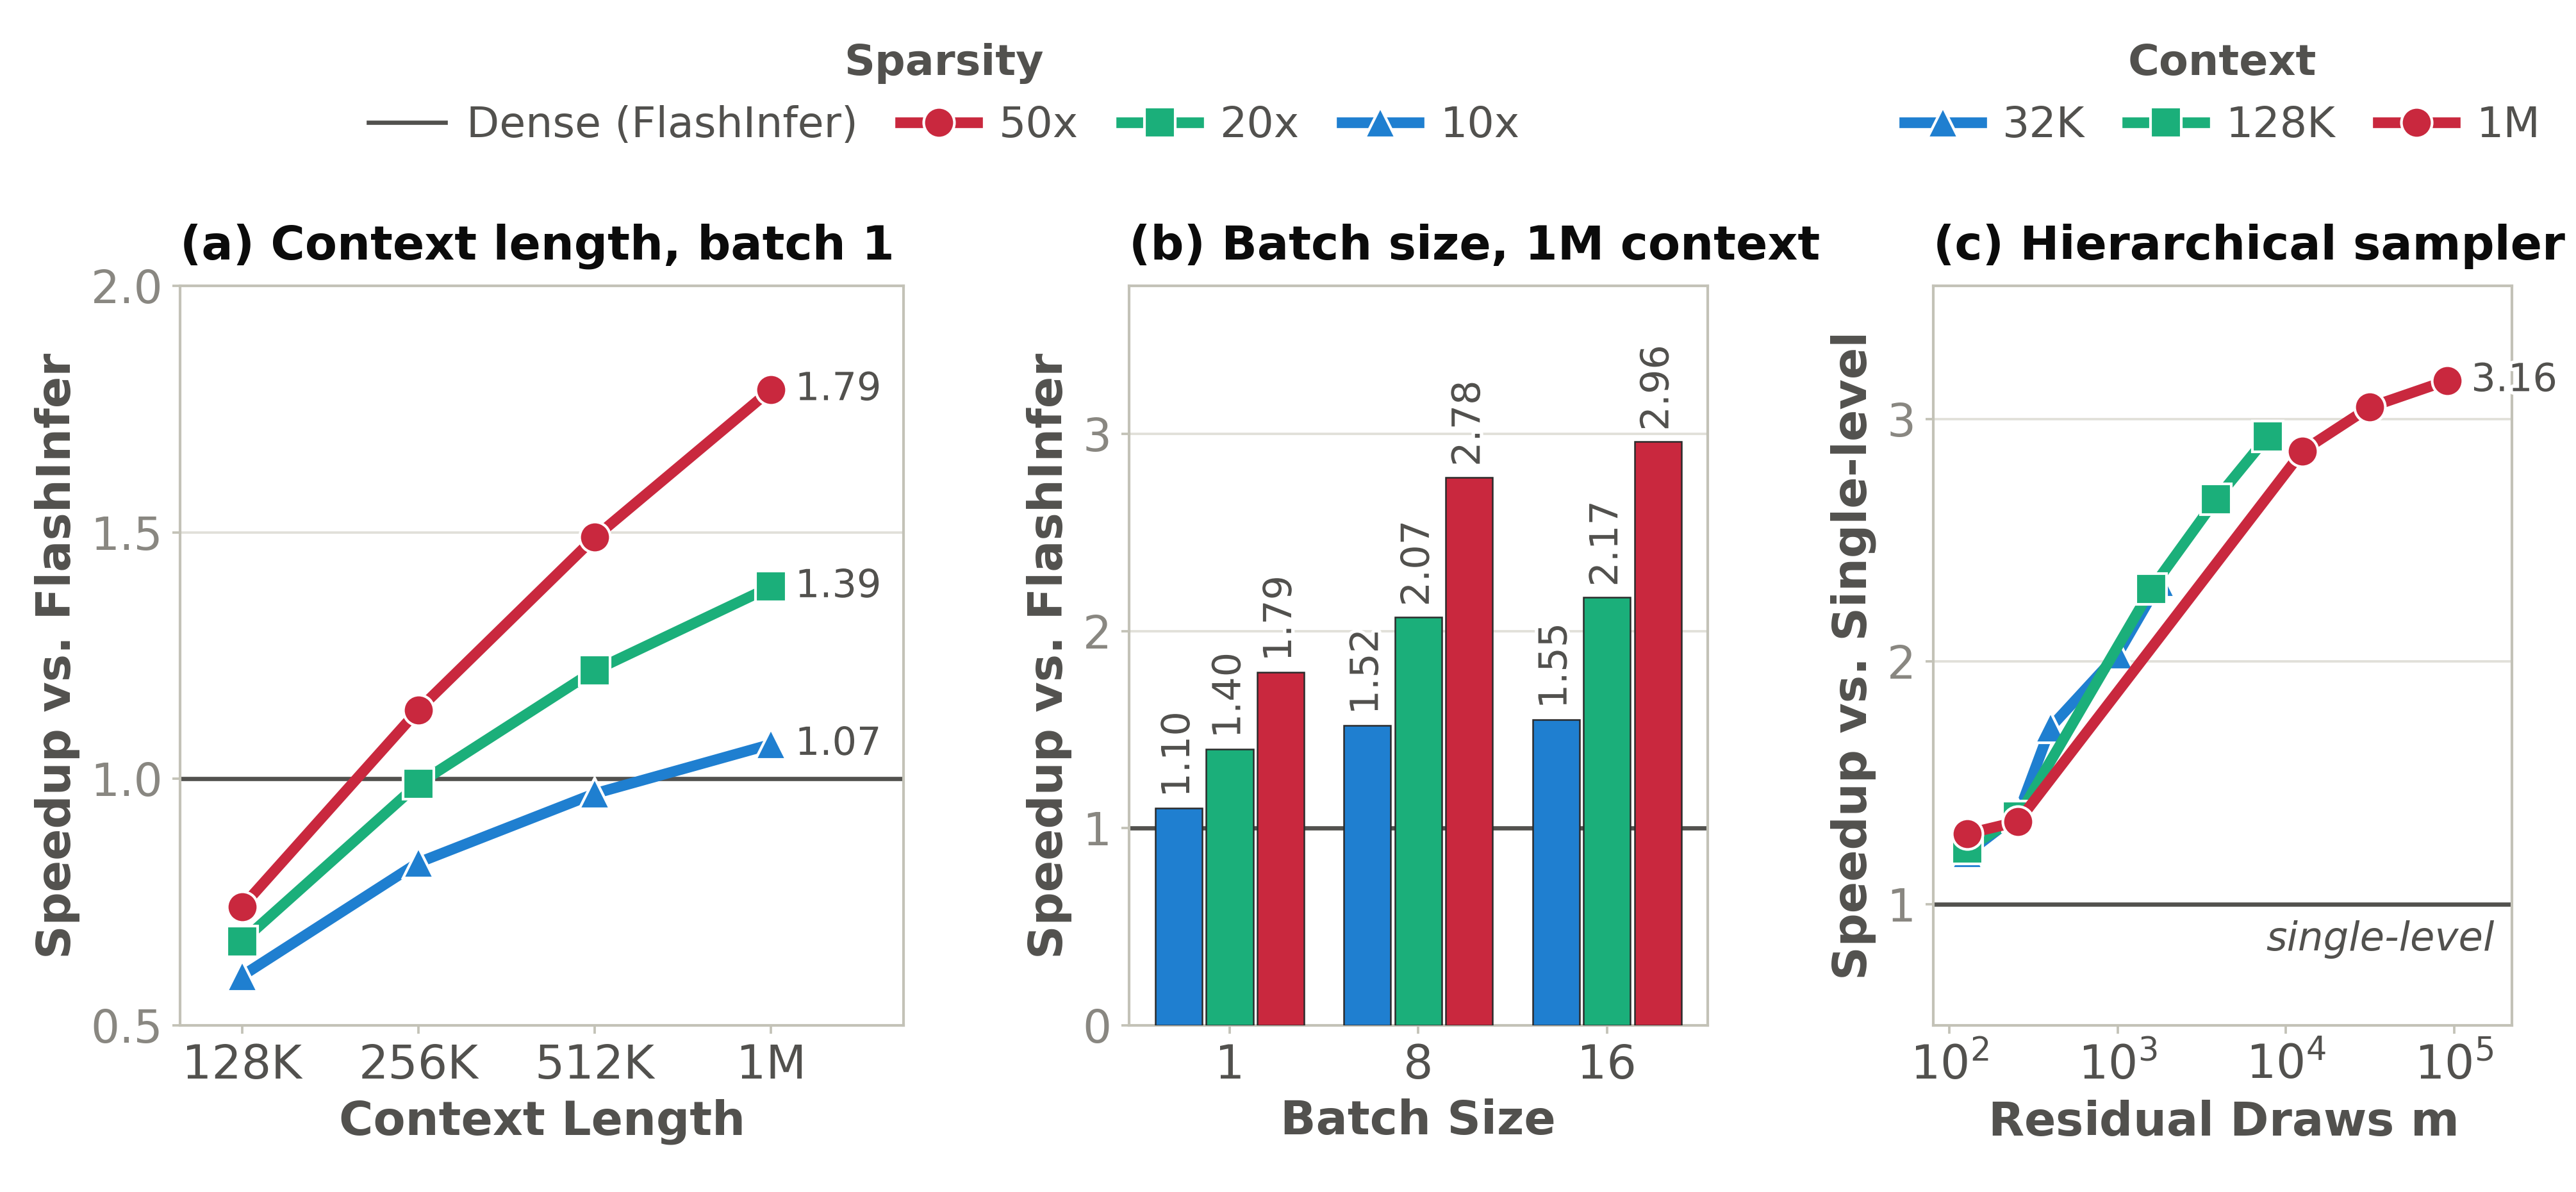
RULER / LongBench / LOFT / AIME,模型 3B–更大。50× 稀疏:32K 81.8→84.2,128K 63.8→69.3(收复 94%/85% 稠密)。H200 上 1M 上下文解码注意力层相对 FlashInfer 最高 2.96×;分片数 64 vs 32 约 1.58–1.71×。
| 上下文 | 基线 | SSA | 相对稠密 |
|---|---|---|---|
| 32K @50× | 81.8% | 84.2% | ~94% |
| 128K @50× | 63.8% | 69.3% | ~85% |
5. 局限
代理分数质量影响分层;极端 batch 下速度优势变化;与其它稀疏核集成需工程。
6. 实践意义
长上下文服务若已上稀疏注意力,用 SSA 式预算分层做 A/B,先看 50× 稀疏下 RULER/长基准相对稠密的回收率。
补充:正文数字均摘自论文表格与实验节;配图为论文 HTML/PDF 原图或页渲染,图注说明看点而非翻译英文 caption。