Perplexity 发布了两个多向量检索模型 pplx-embed-v2-late,参数量分别是 0.6B 和 9B,能编码文本、图片和文档页面截图。它们属于"后期交互"检索:文档里每个 token 都存一个 128 维向量,查询的每个 token 也各算一个向量,打分时每个查询向量找文档里内积最大的那个向量,再把这些最大值加起来(MaxSim)。两个模型不是各自用对比学习训出来的,而是都去逐 token 模仿同一个 18B 教师模型输出的向量,所以两者落在同一个向量空间:文档库可以离线用 9B 建索引,线上查询用 0.6B 编码,直接拿来打分。在作者整理的 72 个领域检索任务上,9B 平均 nDCG@10 为 81.3%,比次优的 nemotron-3-embed-8b 高 1.6 个百分点;0.6B 查询配 9B 文档索引得到 79.6%,比两端都用 0.6B 高 1.6 个百分点,查询端成本不变。需要注意,这 72 个任务的完整清单作者没有公开,分数无法独立复现。
1. 为什么做后期交互,为什么要蒸馏
检索模型通常在两种方案之间取舍。单向量模型把整段文档压成一个向量,用近似最近邻搜索很快,但细节信息会丢。交叉编码器把查询和文档拼在一起过一遍模型,效果好,但每个候选都要单独算一次,只能用于重排。后期交互介于两者之间:文档 token 向量离线算好存下来,查询时只算查询的向量,再做 MaxSim。代价是存储大,所以这篇把每个 token 的向量压到 128 维。
作者的另一个判断是:小模型直接做对比学习效果不够,让它去拟合大模型给出的 token 向量更好。这样做还带来一个副产品,同一个教师蒸馏出的不同尺寸学生可以互换使用。
2. 训练流程
2.1 18B 教师:两阶段对比学习
教师从 Qwen3.5-27B 剪掉最后 20 层得到 18B,并把注意力层的因果遮罩去掉,让每个 token 能看到前后文。训练分两步。
第一步用查询-文档对。数据来自 28 个数据集,按语言和领域再切成 981 个子集,共 1.86 亿对,其中文本-文本 88.3%、文本-图片 8.3%、文本-文档截图 3.4%;训练时调整采样权重,把比例改成 56.5%、30.9%、12.6%。每个批次只从一个子集里取样,这样同一批里的其他文档(作为负例)和正例更相近,更难区分。为了让各子集按目标比例、并且均匀地间隔出现,作者用黄金比例序列做准随机采样,而不是独立随机抽。对比批大小为 16,384 对,用 LoRA(秩 128)训练,MaxSim 写成了 Triton 算子,避免显式存储 token 级相似度矩阵。
第二步合并 LoRA 后加一个秩 32 的新适配器,冻结视觉部分,只用文本三元组训练:每个查询配一个正例和最多 4 个难负例。部分难负例是把高度模板化文档里的关键信息改掉合成的。
2.2 学生:逐 token 拟合教师向量
学生的损失很直接:对查询和文档的每个有效 token,算学生向量和教师向量(都做 L2 归一化)之间的欧氏距离,查询部分和文档部分分别取平均再相加。教师不更新。
因为这个损失不依赖批内负例,一个批次里可以混合多个子集,梯度更稳。9B 学生基于 Qwen3.5-9B,作者发现只用 LoRA 拟合不到位,于是把文本部分最后 8 层全量微调,其余用 LoRA。0.6B 学生从 Qwen3.5-0.8B 剪枝而来,每个块里 3 个线性注意力(Gated DeltaNet)层剪掉 2 个,最后总参数 594M,其中 254M 是词表嵌入、100M 是图像编码,处理文本时实际参与计算的约 240M,并做全参数微调。
3. 实验
3.1 文本检索
这组实验检验蒸馏出的两个模型在文本检索上是否超过同尺寸的单向量模型。领域基准由 72 个公开任务组成(金融 18、法律 20、医疗 8、对话 5、技术 4、多语言 17),指标 nDCG@10,六个领域等权平均:
| 模型 | 维度 | 平均 | 金融 | 法律 | 医疗 | 对话 | 技术 | 多语言 |
|---|---|---|---|---|---|---|---|---|
| pplx-embed-v2-late-9b | 128 多向量 | 81.3 | 82.5 | 81.6 | 82.5 | 81.5 | 70.4 | 89.5 |
| nemotron-3-embed-8b | 4096 单向量 | 79.7 | 80.8 | 81.1 | 83.9 | 77.4 | 67.5 | 87.9 |
| voyage-4-large | 1024 单向量 | 79.0 | 81.5 | 80.0 | 83.0 | 76.7 | 65.1 | 87.9 |
| pplx-embed-v2-late-0.6b | 128 多向量 | 78.0 | 79.9 | 78.2 | 78.0 | 79.7 | 66.6 | 85.8 |
| voyage-4-nano | 2048 单向量 | 74.6 | 77.3 | 75.8 | 76.0 | 74.7 | 59.4 | 84.3 |
| qwen3-embedding-0.6b | 1024 单向量 | 68.4 | 67.9 | 70.0 | 72.4 | 68.4 | 53.9 | 77.8 |
9B 除医疗外每个领域都是最高;0.6B 在 1B 以下的模型里每个领域都最高。
Q2D-Web 更接近 Perplexity 的线上场景:约 7 万条由智能体改写过的线上搜索查询,语料是 1.9 亿个网页,看 Recall@1000。相关文档的标注合并了三种来源:智能体实际引用的、线上检索系统排得靠前的、以及大模型判定相关的。在这个合并标注上,9B 和 0.6B 分别是 74.8% 和 73.6%,最强的基线 nemotron-3-embed-8b 是 69.3%。这个基准来自 Perplexity 自己的流量,其他模型没有针对它调过。
3.2 文档截图和图片检索
| 模型 | 维度 | ViDoRe-V3(截图) | MIRACL-Vision | PPLX-Q2I |
|---|---|---|---|---|
| pplx-embed-v2-late-9b | 128 | 65.2 | 75.7 | 65.0 |
| pplx-embed-v2-late-0.6b | 128 | 62.3 | 67.5 | 60.4 |
| gemini-embedding-2 | 3072 | 46.0 | 77.5 | 67.0 |
| qwen3-vl-embedding-8b | 4096 | 58.3 | 68.5 | 50.6 |
| evie-8b(只做图像检索) | 4096 | 66.4 | – | – |
图片侧它不是全面领先。ViDoRe-V3 上,专门为图像检索训练的 EVIE-8B(66.4%)和 EVIE-4.5B(65.9%)更高,但它们每个 token 存 4,096 和 2,048 维,而 pplx-embed-v2-late 只存 128 维。MIRACL-Vision(维基百科页面截图)和 PPLX-Q2I(Perplexity 线上图片搜索日志,1 万查询、10 万图片)上,gemini-embedding-2 都更高。
3.3 小模型查询 + 大模型索引
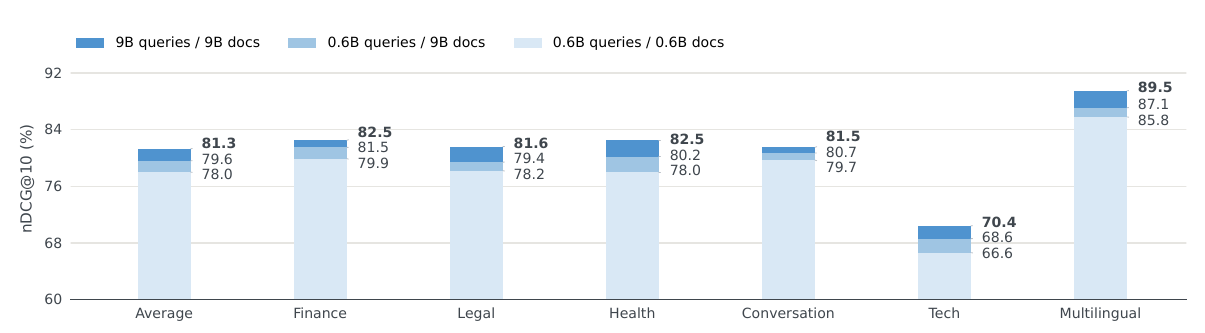
这组实验检验共享向量空间在部署上是否真的可用。做法是用 9B 给文档建索引,再分别用 9B 和 0.6B 编码查询。0.6B 查询配 9B 文档在六个领域都高于两端都用 0.6B,平均从 78.0% 升到 79.6%,两端都用 9B 是 81.3%。查询编码成本和纯 0.6B 一样,文档索引的成本在整个索引生命周期里摊销。
3.4 给搜索智能体当检索器
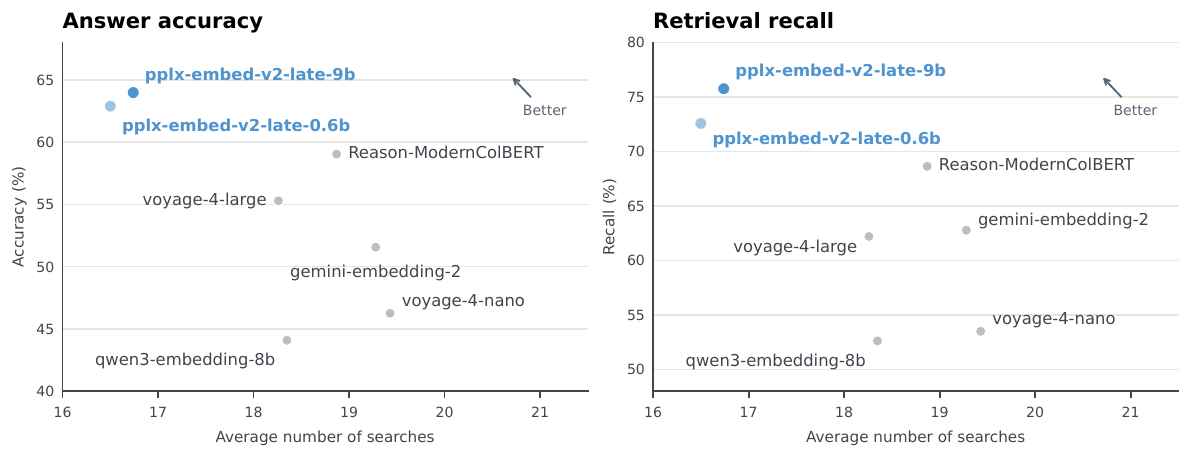
BrowseComp+ 让 GPT-OSS-120B 作为智能体,用被测检索模型在固定语料里反复搜索并回答复杂问题,再由另一个大模型判分。9B 准确率 64.0%,比另一个后期交互模型 Reason-ModernColBERT 高 4.9 个百分点,比单向量模型里最好的 voyage-4-large 高 8.7 个百分点,平均搜索次数也比所有基线少,召回率同样最高。
4. 局限
报告没有给出存储和延迟数据。多向量索引每个 token 都要存一个 128 维向量,网页规模下的存储量和 MaxSim 计算开销,比单向量方案高多少,文中没有说明。领域基准的任务清单不公开,无法复现。图片检索上,专用视觉模型和 gemini-embedding-2 在部分基准上仍更好。另外,论文说蒸馏比单纯对比学习效果更好,特别是在小模型上,但正文没有给出对比实验的数字。
5. 实践意义
对检索团队,最直接能用的是"大模型建索引、小模型查"的部署方式:文档侧算力只花一次,查询侧延迟按 0.6B 算,效果比纯小模型好 1.6 个百分点。前提是两端模型由同一个教师蒸馏,换成独立训练的两个模型不能这样混用。0.6B 版本文本侧只有约 240M 活跃参数,作者认为可以部署到端侧。如果正在评估多向量检索,建议先在自家语料上测一下存储开销,这是报告里没有回答的问题。