As rerankers cluster, nDCG on sparse discrete labels stops separating them. LLM relative judgments split close docs but share no scale across queries; absolute grades share a scale but are coarse. Cohere’s Rubric-Calibrated Preferences (RCP) uses IRT for cross-query calibration: Stage A listwise Bradley–Terry, Stage B rubric criteria as items. RCP-nDCG replaces discrete labels: useful-vs-not AUC 0.910 (vs 0.651); among 185 comparisons where only one metric agrees, RCP-nDCG is that metric 72.4% of the time; on TREC-DL it sides with NIST whenever grades separate. nDCG failure modes hit 45.6% of NanoBEIR and 30.7% of BRIGHT queries. Move reranker eval from discrete nDCG to dense, cross-query-calibrated judgments.
1. Problem
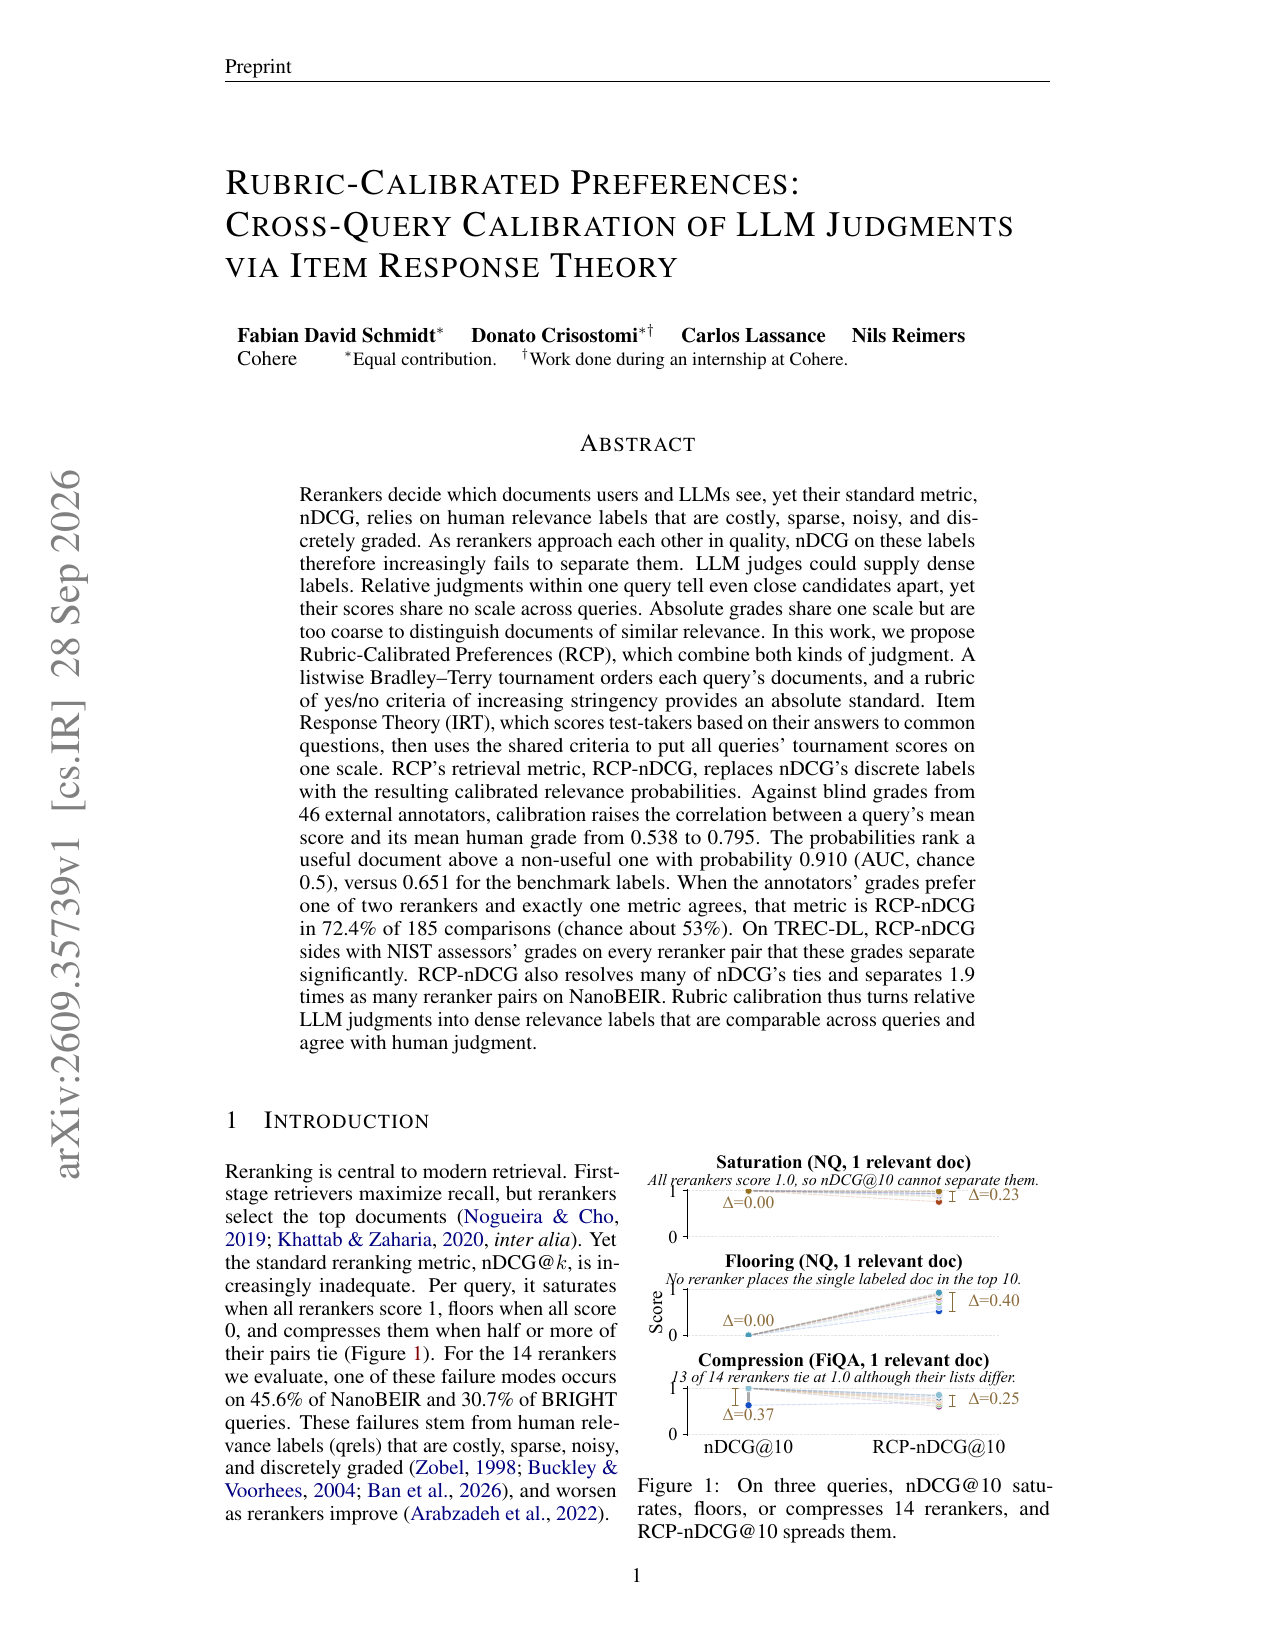
nDCG@k saturates, floors, or compresses near-tied rerankers (45.6%/30.7% of NanoBEIR/BRIGHT queries). Need dense labels on one cross-query scale.
2. Method
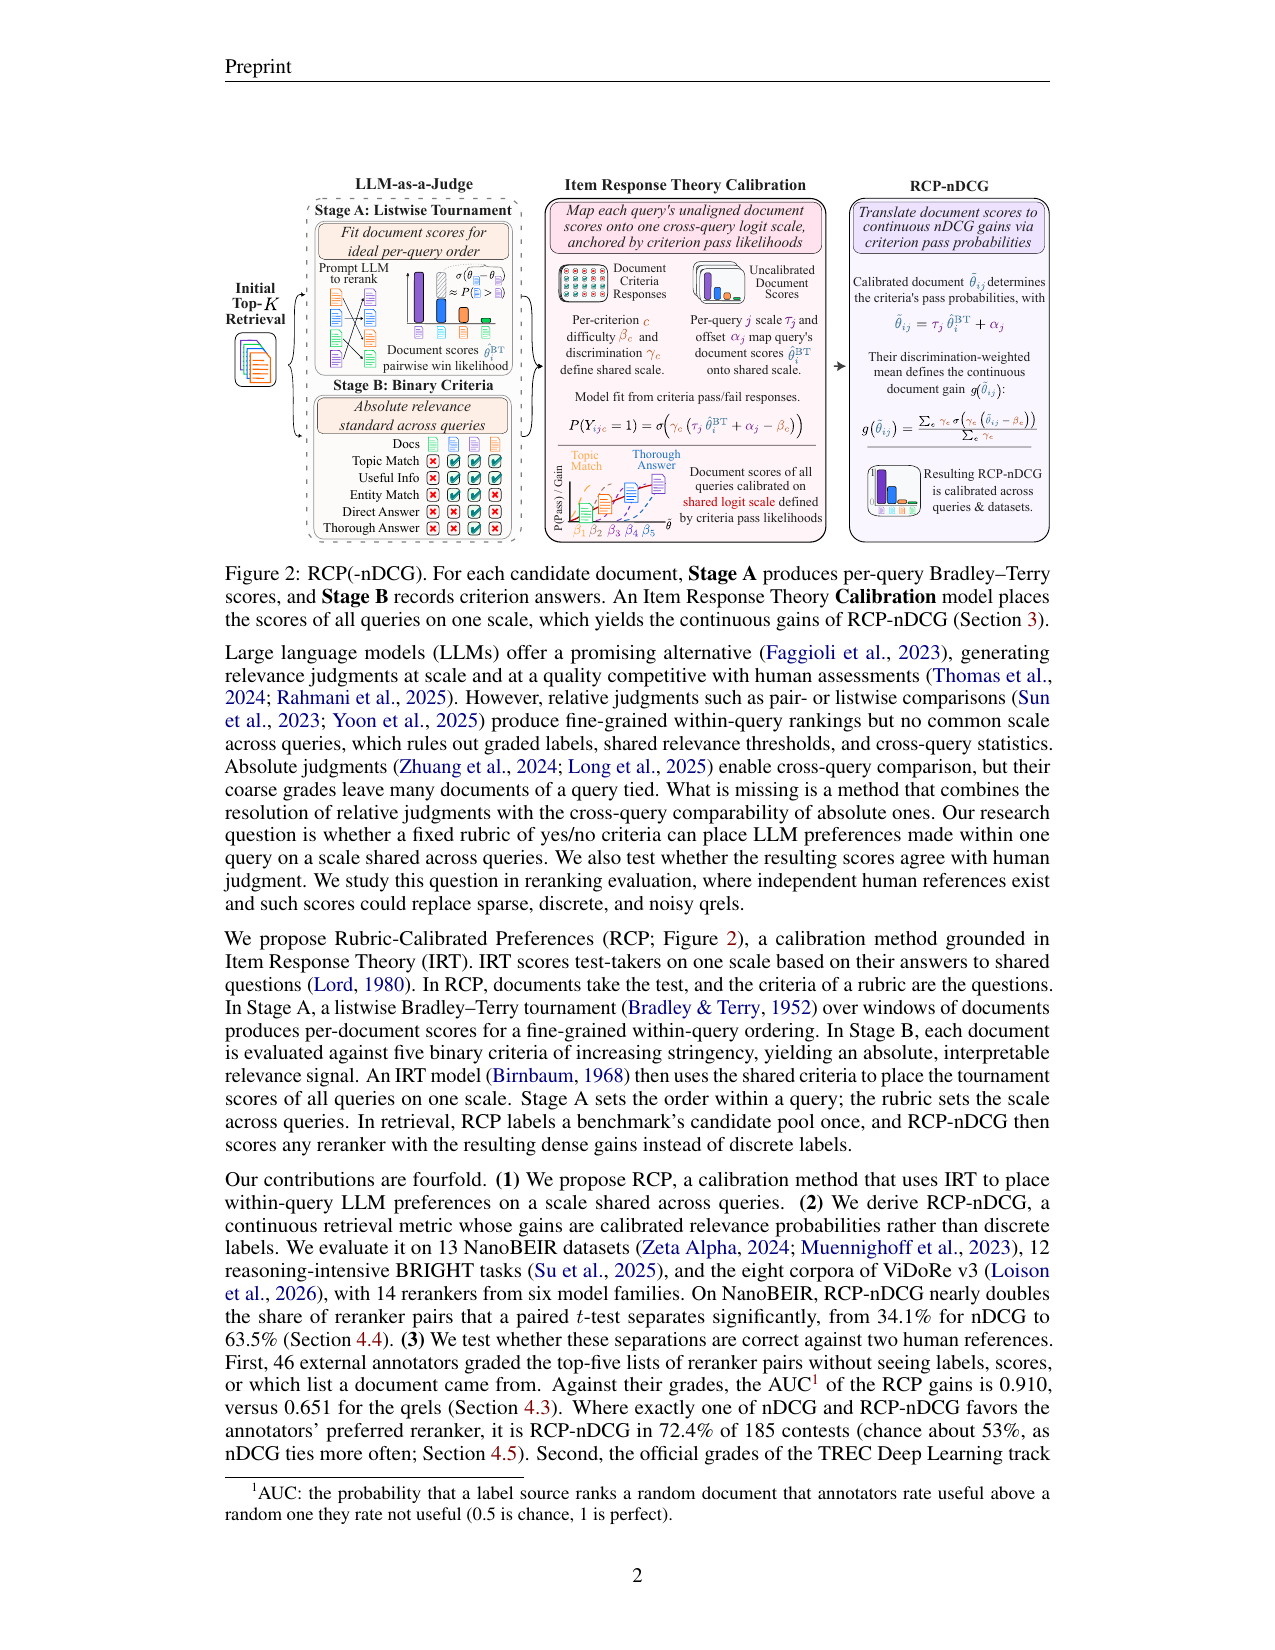
Documents are examinees; rubric criteria are items; IRT puts them on one ability scale. Stage A relative tournament; Stage B absolute criteria; plug continuous gains into nDCG → RCP-nDCG. Calibrate the pool once, score any reranker.
3. Core claim
Turn LLM judgments into IRT-calibrated utilities. Relative discrimination plus absolute shared scale—both required.
4. Experiments
AUC 0.910 vs 0.651; 72.4% of sole-agreement cases; TREC-DL always sides with separable NIST grades; ~1.9× more separations than nDCG.
5. Limits
Depends on LLM judge and rubric design; pool calibration costs; domain-specific rubrics need rewriting.
6. Practice
When rerankers are close, run RCP-nDCG beside nDCG; calibrate judges on NIST-anchored sets first.