目录 · 6 节
1算力涨在稠密层上,量化却几乎不许掉点2微缩比格式为什么能把 6 比特用得接近 8 比特3走一遍:Model A 怎样决定哪些层上 6 比特4核加速为什么没有按 4 倍出现在端到端里5这对做推荐推理的人意味着什么6局限
最复杂那档广告排序,每条例子要算的量两年涨了 22 倍:MXFP8 和 MXFP6 怎么挤出吞吐你刷一条信息流,背后要给这条请求里的一批广告打分。分必须在一秒内回来,而且预测质量几乎不许比线上模型差。
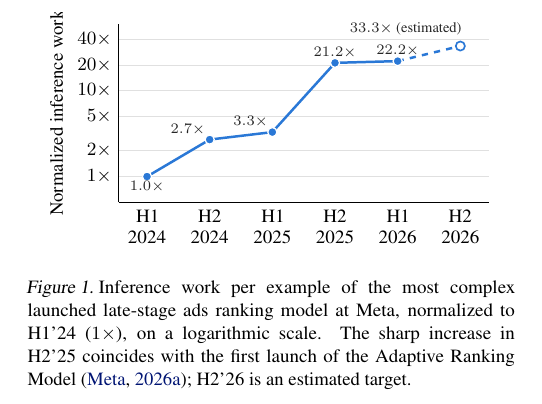
在 Meta 的广告排序里,最复杂的那档晚排模型,每条「用户–广告」对要做的推理计算,从 2024 年上半年到 2026 年上半年涨到了大约 22.2 倍,下半年的目标还要到 33.3 倍。算力在涨,功耗墙却还在那里,所以新 GPU 把峰值算力押在更低精度上。AMD 的 MI350X 上,从 16 比特降到 8 比特,峰值吞吐能翻倍;再降到 6 比特,还能再翻一倍。
这篇论文来自 Meta 和 AMD,在 MI350X 上给两套生产广告排序模型试了两种微缩比格式:MXFP8(8 比特微缩比浮点)和 MXFP6(6 比特微缩比浮点)。现有做法是只把少数扛得住的线性层换成 FP8,按整张量或按行做缩放,其余仍跑 FP16。作者写了可直接在这些低比特元素上做矩阵乘的核,把激活量化融进上游核,再按 0.01% 归一化熵(NE)的上线门槛,挑选能换成 MXFP6 的层。换完之后,Model A 和 Model B 相对各自的生产 FP8 配置,端到端吞吐分别提高 1.5%–5.3% 和 7.6%–14.3%。MXFP8 与行级 FP8 的精度几乎相同,可以按核速度为每个 GEMM 形状挑选更快的那个。
这些结果来自两套生产模型和 AMD MI350X,还不是任意推荐模型和任意 GPU 上的通用结论。
算力涨在稠密层上,量化却几乎不许掉点
工业界的推荐和排序模型,大体还是 DLRM 那一套结构。类别特征,比如用户和广告的 ID,要去很大的 embedding 表里查向量;连续特征走一层 MLP,映到同一空间。然后用一层交互结构刻画这些向量之间的关系,再用 MLP 打出多个任务的分。参数大多在 embedding 表里,但查表受内存带宽限制,算量不大。真正费计算的,是交互结构和 MLP 里的矩阵乘,也就是 GEMM。这篇论文量化的就是这些 GEMM。
大语言模型的量化研究,常常把 1%–3% 的精度下降说成可以接受。广告排序不是这个标准。这里的上线门槛是:相对生产基线,归一化熵(NE)的差距不超过 0.01%。0.01% 几乎就是不许掉点。过去因为过不了这道关,次 16 比特量化在生产里只覆盖少数线性层,大量 GEMM 仍在跑 FP16。
那多出来的计算,又正好堆在这些稠密层上。图 1 按 2024 上半年为 1 倍,画出最复杂晚排模型每条例子的推理计算量。自适应排序上线之前,更大的模型必须服务全部流量,计算量到 2025 上半年大约只涨到 3.3 倍。2025 下半年,Meta 的 Adaptive Ranking Model 按用户情境把请求分到不同复杂度的模型,并把用户侧信号按请求算一次、而不是按每条广告算一次,前沿一下子到了约 21.2 倍,2026 上半年是 22.2 倍。于是 GEMM 在推理时间里的占比更高,低精度的收益也更大。
硬件也把账算在低精度上。论文表 1 写明:NVIDIA GB300 上,FP8 和 MXFP8、MXFP6 的峰值都是 FP16 的 2 倍;AMD MI350X 上,MXFP8 是 2 倍,MXFP6 是 4 倍。这说明 6 比特如果真能用满,这块 GPU 上的理论空间比 8 比特还大一截。问题变成:在 0.01% NE 这道关前面,6 比特能不能用起来。
微缩比格式为什么能把 6 比特用得接近 8 比特
MXFP8 和 MXFP6 来自开放计算项目(OCP)的微缩比(microscaling,MX)标准。做法是:沿着 GEMM 的归约维,每 32 个连续元素共用一个 8 比特、只表示 2 的幂次的缩放因子,记作 E8M0。这个缩放没有符号位,用起来就是把指数平移,把这一小块数对到格式能表示的范围内。个别很大的数只会搅乱自己那 32 个数,不会把整张量的有效精度拉低。这和过去的张量级 FP8 不同:那里一张量共用一个 FP32 缩放,一个异常值会连累所有数。行级 FP8 折中一些,激活按行、权重按输出通道各用一个缩放。
块内动态范围被这把尺子对过之后,指数位不必留得特别宽,尾数位更值钱。MXFP8 有两种 8 比特浮点:E5M2 是 5 位指数、2 位尾数,E4M3 是 4 位指数、3 位尾数。块大小是 32 时,E5M2 多出来的指数范围基本用不上,多 1 位尾数却能把量化间隔减半。按标准量化噪声理论,量化信噪比(QSNR)大约会高 6 分贝。QSNR 的定义是:把参考输出的能量,除以它和低精度输出之差的能量,再取 10 倍对数,单位是分贝,越高说明量化噪声越小。所以本文的 MXFP8 只采用 E4M3。
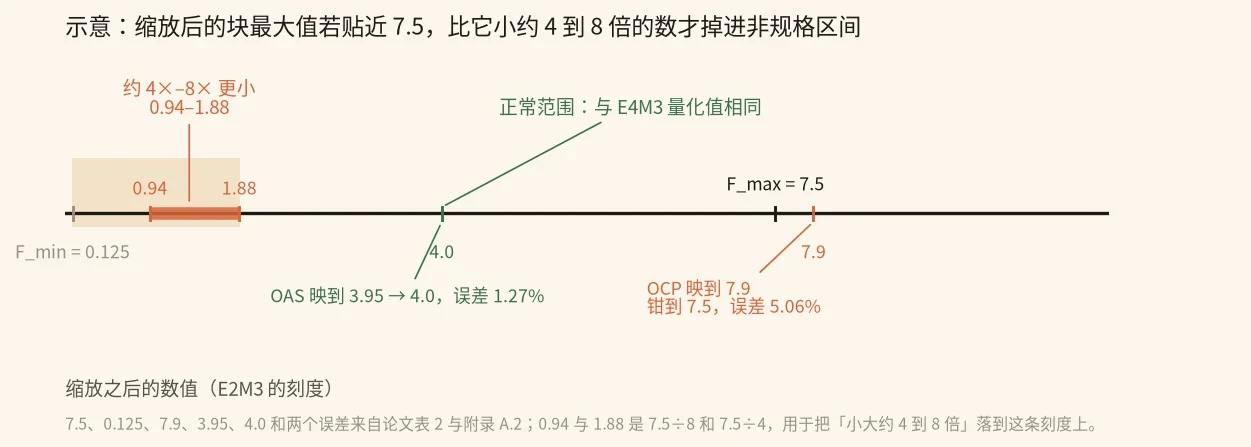
MXFP6 选的是 E2M3:2 位指数、3 位尾数,尾数位数和 E4M3 一样。因为 E8M0 缩放本身是 2 的幂,它不改变尾数怎么舍入。于是在正常范围内,每个 E2M3 元素量化后的值和 MXFP8 的 E4M3 相同。只有比这块最大值小大约 4 到 8 倍、落到非规格数区间的那些元素,精度才会比 8 比特更差。6 比特和 8 比特的差距,主要就落在这些更小的数上。 Hoot 说
正文走一遍已经讲了 Model A 怎样按层的 QSNR 和 0.01% NE 门槛决定哪些层改成 6 比特。这里另走格式本身:同一块 32 个数里,为什么处于 E2M3 正常范围内的值和 8 比特相同,差别只落在更小的数上。示意把这块缩放后的最大值贴近 E2M3 上限 7.5,用来把论文的「小大约 4 到 8 倍」落到具体刻度上。7.9、3.95、4.0 和两个误差是附录 A.2 里 OAS 相对 OCP 的原例,用来看最大值的钳位误差;OAS 给较小的数扩大表示范围,比较的是标准无饱和缩放,基准不同。
32 个数共用 E8M0 幂次缩放 → 只平移指数、尾数舍入不变 → 正常范围内 E2M3 与 E4M3 量化值相同 → 比块最大值小约 4–8 倍的数掉进非规格区间才变差 → OAS 相对 OCP 减少最大值钳位误差,相对标准算法用轻微饱和给较小的数扩大表示范围
- 32 个连续元素 → 一个 E8M0 缩放沿着 GEMM 的归约维,每 32 个连续元素共用一个 8 比特、只表示 2 的幂次的缩放因子。这个缩放没有符号位,用起来就是把指数平移,个别很大的数只会搅乱自己这一块。块大小 = 32
- E8M0 缩放 → 尾数舍入方式不变E2M3 和 E4M3 都是 3 位尾数。E8M0 缩放本身是 2 的幂,只平移指数、不改变尾数怎么舍入,所以在 E2M3 的正常范围内,每个元素量化后的值和 MXFP8 的 E4M3 相同。尾数位数:E2M3 = E4M3 = 3
- 块最大值 → 非规格数边界E2M3 的上限是 7.5,最小正非规格数是 0.125,动态范围只有 60,比 E4M3 窄得多。论文写明,只有比这块最大值小大约 4 到 8 倍、落到非规格数区间的那些元素,精度才会比 8 比特更差;若这块缩放后的最大值贴近 7.5(示意),这条界大约落在 0.94 到 1.88。7.5 ÷ 8 = 0.9375,7.5 ÷ 4 = 1.875
- 溢出感知缩放 OAS → 块最大值与较小的数附录里若按 MXFP6-OCP 把块最大值映到 7.9,会被钳到 7.5,相对误差 5.06%;OAS 把它映到 3.95,再舍入到 4.0,误差只有 1.27%,相对 OCP 减少的是最大值的钳位误差。相对标准算法(对到 (3.75, 7.5]、避免饱和),OAS 允许最大值轻微饱和,较小的数表示范围扩大一倍,这两种收益的比较基准不同。|7.9−7.5|/7.9 = 5.06%;|3.95−4.0|/3.95 = 1.27%
- 少掉的指数范围 → QSNR 差距在论文采用的均匀量化噪声假设下,如果少的是 1 位尾数,量化间隔会加倍,QSNR 大约降 6.02 分贝。这里少的是指数范围,Model A 全部可比较层上,MXFP6 相对 MXFP8 的逐调用点中位差距是 1.0 dB,最重 20 层上是 1.8 dB。6.02 dB(少 1 位尾数)对照 1.0 dB / 1.8 dB(逐调用点中位差距)
所以 6 比特和 8 比特的差距,主要落在块里那些更小的数上,而不是每一个数都少一位精度。
出处
论文 §4.1:E2M3 与 E4M3 同为 3 位尾数,E8M0 缩放不改变尾数舍入,正常范围内量化值相同;比块最大值小大约 4 到 8 倍的数掉进非规格区间才变差。表 2:E2M3 的 F_max=7.5、F_min=2^{-3}=0.125、动态范围 60。附录 A.2:OAS 把块最大值映到 (3.875, 7.75],标准算法映到 (3.75, 7.5],MXFP6-OCP 映到 (4, 8]。若块最大值按 MXFP6-OCP 映到 7.9,钳到 7.5,误差 5.06%;OAS 映到 3.95,舍入到 4.0,误差 1.27%。相对标准算法,OAS 允许最大值轻微饱和,给较小的数扩大表示范围一倍;相对 OCP,它减少的是最大值的钳位误差。附录 A.1:在均匀量化噪声假设下,每多 1 位尾数,量化间隔减半,QSNR 约升 6.02 dB;少 1 位则间隔加倍,QSNR 约降 6.02 dB。正文走一遍的 Model A 中位差距 1.0 dB / 最重 20 层 1.8 dB 沿用于此对照。0.9375 与 1.875 由 7.5÷8 和 7.5÷4 得出,用于把「小大约 4 到 8 倍」落到贴近上限 7.5 的示意刻度上。缩放因子具体怎么选,作者还用了 Overflow-Aware Scaling(OAS,溢出感知缩放)。它允许块里最大的那个数轻微饱和,换取其余较小的数表示范围扩大一倍。MXFP8 里还要避开 E4M3 的全 1 编码,因为那一档被留作 NaN。这一步的计算放在后文不展开,这里只需记住:缩放不是简单把最大值对到格式上限。
有了格式,还得有能直接吃 6 比特元素的 GEMM 核。作者在 AMD 的 FlyDSL 里实现了 MXFP8 和 MXFP6 核,配置由 AlphaKernel 针对这些生产形状搜索。激活不能先写回内存再另起一个核去做量化,否则准备时间会把 GEMM 省下的时间吃掉。论文测过:在 batch 1024、尚未调优的 MX 核上,如果量化和打包单独跑,测过的线性层合计时间可以到 FP16 的 1.6 到 1.7 倍(MXFP6),MXFP8 甚至到 4.6 到 5.2 倍。他们扩展了 PyTorch Inductor,把取绝对值、求块最大值、缩放、钳位和打包接到上游算子的输出链上,让激活在写出来时就已经是带块缩放的低比特数据。
走一遍:Model A 怎样决定哪些层上 6 比特
下面按论文在两套生产模型上的实测,把「哪些层能换成 6 比特」走一遍。数字都来自论文表 3、表 5 和图 2,不是示意。
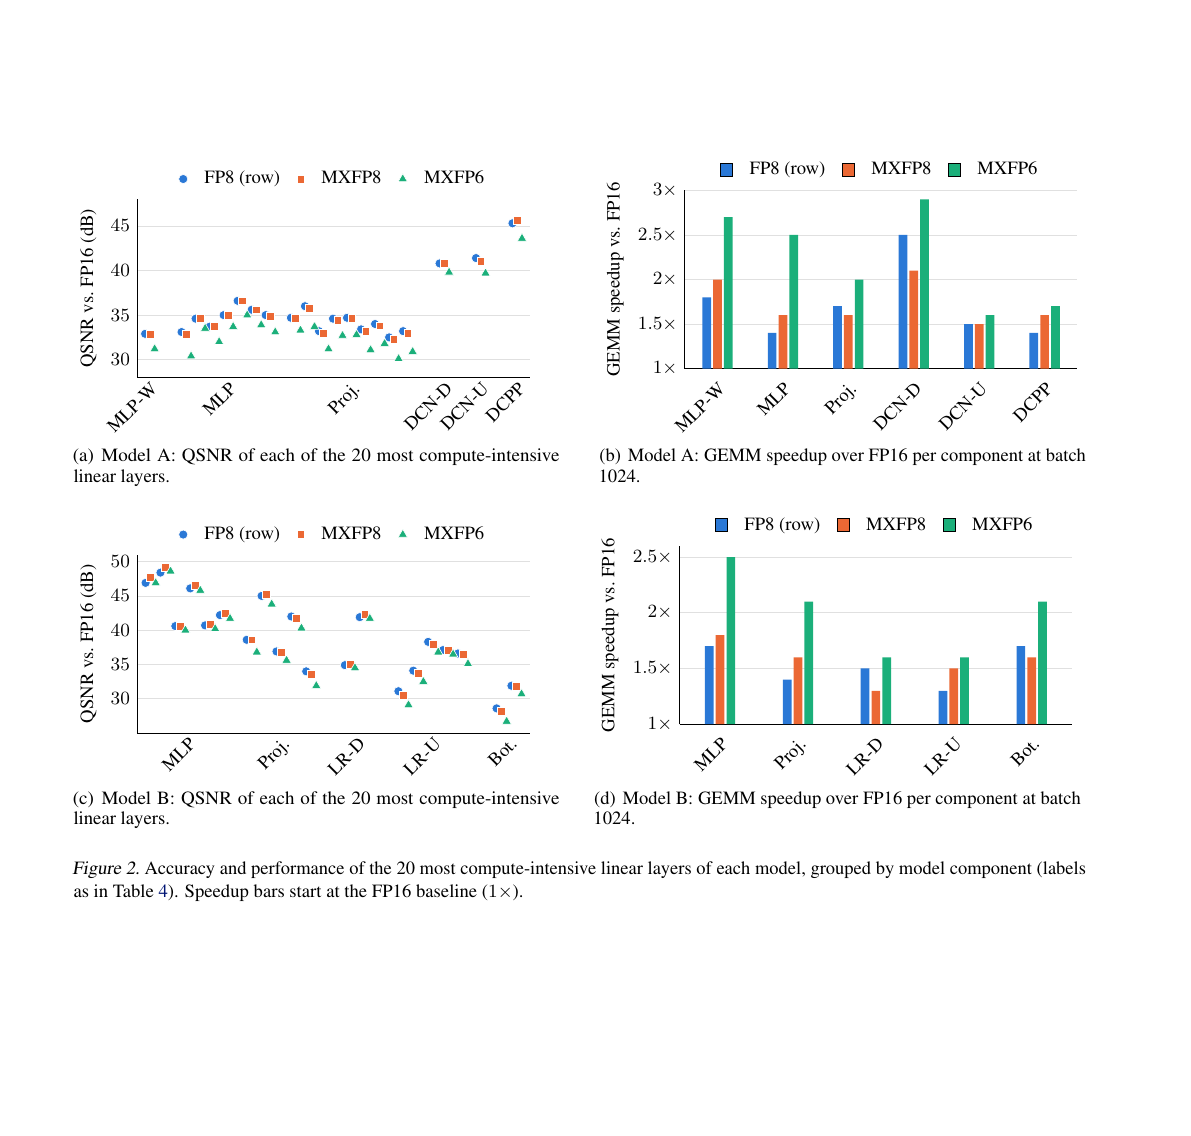
第一步,先给每一层打一个噪声分。作者把各层捕获到的生产输入重新送进这一层,调用真正的低精度核,再把该层输出和同一层的 FP16 输出比,得到 QSNR。每一层比的是自己这一层的量化误差,不把上游低精度误差累加进来。Model A 全部可比较的线性层上,行级 FP8 的中位 QSNR 是 35.6 dB,MXFP8 是 35.4 dB,逐个调用点的中位差距只有 0.1 dB。MXFP6 的中位 QSNR 是 34.0 dB,逐个调用点相对 MXFP8 的差距中位数为 1.0 dB。也就是说,多数层从 8 比特走到 6 比特,噪声只多了一点。
第二步,看最低的那些层,差距会放大。Model A 里,用户序列模块的小层 QSNR 掉到 22.3–23.6 dB。在计算最重的 20 层上,MXFP6 相对 MXFP8 的中位差距是 1.8 dB,高于全层的 1.0 dB。这些层对低精度更敏感,所以不能按峰值吞吐比把所有 GEMM 一律改成 6 比特。
第三步,用上线门槛做裁剪,而不是用 QSNR 直接拍板。作者只替换能把 NE 差留在 0.01% 以内的线性层。Model A 最终有 80.8% 的线性层权重改到 MXFP6(分母是全部不重复的线性层权重,不含 bias 和 embedding),每前向有 27 个 GEMM 跑在 MXFP6 上。论文按这份最终替换清单报告质量,评估过的 6 个预测任务全部落在 0.01% NE 容差内。
第四步,看加速主要从哪一类矩阵来。计算最重的 20 层大约占 Model A 全部线性层参数的 68%,占 GEMM FLOPs 的 67%,占 FP16 GEMM 时间的 49%–54%,所以整体加速主要看它们。其中 DCN 的低秩下投影(DCN-D)在 batch 1024 上,MXFP6 比 FP16 快 2.85 倍,batch 2048 上到 2.90 倍;输入很宽的 MLP(MLP-W)也明显更快。输出很宽、归约维大约是 1000 的层,比如 DCN 的上投影(DCN-U)和 DCPP(Model A 里一套权重网络的输出层),只有 1.59–1.74 倍。这说明大而算力密集的形状吃到了更多低精度峰值,小形状的固定开销降不下来,收益就薄。
第五步,把核时间换成整模型吞吐。端到端计时包含激活准备、GEMM、归约和 host 开销,对照是 Model A 正在用的生产 FP8 配置。七组成对延迟比取几何平均再减 1,得到 QPS 增益:batch 1024 为 +5.3%,batch 2048 为 +1.5%。每一对计时都是 MXFP6 更快,但 batch 变大后增益变小。这说明 6 比特的核加速是实的,可一旦加上准备和其余开销,再对上已经用了 FP8 的生产配置,端到端只能再挤出几个百分点。
Model B 走的是同一套规则。它最终覆盖 72.9% 的线性层权重,每前向 49 个 GEMM 用 MXFP6,3 个任务全部过 0.01% NE,所以同样守住了上线门槛。端到端增益更高:+14.3% 和 +7.6%。它计算最重的 20 层里,对低精度更敏感的是低秩上投影和底部 MLP,MXFP6 的 QSNR 最低到 26.7 dB。尽管如此,全层合计 MXFP6 相对 FP16 仍是 1.73 倍和 1.99 倍,没有一个计算最重层慢于 FP16。
两套模型的端到端结果可以收成一张表。
| 模型 | 改到 MXFP6 的线性层权重 | 相对生产 FP8 的吞吐(1024 / 2048) | 落在 0.01% NE 内的任务 |
|---|---|---|---|
| Model A | 80.8% | +5.3% / +1.5% | 6 / 6 |
| Model B | 72.9% | +14.3% / +7.6% | 3 / 3 |
(数字来自论文表 5)
对计算最重的那些层,MXFP6 相对行级 FP8 和 MXFP8,每个调用点的中位 QSNR 要低 1.2–1.8 dB,换来比行级 FP8 再高 26%–40% 的 GEMM 吞吐。全层看,MXFP8 相对 FP16 的合计加速是 1.33–1.55 倍,MXFP6 是 1.73–1.99 倍,这说明核表上的区间和摘要一致。
核加速为什么没有按 4 倍出现在端到端里
峰值比是 4 倍,全层 GEMM 合计大约 2 倍,端到端只剩几个百分点,中间掉了两截。
第一截在形状。MXFP6 的加速随矩阵变大而升高。附录按计算量分档以后,最大那一档大约占 FP16 GEMM 时间的一半,Model A 上 MXFP6 相对 FP16 是 2.29 倍,Model B 在两个 batch 上是 2.30 倍和 2.37 倍,比 MXFP8 再快 1.31–1.40 倍。小形状就没这么好看。Model B 在 batch 1024 上,45 个形状里有 18 个 MXFP8 慢于 FP16,MXFP6 慢的只有 4 个。最小两档里,MXFP8 相对 FP16 只有 0.79–0.98 倍。这些小 GEMM 里 29 个形状中的 19 个,属于按请求执行、而不是按每条候选广告执行的层,batch 1024 时行数只有 25。所以 8 比特并不是无条件的替代:小而瘦的层,行级 FP8 往往仍更快,MXFP8 更适合作为按形状挑选的备选。
第二截在数据布局。作者改进后的 MXFP6 核,在激活按 K 方向的 tile 主序存放时最快,因为深度流水需要下一块数据在内存里是连续的。端到端实验里,激活仍按行主序打包。于是逐层核表上的加速,不能原样变成全模型 QPS。把这种布局的生产和量化融进更多模型,还要等 PyTorch Inductor 侧的支持。
权重可以离线预打乱并量化,每次前向要动态量化的是激活,端到端计时包含激活准备。MXFP6 的核本身也比 8 比特难写。一个元素有效占用 0.75 字节,32 个元素一块是 24 字节,不是 2 的幂。常见 GEMM 核按 2 的幂做寻址和切块,这条假设在这里不成立。第一版 MXFP6 核在大归约维的形状上,甚至慢于厂商的 FP8 核。后来的深度流水版本用三个本地数据共享缓冲,把当前块的计算和下两块的加载重叠起来。在计算最重的 20 层上,它在两种 batch 下都快于 FP16,并拿到最低的合计 GEMM 时间;部分小形状仍慢于 FP16。这些是实现细节,但它们说明:格式上的 4 倍峰值,不会自动变成核上的 4 倍。
这对做推荐推理的人意味着什么
6 比特能不能上,先看敏感层和矩阵形状,不要只看峰值吞吐比。
如果你的广告或推荐排序也有接近「几乎不许掉点」的上线门槛,可以先按层、用真实输入和真实低精度核去量 QSNR,再在质量门槛下做替换,而不是先把全部线性层改成同一格式。8 比特这一档,MXFP8 和行级 FP8 在这篇的模型上精度几乎一样,可以按每个形状的核速度二选一;但要单独看按请求执行的小层,它们很可能仍是行级 FP8 更快。6 比特这一档,优先放在占 GEMM 时间最多的大矩阵上,收益主要从那里来。
另外,激活量化一定要融进上游核。论文里未融合的准备时间,可以单独把线性层合计时间抬到比 FP16 还慢。如果目标硬件上 6 比特的峰值并不高于 8 比特——论文表 1 里,NVIDIA GB300 的 MXFP6 和 MXFP8 都是 FP16 的 2 倍——能省下的计算会比 MI350X 更窄,更要靠大形状和融合来决定值不值得做。
局限
实验只覆盖两套 Meta 生产广告排序模型,硬件只测了 AMD MI350X。部分调用点因为核对维度对齐的要求没有进入四格式同台比较:MXFP8 要求归约维是 32 的倍数、输出维是 8 的倍数,Model A 因此排除了 20 个调用点,Model B 排除了 3 个。Model B 还有两层归约维不是 32 的倍数,实验里把它们零填充后再计时,FP16 也在填充后的尺寸上比。
端到端的对照是生产里已经在用的选择性 FP8 配置,不是「所有线性层都改成行级 FP8」的对照。质量结论限于评估过的任务:Model A 6 个,Model B 3 个。模型结构以部件标签给出。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…