目录 · 10 节
1它到底在解决什么问题?2全景:从统一格式到现场编译3第一步:为什么要先统一格式描述?4第二步:三份配置和现场编译5第三步:共享部件,维护成本为什么变成按部件算64-bit 存、8-bit 算:W4A8-MXFP47结果:kernel 测速和端到端8我认为它的局限9一个推荐/搜索团队可以怎么试10结论
做大模型推理的团队值得读这篇,它处理的是量化里更基础的麻烦:难的往往不是把权重压到低比特,而是每多一种格式、每换一代 GPU,就要多写并维护一套 kernel。蚂蚁集团和 vLLM 社区开源的 Humming 把量化格式的描述和在某张 GPU 上的执行方式分开,再用一套共享的 CUDA 部件现场编译出需要的 kernel。部件做得轻,编译也快:在 H200 上编译单个 W4A16 kernel,CUTLASS 要 23.35 秒,Humming 只要 1.82 秒。速度也没让步:在 8 张 H20 上跑 DeepSeek-V4.1-Flash,MoE 层换成 Humming 的 W4A8 后,并发 64 时输出吞吐从每秒 442.37 个 token 提到 633.94 个。维护成本从按格式组合算,变成了按部件算,适合要同时支持多种量化格式和多代硬件的推理团队。
它到底在解决什么问题?
先看一个常见的处境(示意)。一个团队同时在线上跑三类模型:一个用 GPTQ 导出的 INT4 稠密模型放在 A100 上,一个权重是 MXFP4 的 MoE 模型放在 H200 上,还有一个 NVFP4 的 MoE 模型准备迁到 B300。
| 模型(示意) | 权重格式 | 激活 | GPU | 负载类型 |
|---|---|---|---|---|
| 稠密生成模型 | INT4,每 128 个权重共用一个 scale | BF16 | A100 | Dense |
| MoE 模型 A | MXFP4 | BF16 或 FP8 | H200 | MoE |
| MoE 模型 B | NVFP4 | NVFP4 | B300 | MoE |
这张表里每一行都可能需要一个专门的 kernel:权重怎么解码、scale 怎么乘、数据怎么从显存搬进来、用哪条 Tensor Core 指令,三行各不相同。按专用 kernel 的做法,格式、GPU、负载类型每多一种,要写的实现就乘上去,每个实现还要配自己的权重预处理、选择逻辑、框架适配和测试。某个优化做好了,也得在几份实现里各抄一遍。
博客把这件事讲得很直接:量化省下的显存和算力,只有配上高效的 kernel 才会变成更低的延迟和更高的吞吐;而 prefill、decode、各个专家负载不均的 MoE,对算力和带宽的要求又各不一样。Humming 的回答是:把“格式描述”和“执行选择”拆开,kernel 用共享部件拼出来。
全景:从统一格式到现场编译
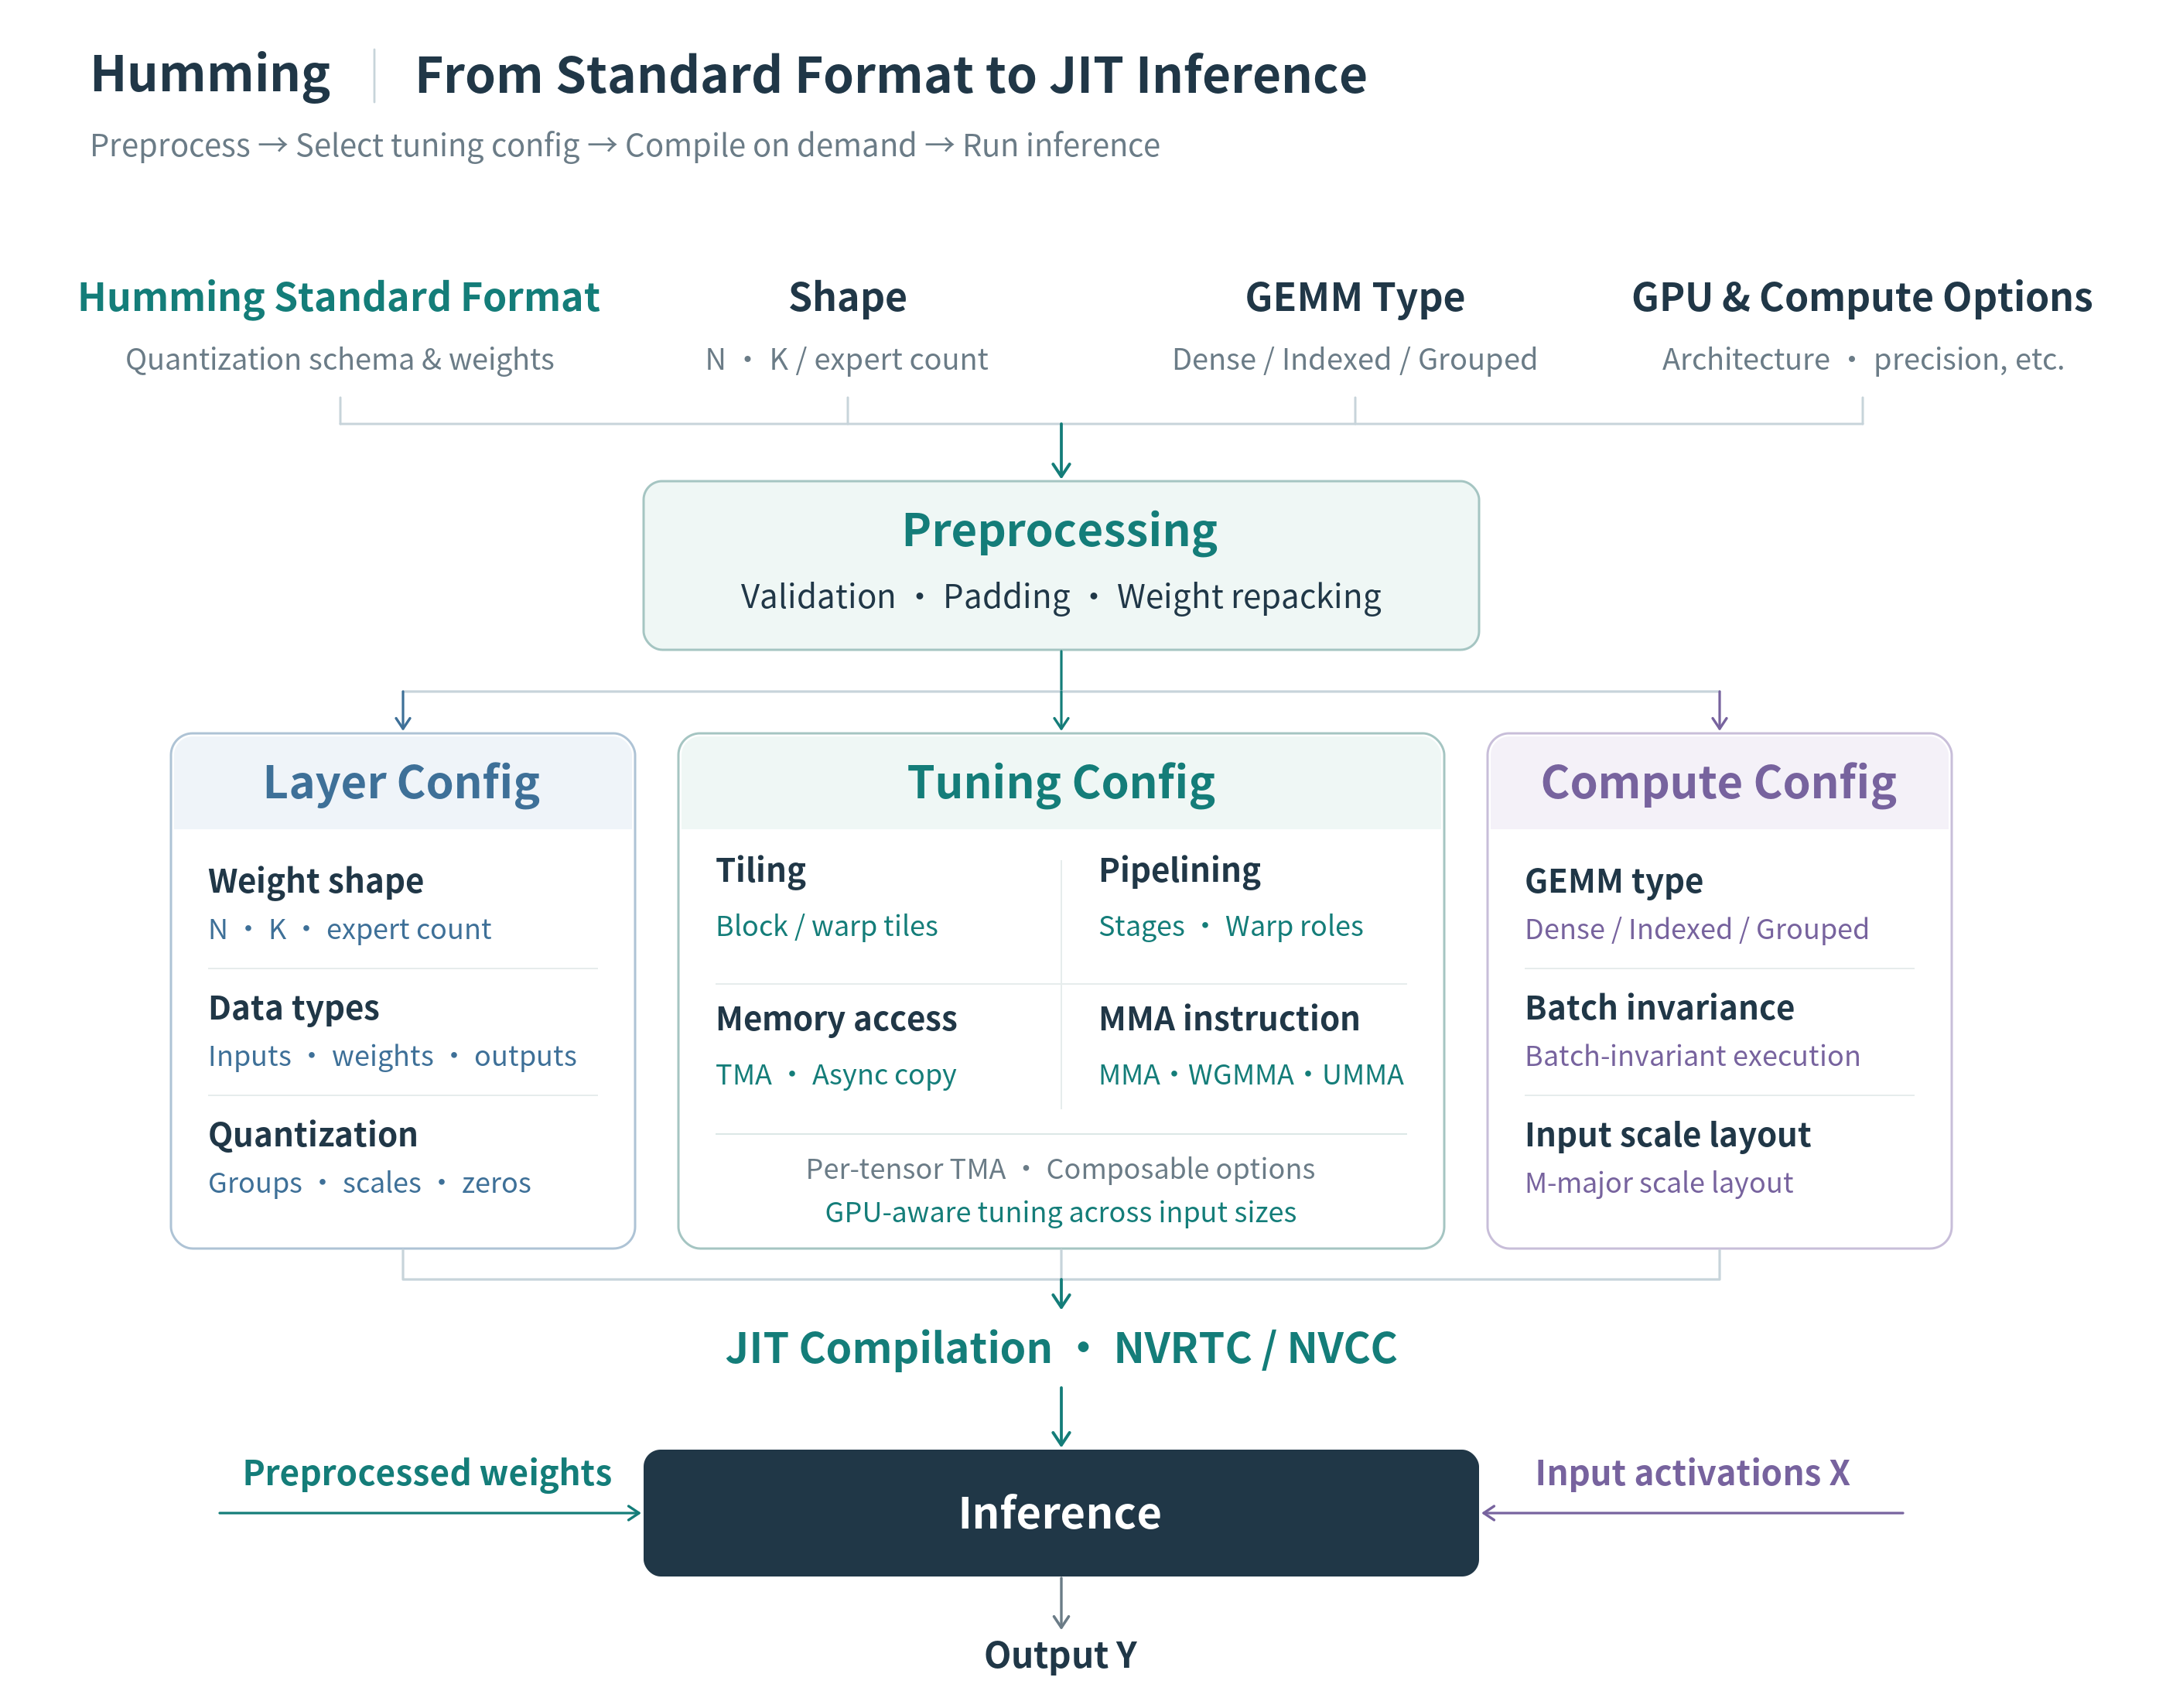
整条路径分四步,每一步产出下一步要用的东西:
- 转成统一格式:把各种量化工具导出的模型,整理成 Humming 自己的标准格式。
- 预处理:校验参数、把维度补齐、把权重重新排成目标 kernel 好读的布局。
- 定三份配置:描述这一层是什么、要算哪种乘法、在这张卡上怎么调度。
- 现场编译并缓存:按三份配置把共享部件拼成一个专用 kernel,编译好的 kernel 缓存起来,推理时直接用。
关键分工是:格式描述回答这些数是什么,配置回答在这张卡上怎么算。量化参数会写进配置,也会限制能选哪些执行方式,但同一份格式描述,可以在不同的卡上配不同的执行方式。下面拆开讲。
第一步:为什么要先统一格式描述?
不同量化工具导出的模型,数值格式、参数怎么组织、权重怎么摆放都不一样。如果 kernel 直接面对这些导出格式,每接一个新工具就要改一遍 kernel 入口。
Humming 的做法是把一个量化方案拆成几个独立的参数:权重用什么格式、scale 覆盖多大一组权重、scale 自己用什么数据类型、有没有 zero point、有没有第二级 scale。激活单独描述自己的格式。这些参数在格式和硬件允许的范围内可以自由组合,原方案的量化含义保持不变。
拿表里第一行举例(示意):它会被写成“权重 INT4、每 128 个权重一组共用一个 scale、scale 为 BF16、对称量化无 zero point;激活 BF16”。换成 MXFP4 的 MoE 模型,只是改几个参数值,描述方式不变。对推理框架来说,不同来源的模型从此只有一个入口。
博客还提到一个小优化:有一种“指数位为零”的浮点格式,能表示的值和同位宽的对称整数完全一样。比如去掉 -128 的 INT8 和 float8e0m7,都只表示 -127 到 127。Humming 会自动把符合条件的对称整数权重改用这种格式存,以便反量化更快。
第二步:三份配置和现场编译
格式统一后,还要决定这一层在这张卡上怎么算。Humming 用三份配置描述一个 kernel:
| 配置 | 回答的问题 | 内容 |
|---|---|---|
| Layer Config | 这一层是什么 | 张量形状、数据类型、量化参数、目标架构 |
| Compute Config | 算哪种乘法 | GEMM 类型(稠密 Dense,或 MoE 用的 Indexed / Grouped)、是否要求 batch invariance(同一条输入不管和哪些请求拼成一批,算出的结果都逐位相同)、输入 scale 的布局 |
| Tuning Config | 在这张卡上怎么调度 | tile 大小、流水线级数、是否让不同 warp 分工、搬数据的方式、用哪条 Tensor Core 指令、并发和调度方式 |
为什么不提前编好所有 kernel?因为组合太多,而且最优选择会随输入大小变。这里的输入大小用 M 表示,是这次矩阵乘法里激活的行数,大致等于这一批一起算的 token 数。博客举的例子是:M 小的时候,用异步拷贝指令(cp.async)配普通 MMA 指令的多级流水线可能更快;M 大的时候,用 TMA(Hopper 起的硬件批量搬运单元)配 Blackwell 的 UMMA 指令吞吐更高。两条路径都在同一套配置和部件里生成。
会不会每个请求都重新编译一次?不会。Humming 默认用按设备写好的启发式规则,针对不同的 M 区间各准备一套配置,在模型预热时并行编译好;运行时只看当前 M 落在哪个区间,分派到对应的 kernel。博客实测,单层 GEMM 覆盖所有支持的 M 大小,编译加载一共约 2–4 秒。一个小走查(示意):decode 时 M=1,落进“小 M”区间,用 cp.async 那套 kernel;一次长 prompt 的 prefill M=4096,落进“大 M”区间,换成 TMA 那套。两套都是预热时编好的。
编译快是这个设计能成立的前提。在 H200、CUDA 13.4、关掉编译缓存的条件下,编译单个 W4A16 kernel,同样用 CUDA 自带的编译器,CUTLASS 要 23.35 秒,Humming 只要 1.82 秒;Humming 改用 CUDA 的运行时编译库,也只要 1.88 秒。正因为编一次只要两秒左右,按负载多备几个专用 kernel 才划算;若一次要二十多秒,预热时间会被拖得很长。代价是这些启发式规则未必在每个形状上都选对,博客自己也把 autotune 列为下一步。
第三步:共享部件,维护成本为什么变成按部件算
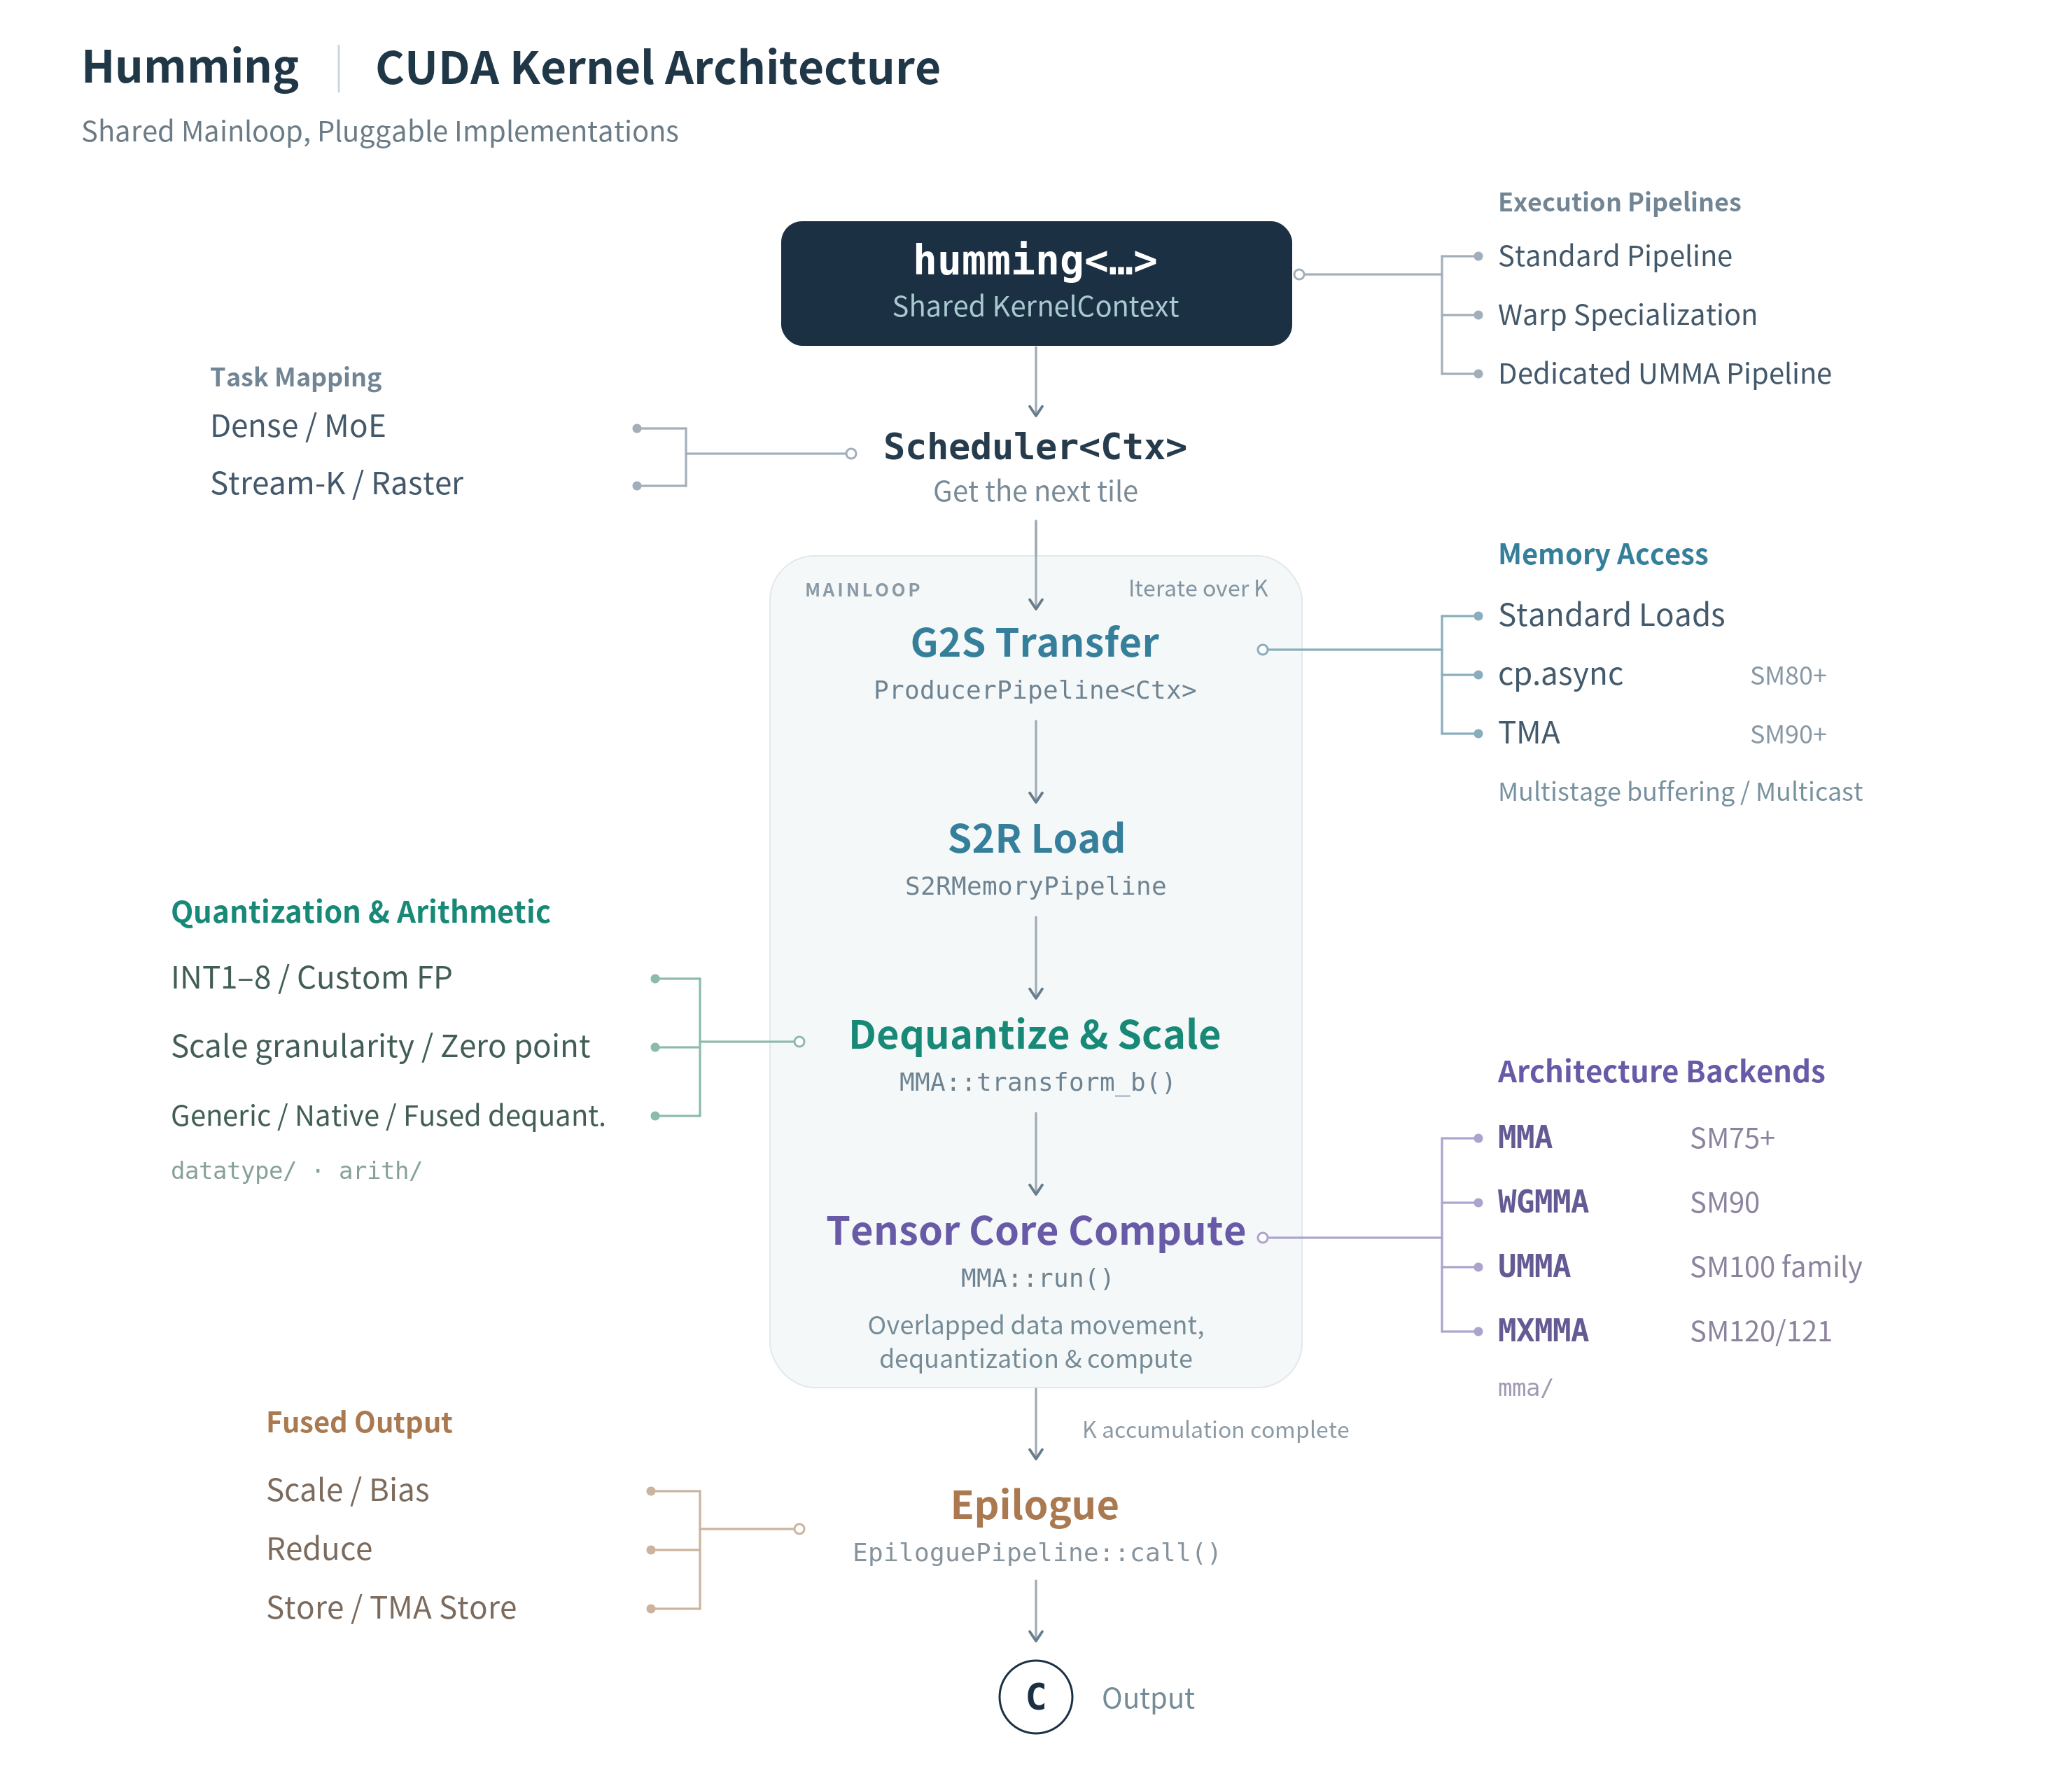
kernel 内部是一条固定的主循环,每一环都可以换实现。读图时看两边挂着的选项:
- 数值处理负责量化格式的差异:位宽、整数还是浮点、scale 和 zero point。反量化和乘 scale 在 kernel 里和计算一起完成,不单独写回显存。
- 访存和计算后端负责 GPU 架构的差异:老卡用普通加载或 cp.async,Hopper 起可以用 TMA 和多播;Tensor Core 指令也按架构选:Turing 到 Ampere 用普通 MMA,Hopper 用 WGMMA(一组 warp 一起发出的矩阵指令),B300 这类数据中心 Blackwell 用 UMMA,工作站和个人电脑上的 Blackwell 用 MXMMA(这一代对应的矩阵指令)。
- 任务映射和调度负责稠密和 MoE 的差异:不同 GEMM 类型用各自的调度逻辑,scale 和 bias 可以并进最后的输出阶段。MoE 的 Indexed 和 Grouped 两条路径,是为 token 分散到各个专家、每个专家工作量随负载变化的情况准备的;博客没说这两条路径怎样用路由信息读取 token 和专家权重,再把结果对应回各个 token。
编译时只把配置选中的实现拼进去,没用到的分支直接去掉。回到开头的表(示意):三种权重格式、三代 GPU、两类负载,按专用 kernel 算最多要 3×3×2=18 份实现;按部件算,是 3 种数值处理加 3 套后端加 2 种调度,共 8 个部件变体。新加一种格式只改数值处理那一组,新出一代卡只改后端那一组,改进某个共享部件,所有用到它的配置一起受益。这就是“维护成本按部件算”的意思。
4-bit 存、8-bit 算:W4A8-MXFP4
越来越多模型直接用 MXFP4 发布权重,可 Blackwell 之前的 GPU 没有能直接算 MXFP4 的 Tensor Core。常规做法在 M 较大时会被反量化和乘 scale 的开销拖住。
Humming 的做法是:显存里仍存 4-bit 权重,kernel 在加载权重时就地把它快速转换成 GPU 能直接计算的格式,博客写的是 INT8 或 FP8。博客测的 W4A8 走的是 FP8 这条:权重转成 FP8 后,和 FP8 激活一起交给 FP8 Tensor Core 相乘。博客没说 MXFP4 每组的 scale 是在转换时乘进权重,还是在乘法之后再乘;它只说反量化和乘 scale 都在 kernel 内部完成,不单独写回显存。为什么这样有用?每个权重 4 bit 只占半个字节,FP8 要 1 个字节,所以每读一遍权重,显存里搬的数据量大约减半;decode 这类小 M 的场景主要卡在读权重,省下的正是瓶颈。
结果对照的是 DeepGEMM 的 W8A8:在中小 batch 下,Humming 的 W4A8 在 H20 上约是它的 4.2 倍,在 H200 上约 4.5 倍,也明显快过 Humming 自己的 W8A8。这说明在老一代卡上,4-bit 权重的好处主要来自少读显存,而不是算得更快。
结果:kernel 测速和端到端
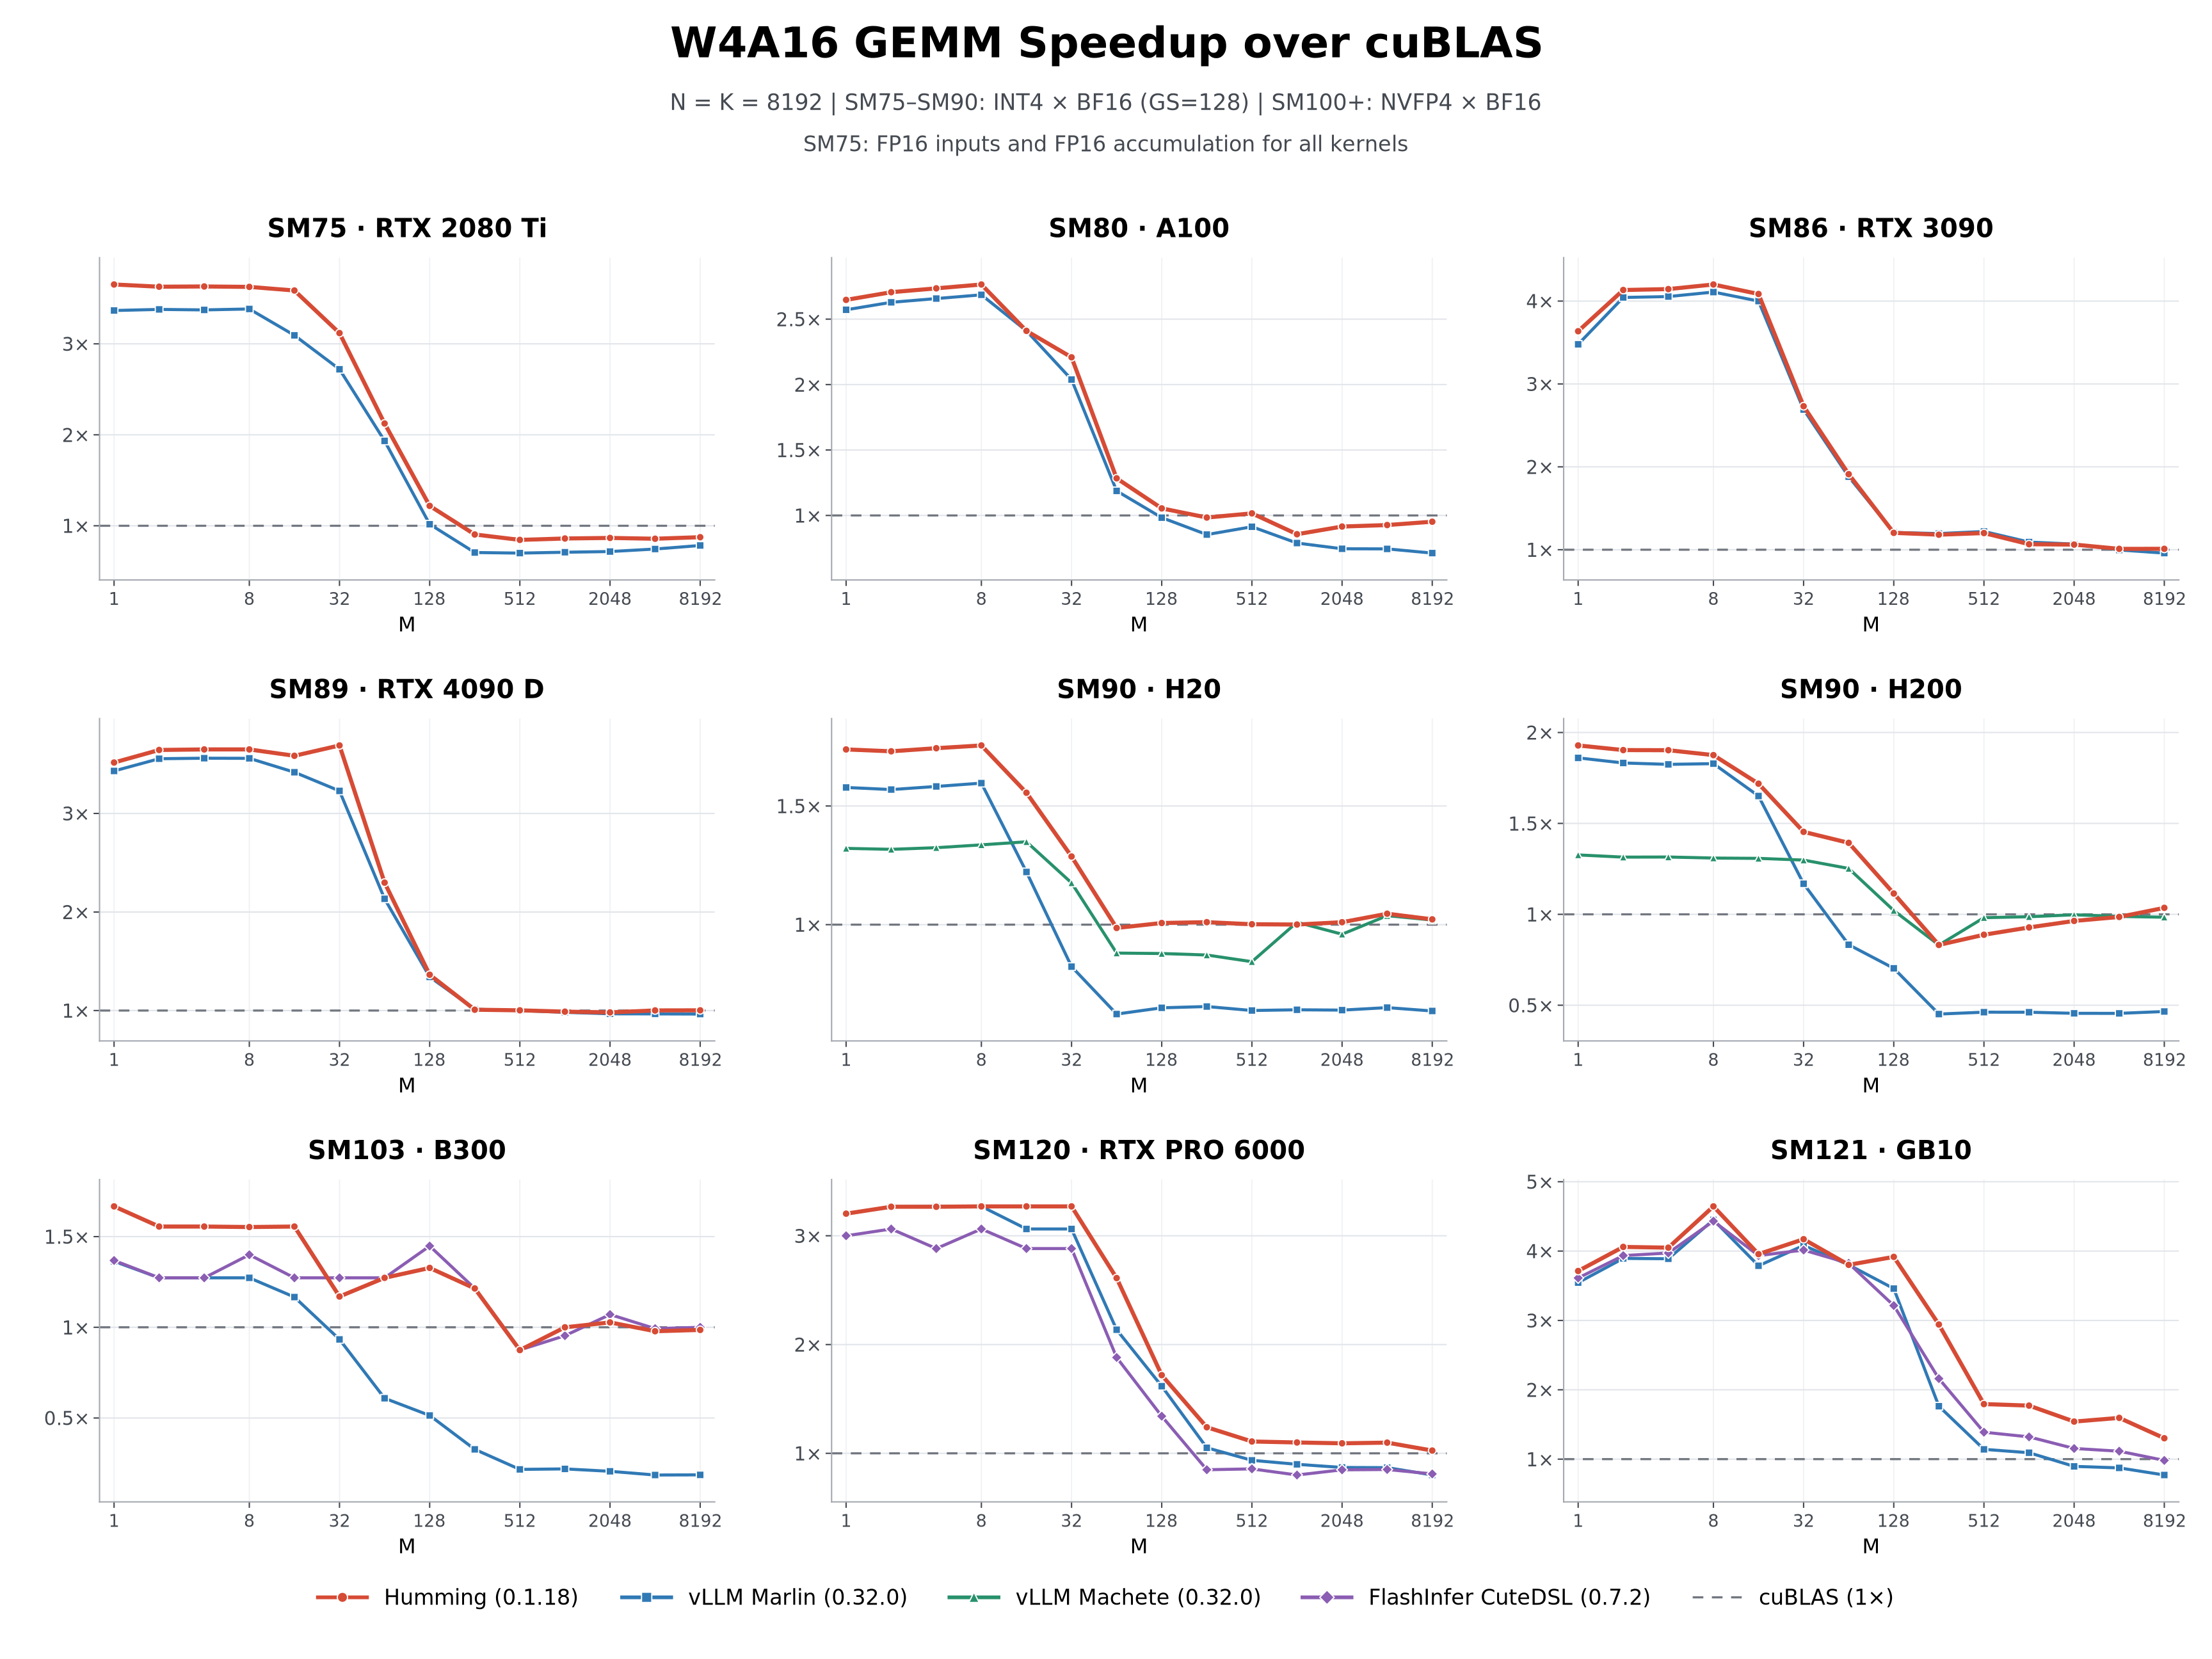
kernel 测速由 vLLM 社区完成,M 从 1 取到 8192 的每个 2 的幂,每次测前清空 L2 缓存;MoE 的加速比按 Gateup 和 Down 两个 GEMM 的延迟之和算。
- 稠密 W4A16:小 batch 下在几张卡上相对 cuBLAS 约快 3–4 倍;大 batch 下 H200 上约是 Marlin 的两倍,B300 的部分形状超过三倍。这说明它不只在 decode 有优势,prefill 这类大 M 场景也没有掉队。
- MoE W4A16:B300 上 MXINT4(按小块共享 scale 的 4-bit 整数)和 NVFP4 的 Grouped 路径在大 batch 下约是 Marlin 的 5 倍。MoE 每个专家分到的 token 数随负载变化,这个结果说明它的 MoE 调度在大 batch 下很有效。
- W8A8:在 H20 和 H200 的中小 batch 下,约是 DeepGEMM Contiguous 的 2.6 倍和 2.5 倍。FP8 W8A8 本来就是 Hopper 上成熟的路径,还能再提升,说明收益不全来自低比特格式本身,也来自搬数据和调度。
- B300 原生微缩放格式(MX,每一小块数共用一个 scale 的低精度格式):W8A8、W4A8、W4A4 分别约是同精度 DeepGEMM 的 1.25、1.6、1.4 倍,提升明显比 Hopper 小,因为这里对手也能直接用原生低精度指令。
端到端测试在 8 张 H20(TP=8)上跑 DeepSeek-V4.1-Flash,MXFP4 权重不变,只把 MoE 从 Marlin W4A16(BF16 激活)换成 Humming W4A8(每个 token 一个 scale 的 FP8 激活)。博客没说这些 FP8 激活和每个 token 的 scale 由哪个模块、在哪一步产生;不过下表是整机测的,这一步的开销已经算在里面:
| 并发 | 后端 | 输出吞吐(tokens/s) | 平均 TTFT(ms) | 平均 TPOT(ms) |
|---|---|---|---|---|
| 1 | vLLM Marlin W4A16 | 88.30 | 543.13 | 9.24 |
| 1 | Humming W4A8 | 100.77(+14.1%) | 383.80(-29.3%) | 8.46(-8.5%) |
| 8 | vLLM Marlin W4A16 | 287.04 | 2049.81 | 19.90 |
| 8 | Humming W4A8 | 383.04(+33.4%) | 1386.91(-32.3%) | 15.49(-22.2%) |
| 64 | vLLM Marlin W4A16 | 442.37 | 5467.35 | 123.25 |
| 64 | Humming W4A8 | 633.94(+43.3%) | 3882.94(-29.0%) | 85.70(-30.5%) |
吞吐提升从并发 1 的 14.1% 涨到并发 64 的 43.3%,首 token 延迟在各档都降了约三成。并发越高 MoE 层的 GEMM 越大,kernel 的优势在整机上体现得越多,所以高并发的在线服务最能吃到收益。
我认为它的局限
第一,端到端只测了一个模型、一种机器,而且同时换了两样东西。表里的 14%–43% 既包含 kernel 本身,也包含激活从 BF16 降到 FP8;博客给的只有吞吐和延迟,FP8 激活下的模型效果要自己测。要上线,效果评测得自己补。
第二,测速多是“中小 batch 下约几倍”这类说法,大 M 一侧优势会收窄。从 W4A16 那张图看,H200 上 M 在 256 附近时 Humming 也低于 cuBLAS 的 1 倍线;SM121(GB10 这类个人 AI 电脑上的 Blackwell 架构)小 batch 下相对 FlashInfer CUTLASS,W4A8 只快约 19%,W4A4 只快约 9%。prefill 占比高的业务,收益会比标题数字小。
第三,执行配置靠设备启发式规则来选。博客自己承认模型形状、量化配置和设备资源组合太多,规则不可能处处选到最优,autotune 还在计划里。遇到不常见的层形状,可能得手动调 Tuning Config。
一个推荐/搜索团队可以怎么试
越来越多推荐和搜索团队在线上跑 LLM:生成式召回、LLM 精排、query 改写。可以这样试:
- 先在现有 vLLM 上只换后端:vLLM 0.29.0 起自带 Humming,用
--linear-backend humming --moe-backend humming打开,模型和量化格式都不动。对比同一份压测流量下的 TTFT、TPOT 和吞吐,看纯 kernel 收益有多大。 - 再试激活精度:MoE 模型若权重已是 MXFP4,在 Hopper 上试 W4A8(把 MoE 激活设成 FP8)。这一步会改数值,要同时跑离线效果评测(召回率、排序 AUC 或人工评审),确认吞吐提升没有换来效果下降。
- 按流量形状验收:分别压 decode 为主(短输入、长输出)和 prefill 为主(长 prompt、短输出)两种流量。若 prefill 占大头而收益不明显,对照上面局限第二条,检查是不是大 M 区间没选对配置。
- 盘点 kernel 维护面:如果团队维护着多套量化格式的自研 kernel,把它们列成“格式 × GPU × 负载”的表,看哪些能被 Humming 的一个配置替代,减少要维护的实现数。
结论
最关键的启发是:量化推理的瓶颈常常不在格式本身,而在为每种组合维护 kernel 的成本;把格式描述、执行配置和 CUDA 部件三者拆开,能同时解决覆盖面和性能。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。量化格式和 GPU 代际都在快速增加,专用 kernel 的维护成本随组合数增长 |
| 方法创新性 | 中高。统一描述加部件化不算全新思路,但把它做到覆盖 Turing 到 Blackwell、稠密和 MoE 的程度少见 |
| 实验证据 | 中。kernel 测速覆盖面广,但端到端只有一个模型一种机器,也没有效果评测 |
| 工程成本 | 低。vLLM 0.29.0 起自带,换后端只需一个启动参数;wheel 包约 500 KB |
| 是否值得尝试 | 值得。已用 vLLM 跑量化 MoE 模型的团队,先换后端压测,成本几乎为零 |
| 适用场景 | 多种量化格式并存、多代 GPU 混用、高并发的 LLM 在线服务 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…