目录 · 6 节
1问题:现成的自动调优工具,要么搜不到,要么会“调坏”2方法:智能体负责找,固定代码负责判3结果一:比公开的最强配方还快4结果二:同样的预算,比其他调优器找得更好5闸门本身靠得住吗6局限与实践意义
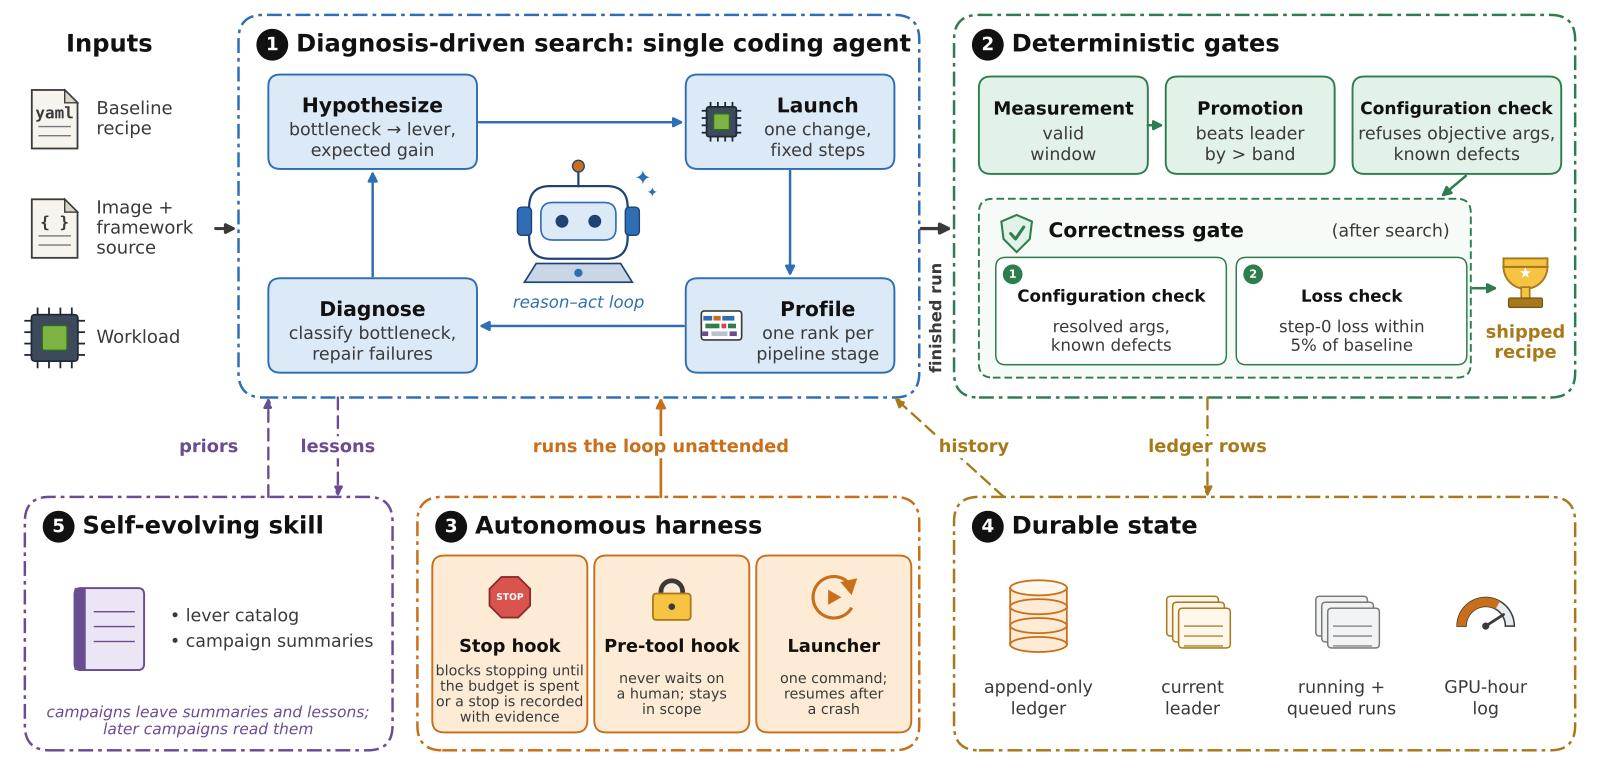
训练一个大模型之前,工程师要先定一份“训练配方”:模型怎么拆到几十上百张 GPU 上、显存不够时拿多少计算去换、用哪些底层计算程序、GPU 之间的数据传输怎么和计算同时进行。同一个模型换一种 GPU 或换一个框架版本,原来最快的配方往往就不再最快。Amazon 做了一个叫 ATTUNE 的系统,让一个能写代码、跑命令的 AI 智能体来调配方:给它一份能跑通的配方和一笔 GPU 小时预算,它自己反复试、自己分析瓶颈,不需要人盯着。但这篇论文真正的看点在智能体之外:一道由固定代码执行、智能体改不了的“正确性闸门”,凡是会悄悄改变训练内容的改动,在启动前就被拒绝。Amazon 内部三个模型的微调任务换上调好的配方后,训练速度平均提高到原来的 1.7 倍,最多 3.9 倍。
1. 问题:现成的自动调优工具,要么搜不到,要么会“调坏”
训练配方里有很多可以调的“杠杆”。最重要的是模型怎么拆分:可以把每一层的矩阵切开分给几张卡,也可以把不同的层分给不同的卡像流水线一样接力,还可以把数据分成几份让几组卡各算一份。另外还有:显存不够时,要不要把中间结果丢掉、需要时再重新算一遍(用计算换显存);要不要把一部分数据暂存到 CPU 内存里;用哪个版本的注意力计算程序。
现有的自动调优工具大致有三类。第一类按一个估算性能的公式,在事先列好的选项里挑。第二类是“黑盒”搜索,比如贝叶斯优化:不理解系统怎么工作,只是一次次试跑、根据结果决定下一次试什么,但每次试跑都很贵。第三类是最近出现的大模型调优器,比如 OptiCo,能读性能分析结果,但同样只能在一张固定的旋钮列表里调。
作者有两个观察,决定了 ATTUNE 的设计。
第一,现成配方没吃到的速度,有一部分藏在要一起改才见效的杠杆组合里,还有一部分藏在固定列表根本没列出来的杠杆里,比如换一种在多张卡之间分发数据的程序。
第二,有些配置会悄悄改变训练的内容,而训练照样跑完、不报错。举两个例子。在“混合专家”模型里,每个输入词会被分给少数几个“专家”子网络处理。有一个常用的提速参数,会限制每个专家最多处理多少个词,超出的词就直接丢掉不训练了。另一个参数看名字只是“用较低精度传梯度”,实际上还会让梯度累加也变成低精度。只检查“能不能跑起来”的调优器,会把这两种配置都当成“优化”交出去,训练出来的模型却和原来不一样。
2. 方法:智能体负责找,固定代码负责判
一次调优叫一个“战役”:固定一个模型、一个集群、固定数量的 GPU。所有候选配方训练的东西完全一样:模型、数据、每条数据的长度、每步处理多少条、数值精度都不变,每次运行还按同样顺序读同样的数据。每次试跑固定若干步,前几步用来热身、不计分,之后按平均每张 GPU 每秒处理多少个词打分。
速度测量有噪声,所以要先确定“多快才算真快”。原配方至少在不同的机器上跑 5 次,求出平均速度,以及标准差占平均值的比例 。噪声门槛取 3% 和 中较大的那个;新候选必须比当前最快的快出这个门槛以上,才能取而代之。这样就不会把一次碰巧跑得快当成真的改进。
智能体用的都是普通工具:读写文件(包括训练框架的源代码)、执行命令、调用集群接口。一份写好的“调优守则”给它定了六条纪律,最重要的三条是:
- 每次启动前,先写下假设:要缓解哪个瓶颈、为什么有效、预计快多少;
- 每次只改一个杠杆,或者一组必须一起改的拆分方式,这样结果好坏才能归因;
- 用一个参数之前,先去框架源代码里读它的实现,看它会不会悄悄连带改掉别的参数,并把代码位置记进账本。
瓶颈不明显时,智能体会做一次性能分析:一个固定的分析程序把每一步训练的时间拆成计算、GPU 之间传数据、CPU 那边的工作和空等四部分,告诉智能体时间主要浪费在哪。
花钱由固定代码把关。记账脚本从集群分配机器那一刻算到释放为止,失败的运行和检查用的运行都算在内,预算不够就不让启动。一个失败过的配方原样重跑也会被拒绝,逼着智能体先找出原因再改。
正确性闸门分两步,这是整个系统的核心。
第一步在启动前,比较候选配方和原配方最终生效的所有参数和环境变量。要比最终值,是因为一个参数可能悄悄改掉别的参数。每一处改动都要到一张登记表里查,这张表智能体改不了。会改变训练内容的(数据、每步多少条、优化器、损失函数、路由方式、数值精度),或者会触发已知软件缺陷的,直接拒绝;只改变“怎么算”而不改变“算什么”的,比如换一种在 GPU 上摆放数据的方式,直接放行;表里没有的,先放行到第二步,并写进报告请人复核。
第二步在启动后,比较训练第一步的损失值,也就是模型在第一批数据上的错误程度。第一步时权重刚加载、还没更新,候选和原配方面对的是同一组权重、同一批数据,算出来的损失本应几乎相同。合法的改动只会因为计算顺序不同带来极小的差异;而如果权重加载错了或拆分错了,损失会成倍变化。所以规定第一步的损失必须和原配方相差不到 5%,而且整个试跑里损失不能出现无穷大或无效值。 Hoot 说

三个示意候选(原配方第一步损失 2.3)
- A:换 GPU 上的数据摆放
- 登记表放行;损失 2.302,差 0.09% → 通过
- B:一个看似无关的开关
- 最终生效值里每步样本数变了 → 启动前拒绝
- C:表里没有的拆分开关
- 先放行;权重拆错,损失 4.6,差 100% → 拒绝
B 说明为什么要比最终值:只看改动的那一项,它看起来没碰训练内容。
第一步损失的盲区
- 为什么能比
- 权重还没更新,候选和原配方算的是同一个东西
- 看不见:优化器、学习率
- 第一步损失在更新前,改了也一样 → 只能靠登记表直接拒
- 看不见:后面才炸的数值问题
- 靠整个试跑不许出现无穷大或无效值
两道闸门是互补的:一道管“算什么”,一道管“算对没有”。
左栏三个候选和它们的损失值都是示意;右栏是按“第一步还没更新”推出来的盲区,论文没有逐条列出。 出处: 论文 §2:正确性闸门两步:启动前比对最终生效的参数和环境变量并查智能体改不了的登记表;启动后第一步损失与原配方相差 < 5%,整个试跑不得出现无穷大或无效值
为了真正无人值守,作者在 Claude Code 外面加了几道钩子:预算没花完、也没有带着证据写明停止理由之前,智能体不能结束;它想问人问题时,改为“取默认值并记录假设”;不认识的破坏性命令会被拦下。所有运行记录写进一个只能追加的账本,系统崩了也能从账本恢复。战役结束后智能体写下心得,经人审核后放进经验库,给下次用。
3. 结果一:比公开的最强配方还快
作者先在自己的集群上原样复现了 NVIDIA 官方的四个基准配方,其中三个和 NVIDIA 公布的速度相差不到 2%,说明起点是公平的。从这些配方出发,ATTUNE 又提速 7% 到 26%,比 NVIDIA 公布的数字高 6% 到 17%。然后作者拿四个开发时没见过的模型,从别人写好的公开配方出发调优。
| 模型 | 硬件 | 提速 |
|---|---|---|
| Qwen3-30B-A3B | 8 张 H100 | +9.9% |
| GPT-OSS-20B | 8 张 H100 | +17.4% |
| Llama-3.1-70B | 64 张 H100 | +26.4% |
| GLM-4.5 | 128 张 B200 | +33.9% |
| MiniMax-M2 | 64 张 B200 | +164.2% |
| Llama-3.1-405B | 128 张 B200 | +6.8% |
| Mixtral-8x22B | 128 张 H100 | 0%(保留原配方) |
能提速多少,取决于原配方和当前环境差得有多远。MiniMax-M2 的原配方本来是为 128 张卡上的强化学习写的,把优化器的数据放在 CPU 内存里来省显存;换到 64 张卡做普通训练后,这一招反而拖慢速度。ATTUNE 关掉了它,又调整了流水线的拆法,速度提到原来的 2.6 倍。GLM-4.5 的配方是为 H100 写的,到了 B200 上,诊断发现瓶颈变成了跨机器传数据和频繁启动小计算任务。ATTUNE 于是缩小专家并行的范围,让每个专家组只占一台机器上的卡。这样每个词要发去的专家都在本机,专家之间交换数据不再跨机器;路由规则和模型都没变,只是专家放在哪些卡上变了。最快的那次还把张量并行降到 1。Llama-3.1-70B 换了更快的注意力计算程序,计算时间占到每一步的 98.5%,几乎不再空等。Mixtral 和 405B 的配方本来就是厂商针对同款硬件调过的,能挖的空间很少;Mixtral 最好的候选没有超出噪声范围,所以按规则保留原配方。
4. 结果二:同样的预算,比其他调优器找得更好
作者给每种调优方法同样的预算:30 倍于一次原配方试跑的 GPU 小时,用同一道闸门和同样的发布规则,每个模型各跑 3 次。在 GLM-4.5 上,ATTUNE 平均提速 33.9%,只花了 669 GPU 小时、6.4 小时;OptiCo 一点没提升,却花了 1,407 GPU 小时;随机搜索提速 7.8%;贝叶斯优化只有 1.8%。在 MiniMax-M2 上,ATTUNE 是 164.2%,最好的对手是 55.5%。这说明 ATTUNE 不只找到了更快的配方,调优本身也花得更少。
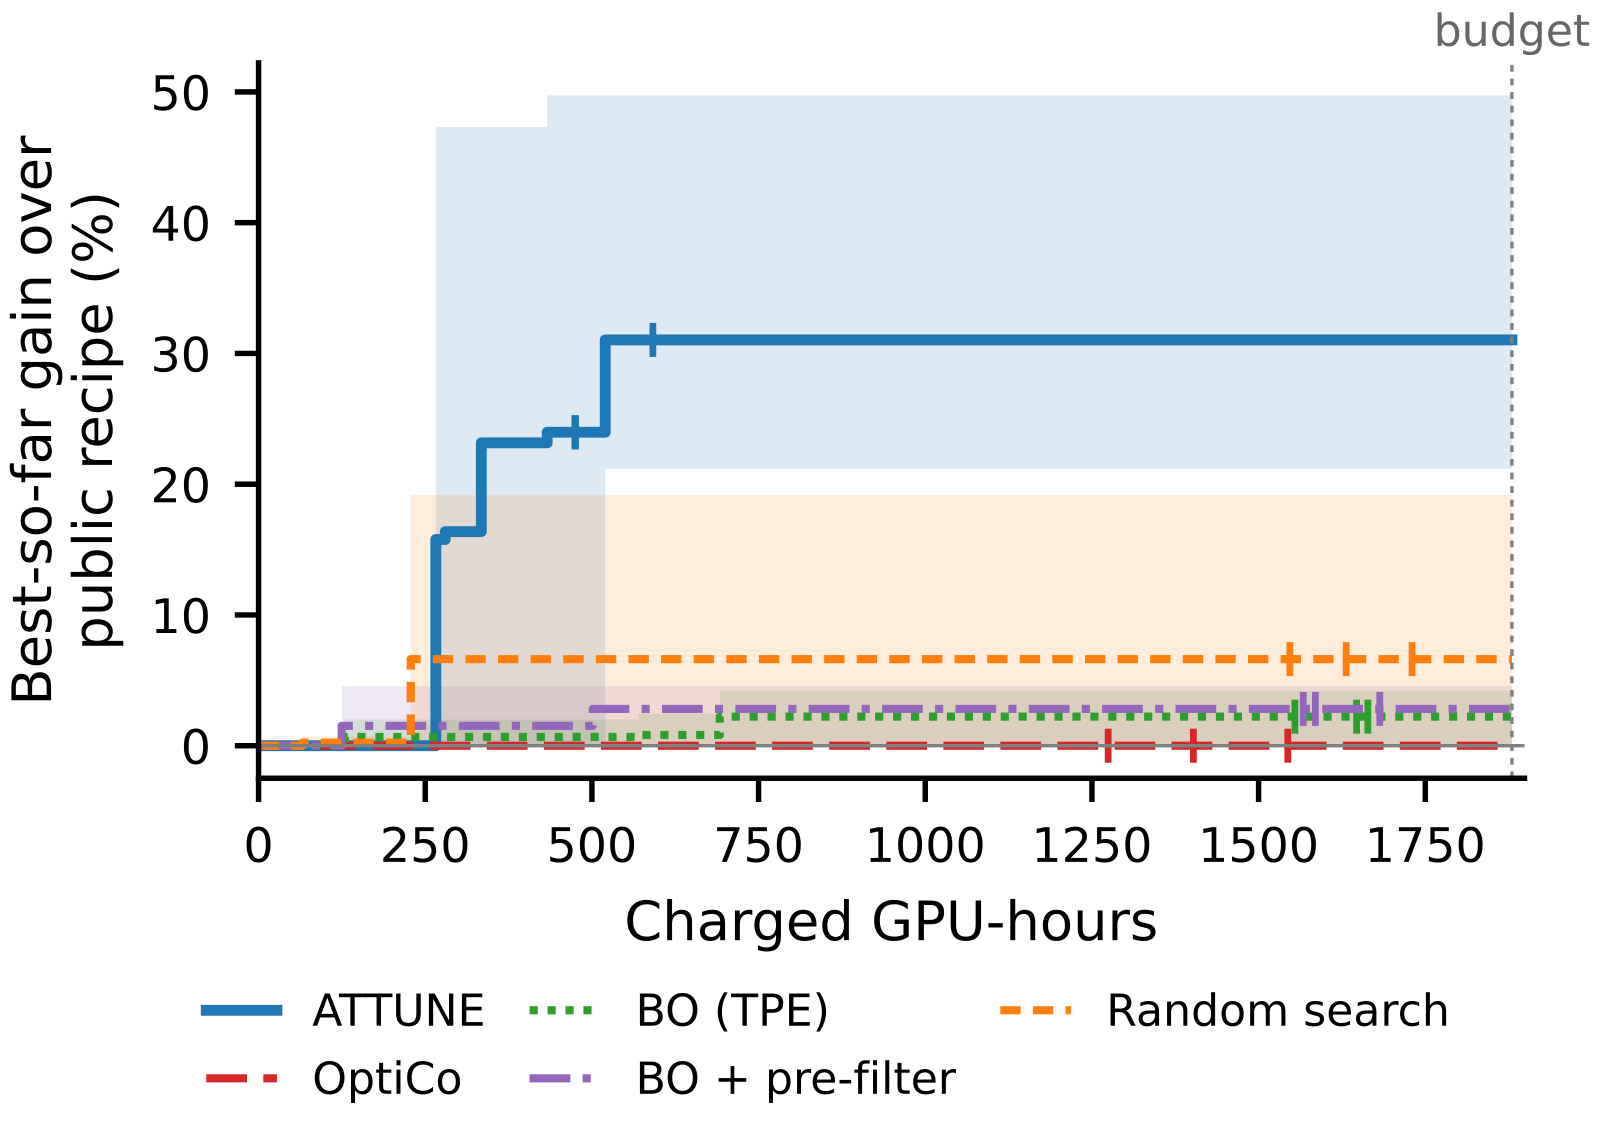
最有意思的是 OptiCo 的失败原因。ATTUNE 在 GLM-4.5 上找到的那种拆法,其实就在 OptiCo 能调的 11 个旋钮范围之内:只用这 11 个旋钮复现这种拆法,速度和 ATTUNE 的最终配方只差 2%,但 OptiCo 没找到:它只在较浅的流水线上试过相关设置,专家之间的数据交换也一直跨机器。黑盒搜索的范围里明明有答案,可没有诊断来指路,大多数尝试要么显存爆掉,要么比当前最快的慢而被淘汰。这说明 ATTUNE 的优势主要来自“先看瓶颈再动手”,而不只是能改的东西更多。
作者还逐个拿掉 ATTUNE 的部件看影响。拿掉调优守则和经验库后,两个测试模型的提速分别从 88.0% 降到 66.9%、从 49.4% 降到 42.9%,一半的试跑没能正常启动。只允许改 OptiCo 那 11 个旋钮时,GLM-4.7-Flash 只剩 18.1%,因为它最大的收益来自关掉“把优化器数据放 CPU”,而这一项不在列表里。
5. 闸门本身靠得住吗
作者专门测试了闸门。460 次合法运行全部放行,所有配置类错误都在启动前被拒绝。作者又故意往代码里埋了 6 种错误:改变模型前向计算的 2 种,让第一步损失涨了 150% 以上,被抓住了;只在更新权重时才起作用的错误,比如漏掉一部分梯度的汇总,第一步根本看不出来;损失计算时标签错开一个词,只让损失变了 2%,和合法改动的最大差异差不多。这几种都漏了过去。
实战中闸门也立了功。在 Nemotron-3-Nano 上,配置检查拦下了 19 次“各段层数不均匀”的流水线拆法。其中一次恰好是所有试跑里最快的,但它把别的层的权重加载进了错误的层,第一步损失比正常高出 215% 到 768%。没有闸门,这个“最快配方”就会被交出去。
6. 局限与实践意义
作者列出三点局限。第一,闸门只看配置和第一步,只在权重更新时才起作用的错误查不出来,所以正式使用前还要完整训练一次做验证。第二,经验库来自过去的调优,GLM-4.5 和开发时用的模型同属一个家族,部分收益可能来自“见过类似的”。不过不用经验库时,GLM-4.5 的结果和完整版差别在噪声以内。第三,ATTUNE 只调框架开放出来的配置,不改底层计算程序和代码,也不覆盖强化学习中让模型生成样本的那一段。还有一个教训:作者回头核对经验库,发现大约五分之一的条目是错的,有的只在当初测出它的那个任务上成立。
对训练平台团队,最值得借鉴的是闸门和记账,而不是智能体本身。不管调优是人做还是智能体做,都可以先建一套检查:比较最终生效的参数差异,查一张不可修改的“哪些改动会改变训练内容”登记表,再比较第一步损失。这样就能把“丢掉超额的词”“低精度累加梯度”这类悄悄改变训练的参数挡在启动前。预算要从分到机器算到释放,失败的运行也要算。如果你的配方是从别的硬件、别的任务(比如强化学习)搬过来的,自动调优的回报最大;如果用的是厂商针对同款硬件调好的配方,预期收益要小得多,论文里这类配方只提速 0% 到 26%。经验库要定期对照原始记录核查,只留下模型自己不知道、或者能纠正它错误直觉的条目。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…