目录 · 8 节
1它到底在解决什么问题?2VEIL 怎么搭:先看全景3为什么照抄攻击能让检测失明?4检测器错的时候还很自信5换数据集、换模型、换检测方法,结论会变吗?6我认为它的局限7一个推荐团队可以怎么试8结论
刷单检测几乎只报一个 AUROC,可这个数说明不了检测器什么时候可信。这篇论文搭了一套叫 VEIL 的审计框架来检查这件事:在冻结的用户 embedding 上学一个打分,用来区分真实账号和刷单注入的假账号,同时报告检测器对自己的判断有多大把握。用它一测,从经典注入到 GAN 生成、再打乱评分风格的假账号都能被抓住,AUROC 在 0.936 到 1.000 之间。换成“照抄真实用户”的攻击后,结果完全不同。这种攻击让每个假账号复制一个真实用户评过的全部电影,再塞进 1 到 3 部要推的目标电影。在 MovieLens-1M 上,检测的 AUROC 掉到 0.48–0.51,和随机猜一样。
可这些假账号并不难抓。直接拿原始评分记录,算每个账号和其他账号评过的物品有多少重合,取最大的那个值当分数,AUROC 就有 0.92–0.97。问题出在 embedding 上:LightGCN 只看评过哪些物品,再经过图传播把相似账号抹平,原始数据里“和某个真实用户几乎一模一样”这个信号就丢了。做推荐反作弊的团队值得读,因为 embedding 检测是常见做法,而这个盲区只看 AUROC 发现不了。核心思想一句话:表示里没有的信号,换什么分类器、加什么不确定性估计都补不回来。
它到底在解决什么问题?
刷单检测要做的,是把注入推荐系统、专给目标物品打高分的假账号挑出来。论文的出发点是:几乎每篇检测论文只报一个 AUROC,可这个数说明不了检测器什么时候可信。
用一个小例子看照抄攻击为什么难。下表是示意:
| 账号 | 评过的电影 | 评分 |
|---|---|---|
| 真实用户 U | 电影 1、2、3、4、5 | 5、3、4、2、4 |
| 假账号 F(照抄 U) | 电影 1、2、3、4、5,加目标电影 T | 照抄 U 的分,T 打 5 分 |
| 早期假账号 G(随机注入) | 随机 5 部电影,加 T | 随机分,T 打 5 分 |
G 评的电影是随机挑的,和任何真实用户都不像,所以容易抓。F 和 U 只差一部电影,两人评过的电影的 Jaccard 是 5/6,约 0.83(示意)。如果检测器只能看到“评过哪些电影”,F 看起来就和一个普通真实用户差不多。不过直接比原始记录,F 和 U 高度重合这一点仍然能看出来。论文把这种攻击叫 donor-mimicry,被照抄的真实用户叫 donor,下文叫“照抄攻击”和“原主”。
作者按难度从易到难排了一组攻击。最容易的是经典的随机、平均、跟风注入。其次是 GAN 生成的假账号(AUSH)。再往上,是在 AUSH 上把假账号做得更像真人(下文叫“打乱风格”)。这时每个假账号的评分条数从真实用户的条数分布里抽,陪衬物品(为了像真人而顺带评的非目标物品)按热门程度和偏好随机挑。目标物品的评分在 4 到 5 分之间随机抖动,每个假账号还各有自己的打分偏高偏低和波动。最难的一档是在打乱风格的基础上再叠加照抄攻击:每个假账号照搬一个真实用户评过的物品和评分,再塞进 1 到 3 部目标电影。
VEIL 怎么搭:先看全景
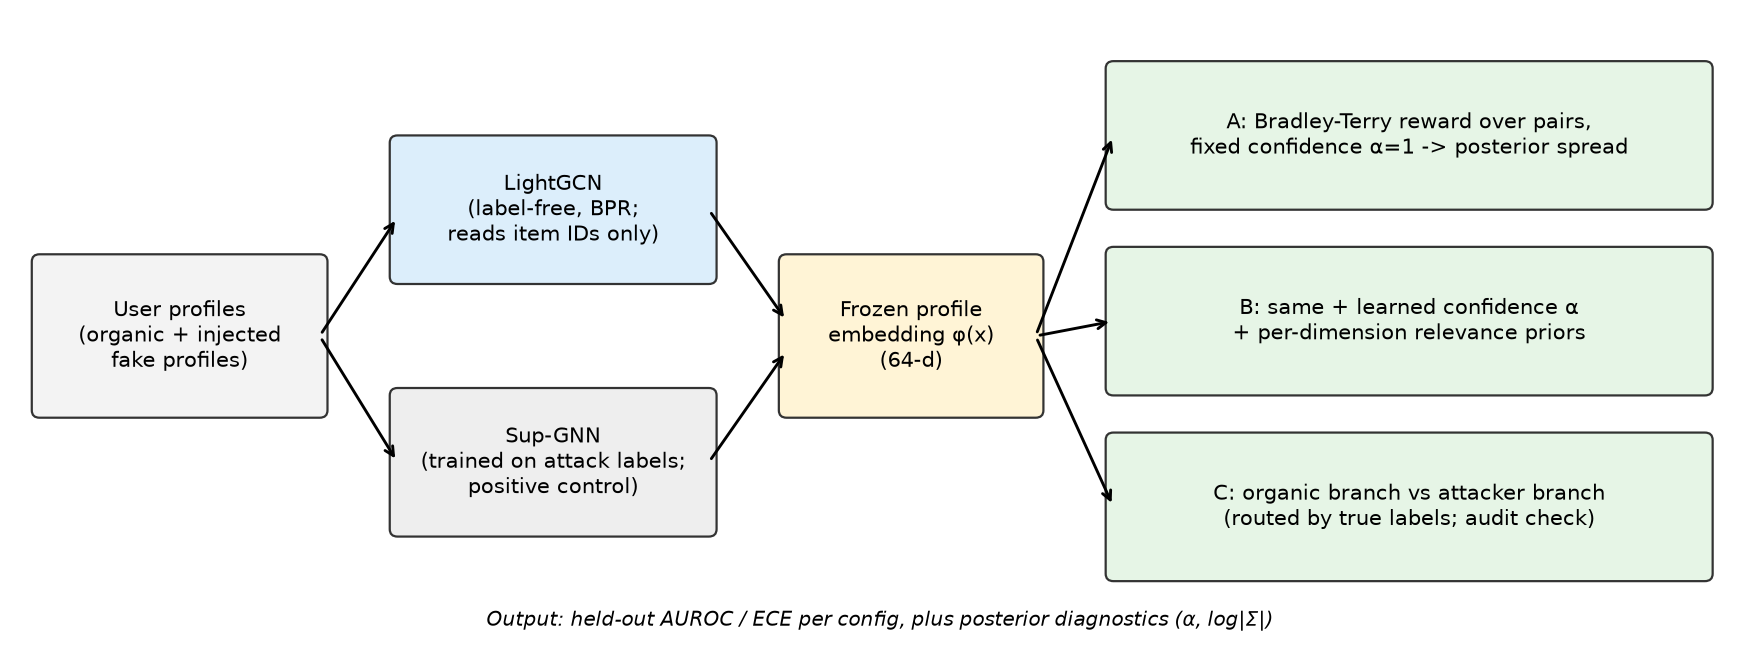
整个流程分四步。第一步,用一个编码器给每个账号算出 embedding(LightGCN 是 64 维),之后冻结不动。编码器有两种。一种是 LightGCN,只用 BPR 排序损失在被注入后的用户–物品图上训练,从没见过“谁是假账号”的标签,这是诚实的测试。所有账号,包括之后留作测试的账号,都是这张图上的节点;编码器训练完后给每个账号取出 embedding,再把账号分成训练集和测试集。另一种是 Sup-GNN,直接用假账号标签训练,embedding 里本来就编码了答案,所以它只当正对照,结果好是意料之中。
后面三步都在这些冻结的 embedding 上做。训练时,作者每次把一个真实账号和一个假账号配成一对,学一个线性打分 ,其中 是账号 x 的 embedding, 是要学的打分方向。目标是让每一对里两个账号的分差能稳定地分出谁真谁假,概率写成:
是 sigmoid, 是“把分差放大多少倍”的信心系数。直觉上,两个账号的分差越大,模型越确定谁是谁。比如 、分差为 2 时,概率是 (示意)。作者说明,没有序列决策的话,这本质上就是在 embedding 差上做贝叶斯逻辑回归。检测时不再配对,每个账号单独打分:取 θ 的一个点估计,分数就是账号 embedding 在这个方向上的投影 。再用训练集账号的标签拟合一条一维逻辑曲线(只有斜率和截距两个参数),把分数换成“是假账号的概率”,后面的 ECE 和可靠性图都用这个概率。留出的测试账号的标签只在评测时用到。
VEIL 有三个组件,下面只讲前两个。第三个组件 C 是作者用真实标签做的正确性检查,不能部署,这里不展开。
- 组件 A: 固定为 1,学 的后验分布。分布越宽,说明这组数据对“该往哪个方向打分”越含糊。
- 组件 B:在 A 的基础上把 也当成要学的量,并给 embedding 的每一维单独学一个“这一维有多重要”的先验,不重要的维度权重会被压向 0。学到的 是审计信号:模型愿意把多少分差当真。
为什么照抄攻击能让检测失明?
作者把原因追到了 LightGCN 代码里的两个函数。建图函数把每个“用户–物品”评分对都变成一条不带权重的边,不管评了 1 分还是 5 分。BPR 损失只接收物品 ID,从不读评分。所以 LightGCN 的 embedding 只反映一个账号评过哪些物品,经过图传播再掺进“还有谁也评过这些物品”,评分高低完全进不去。 Hoot 说

原始评分记录:看物品重合度
- 真实用户(原主)评过
- 甲 乙 丙 丁 戊
- 照抄的假账号评过
- 甲 乙 丙 丁 戊 + 目标物品
- 共有物品 ÷ 两者合计物品
- 5 ÷ 6
- 重合度(示意)
- ≈0.83
为什么能抓到:真实用户之间很少这么像,所以“和别人的最大重合度”当分数就很灵。论文里假账号和原主的重合度中位数是 0.96。
LightGCN 的 embedding:信号被抹平
- 评分数值
- 不进建图,也不进 BPR
- 假账号连到的物品
- 和原主几乎同一批
- 图传播之后
- 假账号被拉向原主
- 到原主的平均距离
- 1.98(无传播的 MF 是 3.09)
检测器只能看 embedding:假账号在这里和真实用户挤在一起,换什么打分器都分不开。
左栏是示意:一个真实用户评过 5 个物品,照抄的假账号评了同样 5 个,再加 1 部目标物品。右栏的距离是论文在同一份被注入数据上的测量。 出处: 建图与 BPR 的说明、重合度中位数 0.96、距离 1.98 与 3.09 均见论文对 LightGCN 盲区的代码追溯和距离测量;左栏重合度为示意手算。
这就解释了攻击阶梯上的现象。打乱风格里改评分数值的那部分,LightGCN 根本看不到,所以检测只从 1.000 小降到 0.94 左右,没有崩。照抄攻击是第一个连“评过哪些物品”都和真实用户对齐的攻击,所以只有它让检测崩到随机水平。
作者再把这件事写成一个一般结论(命题 1)。假设检测用的 embedding 只取决于账号的一部分信息,论文叫它“结构签名”。对 LightGCN 来说,结构签名是账号评过哪些物品(去重后)及这些评分记录里的物品共现结构,评分数值全部丢掉。如果假账号和真实账号的结构签名分布完全相同,那么任何建在这个表示上的检测打分,不管多复杂、怎么训练,AUROC 都恰好是 0.5。打个比方:一个只看黑白照片的鉴定师,分不出只有颜色不同的两件衣服,换更厉害的鉴定师也没用,因为颜色信息在拍照时就丢了。这里“拍黑白照”对应 LightGCN 只看评过哪些物品、完全不读评分,“颜色”对应被丢掉的评分数值。照抄攻击连评过哪些物品也几乎照搬原主,所以在 LightGCN 能看到的这部分信息上,假账号和真实账号几乎一样。照抄攻击只是近似满足这个条件:假账号之间共享那 1 到 3 部目标电影,留了一点残余信号,所以 MovieLens-1M 的两个照抄配置 AUROC 在 0.48 到 0.54 之间,而不是每次都恰好 0.5。
作者还做了直接测量。攻击生成时没存原主是谁,作者用物品重合度把原主找回来:重合度中位数是 0.96,91 个假账号里有 81 个能确定原主。然后在同一份被注入的数据上,比较假账号到原主的 embedding 距离。LightGCN 把假账号放得离原主更近:平均欧氏距离 1.98,而去掉图传播的版本(层数设为 0,等价于 BPR 矩阵分解 MF)是 3.09。这和“图传播把假账号往原主那边抹平”的解释一致,不过作者也说明,单个配置的结果还不足以证明因果。
检测器错的时候还很自信
只看 AUROC,看不出检测器在失败时还有没有自知之明。作者对每个配置跑了 8 个随机种子,同时报告 AUROC 和 ECE。
| 配置 | 组件 A 的 AUROC | 组件 A 的 ECE |
|---|---|---|
| 经典注入(易) | 1.000 | 0.006 |
| AUSH + 打乱风格 | 0.945 | 0.090 |
| CiaoDVD 经典注入 | 0.877 | 0.177 |
| Musical Instruments 照抄攻击 | 0.805 | 0.263 |
| MovieLens-1M 照抄攻击(叠加在打乱风格之上) | 0.494 | 0.374 |
表中数字是 8 个种子的均值。AUROC 不低于 0.94 的配置,ECE 都不超过 0.09。AUROC 低于 0.88 的配置,ECE 在 0.18 到 0.37 之间。这说明检测器在难的攻击上不只是判错,而且判错时还很自信。
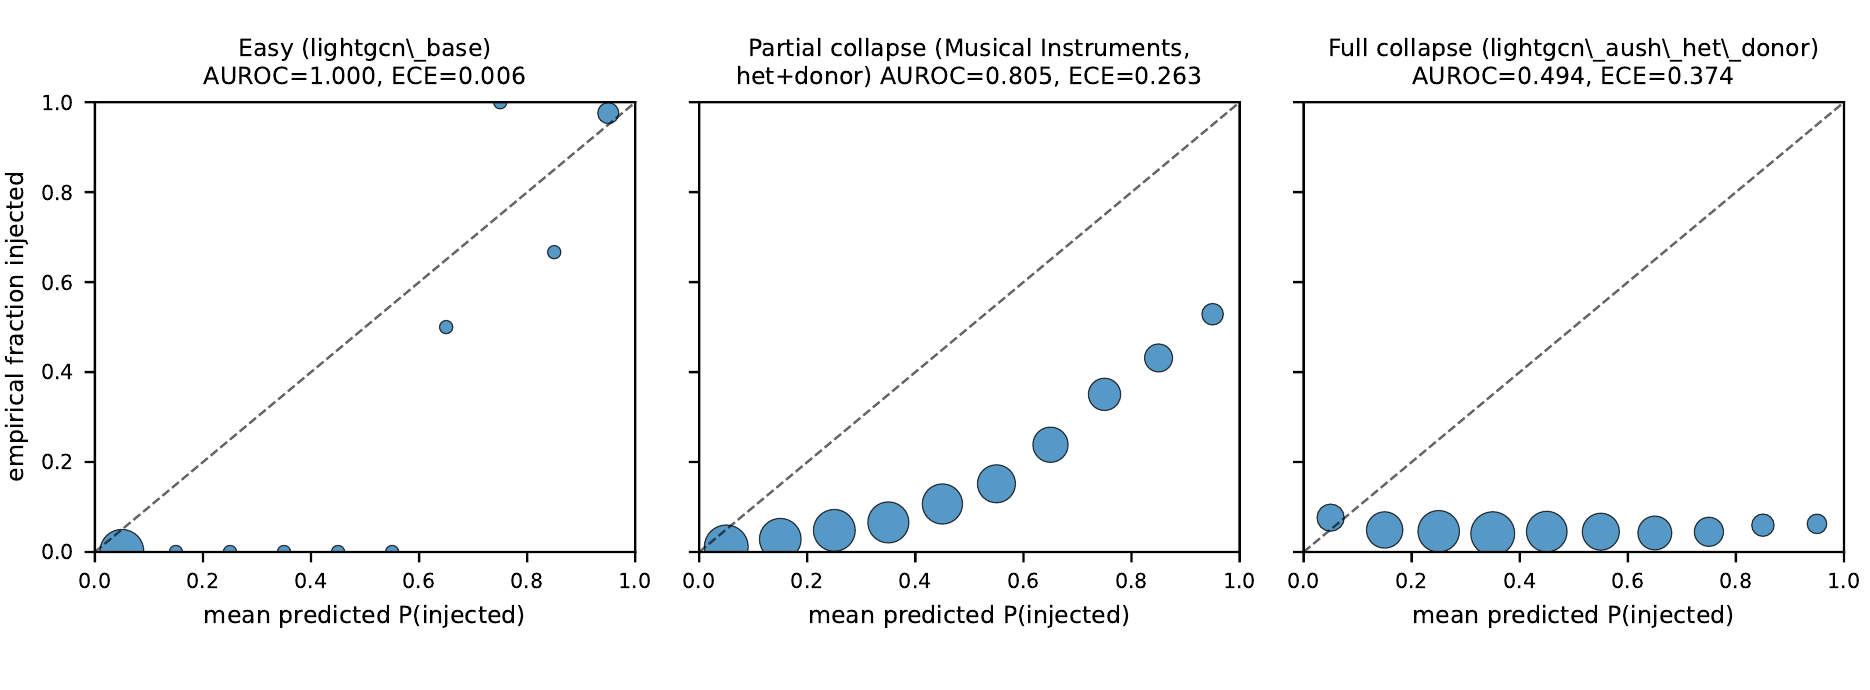
组件 B 学到的信心系数 也没有按“容易就自信、难就犹豫”变化。在 LightGCN 的攻击阶梯上,最容易的两档 最低(0.386 和 0.329),最高的是还能分开的最难一档(0.688),检测已经崩溃的照抄攻击反而回到中间(0.551)。作者把这个倒 U 形明确标为事后解读: 跟踪的可能是还剩多少可用的分差信号,而不是 AUROC 意义上的难度。对读者来说,这意味着不能把学到的信心直接当成“这次检测可不可信”的开关。
换数据集、换模型、换检测方法,结论会变吗?
作者在另外两个数据集上用同样的攻击配方重跑,都去掉了 AUSH。MovieLens-1M 也按这个配方重跑一遍,方便对齐。
| 数据集 | 经典注入 AUROC(组件 A) | 照抄攻击 AUROC(组件 A) |
|---|---|---|
| MovieLens-1M(同配方) | 0.999 | 0.533 |
| Amazon Musical Instruments | 0.991 | 0.805 |
| CiaoDVD | 0.877 | 0.846 |
崩溃程度差别很大。MovieLens-1M 几乎掉到随机,Musical Instruments 掉了约 0.18,CiaoDVD 几乎没掉。CiaoDVD 主要是因为经典注入下的起点就只有 0.877,没多少可掉的空间。作者试过用物品数量和每个用户的评分数来解释这种差别,两者都对不上。
换编码器时,排名也会翻转。在 MovieLens-1M 的照抄攻击上,MF 比 LightGCN 稳(0.632 对 0.481–0.494)。在 CiaoDVD 上反过来,LightGCN 更稳(照抄攻击下 0.846–0.848 对 0.764)。在 Musical Instruments 上,作者先修正了攻击生成器:原版把目标物品总是放在最后、时间戳间隔整齐,序列模型 SASRec 靠这个位置破绽就能拿到 0.9997 以上,不算真本事。修正后让目标物品顶替原主某个物品的位置和时间。四种编码器的排名是 MF 0.940、SASRec 0.901、去掉位置信息的平均池化 0.874、LightGCN 0.800。这里 LightGCN 的 0.800 来自修正后的生成器,上表的 0.805 来自原生成器。LightGCN 是其中唯一做图传播的编码器,又排在最后,和前面“传播把假账号抹向原主”的距离测量对得上。
换检测方法也一样。作者拿经典的评分统计特征(比如一个账号的评分偏离各物品平均分多少)加逻辑回归做对照。MovieLens-1M 上两者一起崩,VEIL 从 1.00 掉到 0.53,经典方法从 0.982 掉到 0.584。CiaoDVD 上经典方法掉得更多,从 0.840 掉到 0.617,VEIL 几乎没掉。这说明三个维度互相影响,在一个维度上得出的排名,换一个维度就不一定成立。
我认为它的局限
第一,主实验只有 MovieLens-1M 一个数据集的完整攻击阶梯,另外两个数据集只跑了最易和最难两档,而且三者崩溃程度差别的原因还没找到。CiaoDVD 的经典注入起点只有 0.877,它“抗住了照抄攻击”的结论要打折扣。
第二,对照太少。检测方法只对比了经典的评分统计方法,没有和近年基于学习的刷单检测器比。 的 8 个种子只换了推理阶段的随机性,每个配置的编码器只训练了一次,所以那个倒 U 形还不稳。
一个推荐团队可以怎么试
- 先在现有检测流程里加一个最便宜的原始重合度检查:对每个账号算它和其他账号评过物品集合的最大 Jaccard。打分不用任何标签,只在离线算 AUROC 时用标签。论文里它在照抄攻击上的 AUROC 有 0.92–0.97,用稀疏矩阵分块相乘就能算。它对经典注入基本无效,所以只能补充、不能替代原有检测器。
- 做一个照抄攻击的红队测试集:复制真实用户的完整行为,再塞进 1 到 3 个目标物品,注意保持原有顺序和时间间隔,否则序列模型会靠位置破绽虚高。
- 每种攻击单独报告 AUROC 和 ECE。如果某类攻击下 ECE 明显升高,说明检测器在这里判错还很自信,不能只看总体 AUROC 上线。
- 检查检测器用的表示到底丢了哪些信息。比如编码器是否读评分数值、是否经过图传播。丢掉的信息恰好是攻击者能对齐的地方,就要用不依赖这个表示的特征补上。
结论
最关键的启发是:检测器能看到什么,决定了它最多能抓到什么。一个只报 AUROC、不审计校准、不换数据集和编码器检查的检测结果,可能离随机猜只差一个攻击设计。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。照抄真实用户的成本很低,而基于 embedding 的检测是常见做法 |
| 方法创新性 | 中。审计框架照搬已有模板,作者也承认照抄类攻击早有人提;新意在把失效原因追到具体函数并写成命题 |
| 实验证据 | 中。攻击阶梯和跨数据集检查做得细,但只有 CPU 规模、三个公开数据集,对照方法少 |
| 工程成本 | 低。最有用的结论是加一个原始 Jaccard 检查,用稀疏矩阵分块计算即可 |
| 是否值得尝试 | 值得。至少把照抄攻击加进红队测试,并按攻击类型分开报告校准 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…