
长对话记忆和长文档检索里,一条记录常常很长,真正回答问题的只是其中一句。单向量检索把整条记录压成一个向量,能找到“在聊同一件事”的记录,却容易漏掉“恰好含有所需细节”的那条。这篇论文不训练新检索器:向量模型在算出最终向量之前,已经为每个 token 算过一遍上下文表示,作者把这些表示存下来,另建一个 token 级索引,查询时让查询里的每个 token 去找最像的记录 token,再和原来的整条相似度融合。在 Qwen3-Embedding-4B 上,八个数据集的平均 Recall@10 从 62.5 提高到 73.8,完全不用训练;再只训练查询一侧的一个小低秩修正,可以到 75.7,但这一步在小模型上几乎没有收益。
做 RAG、智能体记忆或长文档问答检索的团队值得读,因为它说明手里现成的向量模型还有一份没用上的信息,复用它只需要多存一份索引。代价是存储:完整 token 索引比单向量索引大几十倍,压缩后仍大十倍左右。实验全部是离线检索指标,没有线上服务的数据。
它到底在解决什么问题?
单向量检索的打分只有一个点积:查询向量和记录向量越接近,排得越前。当记录很短、话题单一时,这很好用。但在对话记忆里,一条记录可能是一整段聊天,里面先聊了天气、工作,最后才提到“下周三去看牙医”。问“我什么时候看牙医”时,和这段聊天话题相近的其他记录很多,整体向量分不出谁含有这个日期。
论文图 1 是一个真实例子:只用整条向量时,相关记录排第 28 名;加上 token 匹配后升到第 1 名。在 LoCoMo 对话记忆数据集上,这种做法让前 10 名里的命中总共多了 523 次(扣掉变差的之后)。
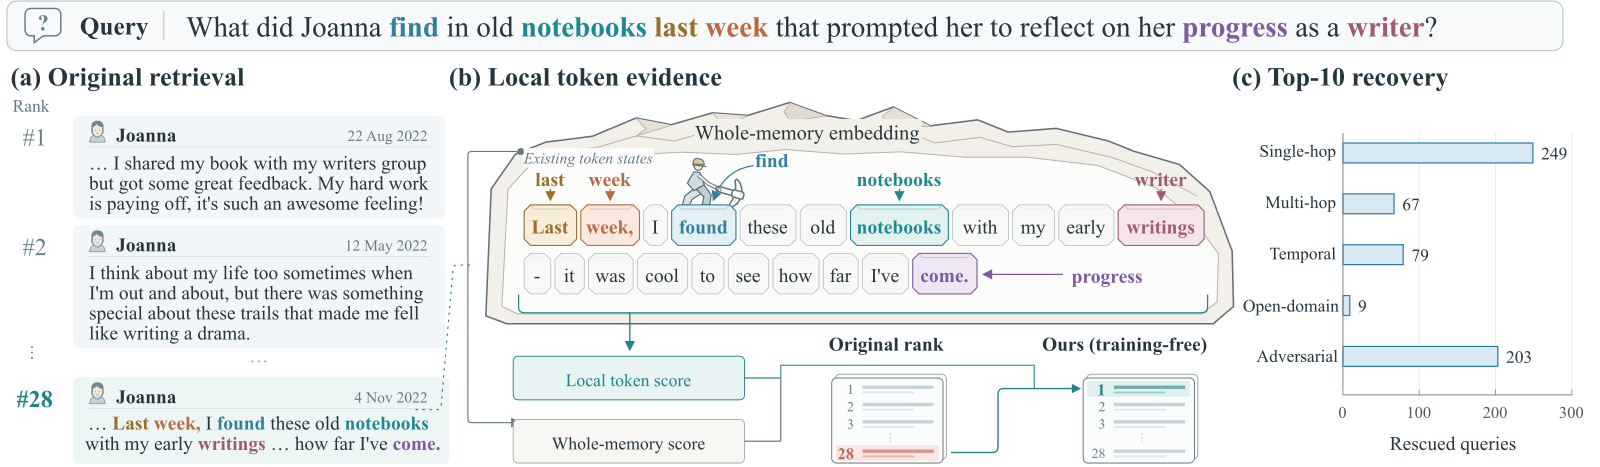
这个思路和 ColBERT 一类“每个 token 留一个向量”的检索器相近。区别在于那些方法要专门训练一个 token 编码模型,这篇直接复用现成的、冻结的通用向量模型。
方法:两条打分通道再融合
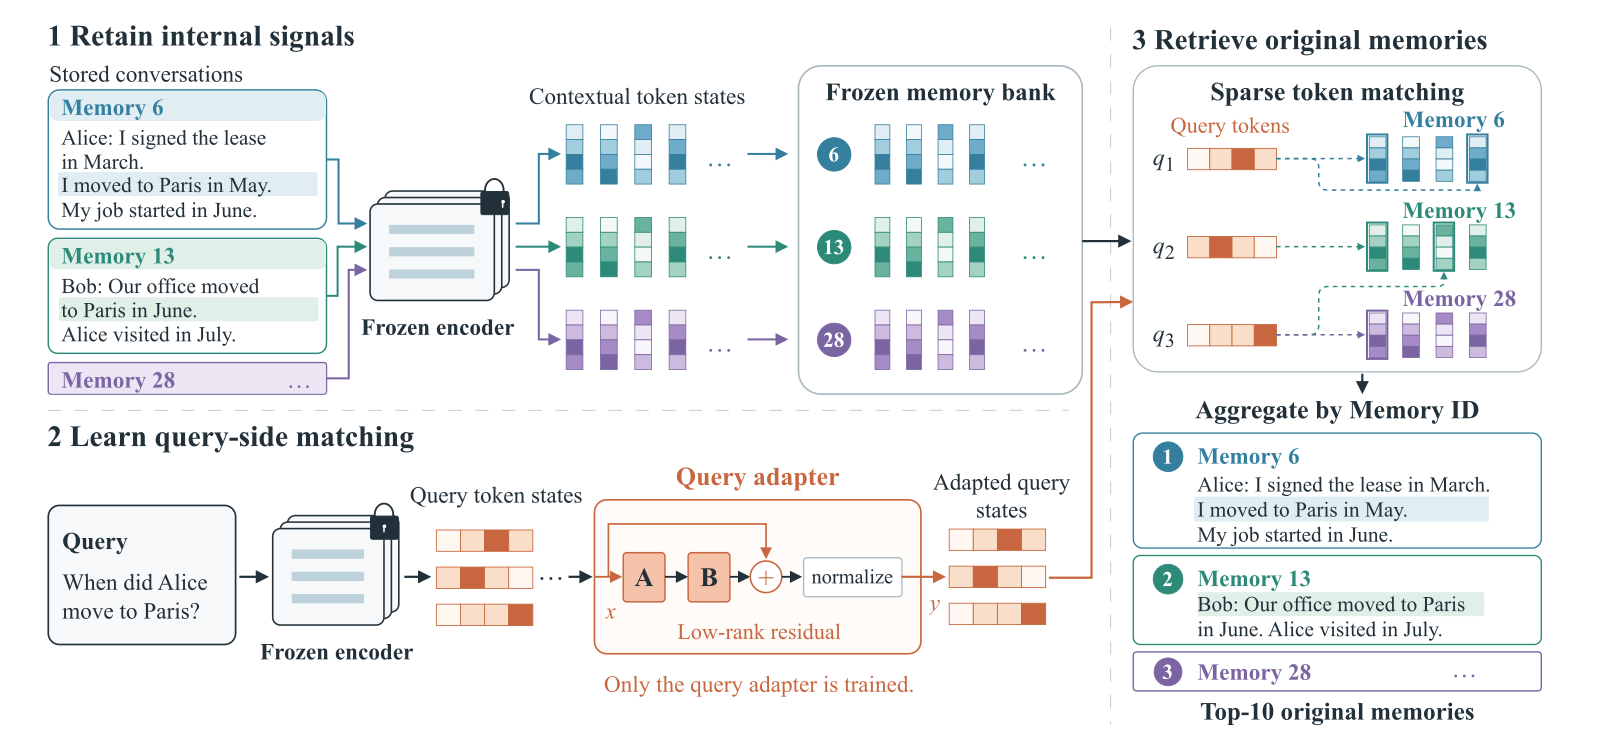
建索引时,每条记录只过一遍冻结的向量模型,存两样东西:整条记录的向量,以及最后一层里每个内容 token 的表示,每个 token 记下自己属于哪条记录。提示词、填充位置等不属于内容的 token 不存。
查询时有两条通道:
| 通道 | 怎么打分 | 覆盖哪些记录 |
|---|---|---|
| 整条通道 | 查询向量和记录向量的点积 | 每条候选记录都有分 |
| token 通道 | 每个查询 token 在全部记录的 token 里找最像的 64 个,按所属记录汇总 | 只有 token 被找到的记录有实分,其余用下限分 |
token 通道的关键是怎么对待没被找到的记录。对某个查询 token,一条记录如果有好几个 token 被找到,只取最高的相似度;如果一个都没被找到,作者用近似搜索返回结果的尾部相似度来估计缺失的匹配分数。作者用第 64 名的相似度(小于 0 时取 0)当这条记录在这个查询 token 上的分数;被找到的记录也至少拿这个分。最后把所有查询 token 上的分数取平均,得到这条记录的 token 分。
候选记录集合是为当前查询给定的输入。token 搜索只查这些记录,两条通道也给这个集合里的每条记录打分。融合前,两条通道分别用所有候选记录的分数计算平均值和标准差,把分数减去平均值、除以标准差,再按各占一半相加。
可选的训练只改查询一侧:给每个查询 token 的表示加一个秩为 32 的低秩修正,加完后把长度缩回原来大小。这个修正写成两个小矩阵相乘,其中一个初始化为 0,所以训练开始时修正项为 0,和原模型完全一样。整条通道仍用原模型输出的查询向量。记录向量和 token 索引都不用重算。训练用了 1024 条样本。“找最像的 64 个”这一步不能求导,所以训练时换一种可求导的打分:每个查询 token 在每条候选记录里取最大相似度,再对查询 token 取平均,作为这条记录的分数。训练时把每条候选记录的分数除以温度 0.07 后做 softmax,得到每条记录的概率,目标是让这个问题所有相关记录(可以不止一条)的概率之和尽量大。
实验结果
评测覆盖八个数据集:三个对话记忆数据集(LoCoMo、LongMemEval、REALTALK),以及企业可持续发展报告、科研论文问答、新冠问答和长文档检索。下表是 Qwen3-Embedding-4B 上八个数据集的平均值:
| 设置 | 平均 Recall@10 (%) | 平均 NDCG@10 (%) |
|---|---|---|
| 原始单向量 | 62.5 | 48.0 |
| 对每条记录直接求 token 最大相似度 | 67.8 | 54.3 |
| 本文,不训练 | 73.8 | 59.9 |
| 本文,加查询修正 | 75.7 | 62.3 |
| 加查询修正,但去掉整条通道 | 74.5 | 60.6 |
| 加查询修正,但 token 通道换成逐条求最大相似度 | 72.4 | 60.1 |
几点读法:
- 大部分收益不靠训练。不训练就从 62.5 到 73.8,训练只再加 1.9。
- 先在全部 token 里找最像的,比给每条记录各算一遍最大相似度好。后者让每条记录总能凑到某个“有点像”的 token,噪声更大,换过去平均掉 3.4 个点。
- 下限分很重要。把没被找到的记录记成 0 分,Recall@10 掉 1.6 到 7.1 个点;而把近似最近邻换成精确搜索,Recall@10 只变化 -0.06 到 +1.6 个点。也就是说,怎么估计没找到的那部分,比近似搜索本身的误差影响大。
- 查询修正不是总有用。Qwen3-Embedding-0.6B 上只多 0.3 个点,Llama 系的 3B 模型上甚至略降。
换成用大模型读取前 10 条记录再作答,Qwen-4B 上 LoCoMo 的答案准确率从 63.4 到 67.9,LongMemEval 从 67.8 到 72.6,但 LongMemEval 的词面 F1 反而从 13.1 降到 12.4,说明检索指标的提升不能直接等同于答案质量。
代价:索引变大多少?
下表是 Qwen-0.6B 在 LoCoMo 上的成本:
| 索引 | 大小 (MiB) | 每次查询 (ms) | Recall@10 (%) |
|---|---|---|---|
| 原始单向量 | 2.23 | 16.66 | — |
| 完整 token 索引 | 153.93 | 29.21 | 68.53 |
| token 表示每个数压成 4 比特 | 26.17 | 21.68 | 68.37 |
| 先随机投影到 128 维再压成 4 比特 | 10.70 | 20.69 | 66.69 |
4 比特压缩几乎不损失质量,所以是最划算的一档;但即使压缩后,索引仍比单向量大十倍以上,因为它随 token 总数增长,而不是随记录条数增长。
局限和怎么用
- 每个查询 token 找更多邻居不一定更好。LoCoMo 上不训练的 Qwen-4B,邻居数超过 32 后反而下降。
- 这组对比保持融合方式不变,也不训练查询修正。Gemma 在 REALTALK 上、Llama-1B/3B 在 QASPER 上,稀疏匹配的 NDCG@10 没有超过 MaxSim。
- 融合前的标准化用的是每个查询自己的候选集合。如果实际系统先用别的方法粗召回再算 token 分,条件已经变了,需要单独测漏召回。
- 没有线上实验,延迟数字来自小规模离线集合。
想试的话,顺序可以是:先不训练,只加 token 索引和融合,看离线 Recall 和 NDCG 有没有涨;再用 4 比特压缩看存储和质量的取舍;最后才考虑训练查询修正,而且要在自己的模型上确认它有用。下限分和融合前的标准化值得原样照搬。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…