目录 · 8 节
1它到底在解决什么问题?2核心想法:同一个模型分“闭卷”和“开卷”两种写法3具体怎么做:三步4迁移:哪些开卷推理值得教给闭卷模式5实验结果:涨了多少,证据够不够?6我认为它的局限7一个检索团队可以怎么试8结论与评价
做多模态检索、并且已经在用“先生成一段推理再做 embedding”这类模型的团队值得细读;只用普通双塔编码器的团队可以先看思路。论文提出的方法叫 PILOT。它的核心一句话:训练时让模型看到正负候选来“想对方向”,推理时只保留不看候选的那一路。在 78 个任务的 MMEB-V2(多模态 embedding 评测集)上,2B 模型总分从 60.1 提到 63.3,7B 从 64.3 提到 67.6,视觉文档检索提升最大,分别涨 6.1 和 6.4 分。这里的分数是这样算的:图片和视频任务看 Hit@1,视觉文档任务看 nDCG@5,都按百分制记,每个数据集单独算,总分是 78 个数据集的平均。但要注意,涨幅是相对同数据、同骨干的直接基线;放到全表,7B 总分仍低于几个用了更多数据的方法。
它到底在解决什么问题?
先说背景。最近一类多模态 embedding 模型不直接把图片或文字编码成向量,而是先让 MLLM 针对输入写一段推理,再把“输入加推理”一起编码。比如输入是一张发票图片,模型先写“这是一张 2024 年的餐饮发票,金额约 300 元”,再生成向量,向量里就带上了这些语义线索。
问题出在训练信号上。检索数据只告诉模型“这个查询配这个正样本,那些是负样本”,没有告诉它该写什么推理。同一个输入可以写出很多段推理,有的推理恰好点出了区分正负样本的关键细节,有的只是泛泛描述。已有方法只根据输入本身去采样推理,再用检索分数事后打分,这就有一个探索瓶颈:如果那段关键推理从来没被采样到,奖励再好也强化不了它。
举个例子(示意):查询是一张伦敦街头双层红色巴士的照片,负样本是一张红色有轨电车的照片。只看查询写推理,模型很可能写“一辆红色公共交通工具在城市街道上”,这句话对两张候选都成立,区分不了;真正有用的是“双层”“巴士”这样的细节。
核心想法:同一个模型分“闭卷”和“开卷”两种写法
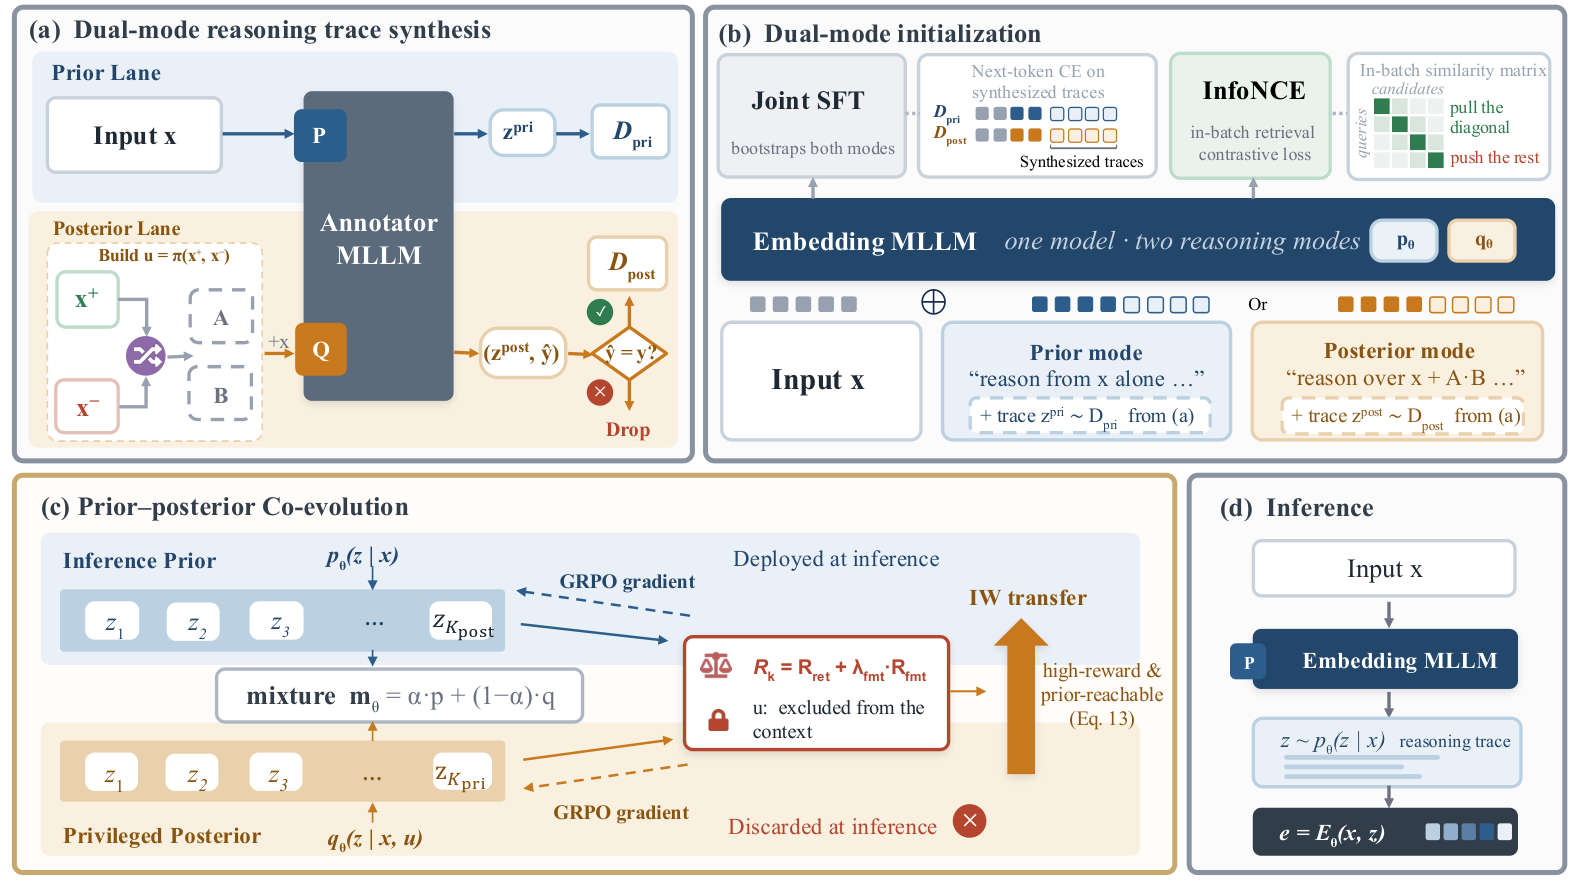
作者把推理看成一个没被直接观测到的隐变量,并让同一个 MLLM 用两种提示词扮演两个角色。打个比方,一种像闭卷考试,只看题目写推理;另一种像开卷考试,能翻看两份候选材料,但不告诉它哪份是对的:
| 角色 | 能看到什么 | 什么时候用 |
|---|---|---|
| 闭卷模式(论文叫 prior) | 只看输入本身 | 训练和线上推理都用 |
| 开卷模式(论文叫 posterior) | 输入,加一对打乱顺序、不标正负的候选 | 只在训练时用 |
这里的“特权信息”指训练时有、线上没有的信息,也就是正负候选。开卷模式看到候选 A 和 B,但不知道哪个是正样本,必须自己比较后猜出来。这样设计的原因是:如果直接告诉它正样本是哪个,它容易照着正样本复述,写出的推理里混进输入里没有的内容;不告诉它,它就得去找两张候选之间的差别,比如“双层”。
具体怎么做:三步
第一步,离线合成推理。作者用更强的多模态模型 GLM-4.1V-thinking 当标注者,对同一条训练数据分别写一段只看输入的推理,和一段看了候选对、并同时猜出正样本的推理。猜错的开卷推理直接丢掉,因为猜错说明它对候选的理解是错的。最后约 67.6 万条开卷推理通过检查,另外约 78.7 万条保留原有推理作为闭卷模式的训练数据。
第二步,双模式初始化。用这些推理做 SFT,让模型学会两种提示词下各自怎么写推理,同时加一个批内对比损失,让“输入加推理”的向量能把正样本拉近、把批内其他样本推远。
第三步,闭卷和开卷模式共同进化。每个训练输入,闭卷和开卷模式各采样 8 段推理,每段推理都算一个检索奖励。关键在于:开卷推理虽然是看了候选写的,但算奖励时向量只由“输入加推理”生成,候选不进向量。所以开卷模式只能靠写出更有用的推理来拿高分,不能直接“抄答案”。
检索奖励怎么算?先把查询向量和每个候选向量的余弦相似度除以温度 0.2,再取指数,当作这个候选的得分;奖励等于“正样本得分”除以“所有负样本得分之和”,再取对数。它不是概率,而是正样本相对负样本领先多少的对数比值,越大越好,正负打平时为 0。公式里每个候选还各自生成 M 段推理、得到 M 个向量,同一个候选的 M 个得分先加总;为了好算,下面的例子取 M=1。手算例子(示意):只有一个负样本时,取指数再取对数会抵消,奖励就等于两个余弦之差除以 0.2。推理 1 让查询和正样本的余弦是 0.6、和负样本是 0.5,奖励是 (0.6−0.5)/0.2=0.5;推理 2 把两者拉开到 0.7 和 0.4,奖励是 (0.7−0.4)/0.2=1.5。所以推理 2 更好。
然后两种模式各自用 GRPO 更新,每个输入的 8 段推理为一组。
迁移:哪些开卷推理值得教给闭卷模式
线上只有闭卷模式,所以开卷模式找到的好推理要迁移过去。但不是所有好推理都能迁移:有些推理依赖候选里的细节,闭卷模式只看输入根本写不出来,硬学只会教它编造。作者从一个重要性加权的变分目标推出了迁移权重,它由两部分相加(取对数后):
| 部分 | 含义 | 越大说明 |
|---|---|---|
| 有用程度 | 这段推理的检索奖励 | 对检索帮助越大 |
| 可达程度 | log(闭卷写出它的概率) − log(混合概率),混合概率 = 0.5×闭卷概率 + 0.5×开卷概率(两路各采 8 段,所以各占一半) | 闭卷模式越有可能自己学会 |
可达程度的例子(示意):某段开卷推理,闭卷模式写出它的概率是 0.001,开卷模式是 0.02,混合概率是 0.5×0.001+0.5×0.02=0.0105,可达程度是 log(0.001÷0.0105)≈−2.35;如果闭卷和开卷模式写出它的概率一样,可达程度就是 0。同一个输入的所有推理,权重再按比例换算,使它们加起来等于 1。手算例子(示意):推理 A 有用程度 6、可达程度 −1,合计 5;推理 B 有用程度 8、可达程度 −5,合计 3;推理 C 有用程度 0、可达程度 −0.5,合计 −0.5。取指数后约为 148、20、0.6,换算成比例后 A 占约 88%,B 约 12%,C 几乎为 0。这说明奖励最高的 B 并不是最该学的,因为闭卷模式离它太远;A 奖励稍低但够得着,所以权重最大。这些权重用来做加权的监督微调,只作用在开卷模式采样出的推理上。所以第三步的训练目标由三项组成:闭卷模式的 GRPO 损失(系数 1.0)、开卷模式的 GRPO 损失(系数 1.0)、加权迁移的监督微调损失(系数 0.3)。第二步里的监督微调和批内对比损失只用于初始化,不在这一步出现。
实验结果:涨了多少,证据够不够?
主表上,PILOT 在 2B 和 7B 两个规模、全部 12 个任务组上都超过直接基线 UME-R1。基线和它用同样的 146 万条训练数据、同样的 Qwen2-VL 骨干,所以这个对比比较公平。
| 规模 | 方法 | 图片 | 视频 | 视觉文档 | 总分 |
|---|---|---|---|---|---|
| 2B | UME-R1 | 66.1 | 41.8 | 63.8 | 60.1 |
| 2B | PILOT | 67.5 | 45.9 | 69.9 | 63.3 |
| 7B | UME-R1 | 70.9 | 47.3 | 67.1 | 64.3 |
| 7B | PILOT | 72.7 | 49.4 | 73.5 | 67.6 |
| 7B | RzenEmbed(训练数据 500 万条以上) | 75.9 | 55.7 | 77.1 | 71.6 |
视觉文档涨得最多,2B 的 PILOT 在这一项甚至超过 7B 的 UME-R1(69.9 对 67.1)。我认为这说明文档类检索最依赖“点出关键细节”的推理,比如表格里的某个字段。但全表上,7B 总分低于 RzenEmbed 的 71.6、MMEmb-R1 的 69.7 和 TTE(把推理和编码拆成两个模型的方法)的 68.6,所以它是一种训练方法上的改进,不是新的最好成绩。
消融实验在 2B 上做,三个随机种子取平均。只用闭卷模式做监督微调是 59.0;改成双模式初始化到 60.3;把开卷推理直接当闭卷模式的训练目标只有 59.4,这说明硬学看过候选的推理确实效果差。只对闭卷模式做强化学习到 61.4;两种模式一起做强化学习到 62.2;再加上加权迁移到 63.3。每一步都有贡献,迁移这一步贡献 1.1 分。
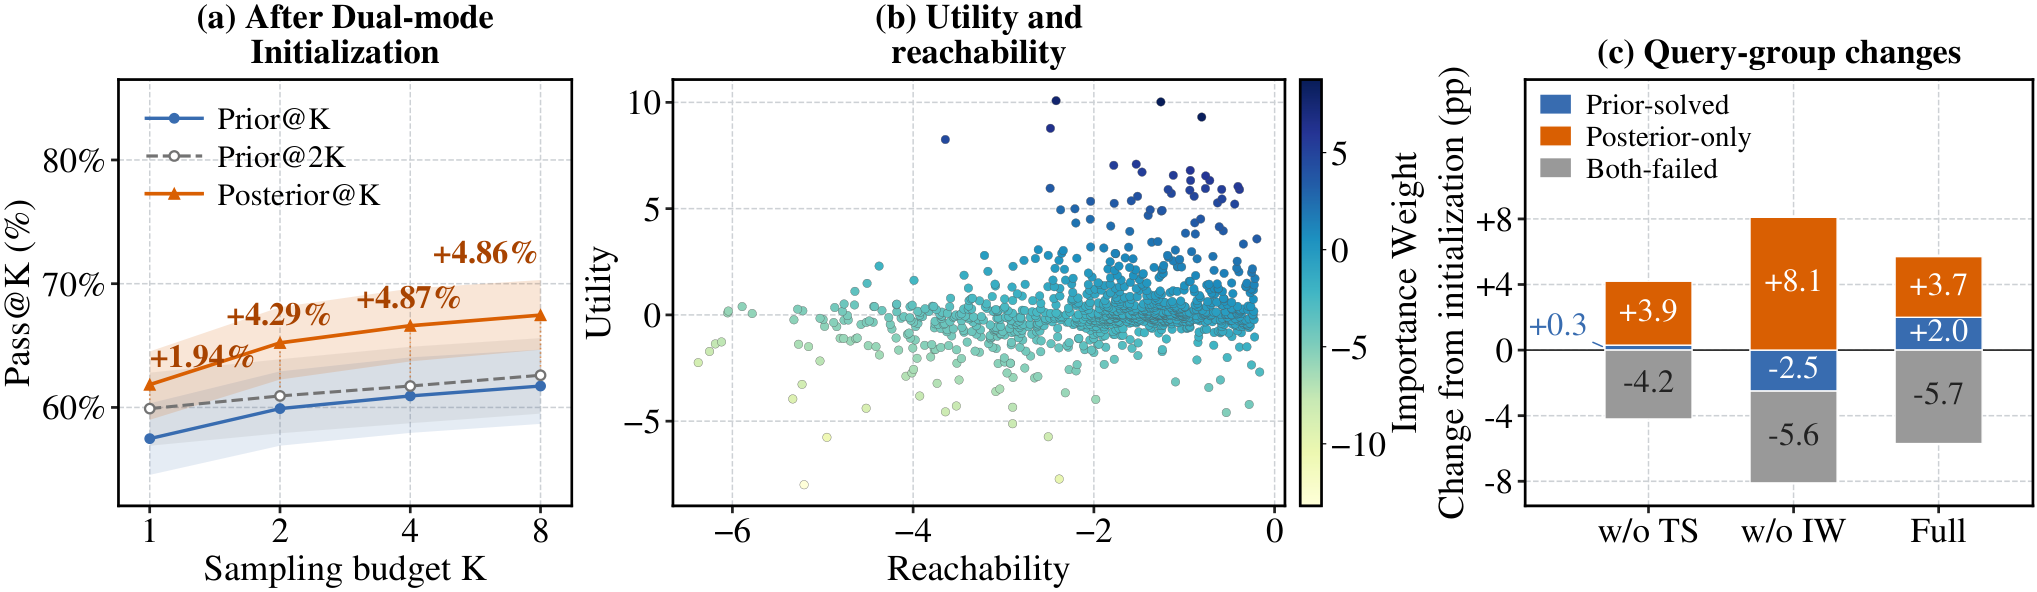
探索是否真的变好了?作者在 1000 条样本上测 Pass@K,这里“做对”指正样本排第一。K 从 1 到 8,开卷模式从 61.8% 升到 67.5%,比闭卷模式采样两倍数量还高 1.9 到 4.9 个百分点。这意味着看候选带来的好处,单靠多采样补不回来。图 4(c) 再看迁移是否落到了闭卷模式身上:完整方法让“闭卷模式能做对”的查询比例提高 2.0 个百分点,“两者都做错”的减少 5.7 个百分点;去掉重要性权重、改成平均迁移时,“闭卷模式能做对”反而下降 2.5 个百分点。这说明权重决定了开卷模式的发现能不能真正交给闭卷模式。
我认为它的局限
- 线上成本高。查询和每条候选在编码前都要先生成一段推理,评测时最多 1024 个 token。对上亿条文档建索引时,这比普通编码器贵得多,论文主要报告效果,部署成本需要自己评估。
- 涨幅主要相对自家基线。全表看,用更多数据的方法总分更高,PILOT 能否叠加到这些更强的方法上,还需要验证。
- 分析部分依赖大模型打分。推理“是否有用”“是否泄露了候选信息”由另一个大模型判断,而且看候选写推理的泄露比例高达 79.6%;消融也只在 2B 上做。训练 2B 用 16 张 A100,还需要一个更强的标注模型,门槛不低。
一个检索团队可以怎么试
- 先确认前提:如果线上已经在用“先推理再编码”的模型,或者能接受查询侧多一次生成,才值得试;否则可以只借鉴“训练时用特权信息”的思路。
- 小规模复现开卷模式合成:拿 1 万条带难负样本的数据,让强模型在“看打乱的正负候选并猜正样本”的提示下写推理,统计猜对率,抽查推理里有多少内容是从候选里抄来的。
- 做最便宜的对照:同样的数据,只用闭卷推理微调,对比加入通过检查的开卷推理做双模式微调,看离线召回能否复现约 1 分的提升。
- 有收益再上强化学习和加权迁移,同时记录线上每次查询多出来的生成延迟,算清楚收益和成本。
结论与评价
PILOT 的价值在于把“训练时有、线上没有”的正负候选信息用在了推理的探索上,而不只是事后打分;再用“有用程度加可达程度”的权重决定哪些发现能教给线上模型,这个设计讲得清楚、消融也支持。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。先推理再编码的多模态检索正在增多,训练信号和推理脱节是真实问题 |
| 方法创新性 | 高。看候选但不给答案的开卷模式和考虑可达程度的迁移权重都有新意 |
| 实验证据 | 中高。对同数据基线全面领先,消融清楚;但不是全表最好,分析依赖大模型打分 |
| 工程成本 | 高。需要强标注模型、多卡强化学习,线上每条输入都要生成推理 |
| 是否值得尝试 | 已有推理增强 embedding 的团队值得试;普通编码器团队先借鉴思路 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…