目录 · 8 节
1它到底在解决什么问题?2整体流程:检索找难的,图谱判对错3为什么要用规则判冲突?4怎么证明起作用的是图谱,而不是检索位置?5实验结果:在 triplet loss 上更明显6我认为它的局限7一个推荐/搜索团队可以怎么试8一句话结论
训练稠密检索模型时,难负例一般取 BM25 或向量检索排在前面、但没被标成正例的文档。可是排得靠前,只说明它和 query 像,说明不了它为什么不该被召回。一份讲 SQL 查询优化进阶的资料,和 query「入门 SQL join」在字面和语义上都很近,它错在知识点和难度级别都对不上。CA-HNM 借助课程知识图谱里的先修、上下位、相关概念和难度信息,给每个难候选查一遍到底哪里冲突,只把冲突明确的留作负例。和从同样检索位置取负例、但不看图谱的对照相比,它在 8 组设置里有 6 组 NDCG@10 更高;可在 Course-Skill Atlas 上把图谱关系随机打乱,NDCG@10 反而从 0.0311 升到 0.1174。
手里有类目树、知识图谱或技能体系的检索团队值得读这篇,理由是它的对照做得干净:它把负例排得多靠前和负例是否违反结构这两件事拆开比较,很多难负例论文恰恰没控制前一个变量。核心思想一句话:检索负责找出难的候选,图谱上的确定性规则负责判断它是不是真的不对,图谱只在离线造训练数据时用,线上仍是普通双塔。但我认为证据比标题弱,收益主要出现在 triplet loss 上,混合负例池里只多出 0.0038 到 0.0076 的 NDCG@10,而打乱图谱的对照还赢过真实图谱。
它到底在解决什么问题?
用一个课程检索的例子说明(示意)。query 是「入门 SQL join」,已标正例只有一份《SQL join 入门讲义》。BM25 和向量检索的前几名里还有下面几份没标注的文档,传统难负例挖掘会把它们一视同仁地当负例。
| 候选文档(示意) | 检索排名(示意) | 和目标概念的关系 | CA-HNM 的判定 |
|---|---|---|---|
| 《SQL 查询优化进阶》 | 2 | 同一主题,但难度是进阶 | 级别不符,留作负例 |
| 《关系代数基础》 | 3 | 是 SQL join 的先修概念 | 关系不符,留作负例 |
| 《join 与子查询练习》 | 4 | 提到了 join,也提到了别的概念 | 证据冲突,丢掉 |
| 《数据库课程总览》 | 5 | 是目标概念的上位概念 | 范围不符,留作负例 |
| 《Excel 表格合并技巧》 | 6 | 图谱里查不到任何关系 | 没有证据,丢掉 |
这张表里有两类风险。第一类是漏标:练习那份文档其实可能对入门学习者有用,只是数据集没标,把它当负例会教模型推开一个相关文档。第二类是负例没有区分度:Excel 那份排得也不低,但模型从它身上学不到这个领域里真正要分清的东西。CA-HNM 的做法是只保留能说出错在哪里的候选,并把错的类型记下来。
整体流程:检索找难的,图谱判对错
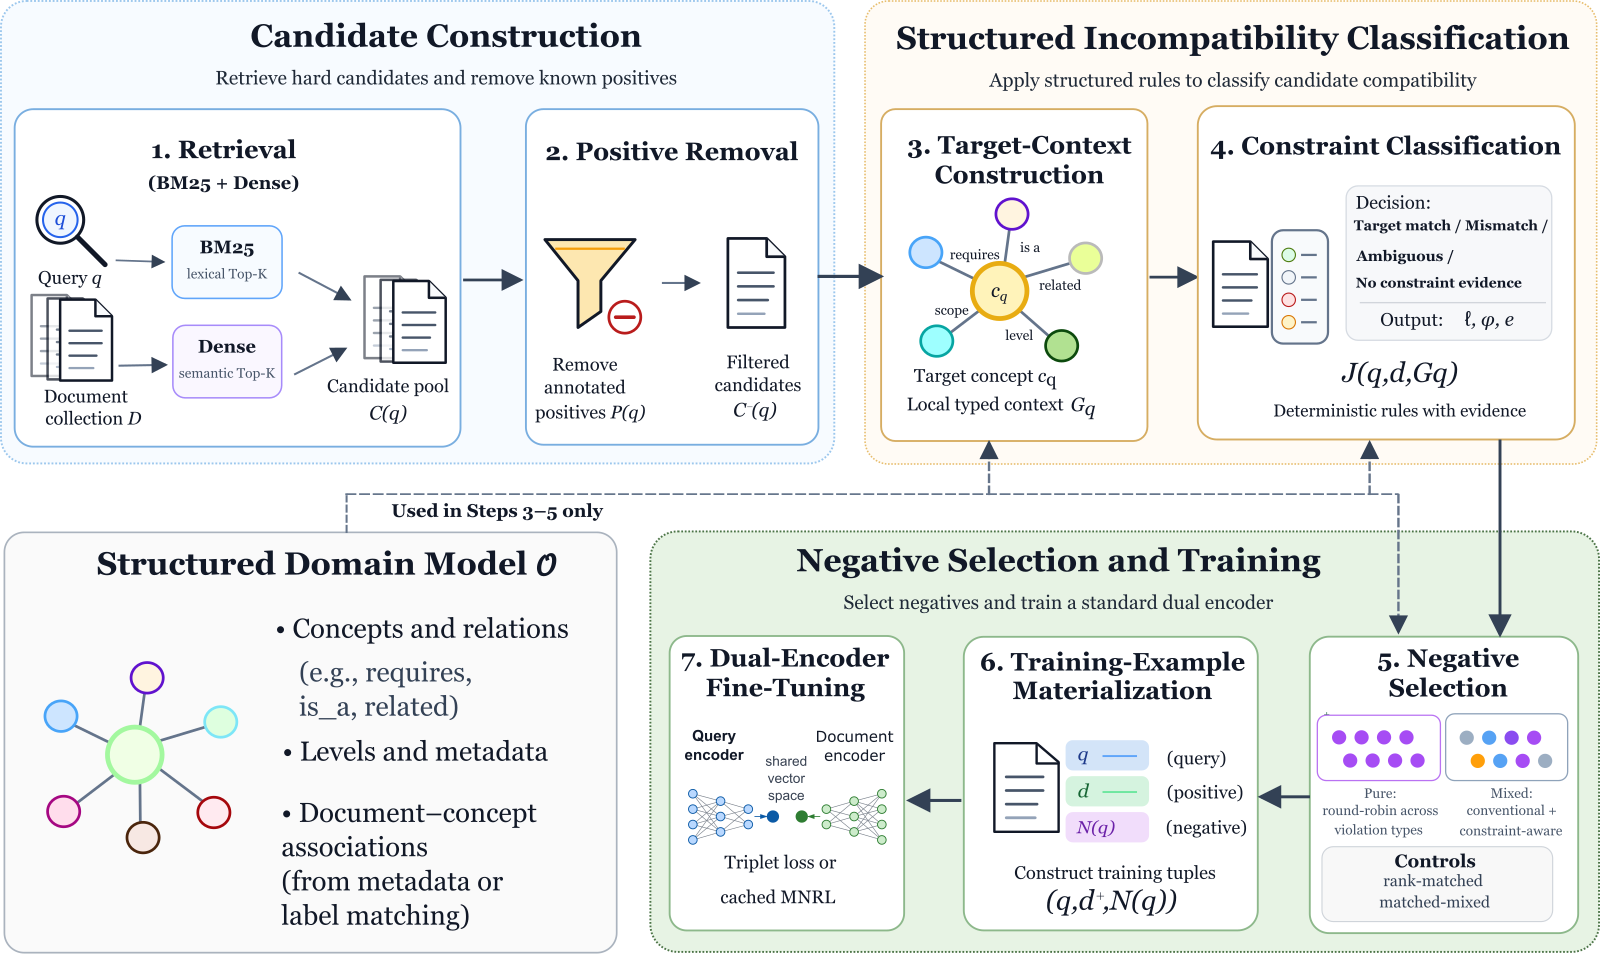
| 阶段 | 输入 | 做什么 | 产出 |
|---|---|---|---|
| 取候选 | query | BM25 和稠密检索各取前 100 名,合并后去掉已标正例 | 难候选池 |
| 找目标概念 | query、图谱 | 有概念 id 就直接用,没有就按名称和别名匹配 | 目标概念和它周围的邻居 |
| 判冲突 | 每个候选 | 用固定规则查它命中了哪些邻居、有没有目标概念的证据 | 冲突类型和触发规则的证据 |
| 选负例 | 冲突候选 | 按冲突类型轮流取,每个 query 最多 4 个 | 训练三元组 |
| 训练 | 三元组 | 微调 BGE 或 E5 双塔 | 普通的稠密检索模型 |
关键分工是:检索排名决定一个候选够不够难,图谱规则决定它算不算真负例。下面拆开讲后两步。
为什么要用规则判冲突?
先看图谱里有什么。MOOCCubeX 里概念之间有先修关系,Course-Skill Atlas 里技能之间有上下位和相关两种关系。对每个 query,方法先找到它对应的目标概念,再把目标概念的直接邻居收集起来,形成一个小的局部图。
然后用一套确定性规则给每个候选分类。候选里出现了目标概念的名称,又没有任何冲突,就判为目标匹配,可能是漏标的正例,不能当负例。候选里出现的是兄弟概念、先修或后续概念,却没有足够的目标证据,判为关系不符。出现的是更宽或更窄的概念,判为范围不符。级别不符看的是图谱给概念标注的难度级别:候选对应的概念级别和目标概念不同,就算不符。目标证据和冲突证据同时出现,判为模糊,也丢掉。用公式写,最后保留的负例集合是:
其中 是已标正例, 表示候选在 BM25 或稠密检索的前 K 名里, 表示它至少触发了一条冲突规则。直觉上,这就是在普通难负例的条件后面再加一个“能说出错在哪”的条件。
为什么用规则而不是再训一个分类器?规则的好处是每个负例都带着证据,比如“命中了先修概念‘关系代数’,没有出现‘join’”,挖出来的负例池里各类冲突各占多少,可以直接查。代价是规则只认名称和别名的字面匹配,换一种说法就漏了。
选负例时还有一步按冲突类型轮流取。假设某个 query 有 6 个关系不符、1 个级别不符、1 个范围不符的候选(示意),直接按检索排名取前 4 个,可能全是关系不符。轮流取则先拿每类排名最高的一个,再回到关系不符补第 4 个,这样单一类型不会占满整个负例名额。
怎么证明起作用的是图谱,而不是检索位置?
这是我认为全文设计得最好的地方。图谱挑出来的负例,排名分布可能和 DenseNeg(直接取稠密检索排名最高的非正例)不一样,如果只和 DenseNeg 比,就分不清收益来自负例的难度还是来自图谱。所以作者做了一个按位置匹配的对照:对 CA-HNM 选中的每个负例,对照组都在同一个候选池里另找一个检索名次和它最接近的非正例,完全不看图谱。这样两组负例的检索名次大致相同。名次相同时按原始检索顺序取。两组负例的难度大致相同,差别只在有没有经过图谱筛选。
实验在两个教育数据集上做,概念或技能当 query,学习资源或课程记录当文档。MOOCCubeX 有 3,781 篇文档、3,500 个训练 query;Course-Skill Atlas 文档多达 281,153 篇,但训练 query 只有 227 个,开发集只有 32 个。编码器是 BGE 和 E5,损失函数有 triplet loss 和 cached MNRL(批内多负例排序损失,cached 指用缓存支持大批量)两种。triplet loss 每次只拿一个正例和一个挑出来的负例比;cached MNRL 会把同一批里其他 query 的文档也当负例,挑出来的 4 个负例只是众多对手中的几个。每组配置跑 10 个随机种子,按种子和 query 两层重采样算 95% 置信区间。
实验结果:在 triplet loss 上更明显
第一个问题是图谱筛选能不能赢过按位置匹配的对照。下表摘出开发集上的 NDCG@10,最后一列是各配置里四种负例策略的最好成绩。
| 数据集 | 编码器 | 损失 | 位置匹配对照 | CA-HNM-Pure | 四种策略里最好的 |
|---|---|---|---|---|---|
| Course-Skill Atlas | BGE | cached MNRL | 0.0379 | 0.0311 | 0.0901(DenseNeg) |
| Course-Skill Atlas | BGE | triplet | 0.0569 | 0.0585 | 0.2283(随机负例) |
| Course-Skill Atlas | E5 | cached MNRL | 0.0764 | 0.0738 | 0.1777(随机负例) |
| Course-Skill Atlas | E5 | triplet | 0.2036 | 0.2947 | 0.2947(CA-HNM-Pure) |
| MOOCCubeX | BGE | cached MNRL | 0.1547 | 0.1724 | 0.3280(随机负例) |
| MOOCCubeX | BGE | triplet | 0.1653 | 0.2472 | 0.3511(DenseNeg) |
| MOOCCubeX | E5 | cached MNRL | 0.1750 | 0.1785 | 0.3662(随机负例) |
| MOOCCubeX | E5 | triplet | 0.0694 | 0.0962 | 0.3930(随机负例) |
8 组里 6 组 CA-HNM-Pure 高于对照,其中 4 组的置信区间完全在 0 以上,3 组是 triplet loss。差距最大的是 Course-Skill Atlas 上的 E5 加 triplet,NDCG@10 高出 0.0911。这说明在难度相同的前提下,经过图谱筛选的负例确实提供了更有用的训练信号,而且挑出来的负例在损失里分量越重,效果越明显。
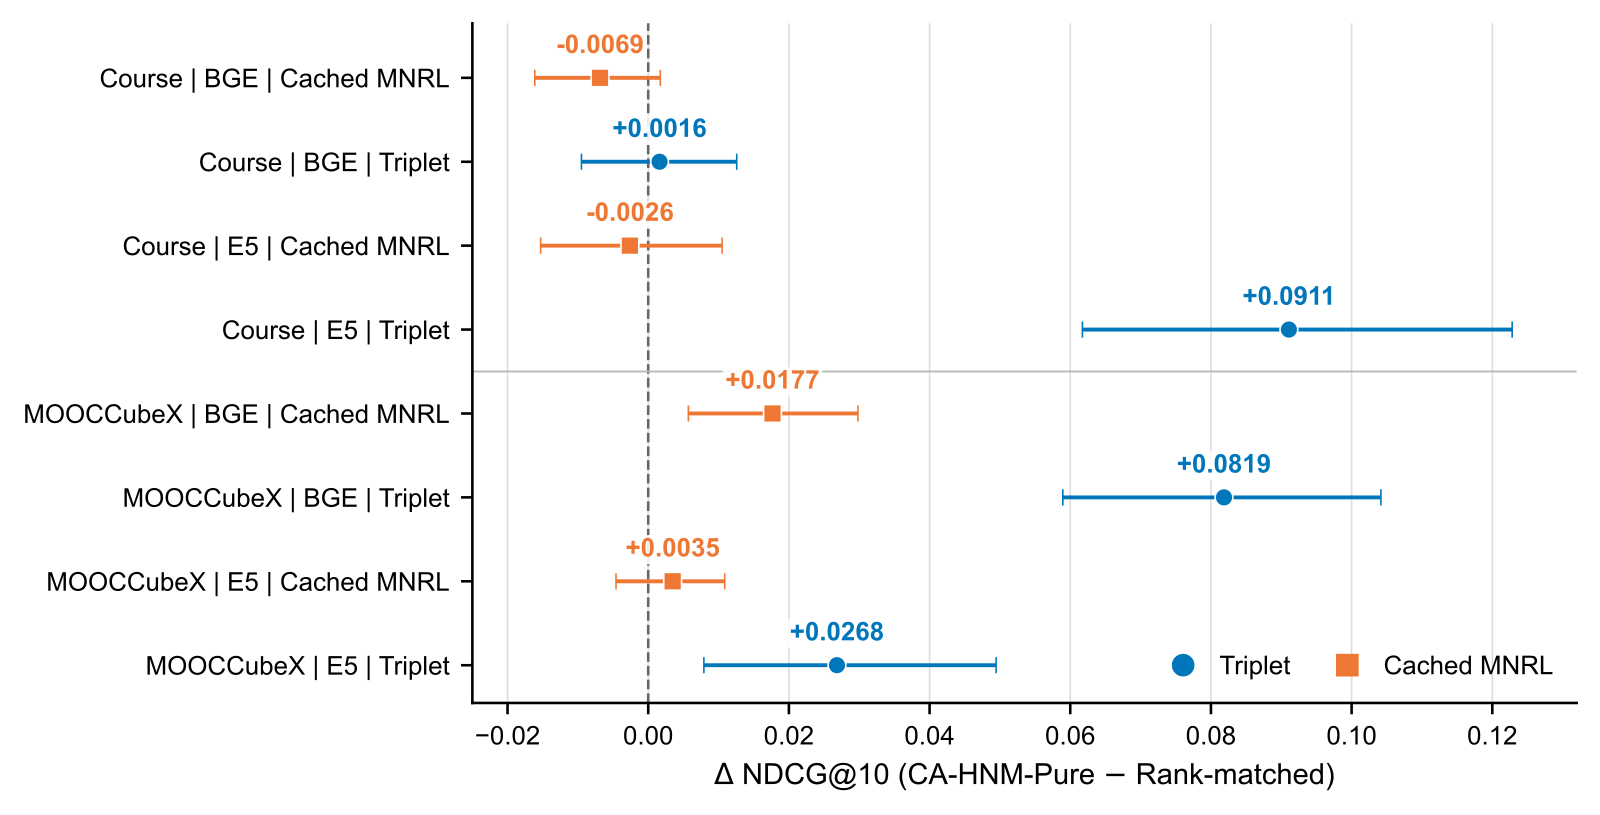
但最后一列同样重要。8 组里只有 1 组 CA-HNM-Pure 是绝对第一,MOOCCubeX 的四组里最好的全是随机负例或 DenseNeg。也就是说,只用冲突负例训练,常常还不如随机取负例。我的理解是冲突负例池太窄,每个 query 最多 4 个且都来自目标概念附近,模型很少见到简单的负例。
第二个问题是把冲突负例混进常规负例池有没有用。作者把随机、BM25、稠密检索三种常规负例和冲突负例混成一个池子,再做一个对照混合池:其他部分完全一样,只把冲突负例那一份换成位置匹配负例。结果在 BGE 加 cached MNRL 下,前者的 NDCG@10 在两个数据集上分别只多 0.0038 和 0.0076。这说明一旦其他来源的负例已经在池子里,图谱那一份的边际贡献很小。
第三个问题是换掉图谱会怎样。作者把每个目标概念的关系邻居随机换成别的概念,其余流程不变。在 Course-Skill Atlas 上,这样打乱图谱后 NDCG@10 是 0.1174,远高于用真实图谱的 0.0311;MOOCCubeX 上几个变体差别很小。作者的解释是改了图谱,候选能不能入选也跟着变,负例池的大小和组成都不一样了,所以这个实验测不出关系本身的作用。这个解释成立,但它也意味着全文没有任何一个实验能干净地证明真实关系比假关系更有用。
我认为它的局限
第一,结构对照的结果和方法的主张方向相反。Course-Skill Atlas 上打乱图谱后 NDCG@10 从 0.0311 升到 0.1174,作者把它归因于负例池组成变化,但没有做固定候选、只换关系的实验来排除另一种可能:真实关系挑出的负例本身就太窄。
第二,结论建立在很小的评测集上。所有数字都来自开发集,没有报告测试集;Course-Skill Atlas 开发集只有 32 个 query,而这个数据集上各策略的 NDCG@10 大多不到 0.1,几个百分点的差距可能只是少数 query 的波动。
第三,规则只认字面。目标概念和邻居都靠名称和别名的标准化匹配来识别,文档换一种叫法就查不到。在商品、内容这类别名很多、描述随意的语料上,规则的召回会比课程数据更低。
一个推荐/搜索团队可以怎么试
- 先只做体检,不改训练。用现有的类目树或属性体系,对当前难负例池跑一遍类似的规则,统计有多少负例能说出冲突类型、有多少其实带着目标证据。如果后一类占比高,说明现有负例里混着不少漏标正例,这一步本身就有价值。
- 再做按位置匹配的对照实验。保持负例排名分布不变,只比较经过规则筛选和不经过筛选的两组负例,这样才能知道收益来自规则还是来自难度。
- 有收益再混入常规负例池,而不是单独使用。论文里单用冲突负例经常输给随机负例,混合使用至少不会更差。
- 如果训练用的是 in-batch 负例为主的损失,预期要放低。论文里 cached MNRL 下的收益明显小于 triplet loss。
一句话结论
难负例挖掘不该只问它排得多靠前,还要问它错在哪里,这个拆分和按位置匹配的对照值得借鉴;但就这篇的证据,图谱规则更适合拿来清洗负例池,而不是单独当负例来源。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。漏标正例混进难负例是稠密检索训练的常见问题 |
| 方法创新性 | 中。规则简单,新意在于把冲突类型和证据记录下来,并设计了位置匹配对照 |
| 实验证据 | 中低。10 个种子和置信区间做得认真,但只有开发集、评测 query 少,结构对照的方向还和主张相反 |
| 工程成本 | 低。只改离线负例构造,线上模型和检索流程都不变 |
| 是否值得尝试 | 值得用来体检和清洗负例池,单独替换现有负例来源要谨慎 |
| 适用场景 | 有现成类目树、知识图谱或技能体系,且概念名称比较规范的检索场景 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…