目录 · 8 节
1它在回答什么问题?2整体评估流程:固定召回,只换精排策略3为什么默认设置会失败,截断怎么修?4结果:质量能追平,延迟和显存追不上5换个数据集,结论会变6我认为它的局限7一个推荐/搜索团队可以怎么试8一句话结论
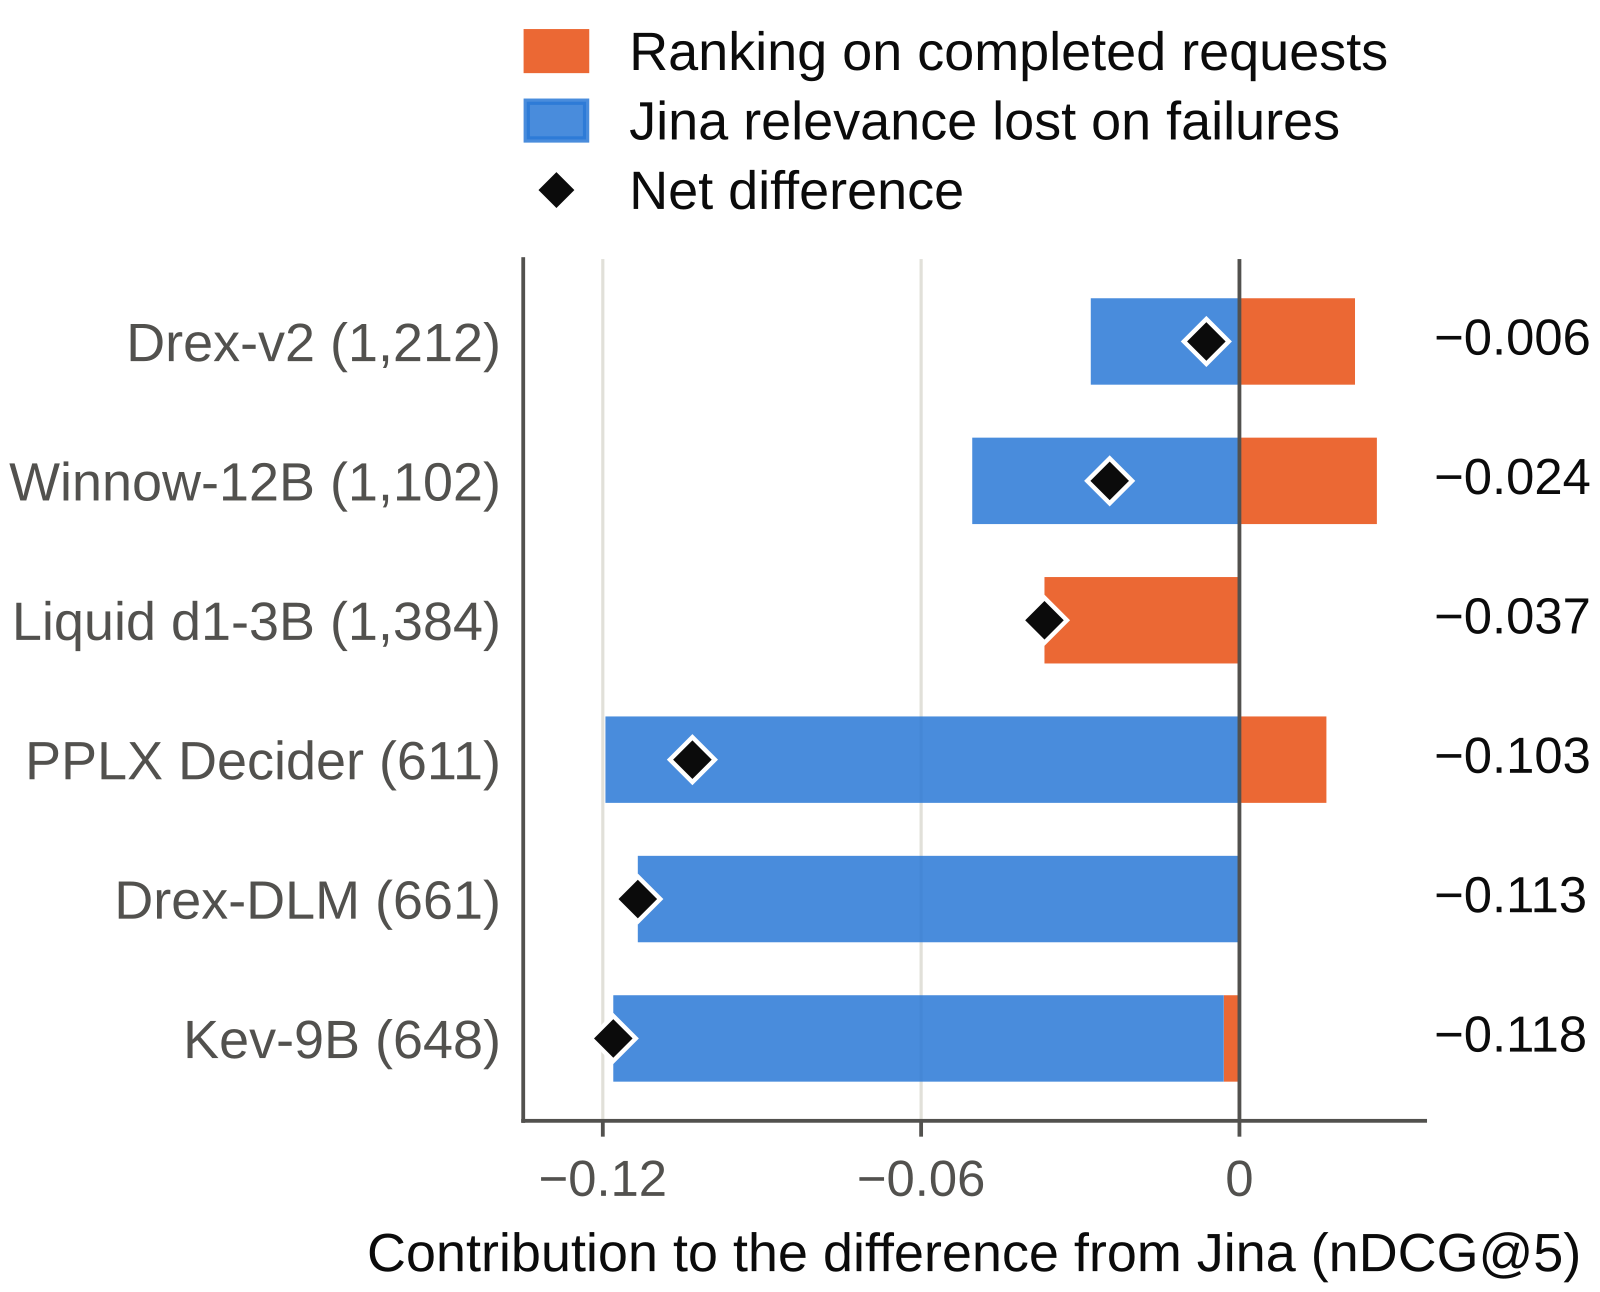
如果打算用一个新的大模型替换 RAG 里的 reranker,这篇的结论很直接:先把现有 reranker 调好,替换的理由多半不成立。作者拿 27B 的决策模型 PPLX Decider 和 0.6B 的专用 reranker Jina v3.5 在完全相同的候选列表上比。决策模型指一类不生成长回答、只返回打分或选项的大模型接口。默认设置下 PPLX 在 BRIGHT 上只有 44.1% 的请求能正常返回结果;只看成功的请求,它比 Jina 高 0.0371 的 nDCG@5,把失败的请求按零分算进来,反而低 0.1031。把每篇候选截短后它能追平 Jina,但显存峰值约 50 GiB,Jina 只要 4.3 GiB。
核心思想一句话:评估一个 reranker 替代品,要把可靠性、排序质量和延迟放在同一套请求上一起看,失败的请求不能从平均分里拿掉。我认为这篇的价值不在模型,而在这套评估方法,它把“排得好”和“能上线”分开了,任何打算换精排模型的团队都可以照搬。
它在回答什么问题?
RAG 系统一般先召回 20 篇左右,再用 reranker 选出前 5 篇交给生成模型。reranker 能提升质量,但候选多、文本长时延迟不小,于是有人想:决策模型一次前向就能在一组选项里挑出最好的几个,能不能更快地完成同样的工作?作者认为“更快”只是一个假设,因为决策模型同样要把问题和每篇候选读一遍。
先用一个示意场景说明为什么要把失败算进来。假设 5 个请求,Jina 都能返回,新模型有 2 个请求因输入太长报错:
| 请求(示意) | Jina 得分 | 新模型得分 |
|---|---|---|
| 短候选 A | 0.3 | 0.4 |
| 短候选 B | 0.2 | 0.3 |
| 短候选 C | 0.1 | 0.2 |
| 长候选 D | 0.5 | 报错 |
| 长候选 E | 0.4 | 报错 |
只看成功的 3 个请求,新模型每个都高 0.1;把 D、E 按零分算进去,新模型明显落后。失败恰好集中在长输入上,而长输入恰好是 Jina 表现更好的请求,只看成功请求等于挑了对新模型有利的子集。作者把这叫做“只算有效请求的陷阱”。
真实数据里也是这样。PPLX 失败的 773 个请求上,Jina 的 nDCG@5 是 0.214;PPLX 能完成的 611 个请求上,Jina 只有 0.147。两组里含有标注正例的比例差不多,所以差距不是标注造成的,而是长输入本身更难、也更有价值。
一个自然的补救是失败时回退到 BM25 的前 5 篇,生产系统通常也会这么做。回退让 Winnow-12B 和 Drex-v2 的全量得分超过了 Jina,但 PPLX 回退后是 0.1687,仍低于 Jina 且超出质量容差,因为它失败得太多,回退的 BM25 结果拉低了整体。
整体评估流程:固定召回,只换精排策略
召回结果固定,每个策略拿到同样的 query 和同样的前 20 篇候选,按 BM25 原始顺序排列,最后返回前 5 篇。PPLX 在一次前向计算中输出每篇候选的分数,系统取分数最高的 5 篇;同分时按候选原始顺序决定先后。被评估的是整套精排策略:模型本身、输入怎么截断、失败时是否回退到 BM25 前 5 篇。替换要同时过三道检查:
| 检查 | 标准 |
|---|---|
| 可靠性 | 至少 99% 的请求由模型自己返回合法的前 5 篇 |
| 排序质量 | 比 BM25 前 5 篇好,且相对全文 Jina 的 nDCG@5 差值,其 95% 置信区间下界高于 -0.02 |
| 服务延迟 | 同一张 A100 上,p95 延迟不超过 Jina 的两倍 |
显存不作为检查项,单独报告。置信区间按领域整体重采样做 bootstrap,因为同一领域内的 query 彼此相关;作者先在 11 个基准上粗筛了 21 个开源模型,其中 9 个专用 reranker、12 个决策模型,然后挑出 PPLX 和 Jina 这一对做对照实验。主实验用 BRIGHT 的 1,384 个推理型 query。
粗筛本身已经能看出端倪。Jina 在全部 11 个基准上都比召回原始顺序好;PPLX 在输入放得下时很有竞争力,在其余 10 个基准里有 5 个排第一,但它在好几个基准上是把每篇候选截到 128 个 token 才跑通的。失败也反复出现:Intern-Decision-4B 在企业文档基准的 500 个请求上全部超出上下文长度。不过粗筛各轮的输入处理并不统一,作者只拿它来挑候选模型,不拿来排名次,所以才有后面的严格对照。
为什么默认设置会失败,截断怎么修?
决策模型的输入上限是 8,192 个 token,而 BRIGHT 候选集合的中位长度就有 8,097 个 token,所以加上提示词之前已经有 49% 的集合超长。Jina 默认只会截掉 27,680 篇候选里的 48 篇。
作者的修法叫等长前缀截断:先给问题和提示词留够位置,再把剩下的预算平均分给 20 篇候选,每篇只保留开头那一段。这样一篇特别长的候选不会把其他候选挤掉,代价是可能丢掉藏在后面的证据。手算一下(示意):预算 4,096,问题和提示词占 1,000,再留 128 作余量,剩下约 2,968,平均分给 20 篇,每篇保留约 148 个 token。
截断后 PPLX 在 1,384 个请求里有 1,380 个正常返回,nDCG@5 从 0.0813 升到 0.1928,和全文 Jina 的 0.1844 相当。为了区分“模型排得好”和“读到的文本不同”,作者还让 Jina 读完全相同的截断文本,这时 PPLX 领先 0.0163,但统计上不显著。
截断并不对所有决策模型都有效。Kev-9B 和 Drex-DLM 截断后全部请求都能返回,nDCG@5 却只有 0.121 和 0.119,比不精排的 BM25 前 5 篇还低。这说明“能跑通”和“排得好”是两回事。
结果:质量能追平,延迟和显存追不上
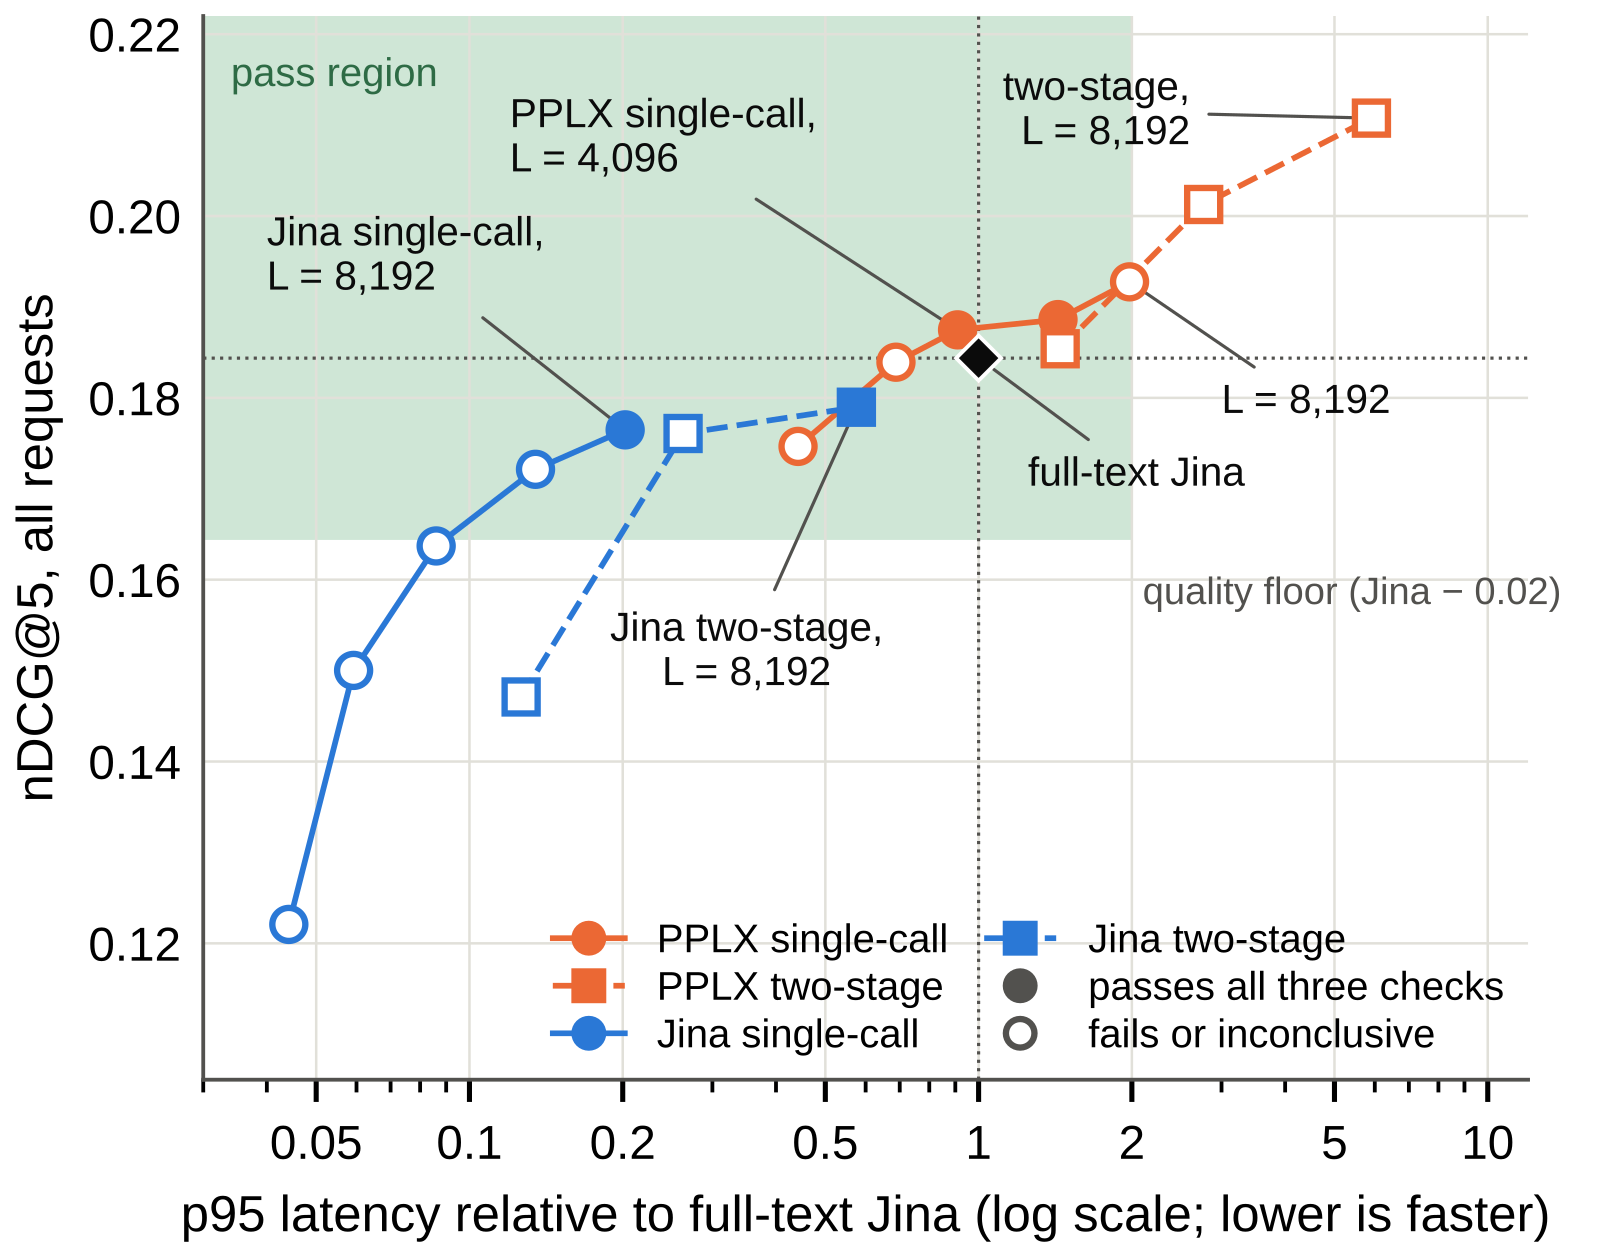
作者把输入预算从 1,024 扫到 8,192 个 token。PPLX 需要的输入远少于 Jina:3,072 个 token 时就到了 0.1839,和全文 Jina 几乎一样;Jina 读同样的截断文本只有 0.1500,要 8,192 个 token 才接近。这说明决策模型从每篇候选的开头就能抓到够用的信号。可是 PPLX 的延迟随预算增长,只有 4,096 和 6,144 这两档同时过了三道检查。
| 策略(BRIGHT) | 有效率 | nDCG@5 | p95 延迟 | 显存 |
|---|---|---|---|---|
| 全文 Jina | 100% | 0.1844 | 1,211 ms | 4.3 GiB |
| Jina 截断到 8,192 | 99.7% | 0.1765 | 245 ms | 1.9 GiB |
| PPLX 单次调用,4,096 | 99.2% | 0.1875 | 1,101 ms | 49.4 GiB |
| PPLX 两阶段,8,192 | 99.8% | 0.2108 | 6,700 ms | 50.1 GiB |
两阶段策略先把 20 篇候选分成两组,每组 10 篇,分别调用模型打分,各保留分数最高的 5 篇。系统再把留下的 10 篇候选文本交给模型,做第三次调用,按分数选出最终的前 5 篇。它的质量最好,比 Jina 高 0.0264,而且对 Jina 用同样的两阶段流程并没有带来显著提升,说明这部分优势确实属于 PPLX。但它的 p95 延迟是 Jina 的 5.9 倍,过不了服务检查。
最值得注意的是表里第二行:Jina 只是换了个截断策略,延迟降到 245 ms,同样过三道检查,比能过检查的 PPLX 配置快 4.5 到 7 倍,nDCG@5 只低 0.011 到 0.012。这意味着与其换模型,不如先调现有 reranker 的输入策略。显存差距同样大:能过检查的 PPLX 配置要 Jina 十一倍以上的显存,同一张卡上能部署的副本数会少得多,并发场景下这比单请求延迟更要紧。
候选顺序也会影响 PPLX。作者把同样 20 篇候选倒序或随机打乱再跑。平均分上 Jina 几乎不动,PPLX 在 BM25 原始顺序下比打乱后高 0.013,12 个领域全部如此。这说明 PPLX 的一部分得分来自召回已经排好的顺序,召回顺序变差时它的优势会缩小;两阶段版本对顺序就稳得多。
延迟的平均值还掩盖了领域差异。PPLX 的预算限制的是输入长度上限,各篇候选没用完的预算不会重新分配。在 4,096 token 预算下,PPLX 在 12 个领域的 p95 都在 1.0 到 1.1 秒之间;Jina 的延迟跟着候选文本长度走,从 158 毫秒到 3.5 秒。所以按领域算,PPLX 和 Jina 的延迟比从 0.31 倍到 6.8 倍不等,在生物、Pony 和可持续生活三个领域超过两倍。在这些领域中,候选文本较短时,Jina 的速度优势更大。
换个数据集,结论会变
作者在另外两个数据集上冻结协议重跑。企业文档问答 EnterpriseRAG-Bench 上,指标是前 5 篇里包含全部标注证据的问题比例,两阶段 PPLX 比两阶段 Jina 高 0.102;多跳问答 MuSiQue 上反而是 Jina 好 0.020。两边的 PPLX 都比全文 Jina 慢 6.5 到 17 倍。在 StackExchange 问答语料 CQADupStack 上,4,096 预算的 PPLX 又过了全部三道检查,6,144 那档在延迟上没有定论。这说明哪个模型排得更好取决于数据,而 PPLX 在迁移数据上比全文 Jina 更慢,BRIGHT 的 4,096 档则与全文 Jina 延迟接近。
我认为它的局限
第一,比较不对等。主对照是 27B 对 0.6B,而且 PPLX 是看过早期结果后才选中带进后续实验的;作者自己也承认,默认 Winnow-12B 加上 BM25 回退后,BRIGHT 得分高于截断 PPLX,却没有被带入后续深入实验。
第二,结论对阈值敏感。质量容差设为 0.02 是在看到初步结果之后定的;收紧到 0.01 时,单次调用的 PPLX 没有一档能过质量检查。延迟也只测了一次一个请求的串行场景,没有测并发和吞吐。
第三,BRIGHT 的标注不完整。1,384 个候选集合里只有 607 个包含标注过的正例,其余请求所有策略都是零分,所有差距都被压缩了,绝对数值需要谨慎解读。
一个推荐/搜索团队可以怎么试
- 评估任何精排替代品时,固定召回结果,让新旧策略吃同一批候选,记录每个请求是否成功,失败按零分或按回退结果计入,绝不从平均分里删掉。
- 先调现有 reranker:试几档候选文本截断长度,看质量损失和延迟收益,很可能当天就能拿到明显的延迟下降。论文里 Jina 截到 8,192 个 token 只损失 0.0079 的 nDCG@5,截到 4,096 就损失 0.0207,在企业文档上也明显变差,所以截断长度要按自己的数据扫一遍,不能照搬。
- 如果仍想试大模型,按长输入、短输入分桶看质量和 p95 延迟。BRIGHT 上,PPLX 在 4,096 token 预算下的 p95 在各领域相差不大,Jina 在候选文本较短的领域更快。
- 把显存当成上线成本的一部分,和延迟、质量一起写进验收标准。
一句话结论
决策模型能排得不错,但“排得好”不等于“能替换”。在这项评估里,调好的专用小 reranker 在延迟和显存上仍然明显占优。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。是否用大模型替换精排是很多团队真实面对的选择 |
| 方法创新性 | 中低。没有新模型,贡献在评估协议:计入失败、等长截断、三道检查 |
| 实验证据 | 中。控制变量和统计检验很细,但只深入比较了一对模型,阈值部分是事后定的 |
| 工程成本 | 低。评估方法和截断策略都能直接照搬 |
| 是否值得尝试 | 评估协议值得照搬;替换模型本身不建议优先做 |
| 适用场景 | 打算升级或替换 RAG 精排模块的团队 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…