目录 · 8 节
1它到底在解决什么问题?2核心想法:从球面换到概率单纯形3具体怎么做:一个适配器加一个打分函数4怎么衡量间隙?为什么要换指标?5实验结果:间隙小了多少,检索变了吗?6我认为它的局限7一个检索团队可以怎么试8结论与评价
做跨模态检索(用文字搜图片、搜音频)的团队值得读,但要带着一个问号读。它给出了一个极便宜的办法:在冻结的编码器后面接一个小适配器,输出再过一次 softmax,把向量变成“各维非负、加起来等于 1”的概率分布,文字和图片两团向量之间的距离就几乎消失了。核心一句话:换一个向量所在的空间,比改模型结构更能消除模态间隙。主表里两团向量中心的距离下降了 97% 到 99%,比如 COCO(常用的图文配对数据集)从 0.810 降到 0.012;但用对尺度做过归一化的指标看,同样结构的适配器加 softmax 前后只从 0.438 降到 0.239,检索得分也基本持平,图片检索上还略低。
它到底在解决什么问题?
先说什么是模态间隙。CLIP(图文模型)、CLAP(音频文字模型)这类对比学习模型把文字和图片(或音频)映射到同一个向量空间,配对的文字和图片向量会靠得近。但研究者早就发现,所有文字向量聚成一团、所有图片向量聚成另一团,两团之间有一段固定的距离,这就是模态间隙(modality gap)。
它为什么值得关心?一个检索场景说明(示意):
| 场景 | 有模态间隙时的问题 |
|---|---|
| 只用文字搜图片 | 影响不大,排序只看哪张图离这句话相对更近 |
| 文字库和图片库混在一起排序 | 文字结果的分数系统性地更高,图片总排在后面 |
| 用固定阈值判断“是否相关” | 同一个阈值对文字对文字、文字对图片含义不同,很难统一 |
学界对间隙到底有多大危害还有争论,有研究认为它会扭曲跨模态的相似度,也有研究认为硬把它消掉会破坏单个模态内部的结构。这篇论文的立场是:先证明用很小的代价就能把它消掉,而且检索效果不变差。
核心想法:从球面换到概率单纯形
常规做法是把向量归一化到单位长度,所有向量都落在一个高维球面上,用余弦相似度打分。论文改成用 softmax 把向量变成概率分布,所有向量都落在“概率单纯形”上,也就是各维非负、总和为 1 的那片区域,用总变差距离(Total Variation,TV)打分。
为什么换个空间就能拉近两团向量?先看球面上间隙为什么能一直存在。对比学习的损失只要求“配对的比不配对的分数高”,分数整体加减一个常数,排序不变,损失也不变。手算例子(示意):拿出一维专门表示模态,文字向量在这一维上取 +0.3,图片取 −0.3,其余各维表示语义。任何一对文字和图片的余弦里,这一维都贡献同样的 0.3×(−0.3)=−0.09,所有配对一起减 0.09,谁排第一不变。所以“两团各自偏向一边”的解和“两团重合”的解在损失看来一样好,训练没有动力去消除间隙。作者把这归结为球面和余弦相似度的对称性太多,留下了大量这样等价的解。 Hoot 说

球面 + 余弦(正文的论证)
- 模态维
- 文字 +0.3,图片 −0.3
- 配对的一对
- 语义分 + (−0.09)
- 不配对的一对
- 语义分 + (−0.09)
- 分差
- 常数 −0.09 抵消,损失看不出间隙
偏开和重合一样好,训练没有动力消除间隙。
单纯形 + TV 距离
- 没有间隙
- 配对 TV = 0,不配对 TV = 0.6,差距 0.6
- 有间隙:文字
- (0.56, 0.14, A 维 0.3, B 维 0)
- 有间隙:配对
- TV = (0.3 + 0.3) ÷ 2 = 0.3
- 有间隙:不配对
- TV = 0.72,差距 0.42 = 0.7 × 0.6
偏移不是给每一对加同一个常数:配对多了 0.3,不配对只多 0.12,差距直接变小。
两个语义 (0.8, 0.2) 和 (0.2, 0.8)、专门表示模态(文字还是图片)的那一维放 0.3,都是示意;左栏只是正文的论证:固定偏移的常数项在分差里抵消;严格放在单位球面上时语义部分也会随归一化缩放,这里不展开。TV 距离:两个分布的每个分量相减取绝对值,加起来再除以 2。右栏的距离是我们按 TV 定义算的,论文给的是直观解释和对照实验。 出处: 论文 §2:球面 + 余弦下,模态偏移对所有配对贡献同一常数,损失不变;单纯形各维非负、总和为 1,偏移要占用语义预算,配对与不配对的差距被压小
到了单纯形上,这种偏移变得很难做。各维都不能取负,就没法让文字取 +0.3、图片取 −0.3 站到同一根轴的两头;想偏开,只能让文字和图片各占一个专属的维度,比如文字在第 A 维放 0.3 的概率,图片在第 B 维放 0.3。但总和固定为 1,这 0.3 是从表达语义的预算里扣出来的,语义部分只剩 0.7,配对和不配对之间的分数差距被压小了,损失会变差。于是两种模态最省事的做法,就是把全部预算都花在同一套语义坐标上,两团自然重合。这是作者给出的直观解释,证据来自后面的成对对照实验。
还有一个附带的性质:softmax 对输入整体加一个常数不敏感。手算例子:输入 (2, 1, 0) 和 (5, 4, 3) 经过 softmax 都得到约 (0.665, 0.245, 0.090)。所以一个模态的输出整体偏高或偏低,都会被自动抹平,相当于多了一层跨模态的校准。
具体怎么做:一个适配器加一个打分函数
整个方法不改动预训练编码器。音频和文字用冻结的 LAION-CLAP,图片和文字用冻结的 FLAVA(一个图文多模态模型)。编码器输出一个向量后,接一个两种模态共用的小适配器(一层线性层,或两层 MLP 即多层感知机),再过 softmax。
打分用 TV 距离的相反数,TV 等于两个概率分布逐维相减取绝对值、求和再除以 2。手算例子(示意):文字向量 p=(0.7, 0.2, 0.1),图片向量 q=(0.5, 0.3, 0.2),逐维差的绝对值是 0.2、0.1、0.1,加起来 0.4,TV=0.2,打分为 −0.2,两个完全相同的分布打分是 0,完全不重叠的是 −1。训练用标准的批内对比损失:一个批次里每句文字要把它配对的图片排在其他图片前面,反过来也一样。适配器训练 20 万步,批大小 64,可训练参数不到总量的 1%。
为了证明效果来自几何空间而不是适配器本身,作者做了成对的对照:同样结构的线性层和 MLP,一组输出普通向量用余弦打分,一组接 softmax 用 TV 打分。还有一组对照是同样带交叉注意力的结构:100 个可学习的查询向量去关注单条输入(一句文字或一张图)自己的 token 表示,再取平均得到一个向量,所以文字和图片仍然各自独立编码,不需要对每个图文对联合计算。其中一个输出普通向量(XAttn),一个输出单纯形向量(ReTreever,作者团队之前的方法)。
怎么衡量间隙?为什么要换指标?
最直接的指标是中心距离:所有文字向量取平均、所有图片向量取平均,算两个平均点的直线距离。但这个指标在两种空间里尺度不同,直接比较会误导。
用一个数说明(示意)。球面上两个随机单位向量的距离在高维时约等于根号 2,也就是 1.41。单纯形上,如果向量是“稠密”的概率分布,按论文给出的公式,维度 d=100 时两个随机分布距离的平方约为 2×2÷101−2÷100≈0.0196,距离约 0.14,只有球面上的十分之一。所以单纯形上的中心距离天然就小,97% 到 99% 的降幅里有一部分是尺度带来的。
作者也意识到了这一点,提出了 RelGap:用中心距离除以两个模态内部的平均分散程度。分散程度这样算:每个文字向量到文字中心的距离取平方再平均,图片同理,两个平均值再取平均、开根号,作为分母。手算例子(示意):文字向量到中心的平方距离平均是 0.01,图片是 0.01,分母就是根号 0.01=0.1,中心距离 0.02 时 RelGap 是 0.2。这个比值不受整体尺度影响,可以公平地比较两种空间。作者还测了学到的向量到底稠密还是稀疏。做法是把学到的概率向量看成从对称狄利克雷分布里抽出来的,估计它的集中度参数 α。α=1 时,概率向量在单纯形上均匀分布,各维都分到一些概率,算稠密;α 远小于 1 时,大部分概率集中在少数几维,比如 4 维时像 (0.9, 0.05, 0.03, 0.02),算稀疏。SoundDescs 上,维度从 2 升到 1024 时,估计出的 α 从约 18 降到约 0.06,在 16 维时就已经低于 1。这说明高维时学到的是稀疏分布,距离不会随维度一直缩小,间隙小不能全归因于尺度。
实验结果:间隙小了多少,检索变了吗?
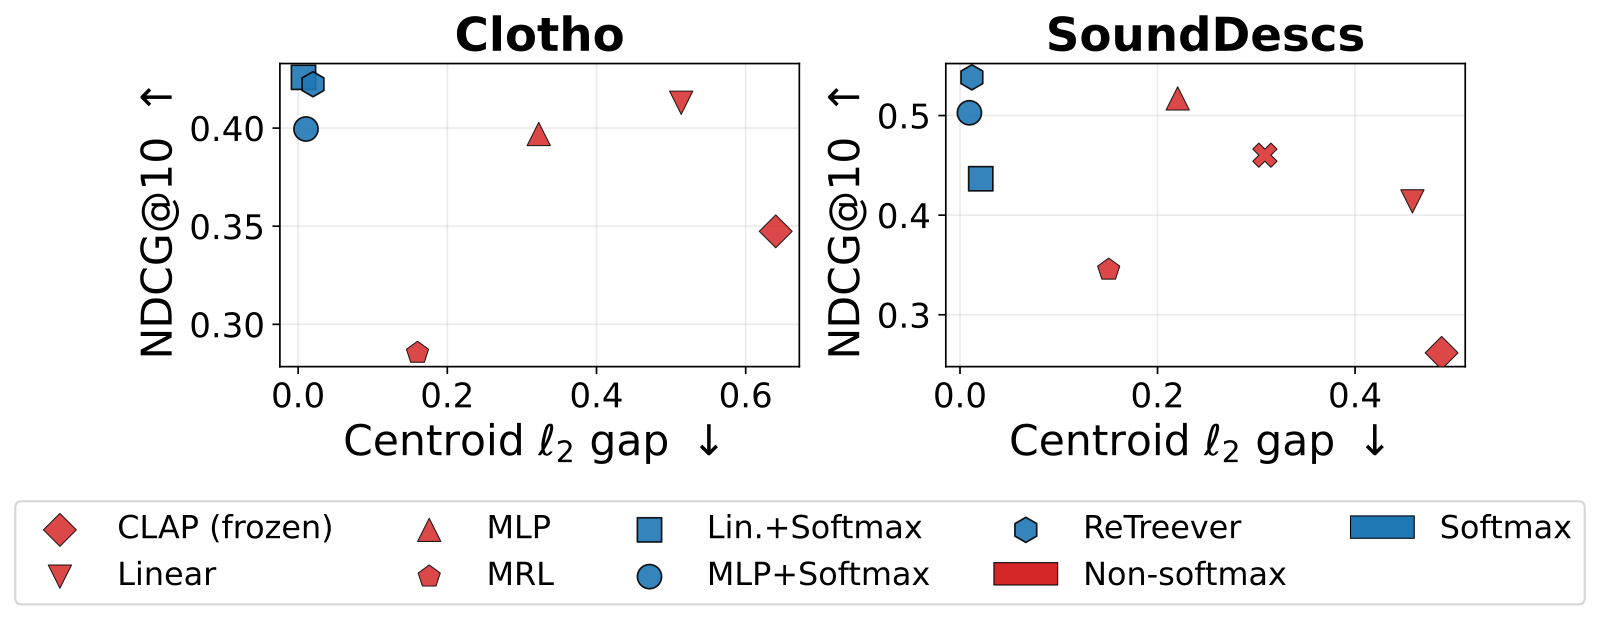
下面是成对对照的关键数字,RelGap 越小越好,NDCG@10(前 10 个结果的排序质量)越大越好:
| 数据集 | 适配器 | 中心距离 | RelGap | 检索 NDCG@10(文字搜对方) |
|---|---|---|---|---|
| COCO(图文) | MLP | 0.411 | 0.438 | 0.688 |
| COCO(图文) | MLP 加 softmax | 0.012 | 0.239 | 0.686 |
| SoundDescs(音文) | MLP | 0.220 | 0.264 | 0.520 |
| SoundDescs(音文) | MLP 加 softmax | 0.010 | 0.179 | 0.507 |
| Clotho(音文) | 线性层 | 0.514 | 0.689 | 0.373 |
| Clotho(音文) | 线性层加 softmax | 0.007 | 0.468 | 0.382 |
两组对照放在一起看,说明了两件事。第一,换成单纯形后,RelGap 确实稳定下降,间隙缩小不只是尺度造成的。第二,检索得分基本持平,有升有降:Clotho 上略升,COCO 和 SoundDescs 上略降。交叉注意力的对照也一致:SoundDescs 上 XAttn 的 RelGap 是 0.331,ReTreever 是 0.097。消除间隙的主因是输出空间,而不是加了注意力层。
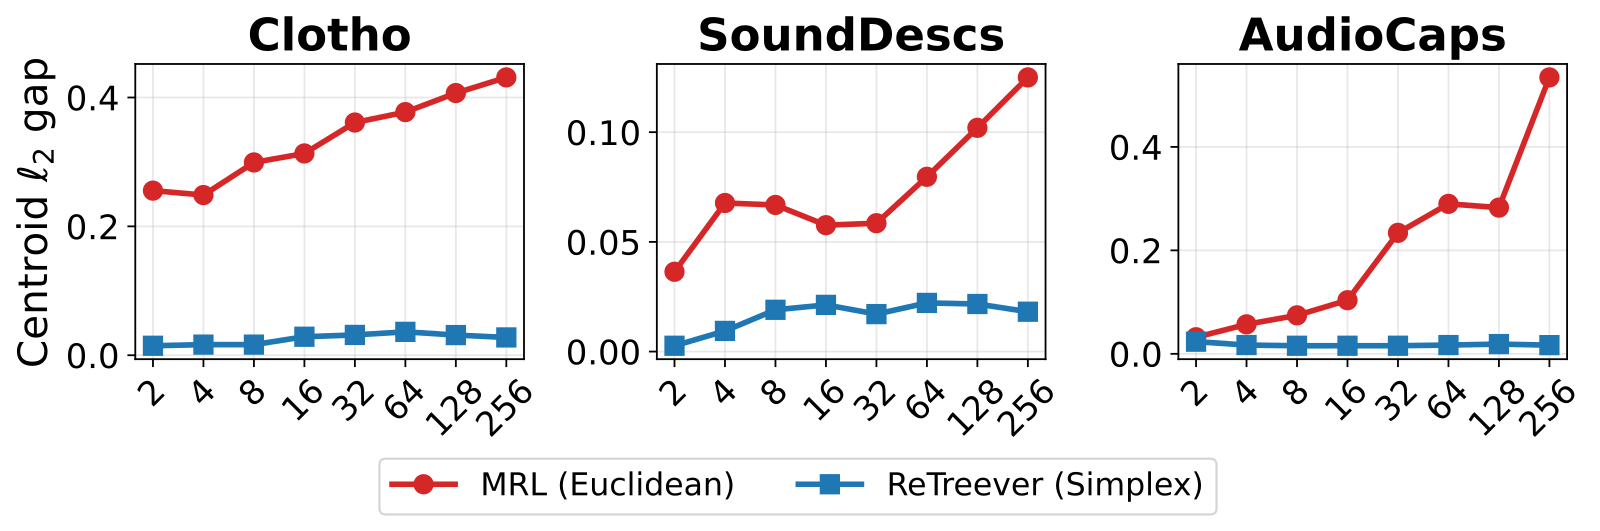
维度实验更有意思。MRL(Matryoshka 套娃式表示)是一种能截取前几维做粗检索的向量表示。AudioCaps 上,MRL 的中心距离从 2 维的 0.032 涨到 256 维的 0.534,涨了约 17 倍,而 ReTreever 始终低于 0.06。也就是说,普通向量维度越高,两种模态越容易各自分开。
我认为它的局限
第一,检索没有变好。主表里同结构适配器加 softmax 后,COCO 文字搜图从 0.688 到 0.686、SoundDescs 文字搜音频从 0.520 到 0.507,基本持平或略降。如果业务只做单向的文字搜图片,排序本来就不受间隙影响,这个方法不会带来收益。
第二,表格里线性层和 MLP 加 softmax 的那两行,配置和方法部分写的不完全一样。音频文字表里,每个数据集取两种配置里较好的一种:一种是适配器输入先做 L2 归一化、softmax 前不做归一化(论文主配置),另一种是输入不归一化、softmax 前对输出加一层 LayerNorm。图文表里这两行用的是输入不归一化的版本。论文脚注写明了这些,但这意味着这两行比其他行多了一次挑选,和对照组比较时有一定优势。
第三,实验规模小。五个数据集都是学术基准,最大的 COCO 也只有十余万张图,检索库规模和线上差很多;适配器只在两个冻结编码器上测过。
一个检索团队可以怎么试
- 先确认问题是否存在:如果系统里要把文字结果和图片结果放在同一个列表里排序,或者要用统一阈值过滤跨模态结果,就统计一下两种模态的分数分布是否明显错开。
- 在现有编码器上接一个两层 MLP 适配器,分别训练“普通输出加余弦”和“softmax 加 TV”两个版本,比较 RelGap 和检索指标,同时看混合排序的效果。
- 上线检索时注意,TV 距离就是 L1 距离(各维差的绝对值之和)的一半,向量库需要支持曼哈顿距离,不能直接沿用内积或余弦索引。
结论与评价
这篇论文最大的价值是一个清楚的几何解释:模态间隙很大程度上来自球面上过多的对称自由,把向量约束到概率单纯形上就能消掉它,代价只是一个小适配器。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中。对混合排序和跨模态阈值有影响,单向检索影响有限 |
| 方法创新性 | 中高。不改模型、只换输出空间,思路新颖,对称性的解释有说服力 |
| 实验证据 | 中。成对对照设计得好,提出了更公平的 RelGap,但检索没有提升、规模小、部分结果挑选了配置 |
| 工程成本 | 低。冻结编码器加不到 1% 的参数,但检索要换成 L1 距离 |
| 是否值得尝试 | 有混合模态排序需求的团队值得试;只做单向图文检索的可以只读不试 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…