目录 · 10 节
1它到底在解决什么问题?2整体流程:把“覆盖”显式算出来3双塔怎么学“补缺口”4覆盖矩阵和贪心选择:每次挑补得最多的那篇5检索上的效果6找得更全,答案却没更全7让模型回头看自己漏用的文档8我认为它的局限9一个搜索团队可以怎么试10结论
这篇论文做了一条显式计算“覆盖”的长答案 RAG 检索链路,并用它发现:检索覆盖得更全,答案不一定更全。按相关度逐篇打分取前十,挑出的文档常常反复讲同一个方面;作者改成先让 LLM 把问题拆成一组子问题,再用一个 cross-encoder 预测每篇候选文档能回答哪些子问题,然后每次挑一篇能补上最多新子问题的文档。在 TREC RAG 2024 上,α-nDCG@10 从 0.625 提到 0.702,接近把子问题换成人写答案要点时的上限 0.718。可在生成模型、候选池和文档预算都固定的对照里,直接按参考标注(事先标好每篇文档覆盖哪些要点)挑出的文档覆盖得更全,写进答案的要点却并不比它多。答案完不完整,不只取决于找到了什么,还取决于生成模型有没有用上。作者据此加了一步自评重写,把模型指回它漏用的文档,两轮后必须要点的覆盖提高 0.086。
它到底在解决什么问题?
长答案 RAG 指的是用户问一个需要写成一段报告的问题,系统检索一批文档,交给生成模型写成十来句带引用的回答。评测这种回答时,常用的做法是先把参考答案拆成一条条原子事实,论文叫 nugget,下面叫“答案要点”,再看系统的回答写到了几条。
问题在于,检索器给每篇文档单独打相关度分,然后取前十。设想一个问题「家用电动车值得买吗」(示意),完整的回答至少要讲续航、充电、保养成本、保值和安全五个方面:
| 排名 | 按相关度取的文档(示意) | 新覆盖的方面 |
|---|---|---|
| 1 | 冬季续航实测 | 续航 |
| 2 | 十款车续航对比 | 无 |
| 3 | 高速续航衰减 | 无 |
| 4 | 家用充电桩安装 | 充电 |
| 5 | 续航焦虑怎么缓解 | 无 |
五篇都很相关,可其中三篇讲的是同一件事,保养、保值和安全一篇都没有。每篇单独看分数都高,合在一起却浪费了上下文。
论文给了真实的量级:在 TREC RAG 2024 上,如果直接用参考标注,也就是事先标好的“每篇文档覆盖哪些要点”(要点由人写,对应关系由 LLM 判),只挑 5 篇就能覆盖 85.8% 的要点,挑 10 篇也还是这个数;而一个专门为覆盖训练过的双塔检索器,取前 10 篇只覆盖 76.2%。也就是说,按参考标注挑,5 篇以后的名额已经补不出新要点;而逐篇打分的检索器用满 10 个名额,覆盖的还更少,名额里有不少重复的证据。
常见的补救是 MMR 这类多样性重排,用和已选文档的相似度来判断重复。作者认为这个代理不对。两篇文档 embedding 不像,并不代表后一篇带来了新的要点;它可能只是换了写法,或者讲的是题外话。真正该问的是:这篇文档能回答哪些还没被回答的子问题。
整体流程:把“覆盖”显式算出来
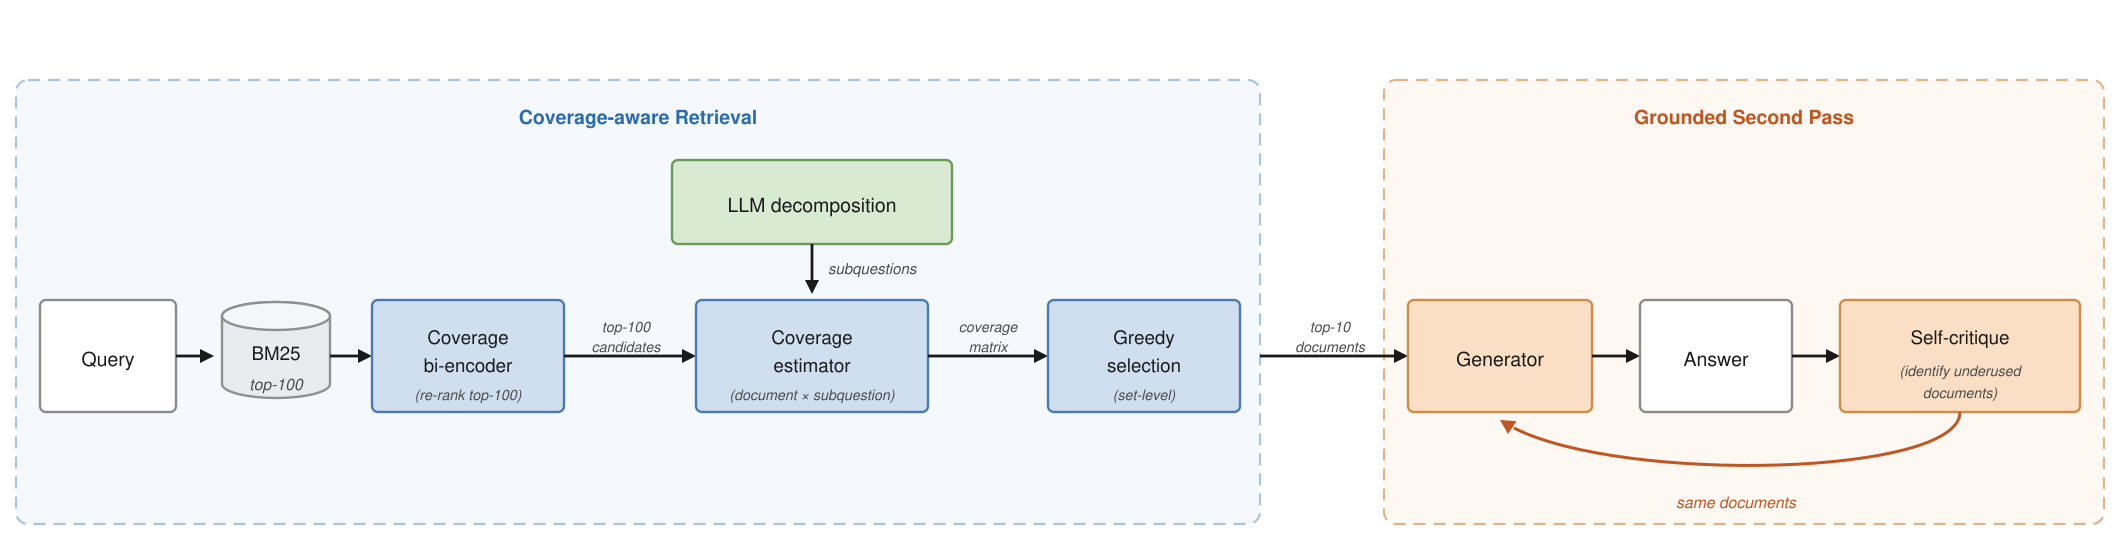
整条链路分四步,每一步的产出如下:
| 步骤 | 做什么 | 产出 |
|---|---|---|
| 候选池 | BM25 取前 100 篇 | 所有方法共用的同一个池子 |
| 双塔重排 | 为覆盖训练过的 ModernBERT 双塔给 100 篇打分 | 一个排序,后面用来打破平局 |
| 拆子问题 | 让 LLM 为问题写 10 个能独立读懂的子问题 | 一张子问题清单 |
| 覆盖估计 + 贪心选择 | cross-encoder 给每对(文档,子问题)打 0 到 1 的分,0.3 以上算覆盖;再贪心挑 10 篇 | 最终交给生成模型的 10 篇 |
关键的分工是:双塔负责“这篇大致相关”,覆盖矩阵负责“这篇补上了哪几个缺口”。下面拆开讲。
双塔怎么学“补缺口”
双塔这一步复现的是已有工作 CoveR 的训练目标,作者明确说这不是本文贡献,放进来是为了让后面的选择步骤建立在一个够强的检索器上。训练数据来自 Researchy Questions:每个问题配好了 GPT-4 写的子问题,再由 Llama 给每对(文档,子问题)打 0 到 5 分,4 分及以上算这篇文档能回答这个子问题。
训练时先随机假设一部分子问题已经被覆盖。能回答至少一个还没覆盖的子问题的文档算正例;只能回答已覆盖子问题的算“重复负例”;什么都回答不了的算无关负例。这组已覆盖的子问题也是模型输入的一部分:训练时双塔 query 一侧是问题和这组已覆盖子问题配在一起,再和正例、负例文档比。所以同一篇文档换一组已覆盖子问题,标签可以不同,模型学的是“已经有这些证据时,哪篇还能补东西”。论文没说上线打分时 query 一侧的已覆盖部分填什么。上线时它对 BM25 取回的 100 篇候选各打一次分、排好序。贪心选择过程中这个分数不随已选文档重算,只用来打破平局。训练集只有 847 个问题上的 1,929 条样本。
作者也试过一个大得多的版本:2 万个问题、44,558 条样本,正例要求覆盖一半以上还没覆盖的子问题。结果反而更差(α-nDCG@10 0.598 比 0.656)。原因是开头一篇都没选时,所有子问题都没覆盖,这条严格规则会把大量中等相关的文档当成中性样本丢掉。这个版本同时改了样本量和正例规则,论文没有把两者分开测,所以只能说更严格的正例规则加更多数据并没有带来提升。
覆盖矩阵和贪心选择:每次挑补得最多的那篇
为什么双塔之外还需要单独一步?因为双塔给每篇文档单独打分,它没法知道前面已经选了什么。“这一组文档一共覆盖几个子问题”是整组的属性,必须在选的过程中算。
覆盖估计器是一个 ModernBERT cross-encoder,输入是一篇文档和一个子问题,输出这篇文档能回答它的概率。它的训练标签同样是 Llama 打的 4 分及以上,规模是 3,000 个问题上的 85 万对样本。对一个问题,100 篇候选和 10 个子问题两两配对,所以每个问题要打 1,000 次分,得到一张覆盖矩阵。矩阵里 0.3 以上记为 1,意思是这篇能回答这个子问题。
贪心选择的规则很简单:每次挑能回答最多“还没被回答的子问题”的那篇,平局时按双塔分数。用上面电动车的例子(示意):
| 轮次 | 候选及新覆盖数 | 选中 | 已覆盖 |
|---|---|---|---|
| 1 | 冬季续航实测 2(续航、安全),购车成本全算 3(保养、保值、充电) | 购车成本全算 | 保养、保值、充电 |
| 2 | 冬季续航实测 2,十款车续航对比 1 | 冬季续航实测 | 全部 5 个 |
| 3 | 所有候选都是 0 | 按双塔分数 | 不变 |
第三轮起已经没有缺口可补,规则就退回双塔顺序,所以输出总是一个完整的排序。这和 MMR 的区别在于,判断“有没有新东西”看的是能回答哪些子问题,而不是 embedding 有多像。
检索上的效果
主结果在 TREC RAG 2024 的 56 个问题上。主指标是 α-nDCG@10。StRecall@10 是前十篇里覆盖到的不同要点占全部要点的比例,不管排在第几。
| 方法 | α-nDCG@10 | StRecall@10 | P@10 | nDCG@10 |
|---|---|---|---|---|
| 只按相关度训练的双塔 | 0.625 | 0.744 | 0.754 | 0.784 |
| + 覆盖训练 | 0.656 | 0.762 | 0.773 | 0.798 |
| + 覆盖估计和贪心选择 | 0.702 | 0.770 | 0.775 | 0.800 |
| 用人工要点代替子问题(拆题上限) | 0.718 | 0.781 | 0.771 | 0.802 |
| 用参考标注的覆盖矩阵(选择上限) | 0.887 | 0.858 | 0.800 | 0.857 |
覆盖训练带来 0.031,显式选择再带来 0.046。在检索器不变的情况下,把覆盖当成整组的选择问题,比只改检索器的训练目标收益更大。P@10 和 nDCG@10 每一步都持平或略升,说明这份覆盖不是拿相关度换的。
两个上限分得很清楚。把 LLM 写的子问题换成人写的参考要点,只多 0.016;把预测的覆盖矩阵换成参考标注的,多出 0.169。剩下的空间主要在覆盖估计,也就是判断“这篇文档能不能回答这个子问题”还不够准。
拆题模型的影响也不大。在 0.3 阈值下,用 Qwen2.5-7B 拆题得 0.675,用 GPT-4o 得 0.702,说明从 7B 换到最强的模型只值 0.027。全开源的 Llama-3.3-70B 比 GPT-4o 只低 0.019,所以部署时可以先不用闭源模型。
找得更全,答案却没更全
这是全文最值得看的部分。作者固定生成模型(Qwen2.5-7B-Instruct)、裁判、候选池和 10 篇的预算,每篇截到 250 词,只换选文档的方式:A 是双塔取前十,B 是本文方法,O 是用参考标注的覆盖矩阵贪心选。然后看生成的答案。
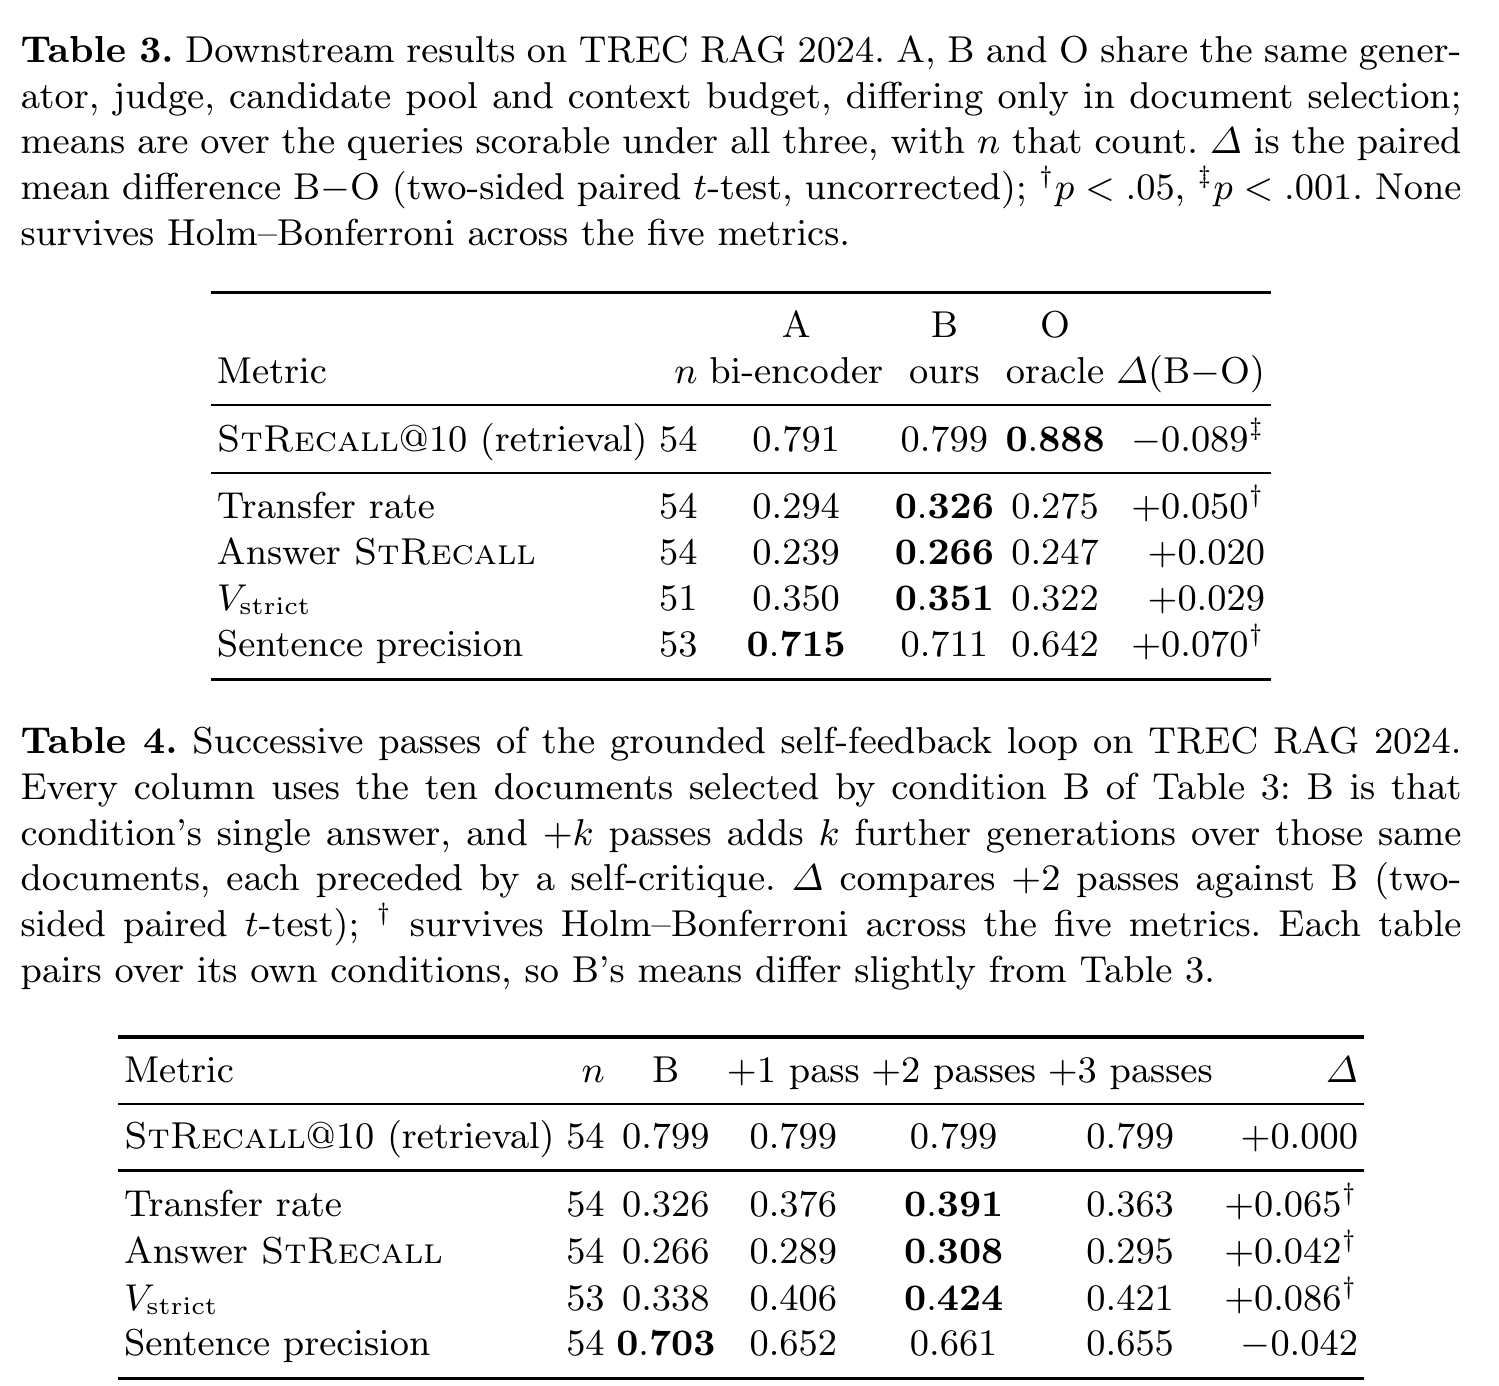
这里有几个指标要先说清。转化率是上下文里有的要点有多少写进了答案;答案 StRecall 是答案写到的要点占全部要点的比例;V_strict 是被标为“必须有”的要点里,答案完整写到的比例;句子准确率是答案里有引用的事实句中,引用的文档确实支持它的比例。
按参考标注矩阵选出的文档覆盖了 88.8% 的要点,本文方法是 79.9%,差距显著。可转化率反过来:本文 0.326,参考标注 0.275;句子准确率 0.711 对 0.642。答案 StRecall 和 V_strict 本文也略高,但不显著,多重比较校正后所有差异都不显著。作者自己的读法很克制:这不说明本文选得更好,只说明检索覆盖的大幅领先没有变成更全的答案。
本文方法和简单的双塔前十比也没有稳定的优势。在 TREC RAG 2024 上答案 StRecall 高 0.027,不显著;换到 CRUX-DUC04,检索覆盖略高,答案 StRecall 反而低 0.024。两个数据集合起来只差 0.003。
作者给的解释是:一组覆盖更全的文档,彼此共享的事实更少。答案长度固定在十来句时,模型要在互不相关的点之间来回跳,每点都写不深。论文说明这只是与已有发现一致的推测,实验没有单独验证它。
让模型回头看自己漏用的文档
既然瓶颈在生成,作者在第一版答案之后加了“自评+重写”:模型先读自己上一版答案,指出哪些文档用得不够,然后被引导回这些文档,在同一批 10 篇上重写,要求写 18 句左右。论文没说自评这一步(论文叫 iter2self)除了上一版答案还看到哪些输入、按什么判断文档用得不够。下面说的“一轮”“两轮”,都指第一版之后做了几次这样的重写。整个过程不检索新文档,也不看任何参考答案。
只把句数从 12 改成 18 是不够的:第一轮直接要 18 句,转化率不变,答案 StRecall 还略降 0.003。所以收益来自“指向漏用的文档”,不是写得更长。
重写两轮后,V_strict 从 0.338 升到 0.424,转化率和答案 StRecall 也同步上升,三项在校正后都显著,说明模型确实把更多已有证据写进了答案。做第三轮反而回落,所以两轮就该停。代价是句子准确率:第一轮重写后掉了 0.050,之后不再继续掉,两轮后比原来低 0.042,不显著,意味着多写的内容大部分仍有出处。
反馈该给什么,作者比了三种:直接把漏掉的参考要点文字塞给模型,转化率冲到 0.771,但句子准确率从 0.703 跌到 0.413,因为模型复述了它在文档里找不到出处的内容;只告诉模型哪些文档支持漏掉的要点,V_strict 提高 0.083,准确率只降 0.031;完全靠模型自评,拿到了“只告诉支持文档”这种做法约 80% 的收益(0.068)。反馈应该把模型指回已有的证据,而不是替它补上内容。
我认为它的局限
第一,样本太小。两个评测集分别只有 56 个和 50 个问题,下游比较里多数差异在多重比较校正后都不显著。表 1 的检索结果没有做显著性检验,作者自己说排序只能当参考。
第二,阈值选在测试集上。0.3 这个覆盖阈值是在评测集上挑的,没有留出验证集,作者承认 0.702 偏乐观。人写的要点在 0.7 阈值下最好,LLM 子问题在 0.3 下最好,说明换一套子问题来源就要重新调阈值。
第三,成本没报告。覆盖估计每个问题要跑约 1,000 次 cross-encoder,自我反馈每多一轮就要在完整上下文上再生成一次,论文没有给延迟或算力数字。另外文档—要点的对应关系是 LLM 判的,和人工比准确率约 69%、召回约 90%,绝对分数会带着这个裁判的偏差。
一个搜索团队可以怎么试
第一步,先量一下自己的转化率。拿一批需要长答案的 query,用 LLM 把参考答案拆成要点,分别统计检索结果覆盖了多少、答案写进了多少。如果转化率也在 0.3 左右,说明先改生成比先改检索更划算。
第二步,试最便宜的自我反馈。不改检索,在现有上下文上加一轮:让模型先指出用得不够的文档,再重写。看必须要点的覆盖和引用准确率,两轮后不再加。
第三步,再试覆盖选择。用现成的 cross-encoder 给(文档,子问题)打分,配 LLM 拆题和贪心挑选,在留出集上调阈值,并单独记下每个 query 增加的打分次数和延迟。
第四步,两者都有效时再组合,比较检索覆盖、答案覆盖和引用准确率三条线,别只看检索指标。
结论
这篇的检索方法本身是稳妥的工程改进,真正值得带走的是它的对照实验:检索覆盖从 0.799 提到 0.888,答案并没有因此更全,转化率一直在 0.3 附近。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。长答案 RAG 普遍用相关度取前十,重复证据浪费上下文是常见问题 |
| 方法创新性 | 中。拆题、覆盖打分、贪心挑选都是已有思路,新在用预测的覆盖矩阵代替相似度去重 |
| 实验证据 | 中。控制变量做得干净,但两个评测集只有 56 个和 50 个问题,多数下游差异不显著,阈值调在测试集上 |
| 工程成本 | 中高。每个 query 约 1,000 次 cross-encoder 打分,自我反馈每轮多一次完整生成 |
| 是否值得尝试 | 值得,先做自我反馈。它不动检索、不需要标注,两轮就让必须要点的覆盖提高 0.086 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…