目录 · 9 节
1它到底在解决什么问题?2整体流程:LLM 只做三件生成的活3为什么每次只写一个“自包含”的子问题?4为什么记账和判断不交给 LLM?5为什么答案可以跨问题复用?6效果怎么样?7我认为它的局限8一个问答搜索团队可以怎么试9结论
做 RAG 和问答搜索的团队值得读这篇,因为它把迭代式检索里 LLM 身兼数职的问题拆得很清楚,而且拆完之后准确率、上下文长度和可复用性都变好了。多跳问题要靠中间实体一环扣一环地找证据,可问题本身从不提这些中间实体。图检索类 RAG 从问题点到的实体出发,大多只走到第一环,三跳问题里能把整条证据链找全的不到一成。迭代式方法能一步步找,但 LLM 要同时规划、排先后、改写、记账,每件事都会出错。DeFT-RAG 让 LLM 每次只写一个把实体名写全的子问题。答出的子问题连同答案按规则写进问答表,不靠 LLM 记;某段是否相关、已有答案够不够用这类是非判断,交给微调过的小模型。在 MuSiQue 上,用 gpt-4o-mini 时准确率从最强基线的 0.577 提到 0.629。在 1,000 道 MuSiQue 题共享缓存时,23.1% 的子问题直接从缓存作答,LLM 调用少了 12.9%,准确率不降。让 LLM 每次只做一件小事,比让它一口气规划整条链更可靠。
它到底在解决什么问题?
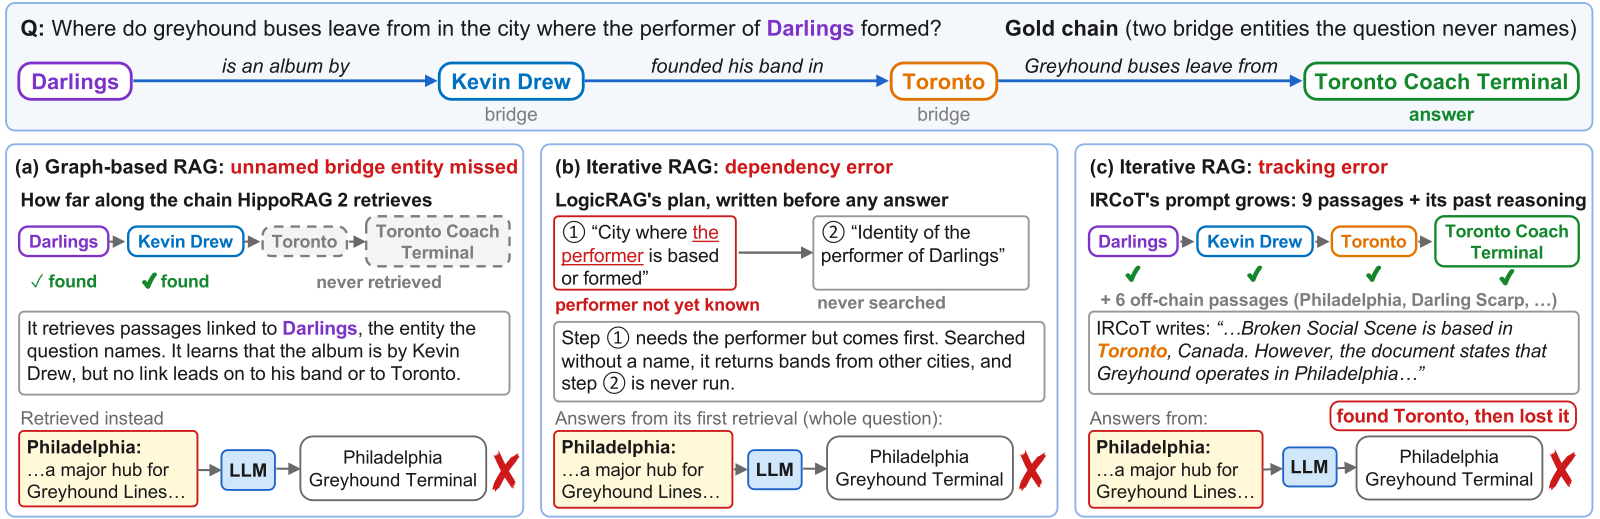
论文用的例子是:「Darlings 这张专辑的表演者是在哪个城市组建乐队的?那个城市的灰狗巴士从哪里发车?」正确的链是 Darlings → Kevin Drew(专辑作者)→ Toronto(他组建 Broken Social Scene 的城市)→ Toronto Coach Terminal。中间的 Kevin Drew 和 Toronto 论文叫桥接实体:证据链要经过它们,可问题里一个字都没提。
只拿问题去检索,召回的是字面相近的段落:讲灰狗这种狗的、讲一款 Greyhound 大巴车型的、讲一个叫 Darling 的人的。讲 Kevin Drew 和 Toronto 的段落排不上来。在 MuSiQue 上,普通 RAG 只给 7% 的三跳问题找全了证据链。
论文图 1 把现有两类方法的失败各演示了一遍:
| 方法 | 走到哪一步 | 错在哪 |
|---|---|---|
| HippoRAG 2(图检索) | 从 Darlings 走到 Kevin Drew | 图里没有连到他的乐队和 Toronto 的边,最后拿费城的灰狗车站作答 |
| LogicRAG(先规划再检索) | 计划第一步就问“表演者在哪个城市组乐队” | 表演者还没找到就去搜城市,搜回别的城市的乐队 |
| IRCoT(边推理边检索) | 三段正确证据都在提示里,推理里也写了乐队在 Toronto | 后面跟着一段讲费城的段落走了,忘了自己已经找到的事实 |
这三种错各有来路。图检索一般每个问题只检索一次,从问题提到的实体出发沿图走,很难越过第一个桥接实体:多数图方法只给 6% 到 10% 的三跳问题找全了证据链。迭代式方法能边答边找下一个桥接实体,可它们让 LLM 在一次调用里同时做好几件事:提前规划子问题、决定子问题之间谁依赖谁、拿到答案后改写下一个子问题、在越来越长的提示里记住已经知道什么。论文把错误也按这四件事分成规划错、依赖错、改写错和记账错。
还有一个放大误差的因素:大多数方法每次固定取前 k 段。论文在一批一步就能答的 MuSiQue 题上测过:给前 5 段时准确率 0.620,给前 10 段时 0.630,几乎没变,虽然证据齐全的比例从 62% 升到 88%。从前 10 段里只留下真正需要的段落,准确率升到 0.793。这说明多给段落并不能帮 LLM 答对,关键是把无关段落拿掉。
整体流程:LLM 只做三件生成的活
DeFT-RAG 把 LLM 的工作压缩成三件:写下一个子问题、根据段落回答一个问题、根据问答表回答原问题。其余的活要么交给规则,要么交给一个 4B 的判断小模型(论文叫 decision model,下文简称判断模型)。
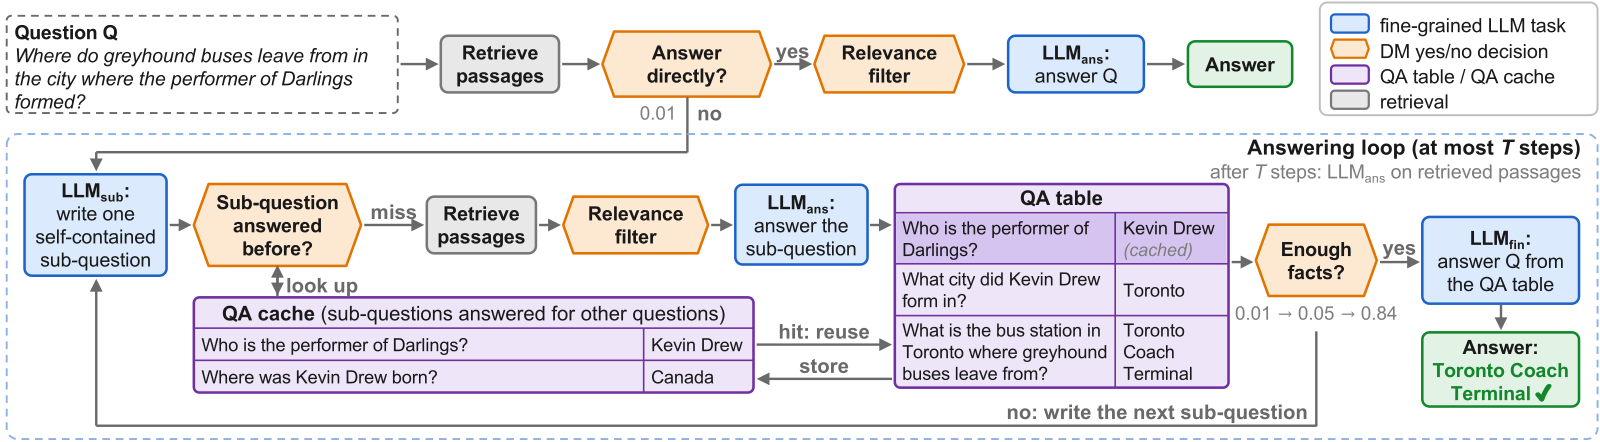
一道题的走法:
| 步骤 | 谁做 | 做什么 |
|---|---|---|
| 1 | 判断模型 | 读原问题检索到的前 10 段原文,判断这 10 段是否已经包含全部证据(训练标签也按这 10 段定义);概率不低于 0.7、且题目不是问祖父母或姻亲这类复合亲属关系(用关键词识别)时,就逐段筛出相关段,由 LLM 只看筛出的段直接作答 |
| 2 | LLM | 根据原问题和问答表,写下一个自包含的子问题 |
| 3 | 判断模型 + LLM | 子问题检索前 10 段,判断模型逐段判断相关不相关,LLM 只看留下的段落给一个短答案 |
| 4 | 规则 | 把子问题和答案写进问答表 |
| 5 | 判断模型 | 看问答表够不够回答原问题;够了就让 LLM 读原问题和问答表作答(不再看段落),不够回到第 2 步 |
第 2 到第 5 步构成一轮循环,每轮写一个子问题,最多循环 6 轮;6 轮后还不够,就从原问题检索的前 20 段里筛出相关段直接作答。下面拆开讲三个设计。
为什么每次只写一个“自包含”的子问题?
自包含的意思是:子问题里把要问的实体名字写全,不用“那个城市”“这位表演者”这种指代,也不依赖别的子问题的答案,单拿出来就能检索、能回答。论文的例子:问答表里已经有“莱茵河注入北海”,这时“北海在哪里和大西洋相接?”是自包含的,“那片海在哪里和大西洋相接?”就不是。
拿 Darlings 那道题走一遍:问答表为空时,LLM 写出“Darlings 的表演者是谁?”,答案 Kevin Drew 进表;下一轮它看到表里有 Kevin Drew,写出“Kevin Drew 在哪个城市组建乐队?”,答案 Toronto 进表;再下一轮写出“Toronto 的灰狗巴士从哪里发车?”。每一步的子问题都是在已知答案上现写的。
这样做为什么能避开前面那几种错?因为不提前规划,就不用在找到桥接实体之前去猜它;子问题之间没有依赖,也就没有依赖关系可以排错,答案回来后也不需要改写别的子问题。LLM 每次只做一件事:写出下一块缺的信息该怎么问。
为什么记账和判断不交给 LLM?
记账交给问答表。问答表就是一张两列的表,每行一个子问题和它的答案,完全由规则更新,不调用任何模型。“答没答出来”看的是 LLM 的回答本身:LLM 从筛出的段里给出了答案,这一对就加进去;LLM 给不出答案,这个子问题就记下来,下一轮提示里告诉 LLM 别再这样问;新写的子问题如果和问过的措辞相同,就让 LLM 换一个。写子问题、判断够不够、给最终答案,三处的输入都是原问题加这张表,不带历史段落和推理过程。和 IRCoT 那种把所有段落和推理过程塞进一个越来越长的提示相比,这张表短,而且每个找到的实体都明明白白写在里面,不会出现“前面推理里写了 Toronto,后面又丢了”的情况。
是非判断交给判断模型。它从一个专门训练过输出 yes 概率的 4B 模型出发,用 LoRA 在三个数据集训练集的金标注上微调:一段是金标支持段就标“相关”,前 10 段包含全部支持段就标“可以直接答”,问答表包含每一跳的答案就标“够了”(这一类只用有分步答案的 MuSiQue 和 2Wiki)。三个判断各有门槛:相关和够不够用 0.5,直接作答用更严的 0.7。直接作答门槛更严的理由论文讲得清楚:多跳题被误判为一步能答,几乎一定答错;一步能答的题被送进循环,最多多花几次调用。
相关性筛选最直接的好处是 LLM 看的段落变少了:每步检索前 10 段,平均只留下 2.1 到 2.4 段。
为什么答案可以跨问题复用?
因为子问题是自包含的,同一个子问题不管出自哪道原题,意思和答案都一样。论文的例子:“Sazerac 公司总部在哪个城市?”答案是 New Orleans,不论原题问的是这家公司旗下哪个威士忌品牌。
缓存的查法分两层。先找措辞完全相同的旧子问题,忽略大小写和标点;找不到,就取最相似的 5 个旧子问题,让判断模型逐个判断是否在问同一件事,门槛是很严的 0.8,因为错复用一个答案会把错误带进另一道题。判断为同义就直接拿旧答案,不检索也不调 LLM。
效果怎么样?
先看主结果。三个数据集各 1,000 道题,所有方法共用同一个 LLM 和同一个 embedding 模型,下表是 LLM 判分的准确率(gpt-4o-mini 作答,Qwen3.6 判分):
| 方法 | 类型 | MuSiQue | 2Wiki | HotpotQA |
|---|---|---|---|---|
| 普通 RAG | 单次检索 | 0.412 | 0.659 | 0.799 |
| HippoRAG 2 | 图检索 | 0.478 | 0.713 | 0.813 |
| IRCoT | 迭代 | 0.510 | 0.767 | 0.823 |
| Self-Ask | 迭代 | 0.500 | 0.849 | 0.783 |
| Hi-Q | 迭代 | 0.577 | 0.812 | 0.840 |
| DeFT-RAG | 迭代 | 0.629 | 0.852 | 0.874 |
提升最大的是证据链最长的 MuSiQue,比第二名 Hi-Q 高 5.2 个点,换 Qwen3.6 作 LLM 也高 5.3 个点,两者都显著。2Wiki 上它和 Self-Ask 基本持平。这说明链越长,把规划和记账从 LLM 身上拿走的好处越大。
证据覆盖的对比更能说明问题。在 MuSiQue 三跳题上,DeFT-RAG 给 LLM 送齐全部证据的比例是 46%,是所有方法里最高的,而 LLM 每道题平均只读 390 个词的段落,不到普通 RAG 870 个词的一半。Self-Ask 送齐的两跳题更多,但每题要读 2,590 个词,因为它把所有段落和推理都留在提示里。这说明它的提升不是靠塞更多段落,而是靠找得更准、留得更少。
两个消融说明各部件的作用。关掉相关性筛选、改成直接给前 5 段,三个数据集平均准确率掉 3.8 个点,HotpotQA 上掉 5.3 个点,损失主要来自直接作答的题,因为那些题要在一组段落里一次找齐证据。不微调判断模型,MuSiQue 前 300 题的准确率从 0.623 降到 0.587,微调提升最大的是“能否直接作答”这个判断。
缓存实验:1,000 道 MuSiQue 题按顺序作答、共用一个缓存,23.1% 的子问题直接从缓存拿到答案,LLM 调用少了 12.9%,准确率 0.642 对比不开缓存的 0.629,差异不显著。这说明跨问题复用中间答案没有带来可见的错误。
我认为它的局限
第一,延迟是所有方法里最高的。每道题的中位延迟 9.9 秒,普通 RAG 是 2.4 秒。论文拆过:MuSiQue 上每道题平均调 7 次判断模型,每次 1.6 到 1.8 秒,这部分占了全部作答时间的六到七成。换成一个通过 API 调用、每次约 0.16 秒的闭源判断模型,中位延迟降到 5.0 秒,准确率相差不到 1.2 个点。所以瓶颈在判断模型怎么部署,但对线上问答来说仍是硬成本。
第二,自包含规则 LLM 并不总能守住。2Wiki 上有一类题要比较两部电影导演的年龄,LLM 会写出“某部电影的导演生日是哪天”这种还没把导演名字找出来的嵌套子问题。这类子问题 38% 答不出来,单一关系的子问题只有 4%;235 道这类题里有 75 道走到步数上限或开始重复。这是它在 2Wiki 上只和 Self-Ask 打平的主要原因。
第三,判断模型要用带金标证据的训练集微调。论文用了 48,036 条训练样本,标签来自三个数据集标注好的支持段,以及 MuSiQue 和 2Wiki 的分步答案。实际业务里很少有这种支持段和分步答案标注,而论文的实验只覆盖这三个带标注的数据集,换到别的领域要重新准备判断模型的训练数据。
一个问答搜索团队可以怎么试
第一步,先在自己的数据上测固定前 k 段的问题。像论文表 1 那样,取一批单步可答的问题,比较给前 5 段、前 10 段和只给需要的段落三种情况的准确率。如果只给需要的段落明显更好,相关性筛选就值得做。
第二步,把现有迭代式检索里的记账改成规则维护的问答表,并让 LLM 每次只写一个自包含的子问题。这一步只改提示和外层控制逻辑,不用训练任何模型,可以先看多跳题准确率和 LLM 输入 token 的变化。
第三步,再上判断模型。可以先用现成的大模型做是非判断验证效果,确认有收益后再微调一个小模型降成本;要注意判断模型的调用次数和延迟,论文里它占了大部分作答时间。
第四步,如果线上问题之间重复的中间事实多,再加缓存。复用门槛要设严,并抽查复用的答案是否真是同一件事。
结论
最关键的启发:多跳问答里让 LLM 少做几件事,比给它更多段落更有用。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。三跳以上的问题,多数图检索方法连证据都找不全,迭代式方法又被 LLM 的多重任务拖累。 |
| 方法创新性 | 中。每个部件都不新,新在把 LLM 的活拆到最小,以及自包含子问题顺带让答案可以跨问题复用。 |
| 实验证据 | 较强。13 个基线、两个 LLM、三个数据集,加上证据覆盖、筛选和微调的消融;缓存只在 MuSiQue 上测过。 |
| 工程成本 | 中。不用建图,索引只要 embedding;但每题约 4.8 次 LLM 调用加多次判断模型调用,延迟最高。 |
| 是否值得尝试 | 值得,尤其是问答搜索里多跳问题占比高的场景。自包含子问题和问答表只改提示和控制逻辑,可以先做。 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…