目录 · 9 节
1为什么不干脆挑一个快 kernel 固定下来?2请求 A 在 Detent 里的路线3挑 kernel 的代码重写成一段可分析的小程序4用最小割找出要钉的几个值5先筛合法取值,再逐家族调优6比特稳住了,延迟比 Stock 高约一成7一张参数清单只适合一类流量8RL 训练端和 rollout 逐比特对齐9请求 A 的答案什么时候还会变?
要让大模型服务对同一个请求每次算出完全相同的结果,不管它和哪些请求拼在一批,并不需要放弃快 kernel(GPU 上实际执行计算的程序):Detent 把推理引擎挑 kernel 时读到的同批信息(比如这一批的总 token 数)换成几个部署前定好的常量,延迟中位数(p50)只比引擎默认配置高约一成。
vLLM、SGLang 这类推理引擎会把同时到达的请求拼成一批送上 GPU。在引擎的默认配置(论文叫 Stock)下,同一个请求换一批同伴,算出来的数值在二进制位(比特)上就可能不同,生成的文字也可能跟着变。先定一个贯穿全文的示意场景:请求 A 是一道小学应用题,上午低峰时几乎单独运行,晚高峰时和另外 31 个请求拼在一批。模型和 prompt 都没变,解码也是贪心的,A 的输出仍可能不同。论文实测过这件事:模型和题目都不变,只改同时发送的请求数量,用 Stock 配置的 SGLang 跑 Qwen3-30B-A3B 时,GSM8K 的 1,319 道题里有 33 道答案变了。
这种变化会落到三类工作上。做评测的人重跑一遍,分数对不上。第三方想自己重算一遍来核对服务商给出的输出,也对不上。做强化学习(RL)的人更麻烦:推理引擎先生成一批回答(rollout),训练端再重算其中每个 token 的对数概率(logprob)。两边比特不一致,训练用的概率就不再是生成时采样用的概率,训练的数学前提就不成立了。
同一个请求为什么会算出不同的比特?根子在浮点加法。浮点加法不满足结合律,同样几个数,先加谁会影响舍入。示意:假设只保留 3 位有效数字,算 1000 + 4 + 4。从左往右加,1000 + 4 = 1004,舍入回 1000,再加 4 还是 1000。先算 4 + 4 = 8,再算 1000 + 8 = 1008,舍入成 1010。数学上是同一个和,结果差了 10。
放到请求 A 身上,假设 attention 要对 A 的 8 块 KV 求和。上午引擎用 FlashAttention-3(FA3)把这 8 块切成 4 份(0–1、2–3、4–5、6–7),每份算完再合并。晚高峰 A 进了一个忙批,FA3 按整批信息设定切分数,这次选了 1 份,8 块依次算(论文示意)。相加顺序一变,A 的比特就可能变。切分数只是同批信息影响 A 的途径之一:MoE(混合专家)层会从调好的配置表里取最接近这一批 token 数的一行,决定矩阵怎么分块;多卡求和(all-reduce)会按这一批要发送的字节数选求和算法。
论文先讨论两类现有做法:只保证 kernel 内部不变,以及引擎自带的确定性模式。放到请求 A 上,前者没挡住变化,后者太慢。第一类是 batch-invariant kernel(Thinking Machines 等团队的做法),它让每个 kernel 内部的相加顺序不再随批变化。可是引擎仍然按同批信息(这一批的 token 数、要发送的字节数)去挑 kernel 和参数。上午挑「切 4 份」,晚上挑「切 1 份」。每条路内部的相加顺序是固定的,可两条路的顺序彼此不同,A 的结果还是可能不同。
第二类是引擎自带的确定性模式(SGLang-Det、vLLM-Det):每个算子只留一个最保守的 kernel,attention 不切分,all-reduce 统一走 NCCL tree,MoE 写死一份配置。A 这下永远走同一条路,可所有请求也都只能走这条慢路,快 kernel 和切分都用不上。在论文的测试负载上,每输出一个 token 的延迟,SGLang-Det 是 Stock 的 1.59–6.34 倍,vLLM-Det 是 2.83–10.3 倍。
为什么不干脆挑一个快 kernel 固定下来?
最直接的想法是保留 FA3 的切分和调好的 MoE 配置,只要确认这些快 kernel 彼此算出的比特一致,引擎选到哪个都行。麻烦在于两个 kernel 算出的比特是否一致,从源码上看不出来,只能实测。论文给了两个结果相反的例子,说明不测就猜不到。head dimension 64 时,FA3 的两种 tile 宽度(同一个 kernel 的内部分块参数)算出的 32 个 logprob 中有 31 个没有逐比特一致。Qwen3-30B-A3B 上,作者实测的 18 份调好的 MoE 配置,算出的比特却和 SGLang-Det 写死的那份完全相同。
实测的量也大到测不完:FA3 光在 head dimension 128、BF16 下就有 18,472 种配置,把这些配置全部测一遍,要占一台四卡节点约 4.8 天。
Detent 换了一个问题来回答。作者观察到,很多快 kernel 一旦选定、参数定好,内部的相加顺序就只看请求自己,不看同批有谁,也就是已经 batch-invariant。这样同批信息只剩一条路影响请求的比特:引擎「挑哪个 kernel、用什么参数」这一步。那就不必回答「哪些 kernel 彼此一致」,只要保证同一个请求每次挑到的都一样。放到 A 身上,Detent 不去比较「切 4 份」和「切 1 份」算出来一不一样,只保证 A 上午和晚上走同一种切法。
论文把这个思路写成一个充分条件,BI 是 batch invariance(结果不随同批请求变化)的缩写,∧ 表示「并且」,⟹ 表示「就能推出」:
kernel BI 指每个候选 kernel 在参数定好后,相加顺序只取决于请求自己,这一条由用户提供的 kernel 保证。selection BI 指挑选结果只取决于部署、模型、提前定好的参数和请求自己,这一条由 Detent 负责。两条合起来能推出端到端 BI,还有一个前提:每个请求的输出在数学上只由它自己的输入决定,比如不能有让同批请求互相看到的计算。
请求 A 在 Detent 里的路线
后面一直要用两个名字。pin 是选择程序里被 Detent 换成常量的值,比如 FA3 的 split 数。参数清单(论文叫 commitment tuple)给每个 pin 定一个合法值,再给每个部署开关定一个设置。部署开关是不读同批信息、但会影响用哪个 kernel 的配置项,例子是 all-reduce 用 push 还是 pull、矩阵乘法(GEMM)加不加 padding。清单在部署前定好,服务期间不改。
Detent 的工作分成部署前和服务时两段:
| 步骤 | 输入 | 操作 | 产出 | 什么时候跑 |
|---|---|---|---|---|
| 写选择逻辑 | 引擎原来挑 kernel 的代码 | 用 SelIR 重写 | 可执行的选择程序 | 每个 kernel 调用点写一次 |
| 化简 | 选择程序、部署已知的量 | 代入已知量并化简 | 一张依赖图 | 每个部署和引擎版本一次 |
| 找 pin | 依赖图 | 求切断同批信息的最少几个值 | pin 列表 | 每个部署和引擎版本一次 |
| 筛合法值 | pin 的候选值 | 代入程序运行,检查前提条件 | 每个 pin 的合法取值 | 每个部署和引擎版本一次 |
| 调优 | 合法取值、和线上相似的录制负载 | tuner 按 kernel 家族(见下文)逐个实测 | 一张参数清单 | 每种负载一次 |
| 服务 | 请求、参数清单 | 选择程序带着常量运行 | 固定的 kernel 选择 | 每次 kernel 调用 |
晚高峰时 A 和 31 个请求进了同一批。走到 FA3 的调用点,引擎运行选择程序,程序原本要按这一批的总 KV 长度算出 split 数,现在 split 数这个选择点直接取清单里的常量,不再随总 KV 长度变化。示意:A 的 8 块 KV 还是切成 0–1、2–3、4–5、6–7,每份内部按固定顺序相加。这里用的 FA3 是作者重建的版本,保留 KV 切分,但按固定步长(split stride)切,一个请求的切分边界只取决于它自己的 KV 长度,不随同批情况变化。MoE 和 all-reduce 的调用点也一样,all-reduce 的每个元素按固定的 GPU 顺序求和。A 的比特这时只取决于部署、模型、清单和 A 自己。
挑 kernel 的代码重写成一段可分析的小程序
Detent 要在选择逻辑里找到同批信息流经的位置,还要保证这些位置在线上真的被换成了常量。所以每个 kernel 调用点直接运行一段 SelIR 程序,代替引擎原来的选择代码。solver(求解 pin 的组件)分析的就是引擎运行的这一份程序,solver 在程序里钉住一个值,运行中的引擎读到的也就是这个常量。如果另外抄一份逻辑来分析,线上跑的还是引擎原来的代码,钉住的值管不到线上。
SelIR 是 Python 的一个子集,程序都是纯函数。用户把读到同批信息的输入标成 Runtime,程序返回的值叫选择点,比如 split 数或用哪一版 kernel。require 和 assume 写明这次选择在什么条件下有效,比如某个 kernel 只支持特定的 head dimension;条件不成立,这次选择就不合法。下面是一段示意,语法和数字都是简化的:
# 示意:FA3 选择逻辑的简化写法
def select_fa3(head_dim, total_kv: Runtime, stride: knob):
    require(head_dim in (64, 128, 256))
    splits = 4 if total_kv < 4096 else 1   # 这里读到了同批信息
    return splits, stride                  # 返回值就是选择点
用户只标输入,不用指定哪个值是 pin,这件事交给 solver。上午总 KV 小,splits 是 4;晚上总 KV 大,splits 是 1。开头 A 上午切 4 份、晚上切 1 份的问题,在这段程序里就是读 total_kv 的这一行。
大部分输入在部署前就知道,比如 head dimension、数据类型、GPU 架构和并行度。Detent 先把这些量代入化简,再把程序转成一张依赖图:图上每个节点是程序里的一个值,边表示一个值是由哪些值算出来的,这样就能看出同批信息流到了哪里,条件分支造成的依赖也算在内。示意:程序里有一个 if head_dim == 64 的分支,这个部署的 head dimension 是 128,这条分支和它读到的同批信息一起消失。
这一步省下的 pin 数很实在。只做常量折叠(把能直接算出的表达式替换成结果)时,FA3 要钉 12 个值,完整化简后只要 3 个。每多一个 pin,后面的搜索空间就要乘上它的候选数。化简结果会存进缓存,FA3 命中缓存约 20 ms,冷求解约 5 s,化简只在部署时做一次,服务时新来一批请求不会触发重新化简。
用最小割找出要钉的几个值
目标是让同批信息走不到任何一个选择点。最简单的做法是把所有读到同批信息的选择点全钉住,这样一定挡得住,代价是 pin 太多。
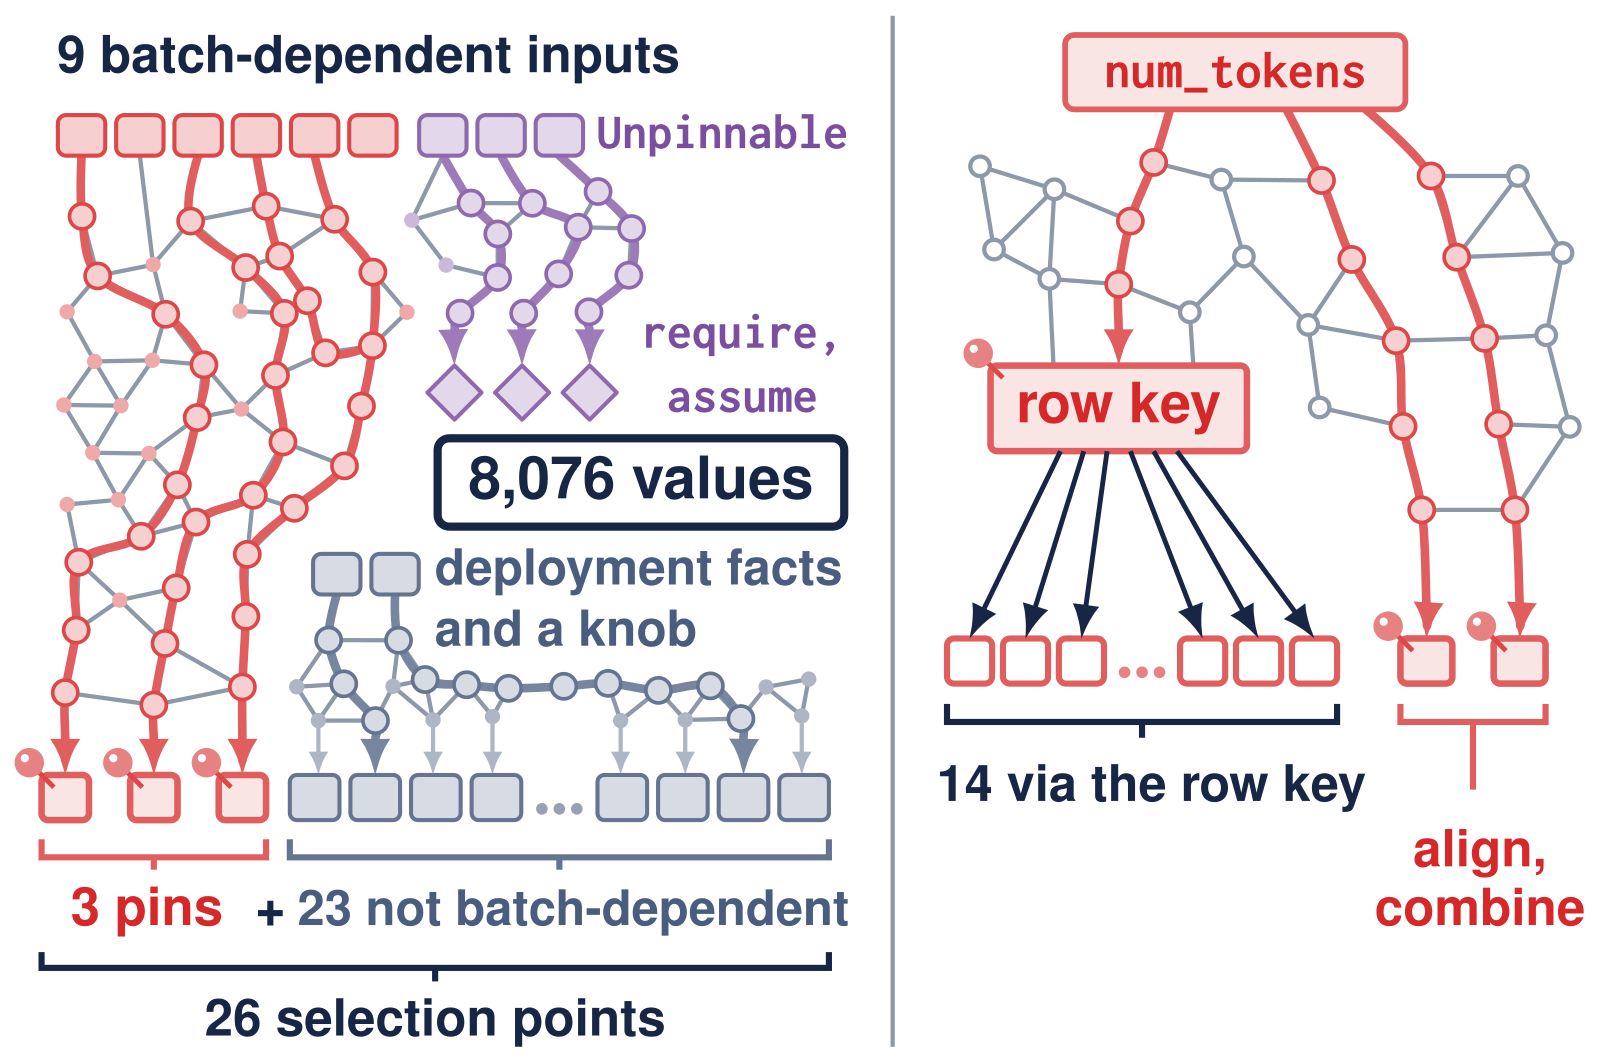
示意:一张 MoE 依赖图上,批的 token 数先决定用配置表的哪一行(这个值叫 row key),row key 再决定 4 个选择点,每个值都有 5 种候选。全钉选择点,tuner(挑清单的组件)要搜 5×5×5×5 = 625 种组合。只钉 row key,一个值就同时切断 4 条路径,只要搜 5 种。
solver 把这件事写成图上的最小割:找一组值,让每条从同批输入到选择点的路径都至少经过其中一个。它用最大流算法求这个最小割,权重设成优先选 pin 少的方案,pin 数相同时优先选靠近选择点的位置。Llama-3.1-70B 上 FA3 的依赖图有 8,076 个值、26 个选择点,其中只有 3 个和同批信息有关,割就落在这 3 个选择点上。Qwen3-30B-A3B 的 MoE 不一样,割落在程序内部的 row key 上,这一个 pin 固定了 16 个批相关选择点中的 14 个。
最终 Llama-3.1-70B 的 attention、all-reduce、MoE 分别钉 3、3、0 个值(Llama-3.1-70B 没有 MoE 层),Qwen3-30B-A3B 分别钉 3、3、3 个,vLLM 和 SGLang 得到的 pin 相同。Qwen3-30B-A3B 的 MoE 如果不求最小割,把批相关选择点读取的值全部钉住,要钉 10 个,而不是 3 个。FA3 如果不做分析,候选组合有 2^27 种。这说明最小割的作用是把后面的调优压缩到能跑完的规模,同时 pin 落在哪里由图的结构决定,FA3 和 MoE 的位置并不一样。
先筛合法取值,再逐家族调优
候选值不能随便填。Detent 把一组候选值代入程序真跑一遍,检查所有 require 和 assume 是否成立,程序可能遇到的输入(比如上下文长度)范围小时检查全部取值,范围大时检查一组固定的抽样取值。Qwen3-30B-A3B 上,FA3 的 7,168 组候选筛完剩 2,976 组。
服务时选择程序还会检查新输入。示意:清单里的某个取值要求上下文不超过 32k token,线上来了一条超长请求,引擎报错停止,不悄悄换成清单以外的 kernel。
合法之后还要快,而最快的清单取决于负载的 prefix 命中率、并发和 prompt 长度。tuner 面对的组合数很吓人。这里要引入 kernel 家族:一段 SelIR 程序从中挑选的那一组 kernel,比如所有 FA3 配置算一族。Qwen3-30B-A3B 上,FA3、MoE、all-reduce、GEMM 四个家族的合法取值分别是 2,976、36、3、5 种,联合搜索要试 1,607,040 组。
tuner 的办法是假设各家族的耗时能直接相加。示意:两个家族各有 10 种取值,联合要试 100 组。如果总时间等于两家族各自的时间之和,每族单独挑最快的就是整体最快,只要试 20 组。
这个假设成立要靠三个条件:不同家族的 kernel 前后运行、互不重叠;录下来的负载固定了拼批和输出,清单只改变每族选哪个 kernel;一次调用的耗时只取决于这次调用和本家族的取值。如果引擎把两个家族融合着跑,用户必须把它们声明成一个家族。
有了可加性,Qwen3-30B-A3B 上只需搜 2,976 + 36 + 3 + 5 = 3,020 组,实际测了 76 组。作者在 Qwen3-30B-A3B 上实测,家族之间最大的相互影响是每输出 token 总 GPU 时间的 1.04%;由这个上限可以推出,逐家族挑出的清单离真正最优的清单不超过 2.1%。Llama-3.1-70B 的穷举结果上,tuner 只测 8.0% 的候选,平均离最优 0.04%,最差 0.75%。这说明逐家族搜索省掉了绝大部分测量,离最优几乎没有损失。
tuner 的产出就是请求 A 上午和晚上读到的那张清单:
# 示意:一种负载的参数清单,只列文中出现过的字段,取值是编的
FA3:        split 数 = 4,split stride = 2 块
MoE:        row key = 4096
all-reduce: workspace = pull
GEMM:       padding = 开
比特稳住了,延迟比 Stock 高约一成
先看比特有没有真的稳住。论文用 26 个测试格检查,每格在 temperature 0 下让请求先跑一个参考批,再跑同一批或换过的批,比较两次前 16 个输出 token 的 logprob 是否逐比特相同。「换过的批」的换法包括换掉 A 的同伴、把 A 挪到批里另一行、改变 A 的 prefix 命中长度。比 logprob 而不比 token,是因为模型的打分变了一点,选出的 token 不一定变,只比 token 会漏掉这种变化。
Detent 和两个确定性模式在这 26 格上全部通过,Detent 在另外 9 个更严格的测试格上也通过了。Stock 在 SGLang 的 26 格里失败 9 格(Llama-3.1-70B)和 5 格(Qwen3-30B-A3B),在 vLLM 适用的 24 格和 23 格里失败 19 格和 2 格(其余几格在 vLLM 上不适用:vLLM 的 cache 页是 16 个 token,测试用的短 prompt 在这几格里命中不了 prefix)。这说明这套测试确实抓得到 Stock 的不一致,Detent 的保证在两个引擎上都成立。
延迟的比较在四张 H100 上进行,负载包括 ShareGPT 多轮对话和 arXiv 约 8k token 的长文档,每种负载按每秒发送的请求数分几档压力,指标是每输出一个 token 的延迟中位数 p50。下表是各档比值的几何平均,Detent 在每档负载上用为这一档调优的清单:
| 引擎 | Detent / Stock(Llama-3.1-70B) | Detent / Stock(Qwen3-30B-A3B) | 确定性模式 / Detent(两个模型的范围) |
|---|---|---|---|
| SGLang | 1.10 倍 | 1.11 倍 | 2.4–2.6 倍 |
| vLLM | 1.08 倍 | 1.11 倍 | 3.4–5.7 倍 |
这说明保留快 kernel 能省回确定性模式的大部分代价:比特同样稳定,Detent 比确定性模式快 2.4–5.7 倍,比 Stock 慢一成左右。分到单个负载上,Detent 的 p50 是 Stock 的 1.01–1.22 倍,p99 的几何平均是 1.12–1.22 倍。
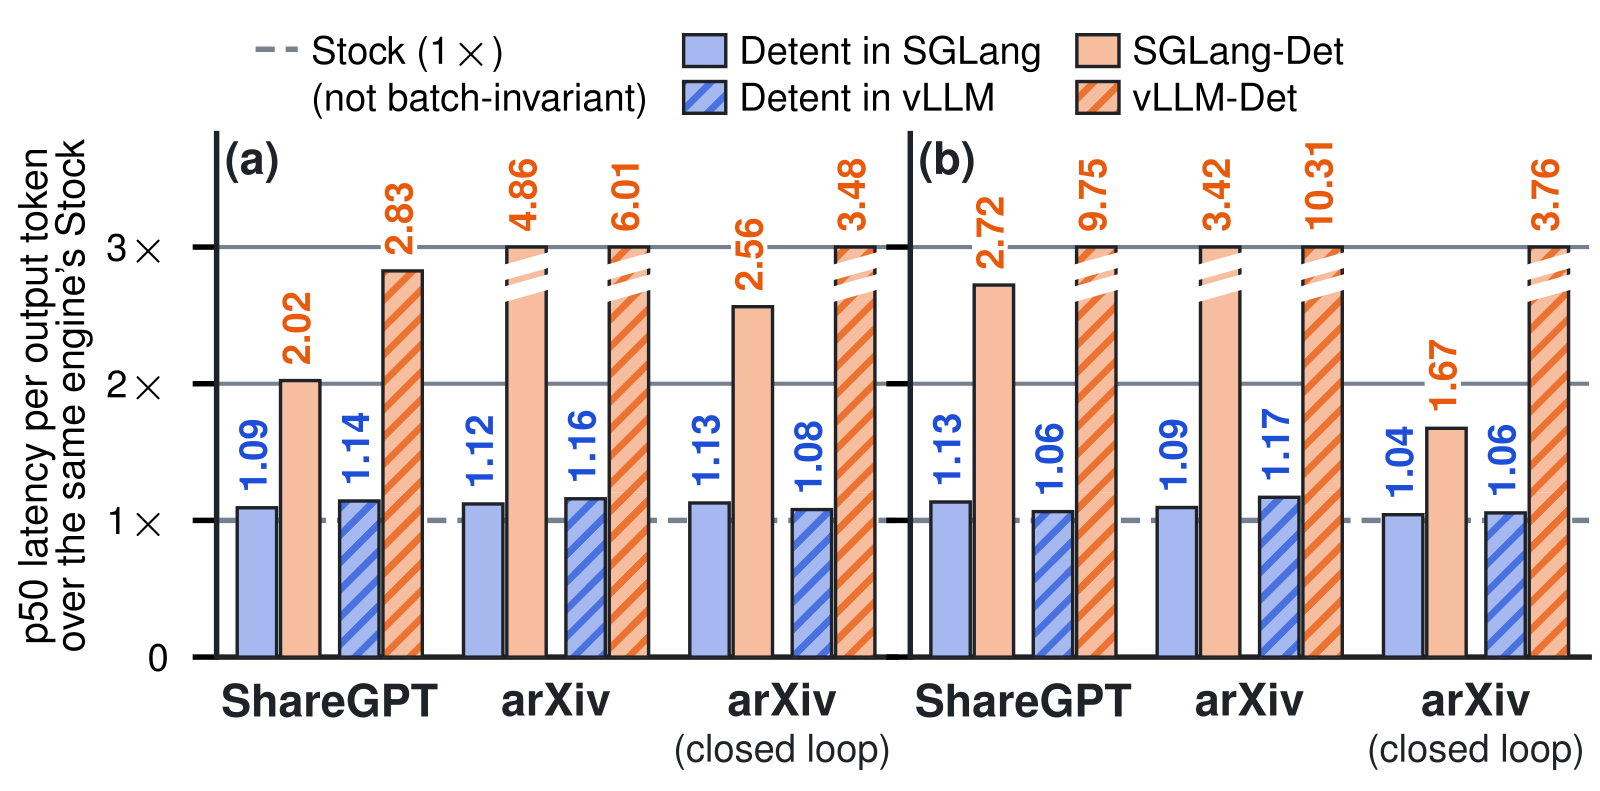
确定性模式的差距有一部分来自排队。压力档的上限按 Stock 能承受的最大吞吐设定,确定性模式处理得慢,跟不上时请求在队列里越积越多,单个负载上 p50 到 Detent 的 6.1 倍和 9.2 倍的情况都来自这种运行。把每种方法放到它自己最大吞吐的 0.67–1.0 倍,队列不再增长,vLLM-Det(Llama-3.1-70B 的 ShareGPT)和 SGLang-Det(Qwen3-30B-A3B 的 arXiv)仍是 Detent 的 2.0–2.3 倍。这说明排队放大了差距,但差距本身在没有排队时依然存在。
延迟能压到只高一成,tuner 起了多大作用?不调优的默认清单让每个 pin 取「不钉住时,程序在这批负载上最常选到的那个合法值」。默认清单在 SGLang 里比调优后最多慢 103%(Llama-3.1-70B),在 Qwen3-30B-A3B 上慢 1–233%。两张清单可选的 kernel 是同一批,所以单靠调优就解释了 SGLang-Det 差距中的 1.34 倍(Llama-3.1-70B)和 1.67 倍(Qwen3-30B-A3B)。
钉住只决定比特稳不稳,钉成什么值才决定快不快。
Detent 接近 Stock,也不是因为换上了更快的 kernel。论文把 Detent 选的 GEMM 和 all-reduce kernel 换进 Stock,如果 Detent 是靠更快的 kernel 才追上,Stock 应该变快,结果每输出 token 的 GPU 时间反而增加 0.6%(Qwen3-30B-A3B)和 2.8%(Llama-3.1-70B)。剩下的差距,作者指出两个来源:重建的 FA3 每次调用多 3 µs,而且最佳 split stride 和 Stock 的切分相比,差距在 1.06 倍以内;一张清单要同时服务长 prefill 和小 decode 批,Stock 则可以每批换选择。
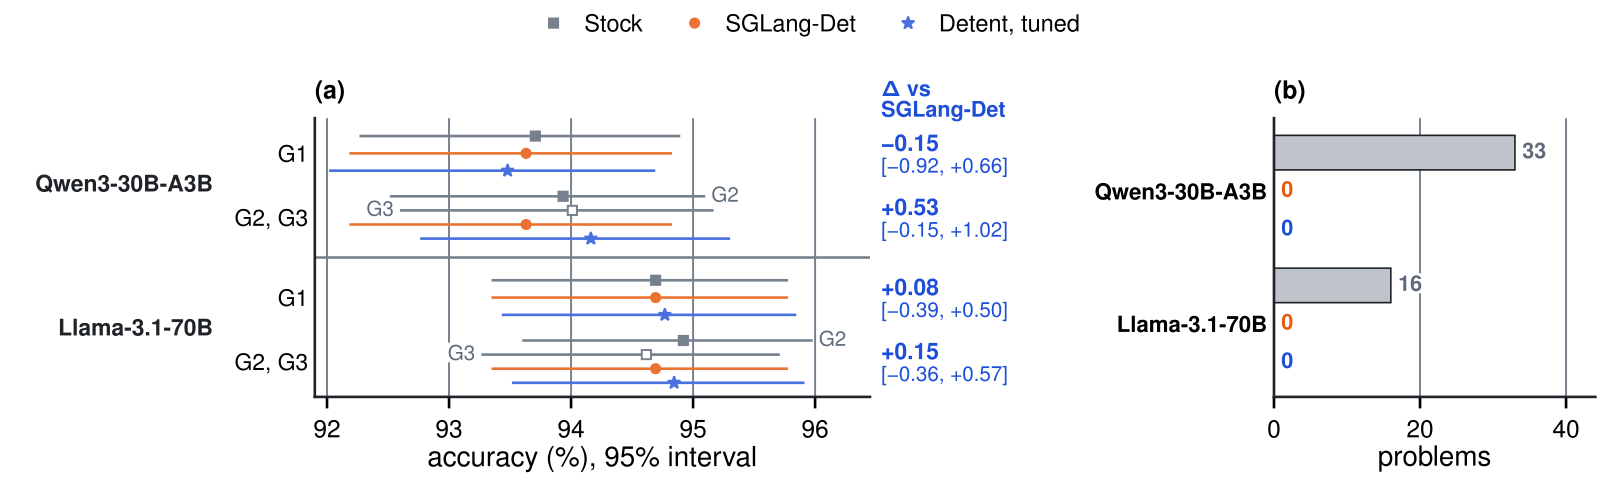
接下来检查答案。Detent 和 SGLang-Det 都保证结果不随同批变化,但跑的 kernel 不同,两者的输出比特可以不同,所以还要看 Detent 的准确率有没有掉。论文在 SGLang 里用三档负载跑 GSM8K 的 1,319 道题:并发 8、并发 64、全部题一次发出,解码是贪心的。Detent 的准确率减去 SGLang-Det,差值在 −0.15 到 +0.53 个百分点之间,McNemar 检验 p ≥ 0.14。这说明在这组题上,两者的准确率分不出高低。
三档负载之间,Stock 的文本在 790 道(Qwen3-30B-A3B)和 484 道(Llama-3.1-70B)题上变了,答案在 33 道和 16 道题上变了。SGLang-Det 的文本从来不变。Detent 在并发 64 和全部发出这两档用了不同清单,这两张清单在 KV 切分上恰好一致,所以文本完全相同。并发 8 那一档的清单会切分 KV,相加顺序不同,文本可以和另外两档不同。所以只看负载这一项,会让答案变化的只有 Stock。
这组结果给 A 的稳定性加了前提:A 的答案跟着清单走,不跟着负载走。
另一条路线不固定 kernel,事后校验。LLM-42 先用快 kernel 解码,再按固定的相加顺序把这段计算重放一遍来校验,结果不一致就回滚重算;它还可以只对一部分请求做这种校验,只让这部分请求的结果确定。作者把 LLM-42 移植到自己的 SGLang 基线上,用单卡 Llama-3.1-8B 和 ShareGPT 比较。Detent 让所有请求确定,中位端到端延迟比 Stock 高 3.5–5.1%。LLM-42 只让 2% 的请求确定时,中位延迟仍是 Detent 的 1.15–1.20 倍。
离线跑 arXiv 长文档时情况相反:确定比例在 20% 以下,LLM-42 的吞吐比 Detent 高 0.4–2.6%。这说明只需要少量请求确定、又是离线长文档时,校验回滚仍有优势。这组数来自作者自己移植的 LLM-42:作者事先登记的离线校验没有通过,差了 44%,看到数据后作者修改了校验方式。
一张参数清单只适合一类流量
Stock 每一批都能换选择,参数清单不能。作者的折中是按负载类型定清单。每类负载(ShareGPT、arXiv 长文档、arXiv 闭环发送)的所有压力档共用一张清单时,在自己的负载上距离逐档调优只差 2.7%(Qwen3-30B-A3B)和 1.1%(Llama-3.1-70B)。
拿错清单代价就大了。Qwen3-30B-A3B 上,用 ShareGPT 的清单跑 arXiv 长文档的一档压力,延迟是逐档调优的 4.17 倍,首 token 中位时间从 238 ms 涨到 4.75 s。同一格在 Llama-3.1-70B 上是 1.15 倍。这说明流量类型一变,清单不跟着换,延迟就会落到这种格子里。重新调优后切换清单时,还要保证同一批里的请求不会一部分用旧清单、一部分用新清单,否则同批情况又会影响结果。
RL 训练端和 rollout 逐比特对齐
RL 对比特一致的要求比评测更苛刻。生成 rollout 时,引擎先 prefill 再 decode,训练端重算时则一次 prefill 全部 token。示意:A 作为一条 rollout,prompt 100 token,生成 50 token。生成时先 prefill 100 个 prompt token,再逐个 decode 50 个生成 token;训练时 150 个 token 一次 prefill。key 的分组不同,logprob 的比特就可能不同。
Detent 的训练端直接运行服务端的 kernel 和同一张清单,这样训练端和 rollout 之间只剩同批情况不同,而这一项已经被清单挡住了。采样的随机性靠带随机种子的温度采样固定:种子和 prompt 一样是每条请求自己的输入,不取决于同批有谁。在 RL 这条路径上,Detent 只接受这一种采样方式,其他采样方式一律拒绝。 Hoot 说

- kernel 和 tuple 定住计算路径。pin 挡住了批到选择点的每条路径,kernel 自身的不变性由用户提供。
- 参数 M 是这次比较的前提。训练端每一步用当时的参数重算,比特相同才有意义;参数一变,logprob 本来就该变,那不是批造成的差异。
- 种子 s 这里只记论文的结论和实测。论文说只接受带种子的采样也定住了采样出的 token;512 条种子 rollout 在换批、换 cache 切分下逐比特重放。
- 只接受带种子的温度采样,是 RL 这边单独加的补丁。服务实验用的是贪心解码。
- 读 Stock 这一行要留意:它的训练端用 transformers,所以它和 rollout 的差别不只是批。
用论文的式子看,一次请求的输出是 y=F(x,s;M,D,T;B):x 是 prompt,s 是种子,M 是模型代码和权重,D 是部署,T 是 tuple,B 是批状态。图里两条路径只有 B 不同。
出处
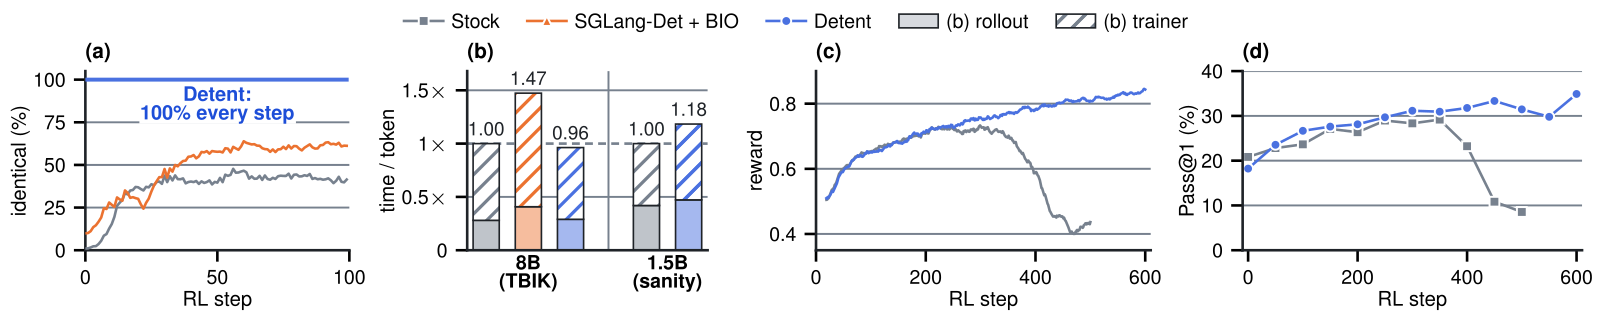
论文 §3(式 2、selection batch invariance、训练端与服务端只差批的论证);§7(RL 的采样补丁);§8.1(服务实验用贪心解码);§8.6(种子 rollout、训练端比特一致、Stock 用 transformers 训练)先看训练端和 rollout 对不对得上。作者沿用 TBIK(一种固定相加树的 kernel 方案)的测试流程,在 Llama-3.1-8B 上跑 GSM8K,训练 100 步。Detent 每一步每个 token 都比特一致,KL 为 0。Stock 在不同步数上只有 1.0–47.7% 的 token 比特一致。SGLang-Det 搭配使用 batch-invariant 算子的 transformers 训练端,也只有 9.9–63.9%。我的理解是,这组数字说明两边各自 batch-invariant 不保证彼此一致;Detent 靠两边用同一组 kernel 和同一张清单做到一致。
时间上,Detent 的 rollout 每生成 token 是 Stock 的 1.03 倍,整步在 4% 以内;SGLang-Det 加 transformers 训练端的组合是 1.47 倍。
再看对齐会不会影响训练结果。作者跑了 Qi et al. 的 BF16 GRPO 配方,模型是 DeepSeek-R1-Distill-Qwen-1.5B,一张卡服务、一张卡训练。Stock 的奖励从第 299 步的 0.733 跌到第 500 步的 0.436,AIME 2024 的 Pass@1 从 29.2% 跌到 8.5%。Detent 的 KL 到第 600 步都保持 0,奖励升到 0.843,每 token 时间是 Stock 的 1.18 倍,主要花在训练上。这说明在这份 BF16 配方上,比特对齐的 run 稳住了,Stock 的 run 崩了。
同一批里混着不同采样方式的请求时,差别更明显。在另一组设置里,作者用 Detent 在 Qwen3-30B-A3B、Llama-3.1-70B 和 Llama-3.1-8B 上各跑 512 条温度为 1 的 GSM8K rollout,换同批请求、换 KV cache 的切分后重新生成,全部逐比特相同,训练端重算的打分也和生成时一致。输出 1,024 token 时,吞吐是 Stock 的 0.84–0.92 倍。SGLang-Det 生成带种子的 rollout 时,只要同批里混进一个贪心或 top-p 请求,20 个测试格的输出全部变化。这说明确定性模式没有把混合采样的情况挡住。
请求 A 的答案什么时候还会变?
Detent 的保证只在同一部署、同一模型、同一张清单内成立。A 换一张清单,答案就可能不同,前面并发 8 的例子已经出现过。换多卡并行度(比如从 4 卡改成 8 卡)也不行,因为求和的分组变了;跨并行度一致还需要 TBIK 那样专门设计的 kernel。
两件事还要用户自己做。kernel 本身的 batch invariance 由用户提供的 kernel 保证,Detent 只管挑选这一步。接入新 kernel 或新引擎时,选择逻辑要由用户手写成 SelIR。
部署变化时的成本可以估出来:FA3 的 7,168 组候选判定在 32 核上要 130–180 秒,每个负载调优在每族 5 分钟预算下要 605–1,148 秒(Qwen3-30B-A3B)。论文另外只拿部署规格(模型结构、并行度、数据类型)求解了 8 个新部署,覆盖并行度 1 到 8、head dimension 64 到 256,以及 Phi-3.5-mini 和 gemma-7b-it,测试结果全部 batch-invariant。调优后,ShareGPT 负载上延迟是 Stock 的 0.97–1.09 倍,闭环负载上是 1.01–1.13 倍。这说明求解和调优的流程不依赖前面两个主力模型,换部署时重跑一遍就行。
最后再看请求 A:它上午和晚上拿到同一串比特,靠的是部署前把 total_kv 能影响到的选择点(比如 split 数)换成清单里的常量,A 不用因此走最慢的路。代价变成了两件事:部署前多跑一次求解和调优,流量类型变了要换一张清单。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…