
让模型查论文时直接看页面截图,而不是先把 PDF 转成文字再搜,问答准确率会更高,检索次数还更少。DR Pixel 把 9.9 万篇论文渲染成约 106 万张页面图,每张图编码成一个向量。智能体用文字发起搜索,拿回的是最相关的 3 张页面图。它在整个推理过程中一直看着这些原图,表格和曲线都不会因为转文字而走样。不做任何训练,只是换成看页面,GPT-5.4、Gemini-3.5-Flash 和 Qwen3.6-27B 的准确率都比“把 PDF 转成文字、再另加一个搜图工具”的方式高 5 个点以上,检索调用少 20% 到 30%。
论文的第二个贡献是一种训练开源模型的办法,叫反事实贡献加权。训练数据是更强的 GPT-5.4 留下的搜索和推理记录,也就是教师轨迹。训练前,用训练题的标准答案给轨迹里每一步打分,看它让标准答案的概率涨了多少;微调时不学没用的步骤,其余按得分加权。用这种办法训出的 Qwen3.6-27B 准确率从 40.1 提到 52.1,和 GPT-5.4 的 51.9 持平,而且找到正确页面的比例更高。论文还发布了 DRPixelBench,500 道题,每道题都对应一张标准页面。做文档检索、多模态 RAG 或搜索智能体的人值得读这篇。
它到底在解决什么问题
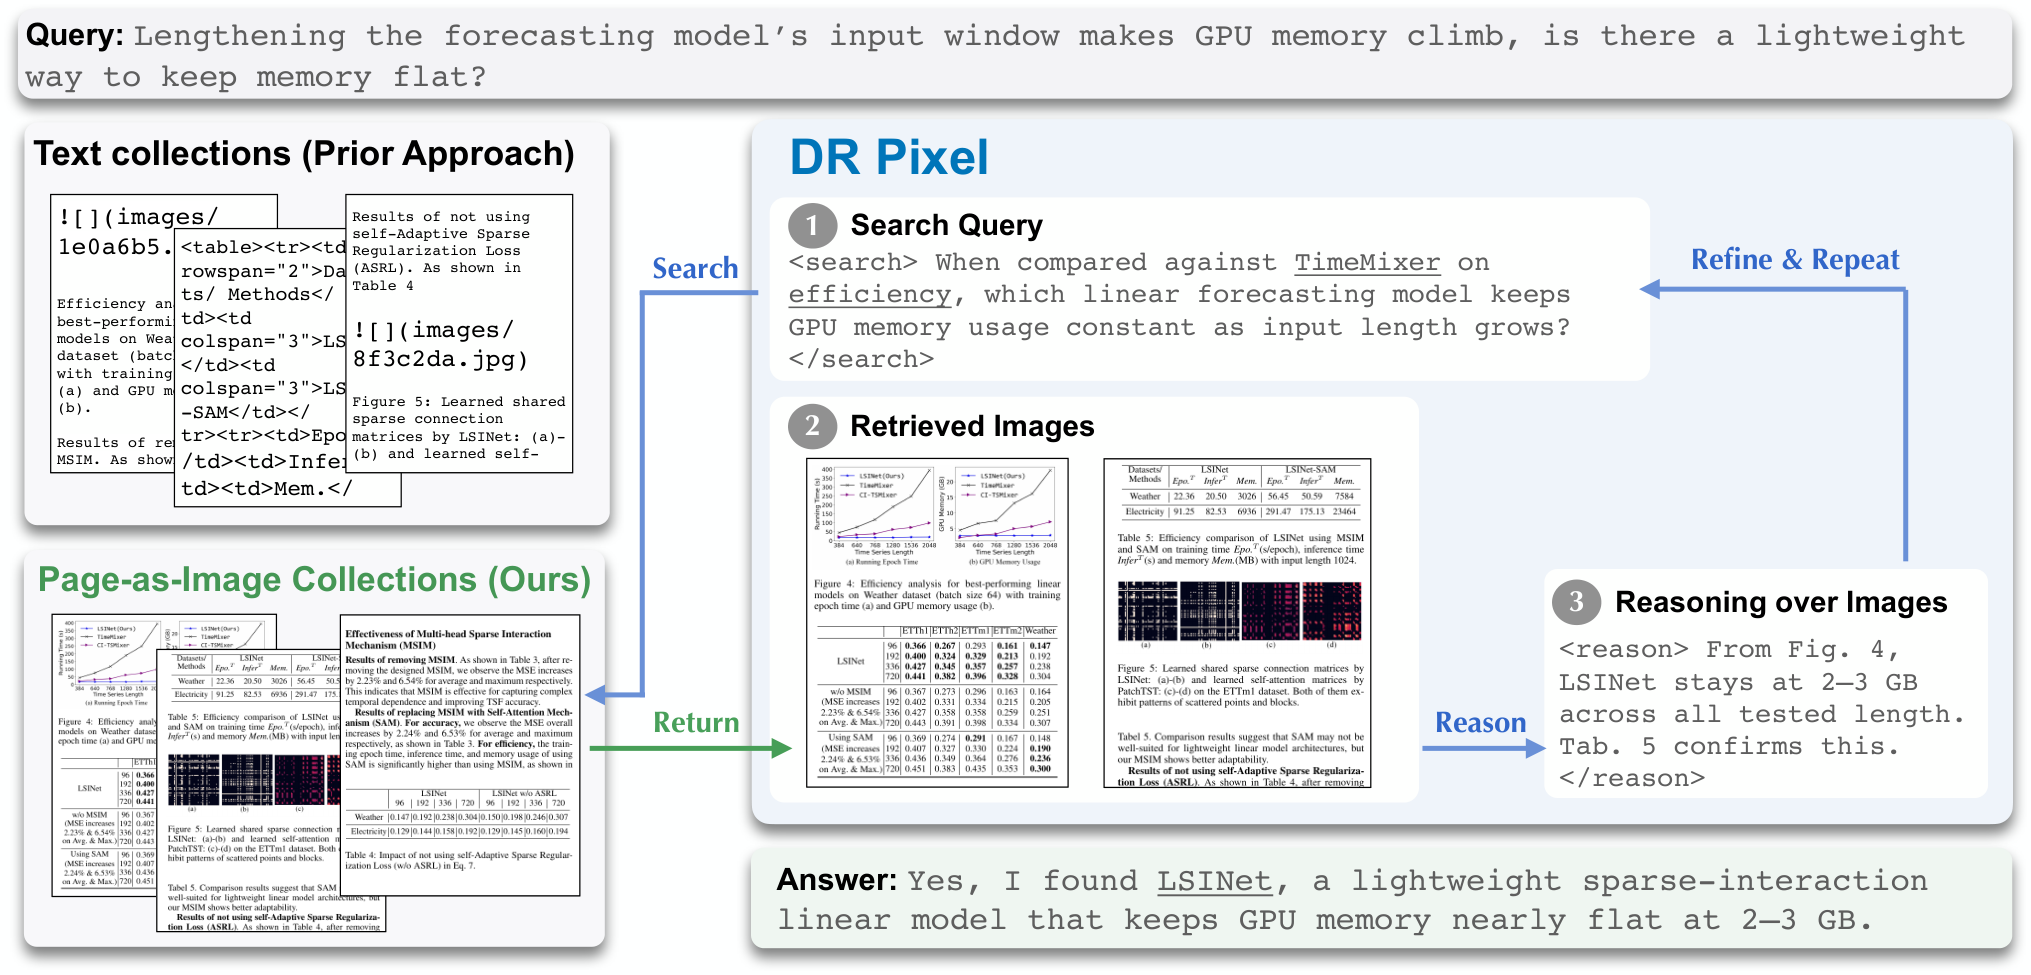
常见的“深度研究”智能体会多轮搜索,再根据搜到的内容回答问题。语料是论文时,通常的做法是先把 PDF 转成纯文字,切成小段,再做文字检索。
转文字会丢东西。表格的行列关系会被打乱,曲线图里的数值完全读不到,公式也常常变形。有些系统另加一个“搜图”工具,但智能体很少主动去用它。论文的实验里,加上搜图工具,准确率只比纯文字高 1 到 3 个点。
DR Pixel 的想法很直接:既然原页面里什么都有,就别转了,让会看图的模型直接读页面。
系统怎么搭
离线时,每篇论文按页渲染成图片。每张页面图用 Qwen3-VL-Embedding-8B 编码成一个固定长度的向量,存进索引。
推理时,智能体按“想一步、搜一次、看结果”的方式循环。它写出一条文字查询,检索器把查询编码到同一个向量空间,返回最相似的 3 张页面图。智能体是一个视觉语言模型,直接读这些图,再决定下一步搜什么,或者给出答案。一道题最多搜 20 次。
为了公平,文字检索那边每次返回 5 段、每段 256 个词。3 张页面转成文字约 1,359 个词,5 段文字约 1,257 个词,两边每次拿到的文字量相当。
不训练,只换成看页面
在论文自建的 DRPixelBench 上,三种模型的结果如下。
| 模型 | 纯文字检索 | 文字加配图 | DR Pixel | DR Pixel 平均检索次数 |
|---|---|---|---|---|
| GPT-5.4 | 43.5 | 46.3 | 51.9 | 9.2 |
| Gemini-3.5-Flash | 40.0 | 41.3 | 46.4 | 13.7 |
| Qwen3.6-27B | 33.2 | 34.9 | 40.1 | 8.8 |
按证据来源细分,GPT-5.4 在需要表格和图的题上提升最大。只靠正文或公式的题,DR Pixel 和两种转文字的方式持平。
开源模型落后不少。同样用 DR Pixel,Qwen3.6-27B 比 GPT-5.4 低 11.8 个点。论文把差距拆成两部分。一是找得少:它搜到正确页面的比例低 9.4 个点,5.3% 的查询和之前的重复。二是用不好:正确页面在最近一次搜索里时,它只落后 5.1 个点;正确页面是更早搜到的,差距扩大到 12.3 个点。这正是下面的训练方法要解决的问题。
训练:只学有用的步骤
训练数据来自 GPT-5.4 在训练题上跑出的轨迹。每道题跑 6 次,只保留最终答对的,每题最多留最短的 3 条,共约 2,500 条。训练用的论文和评测用的论文不重叠。最简单的做法是直接拿全部轨迹做监督微调,每一步同等对待。问题是教师的轨迹里也有无用的搜索,学生会连这些一起学。
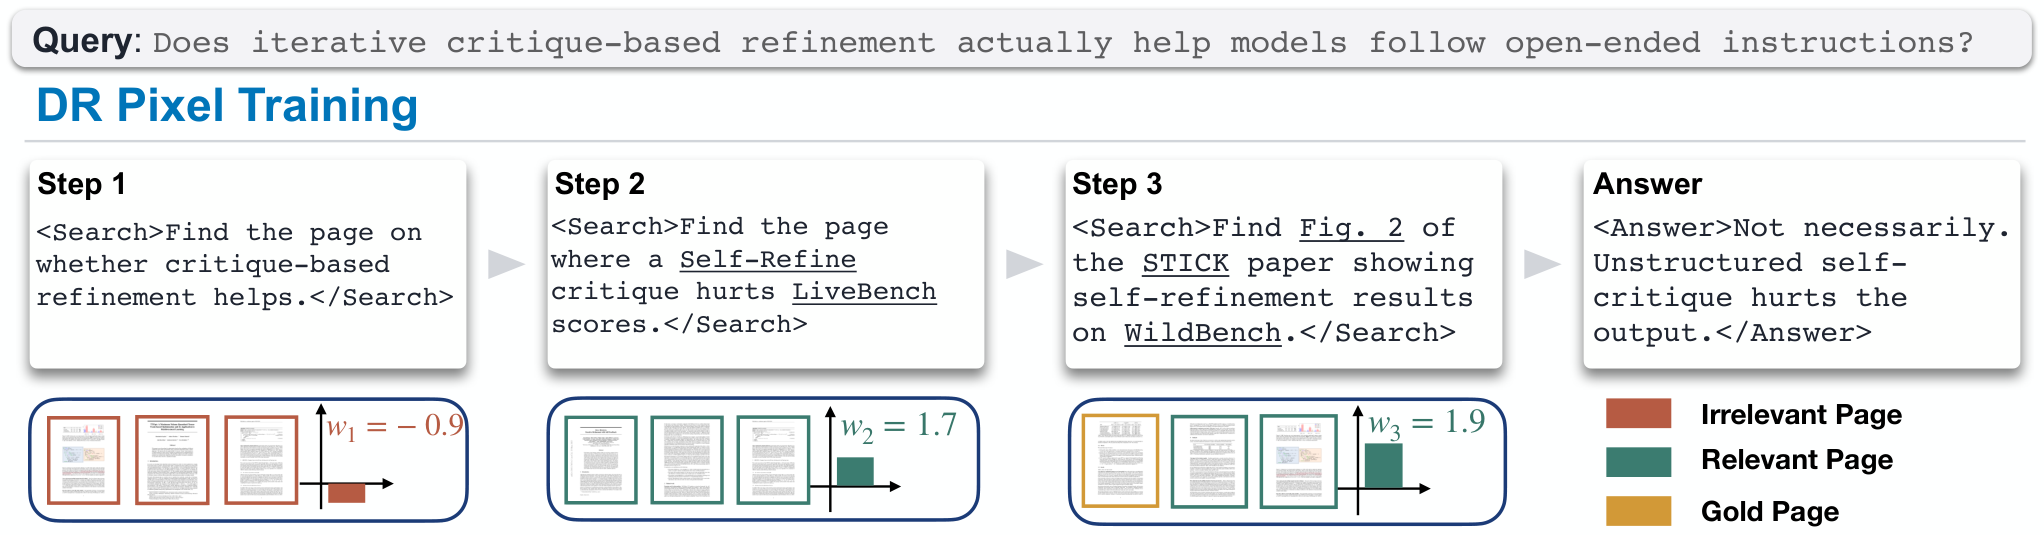
论文的办法是给每一步打一个“贡献分”。这一切只在训练前离线完成。打分要用到训练题的标准答案,推理时没有标准答案,这一步也不会运行。打分用的模型是冻结的未训练 Qwen3.6-27B。
具体分三步。
第一步,定义一个打分函数:给定截至某一步的轨迹,冻结的基础模型生成标准答案的对数概率有多高。
第二步,分别给两类步骤算贡献。对一次搜索,比较两段上下文下标准答案的得分:一段截到上一次搜索返回的页面为止,另一段再接上这一步的思考、查询和返回的页面。后一段比前一段高出多少,就是这次搜索的贡献。对一段思考,打分的上下文是整条轨迹,截到最后一次搜索返回的页面为止,不含教师最后的思考和它给出的答案;标准答案只作为被打分的目标接在后面。拿这段上下文和只删掉这一段思考的版本比,看标准答案的得分降了多少;其余思考、查询和搜索结果都保持原样。 Hoot 说

左右滑动或点箭头看三步。打分全部在训练前离线完成,用冻结的基础模型计算标准答案的对数概率;推理时不运行,也没有标准答案。数字都是示意。 出处: 示意例子,对应论文 §3 的贡献分(Figure 3)
第三步,把贡献变成训练权重。贡献不大于 0 的步骤,权重先设为 0。贡献为正的步骤,在全部训练数据的同类步骤里按贡献从小到大排名,名次比例记为 k/n,权重取它的 2 倍,所以平均约为 1。最终答案固定用 1.5 的权重。权重乘在这一步自己输出的 token 的训练损失上,思考乘在思考文字上,搜索乘在发出的查询上。权重为 0 的步骤只是不计损失,仍留在上下文里。
思考和搜索还会互相校正。一段思考要同时满足两条才保留。第一条,它引出的那次搜索没被屏蔽。第二条,前面的轨迹保持不变,只把这段思考换成空白,它后面那条查询的对数概率会下降,而且降幅不低于所有思考步骤的中位数。满足这两条、但贡献分不大于 0 的思考,权重改为正权重思考步骤的中位数。最终约 62.6% 的思考步骤和 24.5% 的搜索步骤被屏蔽。
训练后的结果
| 模型 | 每题检索次数 | 找到正确页面 | 找到后答对 | 准确率 |
|---|---|---|---|---|
| Qwen3.6-27B 原始 | 8.8 | 36.3 | 63.9 | 40.1 |
| 普通微调 | 14.0 | 53.6 | 67.2 | 49.0 |
| 按贡献加权微调 | 8.9 | 52.0 | 67.7 | 52.1 |
| GPT-5.4 | 9.2 | 45.7 | 71.2 | 51.9 |
普通微调也能提升准确率,但检索次数比加权微调多 57%(14.0 对 8.9)。它在 35.8% 的题上用满了 20 次搜索,加权微调只有 9.8%。这说明给步骤加权,主要省掉的是多余的搜索。
加权微调后的模型找到正确页面的比例比 GPT-5.4 高 6.3 个点,找到后答对的比例仍然低一些。所以准确率的提升主要来自“更会找”。
表里“找到正确页面”是轨迹中检索到标准页面的题目比例,“找到后答对”是这些题里答对的比例。两项都是跑完后对照标注统计的,智能体自己并不知道哪张是标准页面。
训练只用了论文语料,但在另外三个论文问答基准 IRPAPERS、M3SciQA、AirQA 上也提升了 9.6 到 14.4 个点。在 ViDoRe-V3 上,训练后的模型无论用页面检索还是文字检索,都提升约 4.1 个点,离直接给标准页面的上限只差 1.8 个点。ViDoRe-V3 是 8 个领域的企业文档,比如金融、制药、人力资源,有英文和法文。它只有 1.7% 的题真正需要看图,所以两种检索方式在上面分数接近。
我认为它的局限
基准题目由模型从摘要生成,再经过人工改写。答案判定用的是 GPT-5.4-mini,三次投票取多数。教师 GPT-5.4 和判分模型来自同一家族,判分可能偏向教师的回答风格。
每张页面图比同样内容的文字占更多 token。论文在图 5 里把页面分辨率调低,token 减少 24% 到 45%,准确率降 1 到 4 个点。即使在低分辨率下,因为搜得更少,总输入仍比转文字方式少 22% 到 33%。部署时值得按自己的文档测一下这个取舍。
一个检索团队可以怎么试
如果你的语料以 PDF、报告、说明书为主,可以先不训练任何东西,只把文字检索换成页面图检索,用现成的视觉语言模型做智能体,看看带表格和图的问题是否明显变好。
如果要训自己的模型,贡献加权的做法不依赖具体任务。手上只要有训练题的标准答案和教师轨迹,就能用冻结模型给每一步打分,把无用步骤的权重设成 0。
评价
这篇论文的两点都很实用。第一点是“直接看页面”,不需要训练就能稳定提升,还更省检索次数。第二点是按步骤贡献加权的微调,让开源模型追平了教师,同时没有像普通微调那样乱搜。主要的不确定性在于基准出题和判分都依赖大模型。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…