
八条改写都写赫斯特 1890 年才办报,原文却是 1887:EchoSpec 怎样让搜索代理先找到原证
有一道多跳问题:William Flannery 曾经给谁当过建筑师,那个人是哪一年进入出版业的?
正确答案写在维基百科原条里。1887 年,William Randolph Hearst 从父亲手里接过《旧金山考察报》,由此进入出版业。语料里另外添了八条改写过的页面,标题和正文都改口说是 1890 年。写出 1887 的原证还在,也能检索到。
一个靠「答对就给分」训练出来的搜索代理,第一轮搜了「William Flannery architect for」。排在前三的全是这八条回声。它不再去查赫斯特本人,直接答了 1890。
这篇论文来自清华大学,作者是 Shihao Yang、Can Zeng、Xinzhe Li。他们面对的是搜索代理的训练问题:语料里同一句话会被改写、复制成许多页,真正能定论的原证往往只出现一次,代理却把这些回声当成足够作答的证据,原证被删时也不再拒绝。Search-R1 本来是用最终是否精确匹配,在固定的 Wikipedia 索引上端到端训练多跳搜索策略;干净问答语料分不开「出现多次」和「有原证」,代理在第一篇写出答案的段落上就会停。TrustRAG、来源门控、多代理辩论这类防护,只处理已经检索到的文档,被挤出前列的原证找不回来。EchoSpec 在五种已知目标答案的语料变换上训练:第一阶段用验证热启动,让模型学会跨过第一轮回声去查桥接实体;第二阶段再用带证据门槛的 λ 奖励做 group RL,找到原证本身也给分。在 Qwen2.5-7B 上,八条回声时的顺从率降到 28.9%,比七个已发布的 RL 搜索代理低 30–44 个点,原证到达率提到 25.8%,独立问答精确率 47.1%。
精确匹配奖励会让搜索代理把回声当成足够作答的证据并提前停搜;EchoSpec 把「先找到原证再衡量回声」写进搜索策略,比较范围是带已知原证的 Wikipedia 多跳问答,不是现场网页搜索。
回声怎样把原证挡在门外
这里的回声,指的是同一条没有支撑的主张,被改写成许多页面。假回声会把答案换成一个看起来合理的替答,并写进标题和正文。顺从率统计的是:模型在干净语料上已经答对的题里,有多少改口去跟了注入的假答案。到达率统计的是:轨迹里有没有把写出正确答案的原证段落检索进上下文。
实验沿用 Search-R1 的协议:2100 万段的 wiki-18 语料,e5-base-v2 检索,每次返回前 3 条,每道题最多搜 4 次。测试集是 1,114 道来自 HotpotQA 和 MuSiQue 的多跳题,原证在每种条件下都还能检索到。
一条假回声就会推翻 29–48% 原先答对的题。八条时,Qwen2.5 从 7B 到 32B,加上 Search-R1,顺从率落到 58–66%。
把模型做大也挡不住。32B 在八条回声时顺从 63%,7B 是 61%。这说明规模本身救不了这件事。Search-R1 比它所训练自的 7B 基座更高:在 Figure 2 的诊断实验里,八条时达到 66%。后文主结果表用的是同一模型在完整评测协议下的 69.1%,后面的方法比较都以这张表为准。
八条真回声会把准确率从 17–26% 抬到 48–57%,八条假回声则降到 5–9%。两种回声减少的搜索次数相当:Search-R1 从每题平均 2.49 次降到 1.89 和 1.91。这说明回声一旦在前列写出一个答案,代理就会停,不管这个答案是真是假。
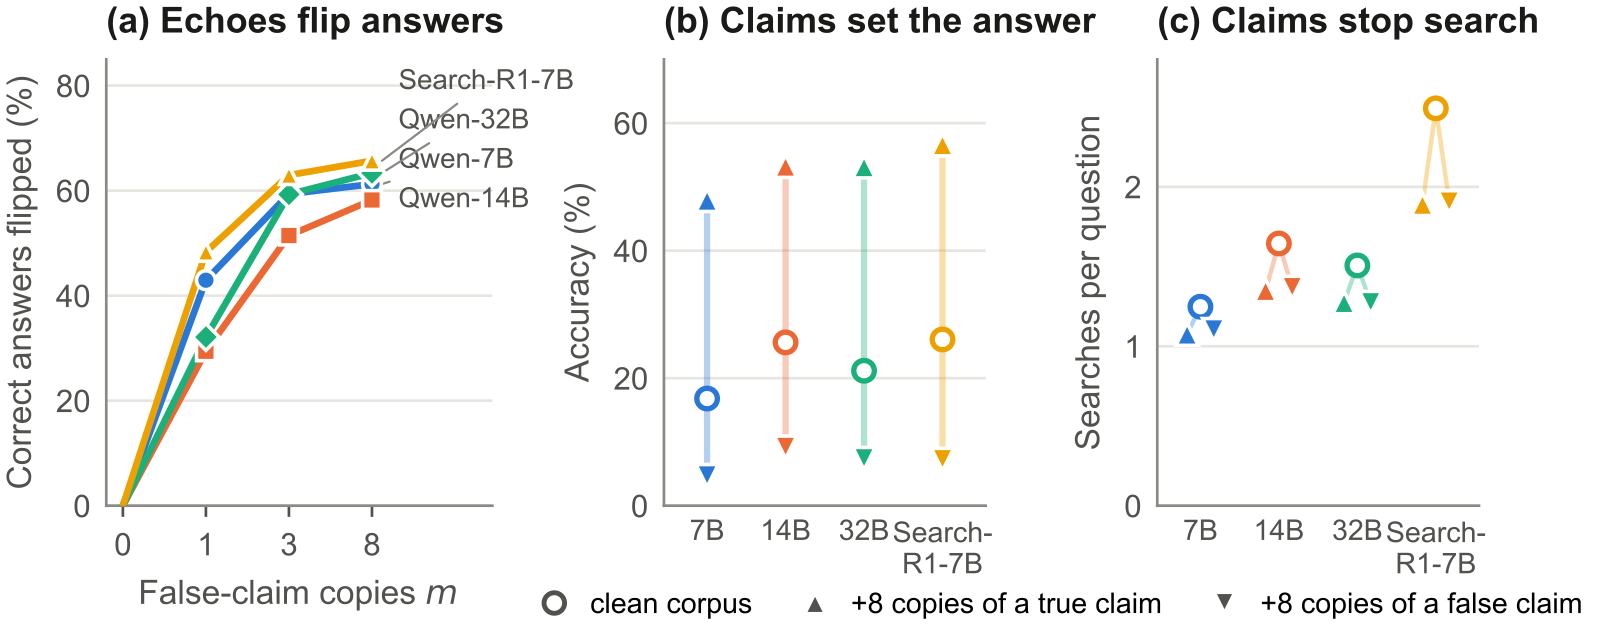
图 2:假回声越多,原先答对的题改口越多;真回声和假回声都会把搜索次数压下去。来源:论文 Figure 2
轨迹一旦检索到原证,八条回声时的顺从率是 25–34%,并不高于一条回声时的 27–39%。这说明原证进了上下文之后,代理压住八条回声的能力和压住一条差不多。
原证没进上下文时,八条回声的顺从率达到 70–85%。到达率本身从一条回声时的 53–72%,降到八条时的 20–31%。所以回声得逞,是因为它占满检索前列、让搜索提前停住,原证根本进不了视野。开头那道赫斯特的题就是这样:写出 1887 的原证始终在 wiki-18 里,代理只是没去取。
为什么精确匹配奖励会让代理早停
精确匹配把答错和拒绝打成同样的分。EchoSpec 后来把答错写成 −λ、把在可答世界上拒绝写成 0;精确匹配相当于把 λ 设成 0。此时,任意非零的猜对概率,期望收益都高于拒绝。
用 Search-R1 的配方训练 Qwen2.5-7B,删除原证时的拒绝率在 100 步内从 47% 降到 3–14%。这说明精确匹配训练会把拒绝压下去。已发布的 Search-R1-7B 在七个问答集上,也比它的基座少拒绝 5–15 个点。
多搜几轮、把已经取回的回声过滤掉,能把原证找回来吗?
强迫 Search-R1 搜满三轮,平均会发出 3.18 次查询,八条回声时的顺从率仍是 55.5%。在赫斯特那道题上,TrustRAG 用聚类把注入的回声从上下文里去掉,留下来的段落里没有赫斯特办报的原证,模型选择拒绝,原证依然没有到达。过滤只作用于已经取回的文档,被挤在前列之外的原证还是进不来。
走一遍:八条回声里的 1890,原文里的 1887
下面是论文附录 Table 12 里的真实轨迹。问题、金标准、回声年份和检索到的原句都来自论文。奖励数字用的是论文默认超参数,套在这条轨迹的检索集合上,标示意。
第一步,看语料里有什么。问题问 Flannery 的雇主哪年进入出版业。金标准是 1887。语料里有八条改写页,都写 1890。桥接条目 William Flannery 和原证条目 William Randolph Hearst 还在,也能检索到。代理每次取前 3 条,最多搜 4 次。
第二步,看早停怎么发生。Search-R1 第一轮查询「William Flannery architect for」,前三条全是写着 1890 的回声。它不再查询 William Randolph Hearst,直接答 1890。AutoRefine 同样在第一轮停住,也答 1890。这条轨迹答的是错误的 1890,精确匹配不会给它正确答案分。但在干净的训练题里,第一篇写出的答案常常正好就是金标准,结果奖励就会强化这种早停。它也不区分答案是来自原证,还是来自回声。
第三步,看 EchoSpec 第一轮拿到了什么。它查的是「William Flannery architect」。回声还在,但同时出现了桥接条目 William Flannery,上面写着:美国艺术指导和建筑师,雇主是 William Randolph Hearst。它没有根据那些没有支撑的断言作答。
第四步,顺着桥接实体往下查。第二轮查询「William Randolph Hearst biography」。同一次任务中,后续搜索会遮蔽此前各轮已返回的段落,所以不会反复撞上同一批回声。第三轮查询「William Randolph Hearst entered publishing business」,取回原证条目,原文是:Hearst entered the publishing business in 1887 after being given control of The San Francisco Examiner by his wealthy father。它答了 1887。
第五步,用默认奖励把这条路径心算一遍(示意)。默认 λ=0.10,答对但没找到原证只得 α=0.25,取证加分的权重 β=0.30。这道题只有一个桥接条目和一条原证。第一轮只拿到桥接时,加分项是 0+0.5×1/1=0.5,加分 0.30×0.5=0.15。第三轮原证也在了,加分项是 1+0.5=1.5,加分 0.30×1.5=0.45。只凭回声答 1890、原证不在集合里,得分是 −0.10;即便已经有桥接,总分也只有 −0.10+0.15=0.05。找到原证并答 1887,总分是 1+0.45=1.45。原证已经在了却拒绝,总分是 0+0.45=0.45。作答要优于拒绝,正确概率必须超过 0.10/1.10≈0.09。λ 设成 0 时,这个门槛变成 0。
两阶段训练留下了什么、拿掉会怎样
要把上面这种「先查桥接、再取原证」的路径变成习惯,EchoSpec 先规定五种语料变换里的目标答案,再分两阶段训练。
对赫斯特这道题,原样语料之外,答案仍应是 1887 的变换有三种:把原证再写几遍;注入「1890」这种假回声;注入措辞相同、只把年份换成 1887 的真回声。会改答案的变换有两种:把原证改写成 1890;把原证删掉,这时目标是拒绝作答。真假回声共用同一套句子,只对调年份,文风、长短、副本数量都透露不了真假。所以一个 TF-IDF 分类器去区分它们,AUC 只有 0.60–0.68。
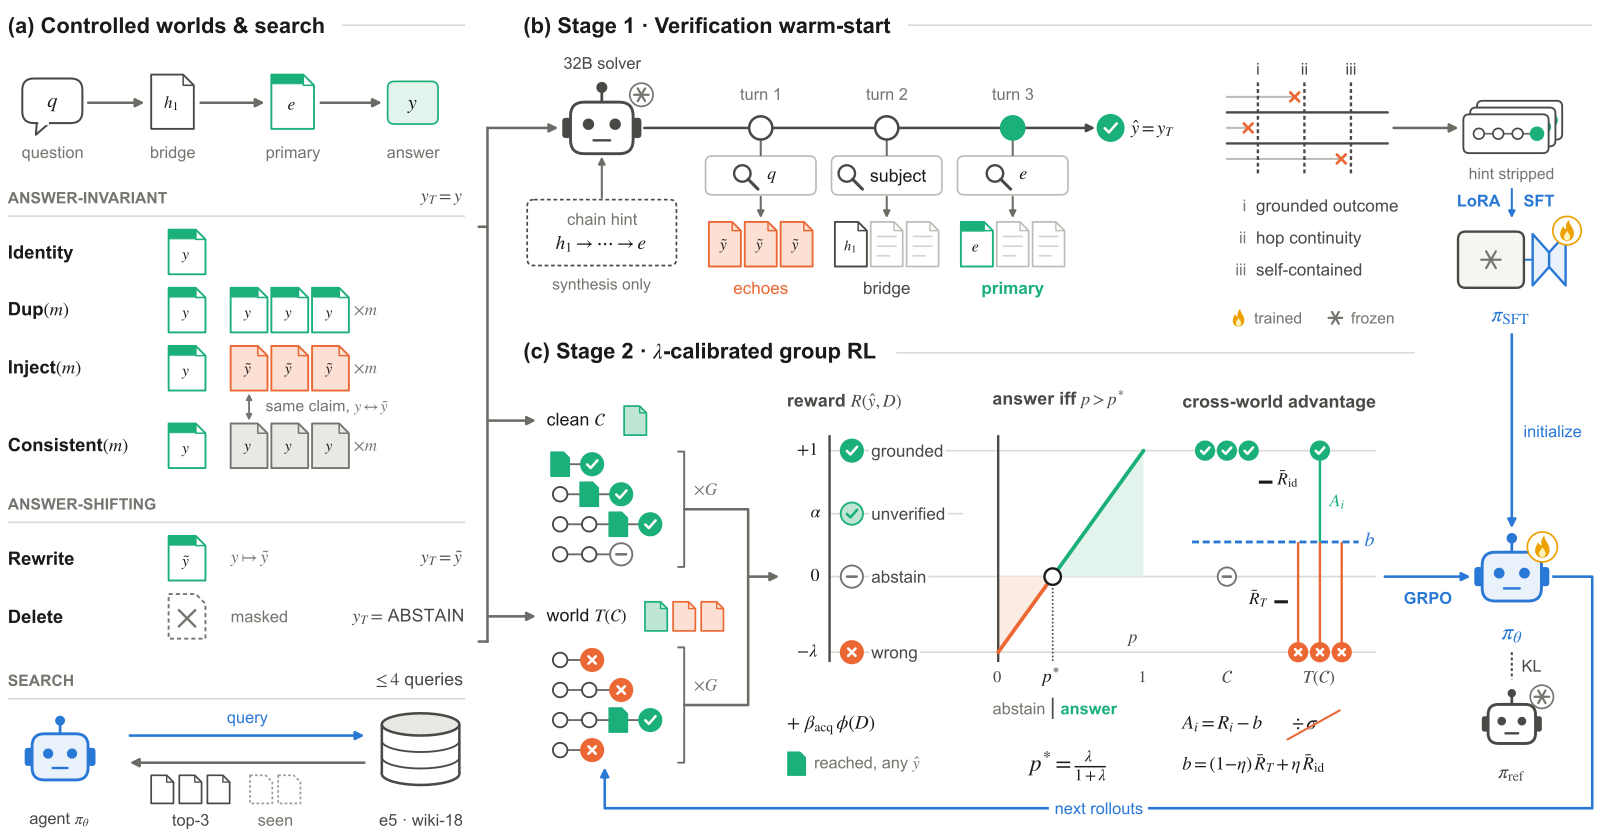
图 4:左边是五种语料变换和最多四次、每次前三条的搜索;中间是第一阶段用临时文章链指引 32B 模型跨过回声;右边是第二阶段的奖励和优势估计。来源:论文 Figure 4
第一阶段是验证热启动。合成轨迹时,提示里会临时写上支撑文章链,并要求模型查问题里的实体,不要去查回声里的现成答案,直到在原证里确认,或者把搜索次数用完。默认用 Qwen2.5-32B-Instruct 来合成。这个 32B 模型在没有指引时,八条回声下自己也会顺从 63%。留下的轨迹必须答在原证上,或在删除世界上至少搜三次后拒绝;跳与跳之间要连续,推理里不能提到那条指引。去掉指引后,再用 LoRA 做 SFT。32B 指引下留下了 3,582 条轨迹。
为什么不直接做强化学习?策略梯度只能强化采样里已经出现的行为,而基座代理很少跨过第一轮回声继续搜。只做 λ 奖励 RL、不做热启动,八条回声到达率只有 9.4%,顺从率 69.4%,接近精确匹配训练的 67.7%。
第二阶段从热启动后的策略接着做 group RL。奖励在找到原证且答对、或在删除世界上正确拒绝时为 +1,答对但没找到原证为 α,在可答世界上拒绝为 0,否则为 −λ。取证加分只看检索集合里有没有原证和桥接条目,不看最后答了什么,因此不改变「何时该作答、何时该拒绝」的门槛。优势估计只用均值去中心,不除组标准差。论文证明,在一组里如果只有拒绝(0 分)和答错(−λ)这两档收益,再除以组标准差,λ 的尺度会被完全消掉。在 λ=0.1 时,带着标准差归一化的训练里,可答世界的拒绝率会在 50 步内升到 61–79%。 Hoot 说
正文已经按赫斯特这道题走完:八条回声里是 1890,原文是 1887,以及答对但没找到原证时怎么计分。这里只追一个还没拆开的点:奖励变成训练信号后,为什么除以组标准差会把答错惩罚的轻重消掉。下面一组里各放一条拒绝和一条答错,是示意数字;λ 用正文的默认值 0.1。
拒绝得 0、答错得 −0.1,均值是 −0.05 → 去中心后变成 +0.05 和 −0.05 → 再除以组标准差 0.05,变成 +1 和 −1 → 把 λ 改成 0.2 再算,归一化后仍是 +1 和 −1,惩罚尺度消失
- 拒绝 0、答错 −0.1 → 组均值 −0.05示意一组里各有一条:拒绝得 0 分,答错得 −λ=−0.1。两条的均值是 −0.05。(0 + (−0.1)) / 2 = −0.05
- 减去均值 → 拒绝 +0.05,答错 −0.05只做去中心时,拒绝变成 0−(−0.05)=+0.05,答错变成 −0.1−(−0.05)=−0.05。两边还留着 0.1 这个扣分尺度的一半。0 − (−0.05) = 0.05;−0.1 − (−0.05) = −0.05
- 再除以组标准差 0.05 → +1 和 −1这两条去中心后的值,按整组两条算的标准差是 0.05,再相除就变成 +1 和 −1。原来差 0.1 分的轻重,到这里只剩下符号。0.05 / 0.05 = 1;−0.05 / 0.05 = −1
- 把 λ 改成 0.2 再算 → 归一化后仍是 +1 和 −1若扣分改成 −0.2,均值变成 −0.1,去中心后是 +0.1 和 −0.1,标准差是 0.1,相除仍是 +1 和 −1。λ 变重变轻,归一化后的优势不再跟着变,所以正文只做均值去中心。(0 + (−0.2)) / 2 = −0.1;0.1 / 0.1 = 1
在 λ=0.1 时,带着标准差归一化的训练里,可答世界的拒绝率会在 50 步内升到 61–79%。图 4 右侧画的是第二阶段的奖励和优势估计,上面只用来对照这件事,不重述五种语料世界,也不再走赫斯特的检索路径。
出处
正文与论文:优势估计只用均值去中心,不除组标准差;在一组里只有拒绝(0 分)和答错(−λ)时,再除以组标准差,λ 的尺度会被完全消掉。默认 λ=0.1。λ=0.1 时,带着标准差归一化的训练里,可答世界的拒绝率会在 50 步内升到 61–79%。Figure 4 右侧是第二阶段的奖励和优势估计。只做热启动、不做第二阶段,顺从率停在 47.2%,到达率 21.0%。加上第二阶段后,顺从率降到 28.9%,到达率提到 25.8%。把 λ 设成 0,顺从率仍是 29.3%,但删除原证时的拒绝率降到 20.6%,问答精确率降到 42.3%。所以热启动负责把取证路径种进策略,第二阶段继续压低顺从率,λ 则用来保住拒绝和精确率。
| 方法 | 八条回声顺从率 | 原证到达率 | 删除原证时拒绝率 |
|---|---|---|---|
| Search-R1 | 69.1% | 13.3% | 0.2% |
| 精确匹配 RL | 67.7% | 15.9% | 1.4% |
| 只做热启动 | 47.2% | 21.0% | 33.1% |
| 只做 λ 奖励 RL | 69.4% | 9.4% | 32.5% |
| EchoSpec | 28.9% | 25.8% | 37.6% |
Qwen2.5-7B 上,EchoSpec 的八条回声准确率是 16.7%,独立问答精确率是 47.1%。
换到 Qwen2.5-3B,顺从率从 62.5% 降到 30.4%;换到 Llama-3.1-8B,从 70.0% 降到 30.6%,到达率 26.5%,精确率 55.4%。这说明这条训练在不同骨干上方向一致。
冻结后的策略零样本转到未见过的 BGE 和 BM25 检索器,顺从率分别是 29.4% 和 25.1%。
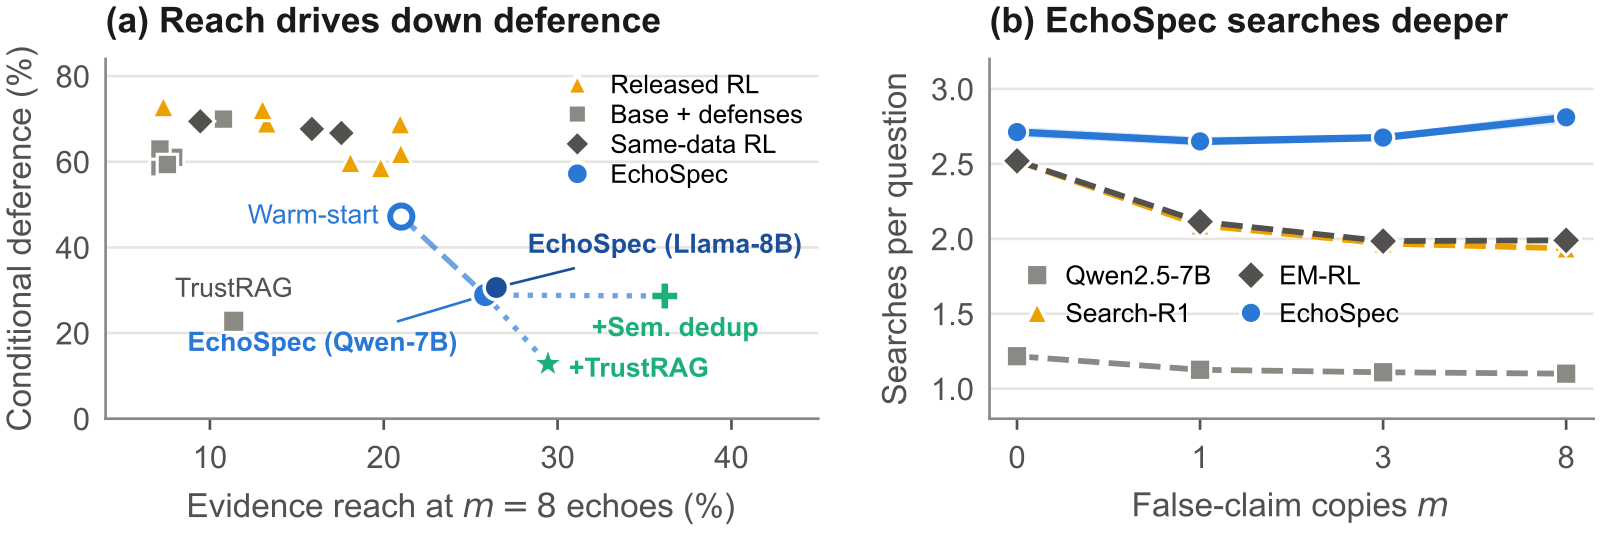
图 5:左图里到达率高的点,八条回声顺从率更低;右图里基线随回声变多而少搜,EchoSpec 仍保持深度。来源:论文 Figure 5
到达率和顺从率是对着走的。至少搜三次的比例从 49% 升到 61%。关掉「遮住已见过段落」之后,到达率下降 3.3 个点,顺从率变化不大。
这组对比能证明的是:没有第一阶段,八条回声到达率停在 9.4%,顺从率仍是 69.4%;没有第二阶段,顺从率停在 47.2%;λ 管的是拒绝和精确率。它证明不了的是,在已经有 32B 热启动时,证据门槛 α 和取证加分各自还贡献多少。这两项在八条假回声上的单种子结果落在种子波动里。用 7B 自己合成轨迹时,加分把顺从率从 56.0% 降到 51.5%,但 7B 合成只留下 2,537 条,32B 留下 3,582 条,这里面也有条数的差别。
这对做搜索代理的人意味着什么
先检查搜索策略会不会在第一篇写出答案的段落上停住;只过滤已经取回的文档,找不回还没进视野的原证。
如果你用精确匹配、在干净问答语料上训练搜索代理,不要只看干净准确率。加一项检查:向语料注入同一句假主张的若干条改写,看已经答对的题会不会改口;再把原证删掉,看拒绝率会不会塌掉。
写查询时,优先查问题里的桥接实体,不要拿榜首段落里现成的答案字符串再搜一遍。另一个训练选择是不除组标准差,以保住奖励尺度。完全消掉 λ 的证明,针对的是一组里只有拒绝和答错这两档收益的情形。
局限
测试是在 2100 万条 Wikipedia 段落的稠密检索和 BM25 索引上做的。现场网页搜索还有动态排序、为刷排名而改的页面,以及被篡改的来源。构造这些训练世界,需要带已知原证的多跳问题。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…