目录 · 9 节
1它到底在解决什么问题?2整体流程3设计一:去掉逐层查表,给非文字输入留位置4设计二:先蒸馏,再用对比学习收尾5设计三:视觉编码器一起训,视觉 token 预算按场景调6主要结果:小一个量级,分数却在前沿上7我认为它的局限8一个推荐或搜索团队可以怎么试9一句话结论
想让一个 embedding 模型同时搜文字、图片、视频和音频,常见做法是先把音频转成文字、给图片配说明,再交给文本模型,既多花算力,又丢掉了语气和画面细节。Google 的 EmbeddingGemma 2 用一个 744M 参数的模型,把这几种输入直接映射到同一个向量空间,各模态编码器还能按需加载。用语音提问去找文本段落最能说明差别:同一个模型先把语音转写成文字再检索,MRR@10 是 57.59,直接读音频能到 69.54。小模型做多模态,不一定要牺牲文本和代码,它的代码检索分数反而比上一代高出近十分,从 68.76 升到 78.68。
做端侧或低成本检索的团队值得读这篇,因为它给出了一份可以照着做的小模型多模态训练配方,而且每个关键选择都有消融:先蒸馏、后对比学习,视觉编码器要一起训,训练结束把最终 checkpoint 和早期 checkpoint 平均。量化到 int4 后,完整多模态模型在 Pixel 11 Pro 上峰值内存 567MB,只做文本时 191MB。需要留意的是,英文文本分数比上一代略低,int4 量化对图片和语音的伤害明显大于文本,视频在加大视觉 token 预算后反而变差。
它到底在解决什么问题?
多模态检索现在大致有三种做法。
| 做法 | 代表 | 优点 | 主要代价 |
|---|---|---|---|
| 先转成文字再用文本 embedding | ASR + 文本模型、图片配说明 | 复用现有文本检索链路 | 多一道模型调用;语气、背景声、画面布局等信息丢失 |
| 每种模态一个专用模型 | CLIP、CLAP | 单模态和跨模态检索效果好 | 不能直接处理图文、音文混在一起的输入 |
| 从多模态大模型改出 embedding 模型 | 数 B 参数的 VLM embedding | 效果强,支持混合输入 | 参数大,延迟和内存都不适合端侧 |
EmbeddingGemma 2 想做的是第四种:参数量压到 1B 以下,却仍然能把任意模态和它们的组合编码进同一个空间。
用一个小例子看差别(示意)。手机相册助手要支持一句语音提问“上次弹吉他那段视频”,库里有一段吉他视频、一张吉他照片和一条“吉他调音器”的笔记。
| 做法 | 要跑的模型 | 能利用的信息 |
|---|---|---|
| 语音先转写,视频先配说明 | ASR、视频描述模型、文本 embedding | 只剩转写和描述出的文字 |
| 三个专用模型 | 语音、视频、文本各一个 | 各自有信息,但向量不能直接比较 |
| EmbeddingGemma 2 | 一个主干,按需加载音频和视觉编码器 | 原始语音和视频帧,向量在同一空间里直接比 |
整体流程
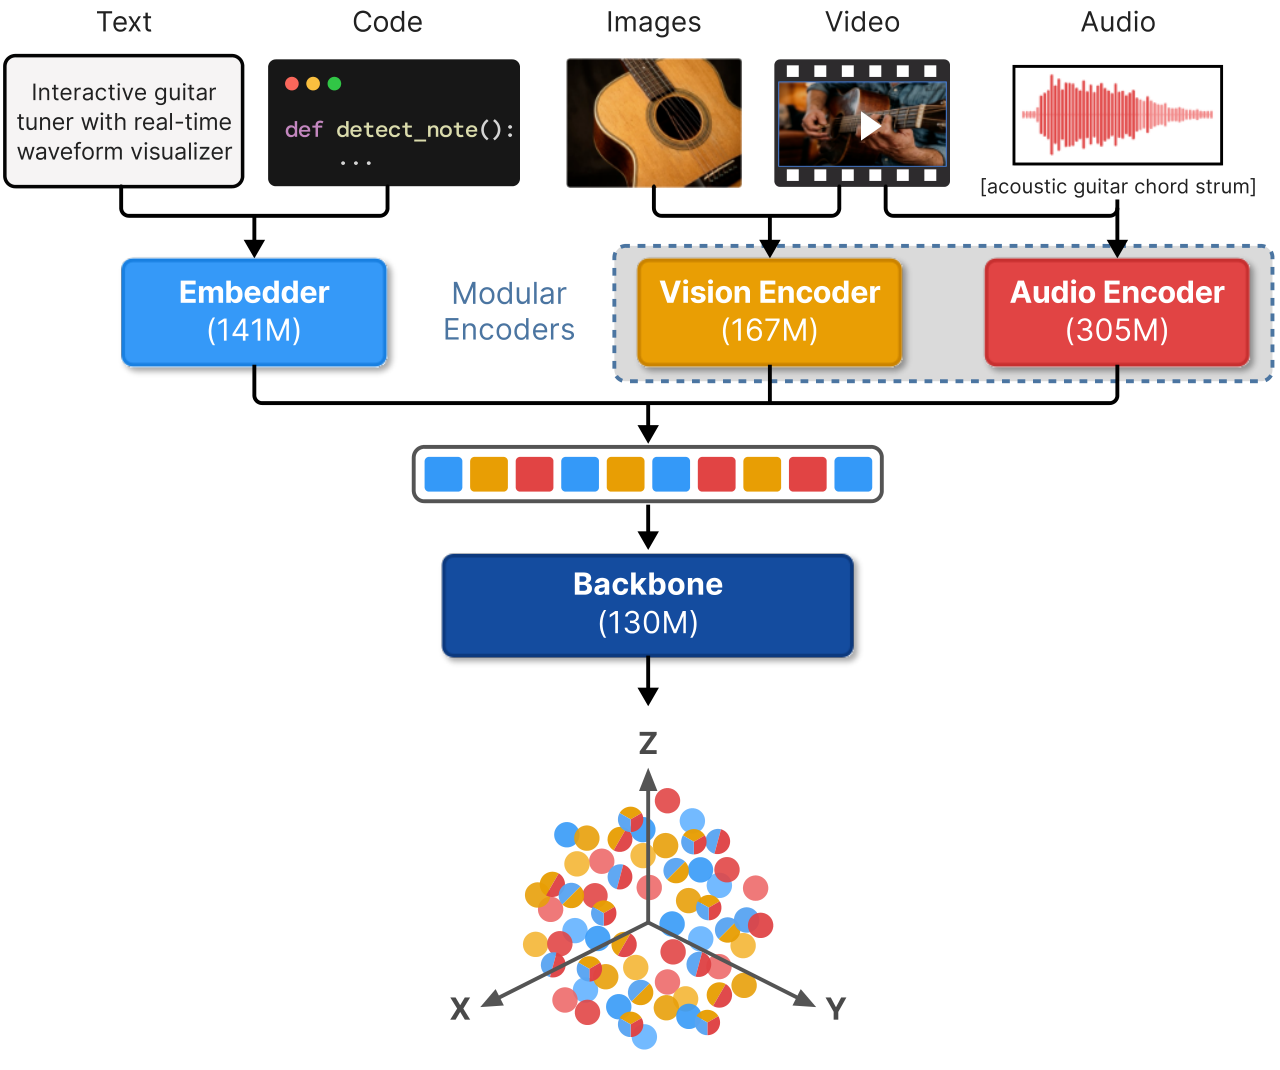
这张图看中间那排彩色方块:不同模态的 token 按原来的先后顺序交错排在一个序列里,所以一条输入可以是“一段文字加一张图再加一段语音”。
| 环节 | 做什么 |
|---|---|
| 主干 | 基于 Gemma 4 的 24 层双向 Transformer,隐藏维度 512,连 embedding 层共 271M,单独就能当文本模型用 |
| 模态编码器 | 视觉编码器输出 768 维、音频编码器输出 1536 维的 soft token,各用一个线性层投到 512 维后与文字 token 交错 |
| 输出 | 均值池化后投影到 768 维。用 MRL 训练:每个损失在前 768、512、256、128 维这几段嵌套子向量上各算一份,所以直接取前 512、256 或 128 维也能检索 |
| 训练 | 文本蒸馏,多模态蒸馏,多模态对比学习微调,合并 checkpoint,最后单独做量化感知训练 |
| 部署 | 只加载需要的编码器:纯文本 271M,图文 439M,音频加文本 577M,全部 744M |
输入的拼法很直接:文字按词切成 token;图片先过视觉编码器,再在空间上池化到预算以内的视觉 token,前后包上图片起止标记;视频按帧处理,最多 32 帧;音频按 40 毫秒一段切开送进音频编码器。所有片段按原顺序首尾相接,所以“文字加图片加语音”的混合输入也只是一个更长的序列。任务通过前缀告诉模型,例如检索 query 写成 task: search result | query: {text},文档侧用另一种前缀。
设计一:去掉逐层查表,给非文字输入留位置
为什么需要:Gemma 4 在每一层都会额外注入一份Per-Layer Embeddings(PLE),它由两部分相加,一部分是主 token embedding 的线性投影,另一部分来自一张按词表查的专用表。图片和音频的 soft token 没有词表编号,查不到这张表,表本身还要占内存。
怎么做:EmbeddingGemma 2 只保留投影那一部分,每层的额外输入都从当前 token 的嵌入算出来,不管它来自文字、图片还是音频。
小例子(示意):一条输入是“吉他”两个字加一张图片的 280 个视觉 token。原来的做法里,这两个字能查到逐层表,280 个视觉 token 只能拿到投影;改完以后,282 个位置拿到的是同一种逐层输入。 Hoot 说

Gemma 4:投影 + 查表
- “吉他” 2 个文字位置
- 投影 + 查表
- 280 个视觉位置
- 只有投影,查不到表
- 合起来
- 来源不一致,还占内存
还要在内存里存一整张逐层表。
EmbeddingGemma 2:只用投影
- “吉他” 2 个文字位置
- 投影
- 280 个视觉位置
- 投影
- 合起来
- 282 个位置同一算法
音频 token 同理:只要有嵌入,就能得到逐层输入。
示意:2 个文字位置加 280 个视觉位置;查表只能按词表编号查,视觉 token 没有编号。 出处: 正文“设计一”的 PLE 描述与示意例子
| PLE 方式 | MMEB-v2 总分 | 图片 Hit@1 | 视频 Hit@1 | 视觉文档 NDCG@5 |
|---|---|---|---|---|
| 只用投影 | 55.46 | 54.67 | 47.82 | 62.37 |
| 投影加查表 | 55.07 | 54.57 | 47.13 | 61.76 |
这说明那张专用表对多模态检索没有帮助,去掉它既省内存,视频和视觉文档还略有提升。
设计二:先蒸馏,再用对比学习收尾
为什么需要:小模型直接从对比学习起步,很难学出大模型那样的空间结构;但如果一直蒸馏,学生只能逼近老师的空间,而老师的空间并不是为 768 维、Matryoshka Representation Learning(MRL)截断和这么小的模型准备的。
怎么做:训练分四段,总计约 2.9T token。
| 阶段 | 数据量 | 损失 |
|---|---|---|
| 文本预微调 | 约 300B token | 几乎全部是从 Gemini Embedding 2 蒸馏:老师的向量截到学生的维度,学生直接拟合同一输入的老师向量 |
| 多模态预微调 | 约 2T token | 只用蒸馏 |
| 多模态微调 | 约 600B token | 对比学习,负例包括批内负例、难负例和同塔负例,再加 spread-out 正则(分别惩罚批内两两 query 之间、两两正例文档之间内积的平方,让向量像在球面上均匀撒开)和 MRL,不再蒸馏 |
| 合并与量化 | — | 最终 checkpoint 与同一次训练里早得多的 checkpoint 等权平均;之后单独一段从浮点模型蒸馏出 int4 模型 |
对比损失写成 ,其中 是同塔负例:一条 query 和批内其他 query 的相似度,加上它的正例文档和其他正例文档的相似度。加它是为了防止 query 和文档各自挤在两块互不相交的子空间里。
小例子(示意):一批里有“吉他调音器”和“尤克里里教学”两条 query。批内负例让“吉他调音器”离“尤克里里教学”对应的文档远一些;同塔负例还要求两条 query 本身也拉开,避免所有 query 都聚在空间的一个角上。
| 做法 | MMEB-v2 总分 |
|---|---|
| 预微调结束时 | 52.27 |
| 继续加长蒸馏 | 52.28 |
| 换成对比学习微调 | 55.46 |
这说明蒸馏到一定程度就到顶了。换成整套微调方案(对比损失加 spread-out 正则)后多了 3 分以上;这组对照没有把对比损失和正则分开测。
最后的 checkpoint 合并也值得单独说。常见做法是跑几次不同数据配比或超参的微调再平均,这里只用一次训练:把最终 checkpoint 和同一条训练轨迹上早得多的一个 checkpoint 等权平均。复现时,这个早期 checkpoint 可以在验证集上挑,选在过拟合任务开始掉分之前。作者观察到,微调后期有些任务会过拟合而掉分,早期 checkpoint 还保留着这些任务的能力,平均之后这些任务回升,原本受益于微调的任务还能再涨一点。对资源有限的团队,这比多跑几次微调便宜得多。
quantization-aware training(QAT)也没有放进微调里,而是在合并之后另起一小段:用冻结的浮点模型当老师,初始化并蒸馏出 int4 版本。这样这段训练很短,作者说它主要缩小了英文文本上浮点与量化之间的差距。
设计三:视觉编码器一起训,视觉 token 预算按场景调
为什么需要:从 VLM 继承来的视觉编码器是为生成文字准备的,不一定适合做检索;而每张图用多少个视觉 token,直接决定延迟和效果。
怎么做:视觉编码器在训练中保持可训练。训练时每张图 280 个视觉 token,视频每帧 140 个,推理时可以改成 70 到 1120。
| 视觉编码器 | MMEB-v2 总分 |
|---|---|
| 一起训练 | 52.27 |
| 冻结 | 48.18 |
这说明冻结视觉编码器会损失约 4 分,省下的训练成本不值得。
| 推理时视觉 token 预算 | 总分 | 图片 Hit@1 | 视频 Hit@1 | 视觉文档 NDCG@5 |
|---|---|---|---|---|
| 70 | 50.07 | 50.90 | 46.33 | 51.61 |
| 140 | 55.37 | 53.58 | 47.99 | 63.60 |
| 280 | 56.15 | 55.15 | 48.51 | 63.38 |
| 560 | 57.02 | 55.21 | 46.52 | 67.62 |
这说明预算加大对 PDF、幻灯片这类视觉文档最有利,从 280 加到 560 涨了 4 分多;视频帧在超过 280 后反而从 48.51 降到 46.52,上线时应当按内容类型分开设置预算。
主要结果:小一个量级,分数却在前沿上
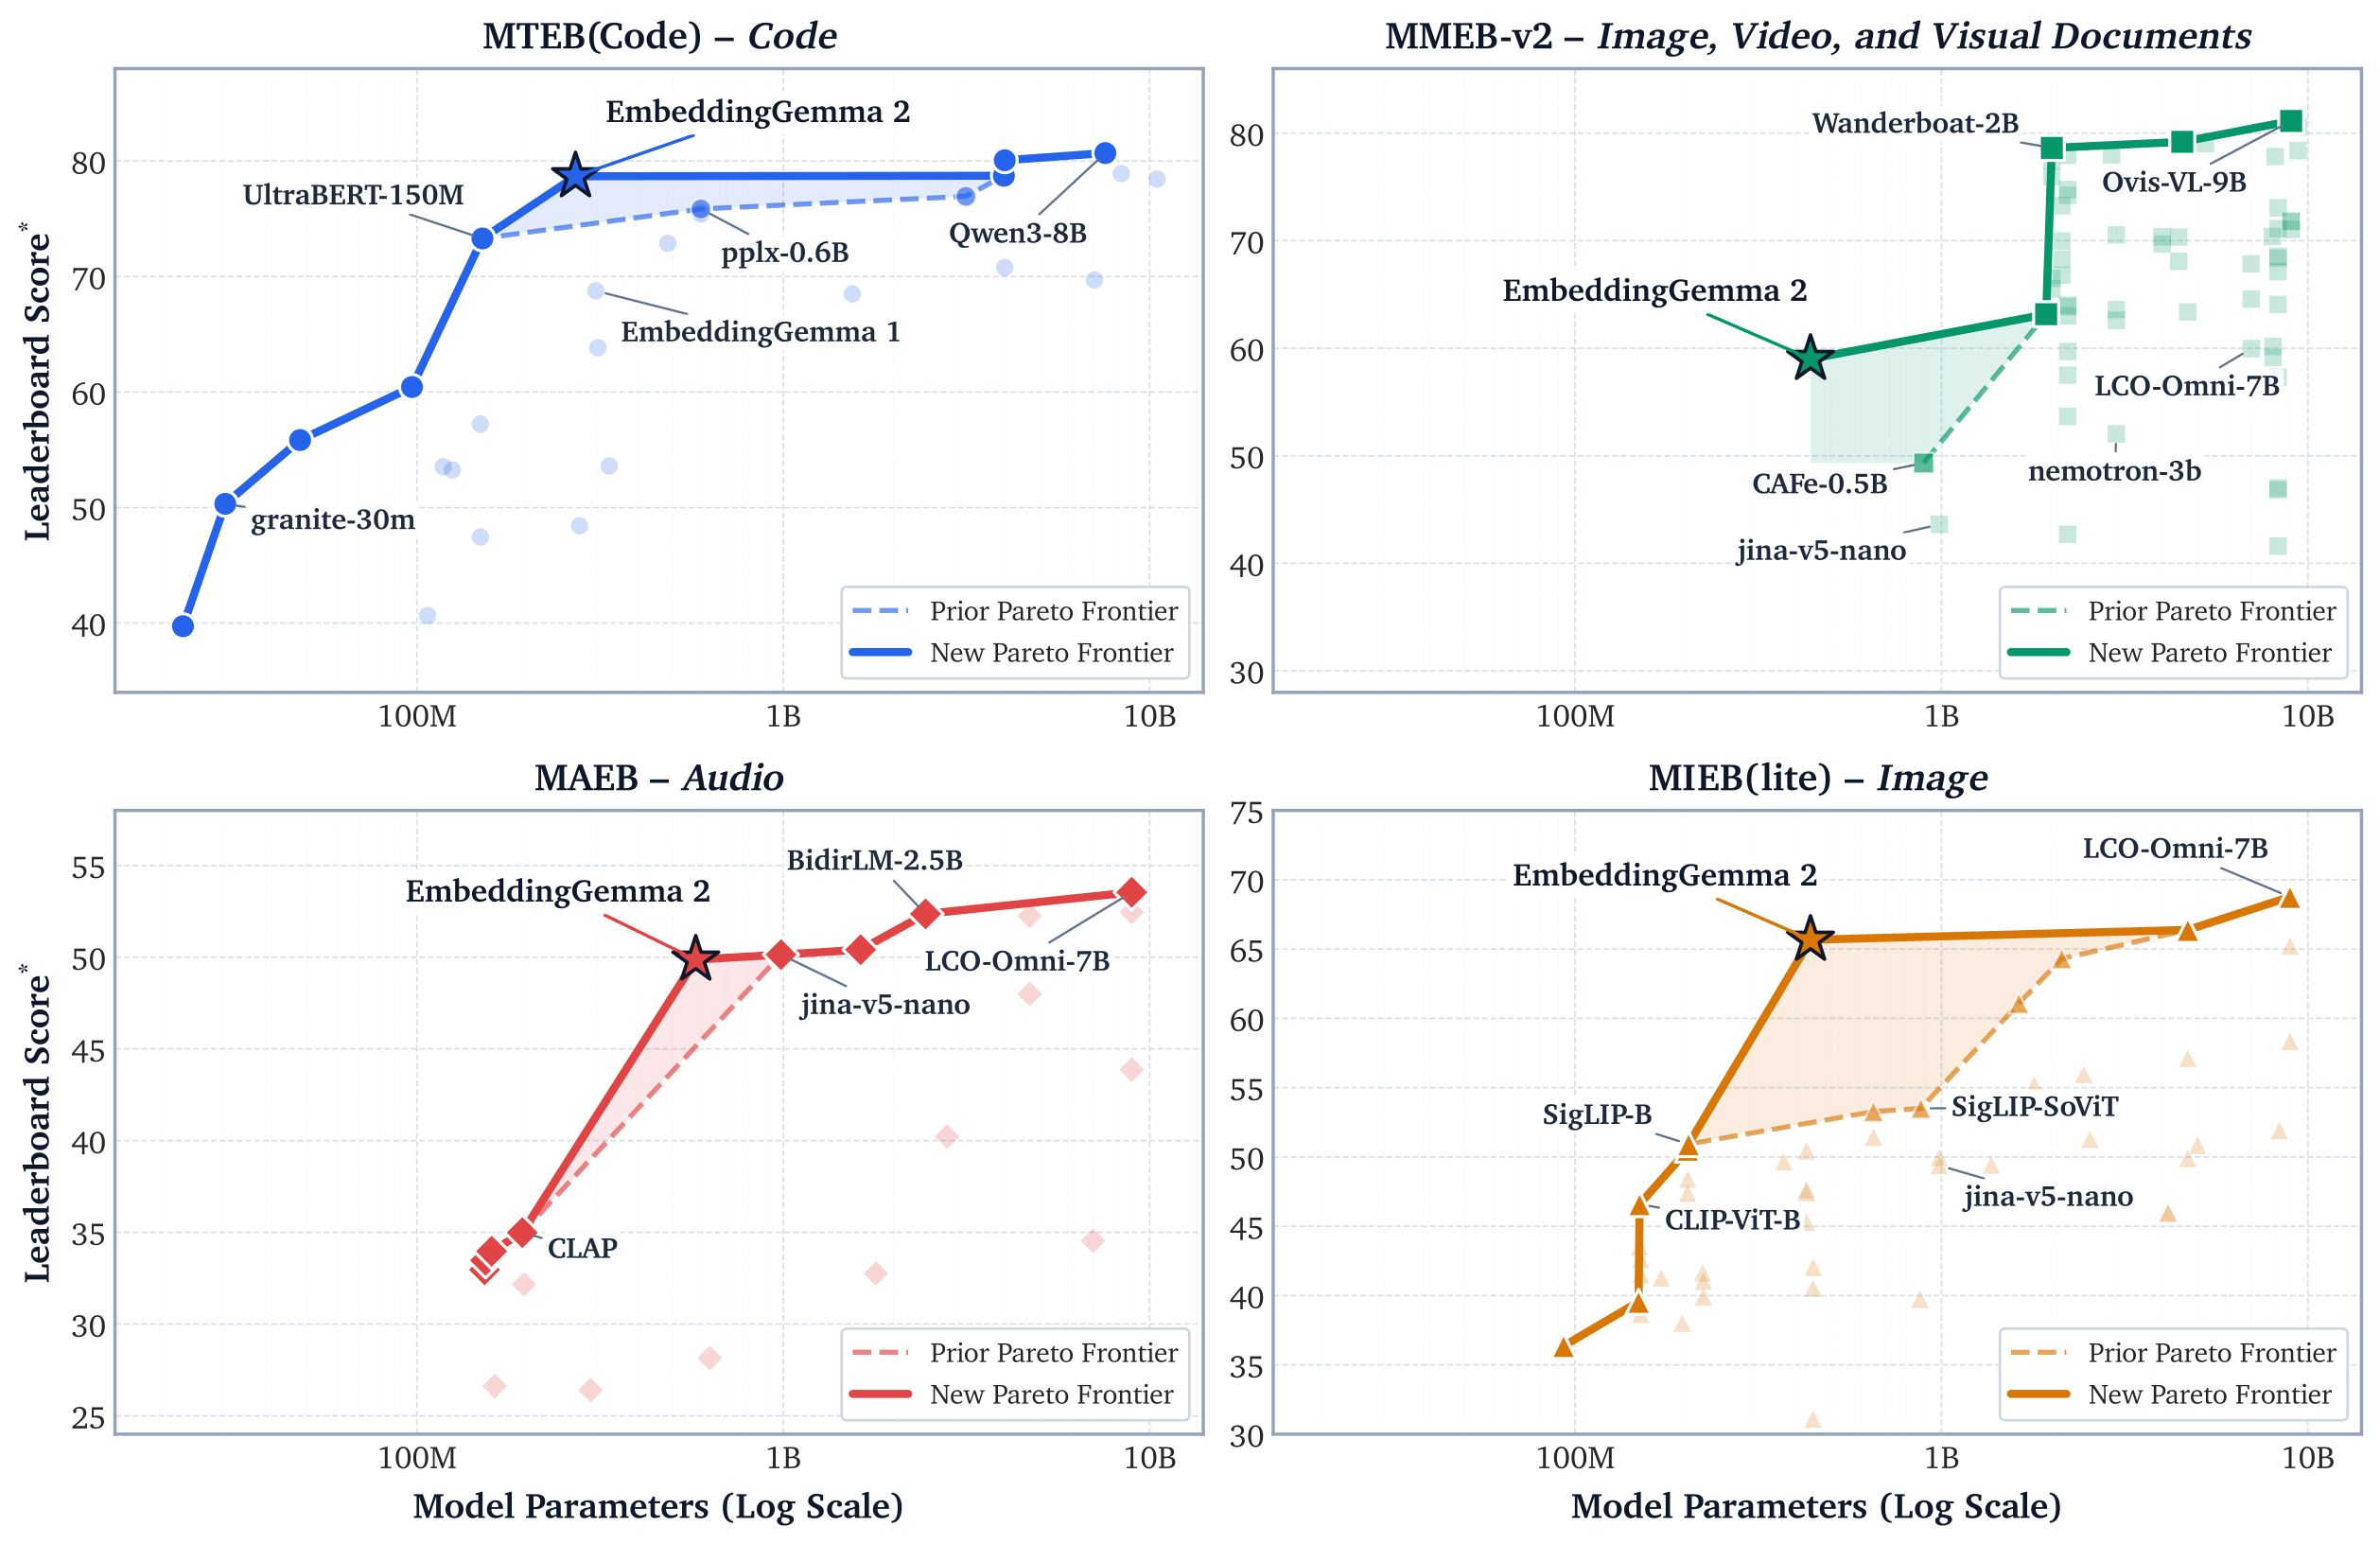
看图时先找星号再看阴影:代码和图片两张图里阴影面积最大,说明在 1B 以下这两个方向它领先最多;音频那张阴影较小,说明它在音频上只是和同量级最好的模型持平。
| 测试 | 指标 | EmbeddingGemma 2 | 对照 |
|---|---|---|---|
| MTEB 多语言 | 任务均分 | 61.36 | 上一代 61.15 |
| MTEB 英文 | 任务均分 | 68.46 | 上一代 69.67 |
| MTEB 代码 | 任务均分 | 78.68 | 上一代 68.76 |
| MMEB-v2 | 图片、视频、视觉文档总分 | 59.01 | jina-v5-omni-nano(986M)43.61 |
| MIEB(lite) | 按单个任务平均 / 先在检索、分类、聚类等任务类型内平均再跨类型平均 | 60.17 / 65.67 | 比 1B 以下最好的模型高 7.9 / 12.2 |
| MAEB | 任务均分 | 49.87 | 距 1B 以下最好的模型约 0.2 |
| MSEB 语音检索 | MRR@10 | 69.54 | 同模型先转写 57.59 |
这说明它的强项集中在代码、图片和视觉文档,代码上超过所有 4B 以下的模型,距离大 28 倍的榜首不到 2 分;文本基本持平上一代,英文略退。
语音检索单独看更清楚,测试是用一种语言说出的问题去找文本段落,覆盖 26 种语言和地区。
| 做法 | MRR@10 |
|---|---|
| 上一代先转写再编码 | 50.95 |
| EmbeddingGemma 2 先转写再编码 | 57.59 |
| EmbeddingGemma 2 直接读音频,256 维 | 66.76 |
| EmbeddingGemma 2 直接读音频,768 维 | 69.54 |
| Gemini Embedding 2 先转写 | 70.40 |
| Gemini Embedding 2 直接读音频 | 73.99 |
这说明省掉 ASR 这一步不只是省算力,还多拿 12 分;截到 256 维(66.76)仍比它自己先转写(57.59)高 9 分以上,只是不如 Gemini Embedding 2 先转写(70.40);向量存储可以先砍到三分之一。
端侧部署方面,int4 按通道量化后在 Pixel 11 Pro 上峰值内存是纯文本 191MB、图文 447MB、全模态 567MB。
| 测试 | bfloat16 | int4 按通道 |
|---|---|---|
| MTEB 多语言 | 61.36 | 60.84 |
| MTEB 英文 | 68.46 | 68.49 |
| MTEB 代码 | 78.68 | 76.70 |
| MIEB(lite) 任务均分 | 60.17 | 56.71 |
| MSEB 语音检索 | 69.54 | 63.92 |
这说明量化对文本几乎无损,对图片和语音的损失在 3 到 6 分之间,部署前要按模态分别评测。
注意论文说明浮点和量化两组的语音、图片分数用的是不同评测脚本,这两项差距只能作为参考。
我认为它的局限
第一,多模态的代价落在了英文文本上。MTEB 英文从上一代的 69.67 降到 68.46,代码虽然大涨,但如果线上主要是英文文本检索,换模型前应该先在自己的数据上确认这 1.2 分的回退影响有多大。
第二,视频是最弱的一环。在视觉 token 预算那组实验里,视频 Hit@1 一直在 46 到 49 之间,预算从 280 加到 560 反而掉了约 2 分,说明多帧信息的整合还没训好,做短视频检索的团队不能直接把视觉文档上的结论搬过去。
第三,音频编码器训练时冻结,直接沿用 Gemma 4 的权重,向量里一些声学信息没有被整理好。一个迹象:在 IEMOCAP 数据上,用向量训练一个线性分类器判断说话人性别,准确率能到 66.40%,说明性别信息还在向量里;但直接按性别给 VoxPopuli 录音聚类时,效果在附表 Table 17 的音频任务里排在最差的一档。也就是说,信息在,但没有排成聚类能直接用的形状。依赖音频聚类或去重的场景要先验证。
一个推荐或搜索团队可以怎么试
- 先只加载 271M 的文本部分,替换现有文本 embedding,用自己的英文、中文和代码查询各抽一批做离线对比,重点看英文是否回退。
- 有语音搜索的业务,把语音 query 分两路:一路走现有 ASR 加文本模型,一路直接送音频编码器,比较 MRR@10 和端到端延迟。
- 有图片或文档库的业务,加载视觉编码器,按内容类型分别试 140、280、560 三档视觉 token 预算,文档类和视频类分开定。
- 用 MRL 截到 256 维做一组对照,算清索引存储和召回分数各变多少,再决定线上维度。
- 如果要上端侧,用 int4 按通道量化版本按模态各测一遍,图片和语音的退化要单独过线。
- 想自己微调的团队,可以照搬它的顺序:先从大模型蒸馏,再用带同塔负例的对比学习收尾,最后把最终和较早的 checkpoint 平均。
一句话结论
这是目前 1B 以下最完整的多模态 embedding 方案,代码、图片和语音检索都在同量级领先,代价是英文文本略退、视频偏弱。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。端侧和低成本场景需要一个模型覆盖多种输入,现有方案不是太大就是要串多道模型 |
| 方法创新性 | 中。单项技术大多已有,贡献在于把蒸馏、对比学习、合并和量化组合成一份小模型可用的配方,并逐项消融 |
| 实验证据 | 高。覆盖文本、代码、图片、视频、音频五类榜单,关键设计都有对照;不足是量化对比的评测脚本不一致 |
| 工程成本 | 低到中。权重公开,可按模态加载,int4 版本可上手机;需要自己评测各模态的量化损失 |
| 是否值得尝试 | 值得,尤其是有语音或图文检索、对延迟和内存敏感的团队;纯英文文本检索可以先做对照再决定 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…