目录 · 9 节
1它到底在解决什么问题?2先看全景:TIDE 换掉了哪几步3为什么通信 kernel 会让矩阵乘慢 69%?4all-gather:参数直接落到最终位置5reduce-scatter:两级加法,最后一步交给 NVSwitch6实验结果说明了什么?7我认为它的局限8一个训练团队可以怎么试9结论
TIDE(可灵团队的一套 FSDP2 通信实现)把 FSDP2 每一步都要做的布局转换直接做进了 all-gather 和 reduce-scatter。原版 FSDP2 的参数和梯度按每个参数单独存放,NCCL 却只收发按 GPU 顺序排好的一整块缓冲区,所以每一步都要来回拷贝:all-gather 完把结果抄回各参数,reduce-scatter 前把 bf16 梯度打包成一块 fp32 大缓冲区。TIDE 让通信从参数所在的位置读,直接写到参数最终要在的位置,搬数据交给拷贝引擎、RDMA 和 NVSwitch,模型代码和计算 kernel 都不用改。在三种模型上,单步时间最多比原版 FSDP2 少 27.1%。在 70B 模型的训练里,光那些拷贝就占单步时间的 6.4%。NCCL 的通信 kernel 还一直占着 SM,能让一个本来一轮就能跑完的矩阵乘慢 69%;TIDE 的 all-gather 完全不占 SM,reduce-scatter 只用几个只活零点几毫秒的线程块做 fp32 累加。通信快不快之外,数据摆放和抢不抢算力同样决定训练速度。用 FSDP2 多机训练大模型的团队值得读,训练 MoE 的尤其值得:MoE 每张卡要收发全部专家的参数,每个 token 却只用到其中一小部分,拷贝和抢 SM 这两笔开销占比最大。
它到底在解决什么问题?
问题出在 FSDP2 每次 all-gather 参数、reduce-scatter 梯度时的摆放顺序上。模型那边,每个参数是一块独立的连续内存,计算 kernel 要的就是这种样子。NCCL 那边,输入输出都是一整块缓冲区,先放 0 号卡的全部数据,再放 1 号卡的,以此类推。两种顺序不一样,FSDP2 只能在中间来回拷贝。
举个能手算的例子(示意):一层有 3 个参数,每张卡上的分片分别是 2、1、3 MB,共 4 张卡,每张卡的分片合计 6 MB。1 号卡上第 2 个参数那一片,在 NCCL 输出里排在第 6×1+2=8 MB 处;可第 2 个参数要拼成连续的一块,这一片应该放在 2×4+1×1=9 MB 处。位置对不上,就要再拷一次。
| 同一片数据(示意) | 在 NCCL 输出里的位置 | 参数需要它在的位置 |
|---|---|---|
| 1 号卡,第 2 个参数 | 8 MB 处 | 9 MB 处 |
| 2 号卡,第 2 个参数 | 14 MB 处 | 10 MB 处 |
反向更费事。梯度是一个个 bf16 张量,而论文测的配置都在 fp32 下做梯度加法,NCCL 的 reduce-scatter 又只能对一块同类型的缓冲区做。于是 FSDP2 先把所有梯度切开、补零、转成 fp32,拼成一块大缓冲区,大小是整组 bf16 参数的 2 倍。前向的拷回和反向的打包加起来,在 Llama-3.1 70B、每卡 8K token 的训练里每步要花 0.33 秒,占单步时间的 6.4%。
第二笔开销更隐蔽:NCCL 的通信 kernel 本身也要占计算单元,下面单独讲。
先看全景:TIDE 换掉了哪几步
TIDE 的核心思路是把“数据该放在哪”写进通信本身。通信直接从参数所在的位置读,直接写到参数最终要在的位置,中间不再经过按卡排序的大缓冲区。搬数据交给 GPU 上不占计算单元的硬件:拷贝引擎、跨机的 RDMA 网卡,以及机内的 NVSwitch,它能把一份数据同时写到多张卡,也能在芯片里直接做加法。计算单元只留给短时间的 fp32 累加。
| 步骤 | 原版 FSDP2 | TIDE |
|---|---|---|
| 前向 all-gather | NCCL 收进大缓冲区,再拷回各参数 | 拷贝引擎经 NVSwitch 直接写到各卡的参数位置,跨机走 RDMA,不用计算单元 |
| 反向 reduce-scatter | 梯度打包成 fp32 大缓冲区,NCCL 全程占着计算单元做加法 | 机内先由少量线程块加成 fp32,跨机只发加好的结果,最后一步加法交给 NVSwitch |
下面拆开讲:先讲为什么占计算单元这件事值得专门处理,再讲两种通信分别怎么做。
为什么通信 kernel 会让矩阵乘慢 69%?
GPU 上的 kernel 以线程块(论文叫 CTA)为单位分到 SM 上。高吞吐的矩阵乘每个线程块要用掉一整个 SM 的共享内存,而且线程块是 4 个一组成簇调度的。一张卡上能同时放下的簇有固定个数,放不下的就等下一轮,论文把这种一轮一轮的执行叫 wave。
论文的例子是一个 256×8192×8192 的矩阵乘,token 少时,MoE 专家层和窄投影层就是这种形状。它有 32 簇,这张卡最多放 33 簇,所以一轮跑完。NCCL 默认的 reduce-scatter(8 台机器、32 MiB 输出时)用 16 个线程块,也是 4 个一组,组成 4 簇,占掉 4 个位置:空余的 1 个和本该给矩阵乘的 3 个。矩阵乘只剩 29 个位置,32 簇放不下,多出来的 3 簇共 12 个线程块要等第二轮,矩阵乘慢了 69%。多出来的不是几个线程块的时间,而是整整一轮。
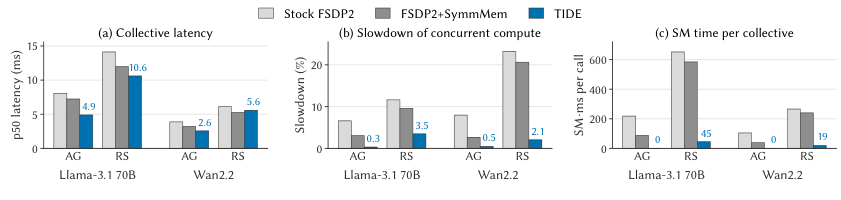
只给 NCCL 少分线程块也不行。限到 4 个线程块时,矩阵乘只慢 2.7%,但 reduce-scatter 本身从 6.75 ms 拖到 26.35 ms。TIDE 的训练配置用 16 个线程块做机内加法,4 个线程块负责最后一步,把跨机收到的部分和加进输出。这些线程块都是单个调度、不成簇,每个只活 0.2–0.4 ms,也不在 SM 上等网络。结果矩阵乘只慢 2.9%,reduce-scatter 用时 6.96 ms。这说明要看两件事:通信线程块会不会成簇占掉矩阵乘的位置,以及它们占着 SM 多久。TIDE 把等网络这件事挪出了 SM。
数据由谁发起、往哪个方向走也有影响。论文让同机另外 7 张卡对 0 号卡读写,0 号卡上跑一个吃显存带宽的 kernel:别的卡来拉数据时它慢 46.7%,别的卡往里推数据时只慢 12.1%。所以 TIDE 尽量用推,不用拉。
all-gather:参数直接落到最终位置
机内,每张卡用一次拷贝引擎操作,经 NVSwitch 把自己的分片同时写到 8 张卡上该参数的最终地址,不用挨个发 7 次。参数类型和通信类型一致时,参数分片只在第一次前向时拷进通信用的内存区一次,参数分片本身随后改为指向这块内存。优化器之后直接在这里更新,all-gather 每次原地读到的就是最新参数。
跨机时,各卡按编号分工:第 l 号卡只经自己的第 l 条网卡线路,和其他机器的第 l 号卡交换各台机器第 l 号卡的分片;收到的分片再由拷贝引擎经 NVSwitch 一次写到本机 8 张卡的参数位置。机器之间的交换顺序上,TIDE 不走环形传递,而是用递推倍增:第 d 轮(从 0 数起),第 n 台机器把手里已攒到的前 min(2^d, M−2^d) 份分片发给编号小 2^d 的那台,同时从编号大 2^d 的那台收同样多份,编号都按机器数 M 取模。前几轮每轮分片数翻倍;机器数不是 2 的幂时,最后一轮只补发还缺的那几份,不会收到重复的。这样 M 台机器只要 ⌈log₂M⌉ 轮,8 台机器 3 轮就够,环形要 7 轮。
多台机器同时往一台机器发,会引发 RDMA 网络拥塞。TIDE 让下一轮等接收方确认上一轮已经到达后才开始。为了不让等确认白白耗时,每次传输拆成开头一小段和剩下的部分(默认所有开头段加起来 8 MiB),接收方收齐开头段就发确认,确认在路上时剩下的部分还在传。论文测到,不加这个节奏控制,训练中交换机让发送方暂停的次数是原来的 9 倍,说明节奏控制省不得。
reduce-scatter:两级加法,最后一步交给 NVSwitch
反向这一侧更难,因为要做加法,而且必须保持 fp32 精度。论文先排除了一个看起来简单的做法:把梯度放进所有卡都能访问的一块内存,让 NVSwitch 直接加。用 bf16 存,NVSwitch 每次加完都会把结果舍入回 bf16,机器一多,小的梯度贡献可能被舍掉;用 fp32 存,就要常驻一块整组 bf16 参数 2 倍大的内存。
TIDE 把加法分成机内和跨机两级来做。第一级在机内:对每台目标机器,本机 8 张卡各负责一小段,其余 7 张卡用拷贝引擎把这段的 bf16 梯度推给负责的那张卡,那张卡用少量线程块把 8 份加成一份 fp32。这样每台机器对每个元素只往外发一个 4 字节的 fp32 部分和,而不是 8 个 2 字节的值,跨机数据只有原来的 1/4。
第二级在目标机器上。每张卡只连自己那条网卡线路,对面也只能落到同号的卡上。要让 NVSwitch 一次加完多台机器的部分和,同一小段来自不同机器的数据必须落在不同的卡、相同的地址上。TIDE 用拉丁方排座位:一张表里每一行、每一列,每台来源机器都只出现一次。具体做法在来源机器这边:对一台目标机器,每台来源机器有一个相对序号 c,等于目标机器编号减来源机器编号、再对机器数取余,目标机器自己记 0,所以同一台来源机器发往不同目标时,c 也不同。来源机器上第 j 号卡负责第 (j+c) mod 4 段(以 4 张卡为例),在机内加完后经第 j 条线路发到目标机器的第 j 号卡。
拿 4 张卡手算(论文图 6):目标机器是 D,来源 A、B、C 相对 D 的序号依次为 1、2、3,D 自己是 0。反过来看,第 s 段来自序号为 c 的机器,就落在第 (s−c) mod 4 号卡上。第 0 段里,D 落 0 号卡,A 落 3 号卡,B 落 2 号卡,C 落 1 号卡,四份正好分在四张卡上。NVSwitch 对这个地址做一次读加,就把四台机器的部分和加完了。目标机器上每张卡最终要的梯度各不相同,所以每份部分和里,这一段又按目标机器的卡分成小块,一张卡一块。每张卡上负责最后一步的那 4 个线程块只读加属于自己的那一小块,结果直接累加进本卡最终持有的 fp32 梯度分片。机器多于 8 台时分批,每批最多 8 台,收件区准备两套、轮流使用,大小不随机器数增长。
梯度什么时候能释放也要安排。TIDE 把“读梯度”和“等网络”分成两段:机内加法一做完,梯度就不再需要。In-Place 模式原地读梯度,下一层的 all-gather 可以提前发;Slot-Reuse 模式把梯度拷进刚空出来的 all-gather 位置,立刻释放原来的梯度内存,代价是下一次 all-gather 要等读完。
实验结果说明了什么?
实验在 8 台机器、64 张 GPU 上训练三个模型:稠密的 Llama-3.1 70B、MoE 的 Qwen3-30B-A3B,以及 Wan2.2 视频生成模型里一个 14B 的稠密扩散 Transformer。对照是原版 FSDP2(下称 Stock)和接入 PyTorch 对称内存的 FSDP2(下称 SymmMem),三者模型、精度、优化器、激活重算都相同。
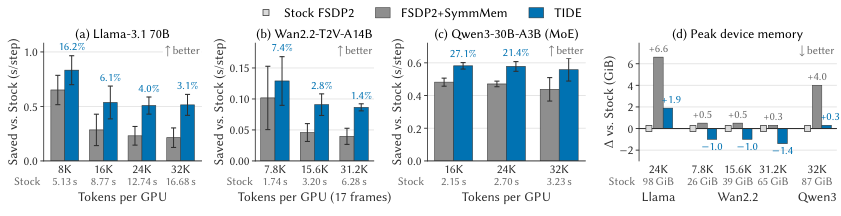
| 模型 | 每卡 token | TIDE 比 Stock 单步时间减少 |
|---|---|---|
| Llama-3.1 70B | 8K | 16.2% |
| Llama-3.1 70B | 32K | 3.1% |
| Wan2.2 | 7.8K | 7.4% |
| Wan2.2 | 31.2K | 1.4% |
| Qwen3-30B-A3B | 16K | 27.1% |
| Qwen3-30B-A3B | 32K | 17.3% |
每卡 token 越多,相对收益越小,但这不是 TIDE 变弱了。Llama 从 16K 到 32K,每步省下的绝对时间稳定在 0.51–0.54 秒,是 SymmMem 省下的 1.9–2.4 倍,只是单步本身变长了。论文给了一个估算:可以收回的开销占单步时间的比例,和参数总量成正比,和每个 token 激活的参数量乘以每卡 token 数成反比。这说明 MoE 最吃亏,因为每张卡都要收发全部专家的参数,每个 token 却只用到其中一小部分。Qwen3 上 TIDE 比 SymmMem 也快 4.3%–6.0%。
收益从哪来?只换 all-gather 拿到总节省的 50%(Llama 24K),只换 reduce-scatter 拿到 58%,两者加起来 108%,说明两部分基本各自独立、可以叠加。在 Llama 8K 的一张卡上,每步通信占用的 SM 时间从 Stock 的 78 SM·秒降到 3.8,有通信 kernel 驻留的时间从单步的 89% 降到 8%。
显存上,In-Place 模式在 Llama 24K 比 SymmMem 低 4.7 GiB,比 Stock 高 1.9 GiB;Wan 上 Slot-Reuse 比 Stock 还低 1.0–1.4 GiB。正确性方面,在 Qwen3-30B-A3B 上从头训 1000 步,以第一次 Stock 运行为基准,比较第 500–1000 步 50 步滑动平均的 loss:TIDE 最多差 0.73%,再跑一次 Stock 最多差 1.12%。这说明 TIDE 带来的差异落在正常的运行波动之内。
我认为它的局限
第一,稠密模型配长序列时收益很小。Llama 每卡 32K token 只省 3.1%,Wan 每卡 31.2K 只省 1.4%,如果你的训练本来就是长序列稠密模型,这笔开销本身就不大。
第二,硬件和软件门槛高。它要求 NVSwitch 能在交换芯片里做加法、每台机器最多 8 张卡、每张卡配一条对齐的网卡线路,还要 Hopper 及更新的 GPU(compute capability ≥ 9.0)、PyTorch 2.13 和 NCCL 2.31 以上,暂不支持 CUDA graph。FSDP2 把参数分组,每组一起做 all-gather 和 reduce-scatter。如果一组里可训练的参数超过 256 个(数的是 weight、bias 这样的参数个数,每个不论多大都只算一个),或者不满足上面这些条件,这一组就改用原版 FSDP2 通信,其余组照常走 TIDE。实验最多到 64 张卡,没有验证几百上千卡的规模。
第三,单独看 reduce-scatter 并不总是最快。论文表 8 里,2 台机器、32 MiB 输出时,TIDE 的中位延迟是 2.12 ms,SymmMem 是 1.27 ms。它在训练里赢,靠的是省掉布局拷贝和少占 SM 带来的重叠,不是每次通信都更快。代码也要等论文发表后才放出。
一个训练团队可以怎么试
做生成式推荐、大模型后训练的团队,如果用 FSDP2 在多机上训练,可以按这个顺序试:
- 先用 profiler 看一步里 split_with_sizes_copy 和 _chunk_cat 这两个拷贝 kernel 占多少时间,以及通信 kernel 驻留的时间比例。占比在几个百分点以上,才值得继续。
- 按论文的估算看自己的模型:参数总量越大、每个 token 激活的参数越少、每卡 token 越少,收益越大。MoE 模型优先试。
- 先切到 PyTorch 已有的 SymmMem 路径,成本最低,可以先拿到一部分 all-gather 的收益,也能确认集群的 NVSwitch 和 NCCL 版本是否满足要求。
- 代码放出后,在同一配置下跑两次 Stock 和一次 TIDE,比较 loss 曲线的差距是否落在两次 Stock 的差距之内,再看单步时间和峰值显存。
结论
FSDP2 的布局转换应该在通信里解决,而不是在通信前后各拷一次,同时要把通信从计算单元上挪开。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。拷贝和抢占计算单元在每步都发生,MoE 和短序列训练里占比明显 |
| 方法创新性 | 高。拉丁方摆放让 NVSwitch 一次加完多台机器的 fp32 部分和,设计很具体 |
| 实验证据 | 较强。三种模型、逐项拆分收益、loss 对照都有,但只到 64 张卡 |
| 工程成本 | 高。依赖特定硬件拓扑和新版 NCCL,代码尚未开源 |
| 是否值得尝试 | MoE 或短序列多机训练值得先 profile 再评估,长序列稠密模型优先级低 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…