
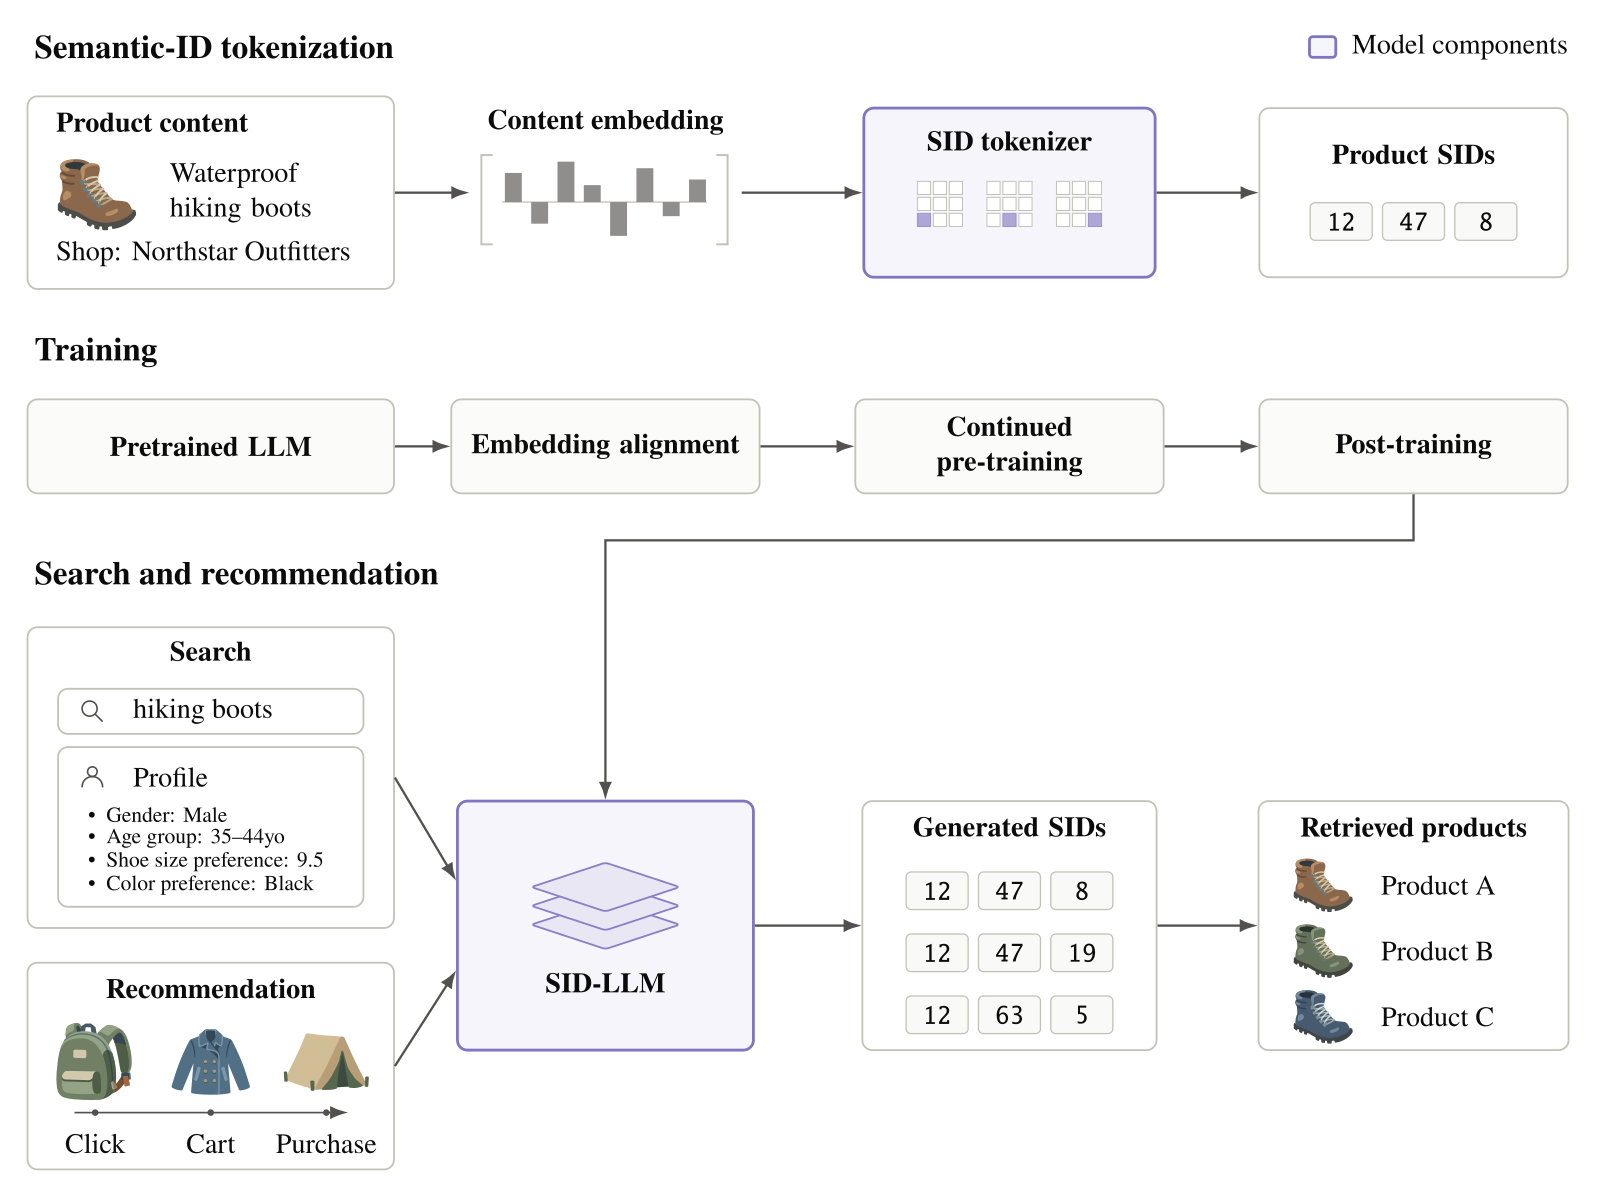
Shopify 要在多商家、目录持续变动的大规模商品集合上做检索,延迟还很紧。SID-LLM 的做法是:用 Shopify 自研的商品搜索 embedding 模型(768 维)给每个商品打出向量,再经残差量化 K 均值(RQ-KMeans)编成短的 Semantic ID(SID)。三个码本是残差式的:第一码本量化这条 768 维向量,第二码本量化残差,第三码本再量化剩下的残差,所以三码是逐层逼近同一条向量,而不是对同一向量做三次互相独立的量化。搜索和推荐都变成「根据当前上下文生成相关 SID」:搜索侧上下文是查询(可加买家画像),推荐侧是交互历史;训练时把上下文与目标商品的 SID 配对做下一 token 预测,推理时提供同样形式的上下文。生成结果再解析成可售商品交给下游排序。共享的是 SID 表示与联合预训练数据;线上搜索和推荐仍是两套分别预训练的模型、两套 serving 路径。
推荐侧:看它给候选池多贡献了什么
生成式召回很容易只报自己的 Recall@50。他们把生产池里每个生成器各取 top 200,用 leave-one-out 看拿掉谁之后池召回掉多少——增量池召回,数的是「只有它找到的成交」。持出周有购买的 70,747 名用户上,以 LFM2-2.6B(文中选用的 2.6B 参数 SID 生成骨干)为骨干的 SID-LLM:Recall@50 为 24.61%,增量池召回 2.65 个百分点,高于近期互动(1.64,按最近交互召回)和原子 ID 的 HSTU(0.78,用互不共享的商品编号做序列生成,而不是内容 SID)。因为增量口径问的是「它独自贡献了哪些成交」,所以它比单看自己的 Recall@50 更接近这个生成器在多路召回里的位置。
首页 feed 的 A/B 更直接:对照是未加入 SID-LLM 的首页,处理臂把 SID-LLM 候选加进候选池(并用联合概率解析)。在实际吃到这些候选的那部分首页流量上,归因订单 +7.95%、转化用户 +8.60%、转化率 +9.85%,均经 Dunnett 校正显著。不要说成全站。骨干选用 LFM2-2.6B,是因为它在对照过的一组模型里 p95 最低;Qwen3 系列平均质量更高,但延迟高很多。这支 LFM2-2.6B 是下游的 SID 生成模型,不是前面那个 768 维商品编码器。
推荐模型实际预测出的 SID 里,78.9% 被不止一个商品共享(就全部 SID 而言,约七成只对应一个商品)。联合概率解析把 beam 给出的 log p(SID|用户) 与簇内按流行度分配的 log p(商品|SID) 相加,每个 SID 最多贡献 10 个商品,取分最高的 200 个。相对「每个 SID 只解一个商品」,这一步让 Recall@50 相对提高 15.8%。推荐线上仍然走自回归解码,再加上这步解析。
三个码本是残差逼近,MTP 训练和推理怎么接上
搜索结果要用一套和普通 NDCG 不同的指标来读。OneDCG@10 先由大模型评审给每个返回商品打 0–3 的相关性等级,再加一个与查询无关的商品质量分(评分、热度、品牌、店铺销量等)。质量分 s 是评分、热度、品牌出现率和店铺销量这四个 0 到 1 信号的加权和,权重和为 1;增益按 100(2^{r+s}-1)/15 合成,s 最多相当于再升一级,所以增益落在 0 到 100。然后做折损累计增益,分母是「k 条结果都拿满分 100」时的常数 DCG。所以它量的是绝对相关性,分母不随这份列表本身变化。购买 Recall@10:转化会话里买到的商品有多少落在前 10。各表的评测协议(评审、查询集、索引)不同,绝对分数只在同一张表内可比。
生产选了每层 8192 个中心的 8192-8192-8192:更大的 32768-8192-8192 在 OneDCG 上更高,但第一码本变大后,生成时第一步要在更多中心上做选择,100 请求/秒时 p95 到 50 毫秒,他们留下延迟余量,才没有上更大的第一码本。
训练时,多 token 预测(MTP)从请求前缀单独预测三个码位各自的分布,码与码之间不互看;这和「按位自回归、后码看到前码」不是同一条计算图。推理时三个头并行给出分布,再在由目录 SID 构成、并带上请求市场资格约束的前缀索引上做 beam,只组装能解析到可售商品的 SID。因为训练已经不依赖码间自回归,推理才能把三个头并行跑完,再用目录索引把非法前缀剪掉。 Hoot 说

按位自回归(对照,示意)
- 第 1 码
- 只看请求前缀,选出 1
- 第 2 码
- 看见已经选出的 1,再选 2
- 第 3 码
- 看见 1-2,再选 0 或 3
- 目录怎么用
- 筛合法前缀会缠进每一步生成
后码依赖前码,三个头不能先全部并行跑完再筛选。
论文的 MTP
- 三个头读什么
- 都只看同一段请求前缀,互不读取
- 训练
- 三个分布一次给出,码与码之间不互看
- 推理
- 三头并行出分布,再在目录前缀索引上做 beam
- 示意结果
- 1-2-0、1-2-3 留下;前缀 1-0 被目录剪掉
正因为训练不依赖码间自回归,才可以先并行预测,再把非法前缀交给目录索引丢掉。
左右两栏走同一条示意请求和同一本小目录:合法 SID 只有 1-2-0 与 1-2-3,1-0 不是合法前缀。数字都是示意,用来对照“后码是否看见前码”;论文没有这一组码。
出处
论文:MTP 训练时从请求前缀单独预测三个码位分布、码间不互看;推理时三头并行,再在目录 SID(含请求市场资格)的前缀索引上做 beam,只组装能解析到可售商品的 SID。示意目录与码值为本文添加。搜索质量:MTP 单独不够,加上轻量 ranker 才站得住
在协议 E5 上:自回归按位出码,OneDCG@10 为 0.3083,购买 Recall@10 为 0.3246。MTP 单独看,OneDCG 大约 0.280、购买召回大约 0.284,加宽 beam 几乎不动;换来的是中位服务端延迟大约减半。搜索侧会先把每个生成的 SID 解析成该码下、按静态质量分最高的一件可售商品;再把这样得到的 250 个商品交给学习到的轻量 ranker(读查询 / 画像与候选)打相关性分,服务排序再把 ranker 分、与 OneDCG 里那个查询无关质量分同一算法的辅助分,以及生成器给该候选的对数概率(MTP 分)按 0.5 / 0.3 / 0.2 加权;三项都会先在当次请求的候选里做最小-最大归一化,尺度才对齐。这一步之后,同一协议下 OneDCG@10 到 0.3365、购买召回 0.3450,两项都超过自回归,并且在各百分位和负载下都更快——低负载时优势不大,高负载尾部差距拉开。因为辅助分和 OneDCG 里的质量分是同一套算法,购买召回是更独立的那一项。生产搜索走 MTP 加 ranker;推荐仍走自回归。
| 协议 E5 | OneDCG@10 | 购买 Recall@10 |
|---|---|---|
| 自回归 | 0.3083 | 0.3246 |
| 只跑 MTP(beam 100 / 250) | 0.2804 / 0.2811 | 0.2839 / 0.2840 |
| MTP + 轻量 ranker(250 个候选) | 0.3365 | 0.3450 |
这些数字说明:并行出码换来的延迟,要靠后接的轻量 ranker 才能把质量拉回自回归之上;只看 MTP 单独的 OneDCG,会把这个组合误读成「质量换速度」的退让。
换到另一套协议 E6 的搜索栈消融(不要和上面的 E5 绝对值横比):带上 SID-LLM 的完整栈 OneDCG@10 为 0.327(合并 = 不带买家画像的查询与带画像的个性化查询合在一起评)/ 0.357(仅带画像的个性化查询);去掉它——同时去掉它的候选和喂给排序的特征——掉到 0.306 / 0.330。单独 SID-LLM(自带 ranker,旁路其他召回以及完整栈里合并候选之后的两级学习排序 L2、L3)在合并设置下是 0.285,低于「无 SID-LLM 的完整栈」;在仅个性化设置下是 0.336,略高于后者。作者把后一项概括成「接近」,完整栈仍然最好。线上搜索做过系列 A/B,作者写结果支持上线;下文只引用文中给出的离线数字和推荐侧首页 A/B,不另写一个搜索总提升百分比。
训练上还试了统一学生
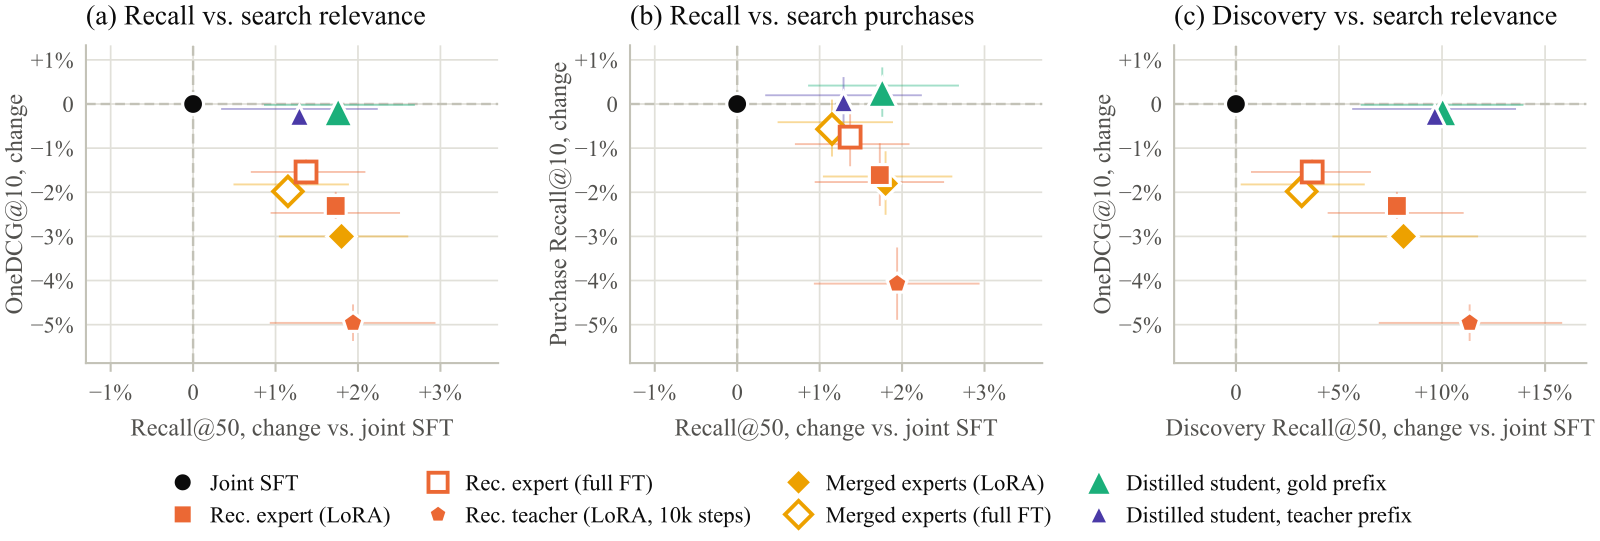
以联合监督微调为基线,再从同一个自回归持续预训练 checkpoint 分别训练搜索专家和推荐专家:推荐专家把 Recall@50 再提高约 1.7%,但搜索变差;搜索专家在搜索上没有可检出的优势,推荐却明显下降。路由多教师蒸馏(每个样本找对应专家,反向 KL 散度加上金标 SID 的交叉熵)做出的学生:相对联合监督微调,Recall@50 提高 1.76%,发现向 Recall@50(只计买家从未交互过的目标商品)提高 10.03%,两个搜索指标未检出变化——置信区间仍容许小幅下降。这是从同一个自回归持续预训练 checkpoint 初始化的实验学生;蒸馏与额外预算、教师选择并没有被写成互相独立的消融,生产 serving 仍是搜索走 MTP、推荐走自回归两套路径。「统一」首先指共享 SID 与联合预训练,其次才是这条蒸馏线。
离线还在同一持续预训练加 MTP 初始化、不加 ranker 的设置下比较了交叉熵、DPO、GRPO 等搜索后训练;GRPO 吃大模型评审反馈时 OneDCG 最高,购买召回可以下降——曝光偏差下,没展示过的相关商品成不了购买正例,作者也说这次下降不能说明替代品会带来更少成交。
这篇首先是一份工业系统报告:要从持续变动的多商家目录里做检索,并把搜索和推荐写成同一种 SID 生成。绝对离线分数绑在各自的评测协议上,E5 和 E6 不能横比。蒸馏学生是实验线,生产 serving 仍然分任务。文中没有另写一个可引用的搜索线上总提升百分比,推荐侧首页 A/B 则给出了受影响流量上的订单和转化数字。
该记住什么
SID 生成要在 Shopify 这种规模上站住脚,关键不只是「会生成 ID」。推荐看增量池召回和首页订单;搜索用 MTP 换延迟,再靠轻量 ranker 把质量拉回自回归之上。三个码本是残差逼近而不是三次独立量化;MTP 在训练里就不让码位互看,推理才能并行出码再用目录索引做约束。目录编码、联合预训练、任务蒸馏是同一条表示路上的零件;上线时搜索和推荐仍然可以、也确实分开服务。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…