目录 · 12 节
1它到底在解决什么问题?2整体流程3打分问句和打分头怎么出分?4混合架构上怎么让每条问句共享缓存?5一次读完会不会掉效果?6能一次读多少段?7选出来的段,生成模型用得上吗?8同一个模型怎么在排序和回答之间切换?9能不能连重读这一步也省掉?10我认为它的局限11一个搜索/RAG 团队可以怎么试12结论
RAG 系统通常要同时部署一个 reranker 和一个生成模型,候选段落被两个模型各读一遍。Glance 的思路是:生成模型反正要读这些段落,不如让它自己来排序。它把所有候选段落一次 prefill 进 KV cache,再从这份共享缓存上给每段接一小段打分提示,由一组 LoRA 参数和一个打分头给出相关度,然后关掉 LoRA,由同一个模型读选中的几段写答案,每多一种判断能力只多占约 0.1 GiB 显存。在 MS MARCO 上短暂微调后,它在 SciFact 上的 nDCG@10 是 0.741,专用 reranker bge-reranker-v2-m3 是 0.721。评测只覆盖两个检索集和一个模型家族,但少部署一个常驻模型,对服务成本的影响很直接。
做 RAG 服务的团队值得读这篇,因为它给出了一个能直接算账的部署方案:少一个常驻的 reranker 模型,排序质量不掉,答案质量还略好。代价也写得很清楚,按单条 query 的延迟算,在同一硬件上专用 cross-encoder 仍然快 10 倍左右。核心思想一句话:排序时全部候选段落只 prefill 一遍,打分靠每段一条约 30 token 的短问句(下文叫打分问句),问句的结果由一个小打分头读出来,答案仍由同一个 9B 模型来写。在 HotpotQA 上,用 Glance 选出的 3 段去回答,F1 比用 cross-encoder 选的 3 段高 0.045,而且这个差距在统计上站得住。候选数加到 200 段时,它的 nDCG@10 仍在上升,比 cross-encoder 高 0.058。
它到底在解决什么问题?
Glance 要省掉的是 RAG 链路里第二个模型。常见做法是 BM25 先召回 20 段,cross-encoder 把 query 和每一段配成一对、各算一个分,取前 3 段交给生成模型,生成模型再把这 3 段从头读一遍。下面对比两种链路处理一条问答 query 的方式(示意):
| 步骤 | 分开部署的做法 | Glance |
|---|---|---|
| 常驻显存里的模型 | reranker + 生成模型 | 只有生成模型,外加约 0.1 GiB 的小模块 |
| 20 段候选怎么读 | reranker 把 query 和每段配对,读 20 次 | 生成模型把 20 段连在一起读 1 次 |
| 怎么出分 | 每对一个分 | 每段接一条短问句,读出一个分 |
| 回答前 | 生成模型再读一遍前 3 段 | 同一个模型再读一遍前 3 段 |
表里“读 20 次”和“读 1 次”的区别,就是这篇论文的出发点。生成模型本来就要读段落,如果打分也能复用它读段落时算好的东西,就不必再常驻一个模型。难点有两个:一次读进 20 段之后,怎么给每一段单独出一个分;以及给模型加上排序能力后,它还能不能正常写答案。
整体流程
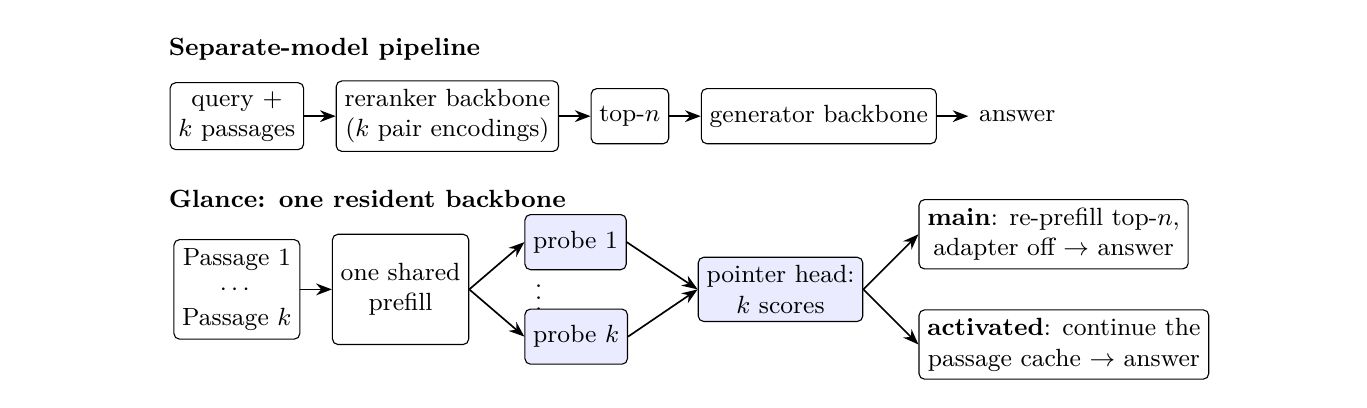
Glance 的流程分四步:
- 把 query 召回的 k 段按“[Passage 1] 段落 1 … [Passage k] 段落 k”的格式拼在一起,prefill 一次,得到一份共享的 KV cache。
- 从这份缓存的末尾分出 k 条短问句,第 i 条问的是“第 i 段里有没有能回答或支撑这个 query 的信息”。论文把这种短问句叫 probe,下面就叫打分问句。每条约 30 token,k 条放在一个 batch 里一起算,彼此看不到。
- 一个打分头(论文叫 pointer head,256 维)读出每条打分问句的结果,得到 k 个相关度分数,取前 n 段。
- 关掉 LoRA,同一个模型把前 n 段重新 prefill 一遍再写答案。另一种做法是直接接着第 1 步的缓存写答案,后面单独讲。
关键分工是:段落内容只算一次,每段的分各自算。20 段就是一次长 prefill 加 20 条短问句,而不是 20 次“query 加一段”的完整前向。
打分问句和打分头怎么出分?
Glance 给每段出一道是非题,“true”的概率就是这一段的相关度。读出方式沿用 Kev 运行时(论文引用的一套推理运行时)的“判断模式”:模型不生成文字,输入按固定格式排:先是共享内容,再是问题,然后把每个选项依次用 <opt> 和 </opt> 两个特殊标记包起来,最后放一个特殊标记 <decide>。<decide> 所在的位置就是模型给出判断的地方,下面叫判定位;每个 </opt> 是对应选项的结束标记。打分头是一个 256 维的小网络,输入是判定位的隐状态和每个选项结束标记的隐状态,输出是各选项上的一组 softmax 概率。论文只给出了这个打分头的输入和输出,没有展开它内部怎么比较两份隐状态。对是非题,选项就是 false 和 true。
举个例子(示意):20 段里第 7 段讲的是问题的答案,第 7 条打分问句读出 true 的概率是 0.92,第 12 段是不相关的同名人物,读出 0.08。按概率排序,第 7 段排在前面。整个过程不生成任何 token,一次判断的成本就是一次 prefill。
要训练的只有两样东西:一组 rank 16 的 LoRA 和这个打分头,9B 主干完全冻结。
为什么不让每段单独当一次输入、各问一次?这样做也能排序,论文把它作为对照组(叫 separate),但要读 20 次段落。为什么不干脆出一道选择题,把 20 段都当成选项,按每个选项的概率排序?论文也比了这种 listwise 做法,在 SciFact 上它明显更差(见下面的表)。打分问句的好处在于,每条问句都能看到全部 20 段,所以可以拿这一段和旁边的段比较。作者用这一点解释 NFCorpus 上一次读完反而比逐段单独问更好。
混合架构上怎么让每条问句共享缓存?
Glance 直接用 Kev 的共享前缀路径来处理混合架构,这是它能在这个 9B 主干上跑起来的工程前提。主干是 MiMo-V2.6-Distill-Qwen-9B,每 4 层里有 3 层是 Gated DeltaNet 线性注意力,1 层是普通的全注意力。全注意力层里,让每条打分问句只看共享部分、不看别的问句,用一个注意力 mask 就行。线性注意力层不一样,它只有一份顺着整段输入往前滚的循环状态,mask 管不住。
Kev 的做法是:共享部分算一遍,在末尾把每一层的缓存拷贝一份给每条打分问句当起点。全注意力层拷的是 key 和 value,DeltaNet 层拷的是卷积窗口和循环状态。这样每条打分问句的计算和“共享部分加这条问句单独跑一遍”完全一样。Glance 训练时也走这条路径,所以共享部分每条训练样本只算一次。
这个设计带来一个限制。DeltaNet 的循环状态按顺序概括了前面全部内容,没法像 KV cache 那样把单段的缓存按任意顺序拼起来。所以主流程里,选出的前 3 段(约 1.5k token)要重新 prefill 一遍再回答;另一个原因是共享部分是开着 LoRA 算的,不是原模型的缓存。
一次读完会不会掉效果?
第一组实验要回答:不做任何检索训练,一次读完 20 段的打分能不能接近逐段单独问。这里的 LoRA 只在通用判断数据(BoolQ、话题分类等)上训过 20 分钟,没见过任何检索数据,所以它的成绩说明的是这套打分方式本身的底子。
之后再在 MS MARCO 上训 39 分钟。每条训练样本是一个正例加 7 到 19 个 BM25 难负例,打乱后按一次读完的格式拼在一起,每条打分问句一个是非标签。BEIR 和 HotpotQA 都不参与训练,因此下面的成绩都是跨数据集的。下表是 BM25 前 20 段重排的 nDCG@10(论文表 2、表 3):
| 方法 | SciFact 未训练 | SciFact 训练后 | NFCorpus 未训练 | NFCorpus 训练后 |
|---|---|---|---|---|
| BM25 原顺序 | 0.662 | 同左(不训练) | 0.306 | 同左(不训练) |
| bge-reranker-v2-m3 | 0.721 | 同左(不训练) | 0.326 | 同左(不训练) |
| 同一 9B 模型逐段单独问 20 次 | 0.729 | 未重跑 | 0.323 | 未重跑 |
| Glance 一次读完 20 段 | 0.715 | 0.741 | 0.341 | 0.345 |
| Glance 共享部分只放 query、每条问句带一段 | 0.721 | 0.738 | 0.328 | 0.338 |
| Glance 一道选择题、20 段当选项 | 0.684 | 0.692 | 0.331 | 0.334 |
未训练时,一次读完在 SciFact 上比逐段单独问低 0.014,速度快 3.6 倍(614 ms 对 2210 ms)。这说明共享读入只付出很小的质量代价。这个加速比是在和别的任务共用的 GPU 上测的,在负载较低的 20 条试验里只快 2 倍,论文说比例随负载变化。训练 39 分钟后,一次读完在两个数据集上都略高于 bge-reranker-v2-m3,SciFact 高 0.020,NFCorpus 高 0.019,正好落在作者自己划的参考线上:约 300 条 query 下小于 0.02 的差距只能当参考,而且没做显著性检验。表里还有一种折中做法(论文叫 packed_q):共享部分只放 query,每条打分问句各自带一段,未训练时在 SciFact 上是 0.721,比一次读完略高。所以一次读完的好处在于每段只读一次、每条问句都能看到全部段落,而不是质量上处处领先。速度上 cross-encoder 仍然快得多:同在共享的 RTX PRO 6000 上,SciFact 每条 query Glance 要 614 ms,cross-encoder 只要 31 ms。
能一次读多少段?
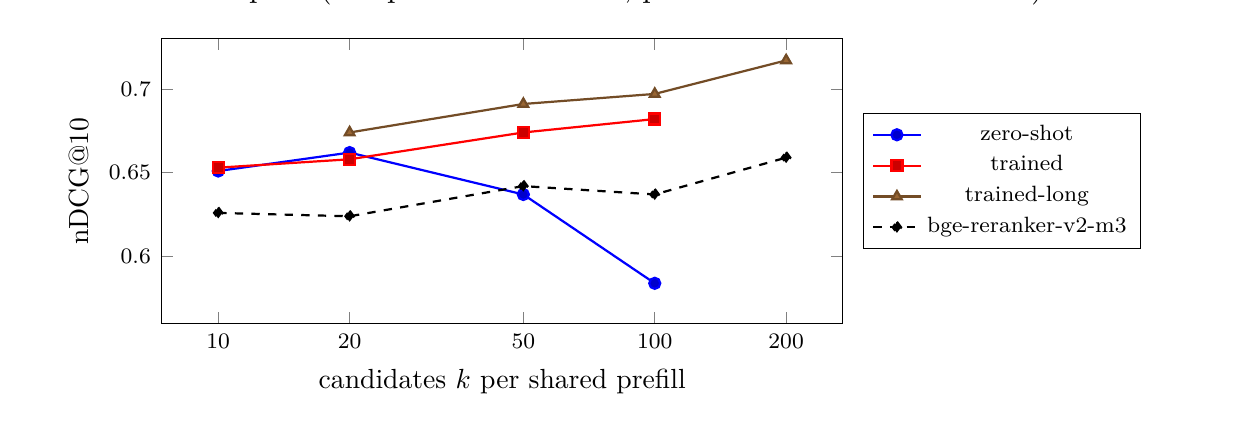
这组实验把段落截短到 100 词,k 从 10 加到 200。未训练的版本在 k=20 时最好,到 k=100 掉到 0.584,说明不经检索训练时一次读不了太多段。
训练过的版本只见过每条 8 到 20 段的样本,却在 k 从 20 到 100 的范围里随 k 增大一直变好。再用 20 到 80 段的样本多训 14 分钟(trained-long),k=100 时是 0.697,比同样 100 段的 cross-encoder 高 0.060;k=200(43.4k token)时是 0.717,cross-encoder 是 0.659。在这 100 条 query、100 词段落的子集上,训练让 k 到 100 都不再掉分,作者认为这说明段一多就掉分不是共享读入本身的上限。
成本也随之上去。k=100 时峰值显存 56.4 GiB,因为当前实现里每条打分问句都拷一份共享部分的缓存,显存按“候选数乘上下文长度”增长。k=200 一次放不下,要分几批跑打分问句,每条 query 约 15.8 秒。多条 query 拼成一个 batch 目前也帮不上忙,吞吐反而从每秒 2.87 条降到 1.57 条。
选出来的段,生成模型用得上吗?
这是我认为最有说服力的一组实验,因为它直接看最终答案,而不只看排序指标。HotpotQA distractor 每题给 10 段,其中 2 段是真正需要的。同一个 9B 模型先排序,再用前 3 段贪心解码写答案。表里最后一列是前 2 名的召回率(论文表 5):
| 交给生成模型的段落 | EM | F1 | 前 2 段的正确段落召回率 |
|---|---|---|---|
| 全部 10 段 | 0.533 | 0.716 | — |
| bge-reranker-v2-m3 选的前 3 段 | 0.503 | 0.684 | 0.863 |
| Glance(训练后)选的前 3 段 | 0.553 | 0.729 | 0.897 |
| 只给 2 段正确段落 | 0.607 | 0.789 | — |
表里“全部 10 段”和“只给 2 段正确段落”两行取自未训练版本的那次运行,作者说两次运行在相同条件下 F1 最多差 0.003。
Glance 和 bge-reranker-v2-m3 这两行都是关掉 LoRA 的原模型来回答,只有选出的段落不同,所以 F1 高出的 0.045 只能来自选段(配对 bootstrap 95% 置信区间 +0.014 到 +0.076)。未训练版本更有意思:它的前 2 段召回率只有 0.762,比 cross-encoder 的 0.863 低,但答案 F1 反而更高(0.718 对 0.683)。作者说这和“生成模型挑的是自己用得上的段”相符,但也明确说训练标签只是段落相关性,不能证明模型学会了按答案有用程度挑段。另外这一组未训练的差距不显著。
还有一个对照值得看:HotpotQA 每题只有 10 段,直接全给生成模型已经有 0.716,训练后 Glance 选的 3 段只比它高 0.013,cross-encoder 选的 3 段反而比不选更差。在这种短上下文任务上,Glance 的收益主要是避开了 cross-encoder 选段带来的损失。
同一个模型怎么在排序和回答之间切换?
LoRA 不合并进主干,排序时打开,回答时关掉,切换不改任何权重。20 次来回切换里,进入关闭状态约 11 ms,打开约 2.8 ms,每次打开时的打分概率逐位一致,每次关闭时的答案完全相同,显存一直是 16.77 GiB。论文还在同一个主干上挂了通用判断和排序两套 LoRA,加上原模型对话,三种模式按请求切换,两种判断模式的概率和单独加载各自的模型逐位一致,原模型对话的贪心输出文本也相同。每多一套判断能力约 0.1 GiB(LoRA 0.08 GiB 加打分头)。
LoRA 开着回答也会改变答案:在 HotpotQA 上答案更短(平均 2.5 词对 3.1 词),这正好贴合 HotpotQA 的短答案格式,未训练版本的 F1 因此升到 0.757。作者让 cross-encoder 选的段也用开着 LoRA 的模型回答,把答案风格的影响和选段的影响分开,Glance 选段仍高 0.055 F1,置信区间在零以上。排序专用的 LoRA 也会忘掉一些通用判断能力,在 JevBench(一个分易、原始、难三档的判断题基准)的 231 道题上,答对数从 184 道降到 175 道。
能不能连重读这一步也省掉?
主流程里 LoRA 在所有 token 上都开着,所以段落的缓存不是原模型的缓存,回答前要重读。Glance-Activated 改成读段落时关掉 LoRA,只在打分问句上打开。这样段落缓存就是原模型自己的,打完分可以直接接着这份缓存写答案。
同样训 150 步时,这个版本和全程开 LoRA 的对照组排序分数相近:SciFact 上是 0.740 对 0.744,NFCorpus 上都是 0.351。也就是说,在这组单种子对照里,只在打分问句上开 LoRA 没有看出排序能力的损失。
在 100 道 HotpotQA 题上,接着缓存回答的 F1 是 0.750,重读前 3 段是 0.754,两者基本持平;回答延迟从 181 ms 降到 138 ms,因为省掉了重读那一步。要注意的是,接着缓存回答时,生成模型看到的是全部 10 段,排序分数并没有替它挑段。这一组只有 100 题、单个随机种子。
我认为它的局限
第一,比速度 Glance 吃亏。同在 B200 上、HotpotQA 每题 10 段时,训练后 Glance 排序要 274 ms,bge-reranker-v2-m3 只要 24 ms。作者的延迟来自没有优化的 eager 实现,GPU 还和别的任务共用,但目前的数字只支持“省显存、省一个模型”,不支持“更快”。
第二,打分受段落顺序影响。每条打分问句都能看到全部段落,BM25 原顺序加 4 种随机顺序,nDCG@10 在 0.678 到 0.693 之间。单段概率的变化多数很小,中位数只有万分之一,但最多能变 0.36。对单段分数做阈值过滤的场景要先测这一点。
第三,证据面窄。只有一个混合架构的 9B 主干、两个 BEIR 数据集、一个问答集,每个都是几百条 query。vLLM 上的服务路径还是原型:同样 400 条打分问句,vLLM 给出的 true 概率和原实现平均差 0.006,有 4 条的是非结论和原实现相反。
一个搜索/RAG 团队可以怎么试
- 先用公开的 LoRA,在自己的召回结果上离线比一次:同一批 query 取前 20 段,比较 Glance 和现有 reranker 选出的前 3 段,看召回率和最终答案质量。判断标准是答案质量,不只是召回率,因为论文里未训练版本召回率更低、答案 F1 却更高,召回率和答案质量不一定同向。
- 测顺序敏感性:每条 query 除了原来的召回顺序,再随机打乱 4 次,统计打乱后排第一的段和原顺序下排第一的段相同的比例。论文在 100 条 SciFact query 上测出来是 91%。不稳定就对这 5 种顺序的分数取平均。
- 按自己的 k 和段长测显存和延迟。论文里 100 词的段落、k=20 时峰值显存约 17 GiB,k 到 100 会涨到 56 GiB,这决定了排序时的缓存峰值能不能放进生成服务原本的显存余量里。
- 前三步都过了,再试 Glance-Activated 接着缓存回答,确认生成模型看到全部候选段时答案不变差。
结论
最关键的启发是:生成模型读段落时的计算可以和排序共用,只要加一组小 LoRA、每段一条打分问句和一个打分头,就能给段落排序,不必再常驻一个 reranker。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。RAG 服务里 reranker 是常驻成本,能省掉一个模型对显存和运维都直接 |
| 方法创新性 | 中。共享读入的运行时来自 Kev,本文的贡献是把它用在 RAG 里、训成生成模型自带的 reranker |
| 实验证据 | 中。HotpotQA 上有配对置信区间,检索集差距没做显著性检验,只有一个主干 |
| 工程成本 | 中。不用新模型,但显存随候选数快速增长,同一硬件上单条 query 延迟约是 cross-encoder 的 10 倍 |
| 是否值得尝试 | 值得离线试。显存紧、已经在跑同类开源主干的 RAG 服务最适合 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…