 已录用 ICML 2026

CLIP 这类检索模型遇到中文 query、长文本 query 或图文组合 query 时效果明显下滑,可重训检索器、重算整库向量又太贵。这篇论文不动检索器,只训练一个大模型来改写 query,并用 GRPO 把检索排名直接当作改写的奖励。作者发现,如果奖励只看改写后的 query 和正确结果有多相似,模型会学会把所有候选的分数一起抬高,无关结果也跟着变高。改成看正确结果在整个语料里排第几,这个问题就消失了。在多语言、长文本和组合图像检索的五个基准上,Recall@10 平均比不训练的大模型改写高 4.9 个百分点,3B 的改写模型在两个基准上还超过了直接拿 GPT-5.4 来改写。
做检索的团队值得读这篇,主要是因为它把“改写模型该学什么”说得很清楚:奖励要看排名,不要看分数。分数涨不代表排名涨,这一点在任何“用检索结果当奖励”的训练里都会遇到,不只限于图片检索。它的证据也比较扎实:三种 CLIP 尺寸、五个基准全部有提升,还专门画了用相似度当奖励时分数一路上涨、Recall@1 一路下滑的训练曲线。代价是每条 query 在线上都要先过一遍 3B 模型,延迟要自己算。
它要解决什么问题?
CLIP 在英文短描述上训练,查询一旦换了样子,效果就掉得很厉害。论文覆盖了三种常见的偏移,下面用一个图库搜索的例子说明(示意):
| 用户输入 | 偏移类型 | 直接丢给 CLIP 会怎样 |
|---|---|---|
| “投手正在把球扔出去”(中文) | 语言不同 | 英文 CLIP 读不懂中文,多语言版本也常常抓不到“投手”这类实体 |
| 一段 600 多词的维基百科词条 | 长度不同 | 文本编码器只吃前 77 个 token,关键信息常常落在后面被截掉 |
| 一张红色连衣裙的图 + “换成蓝色、短袖” | 模态不同 | CLIP 不接受图文混合输入,必须先把它变成一段文字 |
解决办法通常有两种。第一种是扩充训练数据、微调检索器,但要重新给整个语料库算向量,上线也要整体替换,成本很高。第二种是在检索器前面加一个大模型,把 query 改写成 CLIP 熟悉的样子,比如翻译成英文、压缩成短描述。第二种便宜,但大模型并不知道 CLIP 喜欢什么样的输入:它写出来的东西在人看来通顺,在 CLIP 的向量空间里未必找得准。表格后面的数字会说明,在维基百科长文本上,直接用大模型改写,Recall@10 反而比原始 query 低。
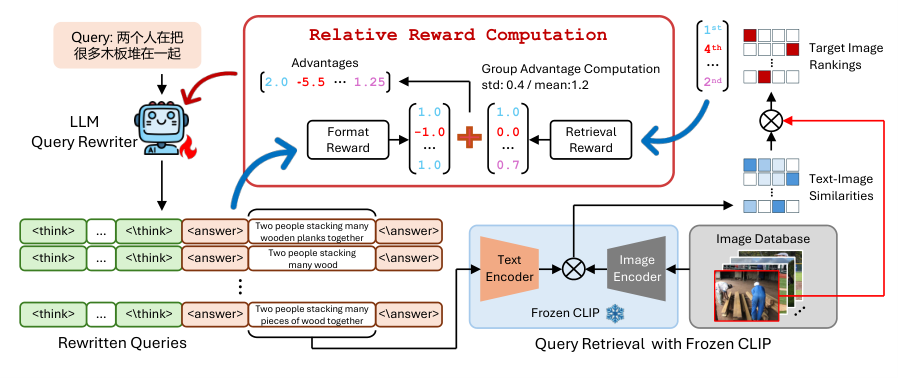
论文的方法 GRAPE 选第二条路,但补上了缺失的那块:让冻结的检索器告诉大模型,哪种改写真的把正确结果排到了前面。
整体流程
| 步骤 | 做什么 | 谁在变 |
|---|---|---|
| 1. 采样改写 | 改写模型(Qwen2.5-3B-Instruct,组合检索用 Qwen2-VL-7B)对同一个 query 生成 K 个改写,默认 K=8 | 改写模型 |
| 2. 格式检查 | 推理过程必须放在 think 标签里、最终改写放在 answer 标签里;格式不对直接给 -1 分,不进检索 | 无 |
| 3. 检索打分 | 每个改写用 CLIP 文本编码器编码,和预先算好的整库图片向量比相似度,得到正确图片排第几 | CLIP 冻结 |
| 4. 排名奖励 | 排第 1 得 1 分,排最后得 -1 分,中间线性分布 | 无 |
| 5. 组内比较 | 8 个改写的总分减去组平均、除以组标准差,作为每个改写的优势值 | 无 |
| 6. 更新 | 按优势值加权更新改写模型,同时用 KL 项拉住它别离原模型太远 | 改写模型 |
训练只跑 1,500 到 2,500 步,学习率 5e-7,批大小 8。整个过程中 CLIP 的两个编码器和语料向量都不动,所以训练完的改写模型可以直接插到现有检索系统前面。
关键机制:为什么奖励要看排名
最直接的奖励是相似度:改写后的 query 和正确图片越像,分越高。论文发现这条路会走偏,作者把这种现象叫作“分数膨胀”。
先看一个具体例子(示意)。语料里有 1,000 张图,query 是“一个男孩在海边放风筝”。改写模型试了两种写法:
| 改写 | 和正确图片的相似度 | 和其他图片的平均相似度 | 正确图片排第几 | 相似度奖励 | 排名奖励 |
|---|---|---|---|---|---|
| A:“男孩,沙滩,风筝,蓝天” | 0.31 | 0.18 | 3 | 0.31 | 0.996 |
| B:A 加上“真实世界环境,氛围感” | 0.34 | 0.27 | 40 | 0.34 | 0.922 |
改写 B 加了几个“万金油”词,和正确图片更像了,但和其他图片也一起变像,正确图片被挤到第 40 名。相似度奖励给 B 更高分,排名奖励给 A 更高分。如果用相似度训练,模型会越来越喜欢往 query 里塞这类词。
论文附录给了一个直观的解释。每张图片的向量可以拆成两部分:整个语料共有的“平均图像”部分,加上这张图自己独有的部分。query 和图片的相似度也就拆成两项:query 和平均图像的相似度,加上 query 和独有部分的相似度。第一项对所有图片都一样。相似度奖励会鼓励模型把第一项做大,这最省事,但对区分图片毫无用处。排名只取决于正确图片比其他图片高多少,第一项在相减时直接抵消,模型只能去抓正确图片独有的特征。
排名奖励的公式很简单:正确图片排第一时得 1 分,排最后时得 -1 分,中间按名次线性分布。这样设计是为了让每前进一名奖励都会变化,模型哪怕只把正确结果往前挪一位也能得到反馈。
这里有个容易被忽略的细节:GRPO 本身就在组内做了标准化。附录证明,奖励只要是排名的线性函数,标准化之后的优势值就只取决于 8 个改写之间的相对名次,和具体用哪个线性映射无关。另一个好处是数值稳定:训练中后期 8 个改写往往很接近,相似度可能都挤在 0.30 到 0.31 之间,除以一个接近零的标准差会放大噪声;排名是离散的,只要名次有一点差别,信号就清楚。
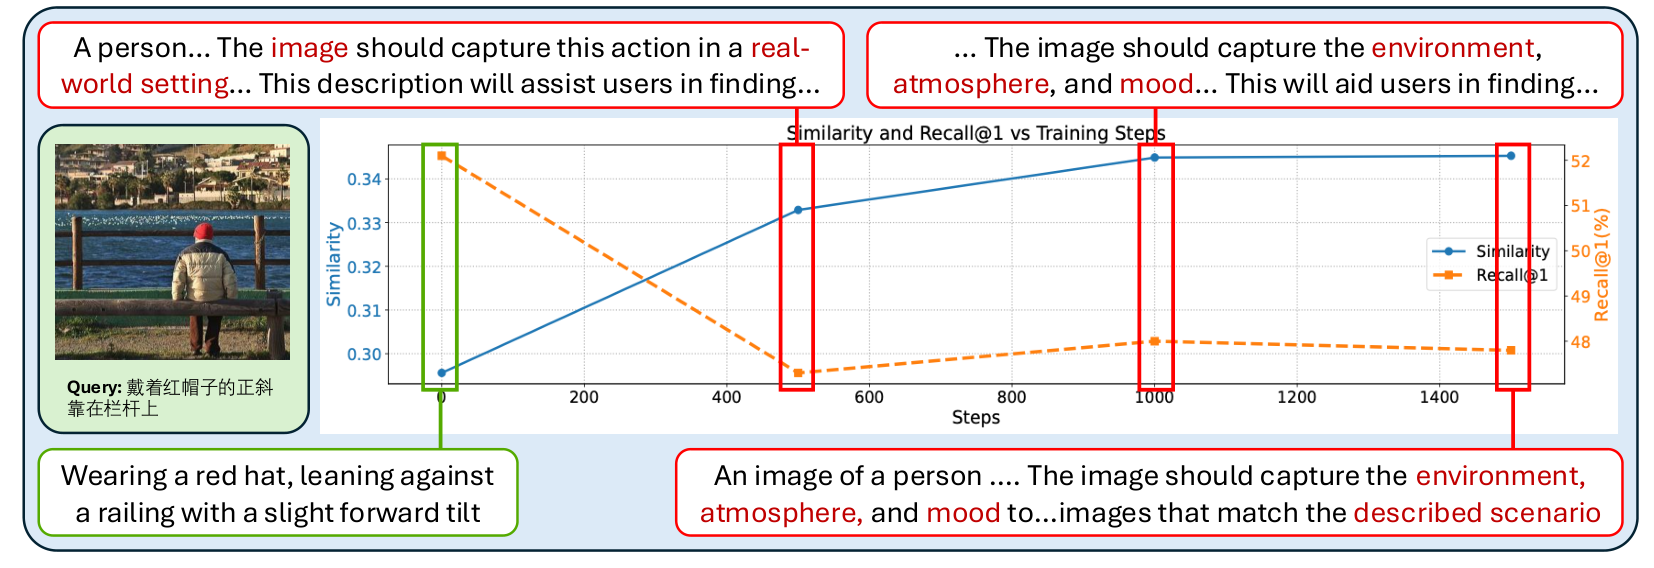
图 5 是这件事的实测。在 Flickr30k-CN 上用相似度当奖励,平均相似度随训练单调上升,Recall@1 一路下跌,改写里开始出现“real-world environment”“atmosphere and mood”之类的词。换成排名奖励后,召回率稳定上升。
实验结果
五个基准分别对应三种偏移:Flickr30k-CN 和 CVLUE(中文视觉语言评测集)是中文图文检索,XM3600(谷歌的 36 语种图片描述集)是多语言检索,Wikipedia 是长文本,CIRR(组合图像检索数据集)是“参考图 + 修改说明”的组合检索。下面是 ViT-B/16 版本 CLIP 的结果(Recall@1 / Recall@10,%),短横表示 CLIP 不能直接处理这种输入:
| 基准 | 原始 CLIP | 大模型直接改写 | GRAPE | GRAPE 比直接改写 |
|---|---|---|---|---|
| Flickr30k-CN(中文) | — | 52.1 / 86.0 | 58.0 / 90.0 | +5.9 / +4.0 |
| CVLUE(中文) | — | 12.1 / 42.0 | 14.6 / 48.7 | +2.5 / +6.7 |
| XM3600(多语言) | 12.3 / 26.8 | 52.9 / 78.9 | 58.4 / 83.1 | +5.5 / +4.2 |
| Wikipedia(长文本) | 33.5 / 71.9 | 34.3 / 69.3 | 43.7 / 82.8 | +9.4 / +13.5 |
| CIRR(组合检索) | — | 30.7 / 73.3 | 35.7 / 77.8 | +5.0 / +4.5 |
| 平均 | 22.9 / 49.4 | 36.4 / 69.9 | 42.1 / 76.5 | +5.7 / +6.6 |
这张表里提升最大的是长文本:直接改写在维基百科上 Recall@10 比原始 query 还低 2.6 个点,GRAPE 则高出 10.9 个点,说明大模型不知道 CLIP 喜欢什么输入时,改写甚至会帮倒忙。
换检索器尺寸,结论也不变:在最大的 ViT-L/14 上,平均 Recall@10 依然从 71.9 升到 76.8,所以检索器变强后改写仍有用。CVLUE 是反例,Recall@1 只有 14.6%,意味着改写能缩小语言差距,但检索器本身分不清的图它也救不了。
长文本那一项有个对照实验很有说服力。有人可能会问:GRAPE 是不是只是把 query 写短了?作者让大模型直接按“尽量压缩”来改写,平均 35.7 个词,比 GRAPE 的 45 个词还短:
| 方法 | 平均词数 | Recall@1 / Recall@10 |
|---|---|---|
| 原始 query | 533 | 33.5 / 71.9 |
| 大模型改写 | 91 | 34.3 / 69.3 |
| 大模型强制压缩 | 35.7 | 34.8 / 73.7 |
| GRAPE | 45 | 43.7 / 82.8 |
光是写短只带来约 1 个点,GRAPE 多出的 9 个点来自它学会了留下哪些词:可见的实体、颜色、动作,而不是背景介绍。
和更大的现成模型比,在同样提示下,GRAPE 在 Flickr-CN 上是 58.7 / 90.1,Claude-Sonnet-4.6 是 56.2 / 91.3,GPT-5.4 是 56.2 / 89.0;在维基百科上 GRAPE 是 43.7 / 82.8,两个大模型分别是 36.9 / 73.9 和 38.4 / 78.4。也就是说,一个按检索器口味训练过的 3B 模型,比不知道检索器口味的大模型更有用。
训练数据不必很多:Flickr30k-CN 只用约 1 万条(全量的十分之一),就能拿到全量训练 94% 的 Recall@1,说明几千到一万条带正确答案的 query 就够起步。
组大小 K 也不敏感,从 2 改到 8,Flickr30k-CN 上 Recall@1 只差 0.9 个点,因为排名奖励是离散的,组里只要名次有差别就有信号。
我认为它的局限
第一,线上延迟这一项没有量化。每条 query 都要先让 3B 模型生成一段推理和一个改写,推理过程放在 think 标签里,长度不受控。对图库搜索这类能容忍几百毫秒的场景问题不大,但对要求几十毫秒响应的搜索框,这一步可能比检索本身慢一个数量级。作者在讨论部分自己承认了这一点,提到可以蒸馏成更小的模型,但没有给数字。
第二,训练要求每条 query 都有已知的正确结果。五个基准都是一条描述对应一张图,排名奖励很好算。真实系统里一个 query 往往有多个相关结果,或者只有点击日志这种带噪声的标签,奖励怎么定义、噪声会不会被模型钻空子,论文没有覆盖。
第三,天花板由检索器决定。CVLUE 上 GRAPE 把 Recall@1 从 12.1% 提到 14.6%,提升 2.5 个点,但绝对值依然很低。改写只能把 query 挪到检索器熟悉的区域,检索器本身分不开的两张图,怎么改写都分不开。附录里 36 种语言的结果也显示,低资源语言上提升有限,因为改写模型自己就不太懂这些语言。
一个检索团队可以怎么试
- 先确认问题出在 query 侧:从线上抽一批失败的 query,看是不是集中在某种偏移上,比如长文本、外语或图文混合;如果失败分散在各种 query 上,问题更可能在检索器本身。
- 用现成大模型做零样本改写,量一下 Recall@10。这一步决定了上限的起点,也是之后对比的基线。
- 准备几千到一万条有正确结果的 query,按论文的数据量,这已经够拿到大部分收益。用冻结的线上检索器给每个改写算排名,奖励用排名,不要用相似度。
- 训练时同时监控两条曲线:正确结果的平均相似度和 Recall@1。如果前者涨、后者跌,就是分数膨胀,说明奖励设计有问题。
- 上线前量端到端延迟。如果改写太慢,先试只对命中某类偏移的 query 做改写,或者把推理部分去掉、只保留最终改写。
一句话结论
用检索结果训练改写模型时,奖励要看正确结果排第几,而不是它的分数有多高:分数可以被万金油词整体抬高,排名不会。
| 维度 | 判断 |
|---|---|
| 问题重要性 | 高。检索器冻结、语料巨大的系统很常见,改 query 是成本最低的入口 |
| 新意 | 中。用 GRPO 训练改写模型不算新,把奖励从分数换成排名并讲清楚原因是主要贡献 |
| 证据强度 | 中高。三种检索器、五个基准一致提升,有分数膨胀的训练曲线和强制压缩的对照 |
| 工程成本 | 中。训练只要几千步,但线上每条 query 都多一次大模型调用 |
| 值不值得试 | 值得。特别是长文本或跨语言 query 多的检索系统,可以先用小规模数据验证 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…