 已录用 NeurIPS 2026

用大模型做推荐的团队可以读一读:它不训练模型,只改画像怎么构建、在哪一步用、什么时候修正,就拿到了明显提升。用大模型做推荐时,常给用户写一段画像,物品却没有对等的描述;用户画像只塞进重排提示词,和别的内容抢长度;画像写好后也不再修正。HARP(本文提出的方法)不训练参数,补了这三处。它让物品也有一份画像,同样分偏好、品质、场景、受众四栏,用规则从元数据和评论里填。重排前,原有方法会按行为相似度挑一批用户和物品当协同邻居,把它们的文字记录送进重排提示词。HARP 按画像相近程度给这些邻居的分数打折,画像越不像,打折越多,越难入选。预热时,拿用户最近一条历史交互试推一次,记下推没推中,再让大模型据此反思,写出或改写画像。四个公开数据集上,Hit@1 比最强的已发表基线高 6.9% 到 24.0%,消融显示给邻居加权贡献最大。
我的判断:这篇最值得看的不是“双画像”这个说法,而是一个具体的工程结论:画像放进提示词里几乎没用,拿去筛邻居才有用。理由是作者的消融把这两条路分开测了,差距很清楚。需要打折扣的是,主表的基线数字抄自原论文,没有在同一套代码里重跑。
它到底在解决什么问题?
论文针对的是一类基于大模型代理的推荐方法。每个用户和物品都有一个代理,代理会存一段由大模型维护的自由文本,记下这个用户或物品的情况,论文叫记忆。推荐分两步。第一步挑协同邻居:每个用户事先有一个邻居池,里面是相近的用户和物品,各带一个行为相似分。从池里按分数取前 k 个。邻居池和行为相似分沿用原有方法,论文没有给出行为相似分的公式。第二步把这些邻居的记忆拼进提示词,交给一个冻结的大模型,给候选列表重新排序。完整的 HARP 还会把用户画像写进重排提示词;物品画像只用来算相近度、筛邻居。候选列表由评测协议给定,HARP 不负责召回候选。
下面是一个示意,说明行为相似的邻居为什么会带偏。假设用户的请求是“今晚找个地方吃饭”:
| 邻居(示意) | 行为相似分 | 和用户画像像不像 |
|---|---|---|
| 一家川菜馆 | 0.8 | 像:用户常去川菜、夜宵 |
| 一家婚纱摄影店 | 0.8 | 不像:只是同一商圈,被同一批人点过 |
只看行为,两个邻居分数一样,都会把自己的记忆送进提示词。婚纱店的记忆对“今晚吃什么”没有帮助,还占掉提示词长度。作者把这类邻居叫跨品类的误导邻居。
作者认为现有做法有三个缺口。第一,只有用户有画像,物品没有对等的描述,没法比较两边像不像。第二,用户画像只进重排提示词,而提示词长度有限,画像多占一点,邻居记忆就少一点。第三,画像在预热时写好,之后不再根据推荐结果修正。
整体流程
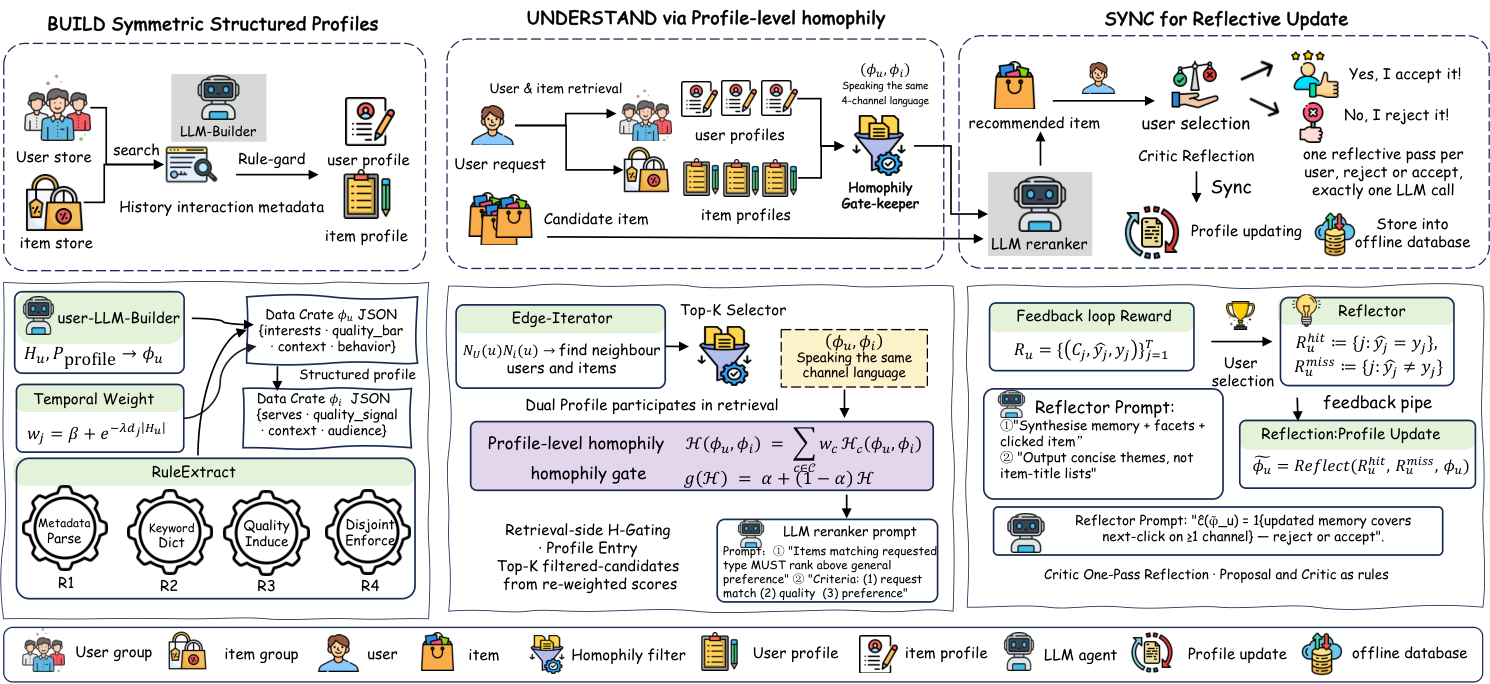
HARP 不训练任何参数,在冻结的大模型外面加了三个部件,各补一个缺口:给物品也建画像;用画像相近程度给邻居重新打分;预热时反思一次,改写用户画像。下面逐个讲。
物品画像:不调大模型,用规则填
用户画像由一次大模型调用读历史生成。主实验里,这次调用就是后面讲的预热反思。越近的历史保留的细节越多,越早的压缩得越狠。生成的画像有七个字段,HARP 只用其中四个和物品对得上的字段,叫四个栏:偏好、品质、场景、受众。
物品画像用同样的四栏,但完全不调用大模型。它按规则从元数据和评论里抽短语,每个数据集各有一份短语词表。比如一家餐馆的“偏好”栏写它供应什么,“品质”栏根据星级和评论数给出一个品质标签。这样一来,用户的“爱吃川菜”和餐馆的“供应川菜”就能放在同一栏里比较。
用画像相近程度给邻居打折
两边都有画像后,HARP 算一个相近度,论文叫 homophily(同质性)。偏好和受众两栏都是短语,就看用户的短语有多少被物品的短语提到,算一个比例。品质栏比的是物品的品质标签能不能达到用户写的门槛,比如几星以上。场景栏看地点和场合短语对不对得上:对上算 1,对不上算 0。比如用户偏好栏有三个短语:川菜、夜宵、小份,餐馆提到了川菜和夜宵,这一栏就是 2/3。
比例的分母是用户的短语数,所以它问的是:用户在乎的东西,物品提到了多少。四栏加权求和得到总相近度 H。偏好栏通常占一半或更多,其余三栏平分剩下的权重;这些权重是固定的超参数,没有按评测指标调。用户和用户之间不用四栏,只看两人偏好栏的短语重合多少,论文没有给出这一项的具体公式。
然后在取前 k 个之前,用相近度给原有方法算出的行为相似分打折:新分数 = 行为相似分 × (α + (1 − α) × H)。α 是一个下限,用户和物品之间取 0.4,用户和用户之间取 0.3,保证行为信号不会被完全清零。
回到上面的例子。两个邻居的行为分都是 0.8。川菜馆的 H 是 0.9,新分数是 0.8 × (0.4 + 0.6 × 0.9) = 0.752。婚纱店的 H 是 0.2,新分数是 0.8 × (0.4 + 0.6 × 0.2) = 0.416。这说明,同样的行为分,画像不像的邻居会被压下去。所以按新分数取出的前 k 个就换了一批,重排模型看到的记忆也跟着变了。 Hoot 说

- 示意:川菜馆系数=0.4+0.6×0.9=0.94,新分数=0.8×0.94=0.752
- 示意:婚纱店系数=0.4+0.6×0.2=0.52,新分数=0.8×0.52=0.416
两个邻居的行为分一样。画像一比,川菜馆像,婚纱店不像。打折系数从 0.4 起步,画像越像越接近 1。婚纱店的分数掉了将近一半,进不了前 k 个。它的记忆也就不会进提示词。下方的数字是示意。
出处
论文 §3.3 式 7:新分数=行为分×(α+(1−α)×H),用户与物品之间 α=0.4作者解释了为什么画像要用在筛邻居这一步,而不是直接写进提示词。一是提示词长度有上限,一旦占满,画像多一个词,邻居记忆就少一个词。二是重排模型冻结,学不会怎么平衡这两类信息。三是邻居选错了,提示词里写得再好也很难把正确答案推上来。
预热时反思一次
每个用户在测试前有一次预热。系统把测试物品之前的那一条历史交互当成一道练习题,完整跑一遍推荐,看能不能推中它,记下结果。主实验里,这时用户还没有画像。按论文的规则,一边画像为空时相近度记为中性的 0.5,画像在这一遍里起不了区分作用。这条交互本来就在用户历史里,不是测试时要猜的那一条。然后调用一次大模型反思。它拿到压缩后的历史、已有的画像(如果有),以及这次试推的候选列表、推荐结果和用户实际选的物品,据此写出或改写画像。
整个过程每个用户只做一次,不会在每次交互后都更新。
实验:哪个部件在起作用?
实验用四个公开数据集:Amazon Books、Goodreads、MovieTV 和 Yelp,重排模型是冻结的 gpt-4o-mini,每次取 16 个邻居。和最强的已发表基线 MemRec 比,Hit@1 在 Books 上相对高 6.9%,在 Goodreads 上高 17.2%,在 Yelp 上高 24.0%。这些是相对提升。Yelp 和 Goodreads 提升最大,作者认为这两个数据集只靠行为信号最弱,按画像筛邻居最有用。但这和作者自己的消融对不上:Goodreads 上筛邻居这一步的收益是四个数据集里最小的。
Yelp 上的提升随着评测看的名次变多而缩小:Hit@1 高 24.0%,Hit@3 高 14.3%,Hit@5 高 9.4%。这说明 HARP 主要是把正确答案从前几名推到第一名。
消融更能说明问题。作者在 Yelp 的 1000 个用户上比较了五种配置:
| 配置 | 物品画像 | 画像筛邻居 | 画像进提示词 | 预热反思 | Hit@1 |
|---|---|---|---|---|---|
| Memory(原始做法) | 无 | 无 | 无 | 无 | .580 |
| Monologue | 无 | 无 | 用户画像 | 无 | .578 |
| Consult | 有 | 无 | 两边画像 | 无 | .580 |
| Dialogue | 有 | 有 | 无 | 无 | .635 |
| HARP | 有 | 有 | 有 | 有 | .643 |
只把画像写进提示词,Hit@1 不动:Monologue 和 Consult 都停在 .578 到 .580,和 Memory 一样。一旦用画像筛邻居,Dialogue 跳到 .635,比 Monologue 高 5.7 个百分点,配对检验显著。更干净的对照是 Consult 和 Dialogue:两边画像都有,只差画像用在提示词里还是用来筛邻居,Hit@1 差 5.5 个百分点,同样显著。提示词注入和预热反思加在一起,只再多 0.8 个百分点。
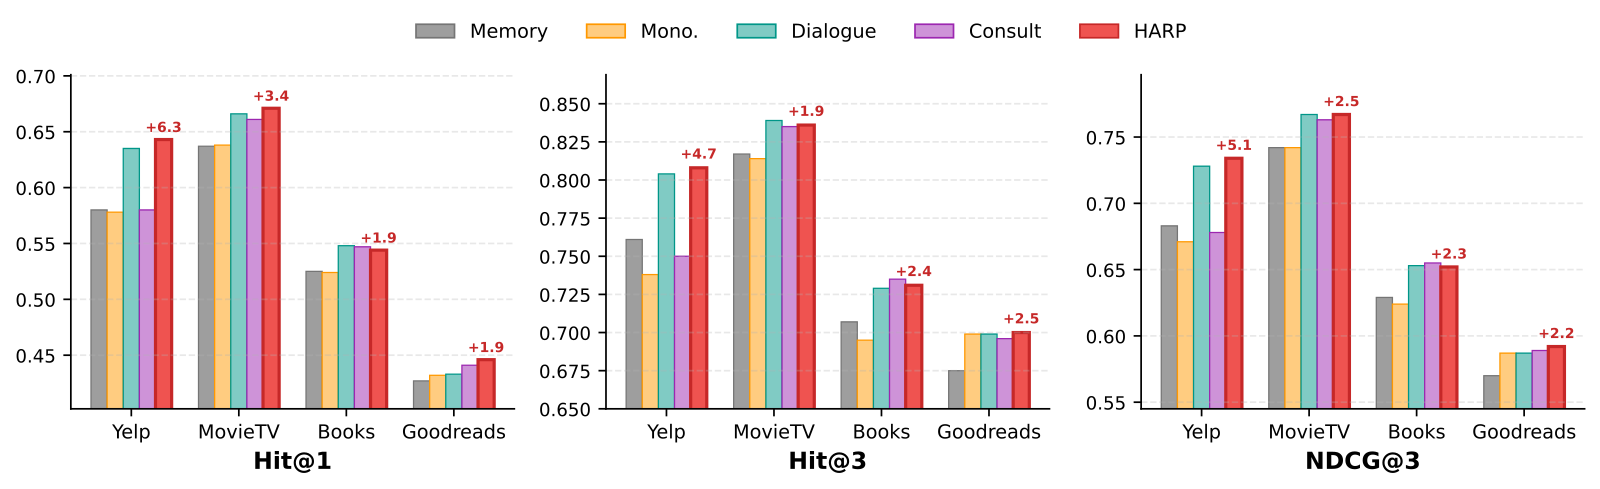
换到其他数据集,幅度小很多。相对 Memory,Hit@1 的总提升在 Yelp 是 6.3 个百分点,MovieTV 3.4,Books 和 Goodreads 都是 1.9。Goodreads 是例外:1.9 里有 1.3 来自提示词注入加反思,筛邻居那一步收益很小。提示词注入加反思这部分,在 Books 上是 −0.4 个百分点,也就是略有损失。
我认为它的局限
第一,主表里的基线数字全部抄自各自的论文,没有在同一套代码和同一个大模型下重跑。6.9% 到 24.0% 的提升,有一部分可能来自实现差异。附录里作者用另外三个大模型、在 1000 个用户的子集上同代码重跑了 MemRec,HARP 仍然领先,但那不是主表的全量测试。
第二,画像比对靠子串匹配和每个数据集手写的短语词表。Goodreads 的物品元数据大多是自由文本,规则抽出来的场景、受众栏很空,这也是它上面筛邻居收益最小的原因之一。换一个新领域,词表要重新写。
第三,消融只在每个数据集 1000 个用户上做,Yelp 以外,相对 Memory 的提升只有 1.9 到 3.4 个百分点。提示词注入和反思合在一起,在 Books 上还是负的。消融没有把反思单独拆出来,所以说不清它值不值那一次大模型调用。
一个推荐团队可以怎么试
- 如果已经有“邻居记忆进提示词”的大模型重排,先离线统计:入选邻居里有多少和用户画像明显不像。
- 用规则给物品建一份和用户画像同栏的画像,不调大模型,成本很低。
- 在召回邻居这一步加上 α + (1 − α) × H 的打折,α 从 0.3 到 0.4 起试,比较 Hit@1。
- 预热反思最后再加,先在小流量上确认它是正收益。
评价
一句话:画像别只塞进提示词,用它决定哪些邻居能进提示词,收益更大。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。大模型推荐里提示词长度有限,邻居选得准不准直接影响结果 |
| 方法创新性 | 中。三个部件都是已有思路,价值在于把“画像用在哪一步”分开测清楚 |
| 实验证据 | 中。消融设计清楚,但基线没有重跑,Yelp 以外提升较小 |
| 工程成本 | 低。不训练,物品画像用规则,每个用户在预热时调用一次大模型反思 |
| 是否值得尝试 | 值得。按画像给邻居打折几乎零成本,先试这一步 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…