
快手 Push 通知要决定给每个用户推哪条视频。用户既被好内容吸引,也会长期信任某些作者,但现在的生成式推荐大多只生成单个视频的编号,体现不出“愿意一直看这个作者”的偏好;而且逐个编号生成要跑好几轮模型,Push 链路对延迟很敏感。这篇论文提出 HGenPush(Heterogeneous Generative Push):一个模型同时生成视频和作者两类候选,用一次前向就把视频的多级编号全部算出来,再用点击之后的观看行为做强化学习微调。线上相比原来的多阶段架构,日活 +0.181%,点击率 +1.577%。
做生成式召回、尤其是在意线上吞吐的人值得读:它给出了一个比逐步生成快、又比完全并行准的折中做法,并且有吞吐数据。证据全部来自快手 Push 场景,没有公开数据集上的结果。
它到底在解决什么问题?
生成式推荐通常把每个视频表示成几级 Semantic ID,让模型逐级生成,TIGER、OneRec 都是这种做法。它有两个问题放到 Push 场景里更明显:
- 只推视频,不推作者。两个作者内容类别相近,用户可能只信任其中一个,这种偏好单看视频编号学不出来。
- 逐级生成要跑多轮模型,Push 发送量大、对延迟敏感,召回如果太慢就替代不了现有链路。
还有一个问题是只用点击训练,容易学出标题党:用户点了,但很快划走。点击之后有没有看完、点赞、转发,才更接近内容本身的价值。
方法:一个模型,两个分支,再加一步强化学习
模型是只有解码器的 Transformer。输入包括首页长期和短期行为、Push 点击序列、Push 发送序列,以及年龄、性别等静态特征。每个视频由它的 Semantic ID、作者 ID、话题标签、时长等拼起来再投影成一个向量;Push 点击序列额外带上通知类型,用来学用户对不同通知形式的接受程度。序列末尾加两个特殊 token,一个给作者分支、一个给视频分支,用来汇总用户兴趣。
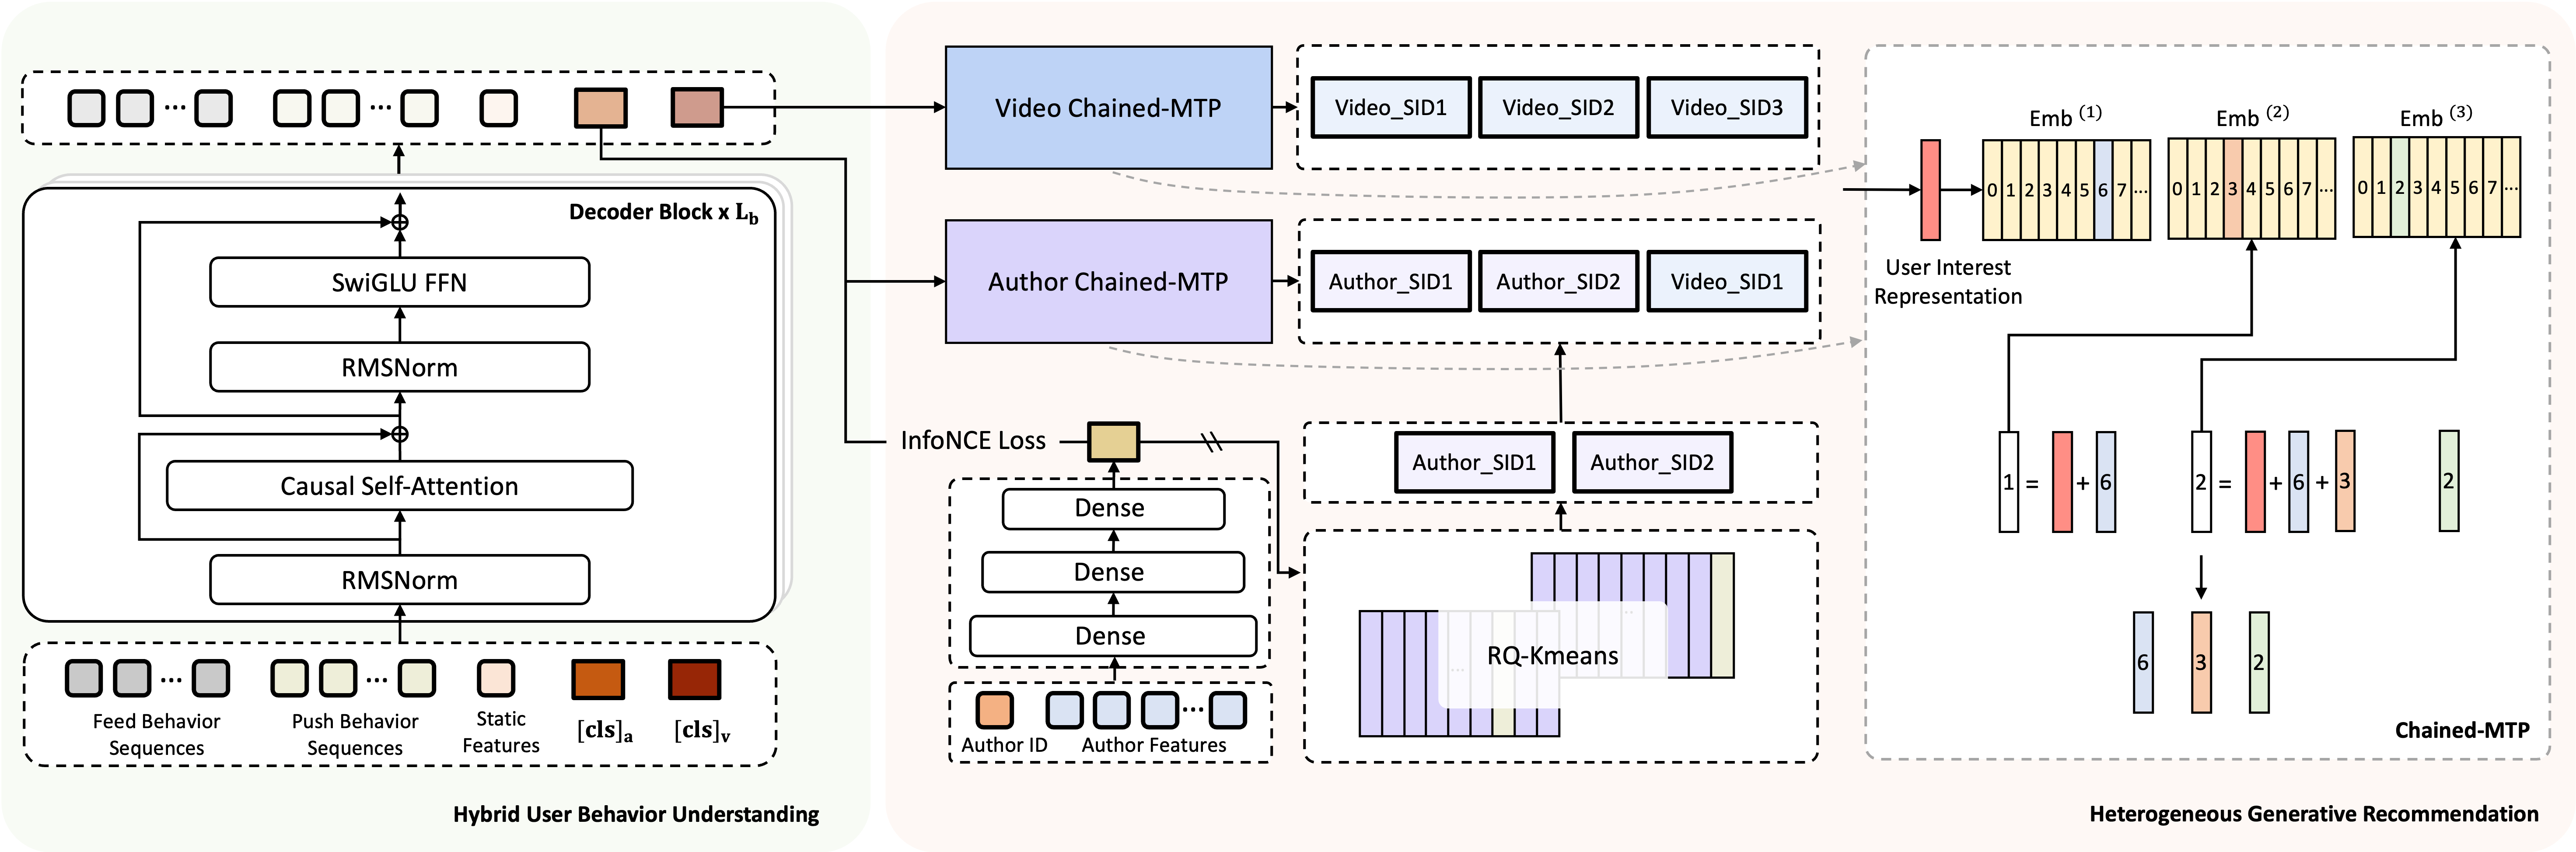
视频分支负责一次算出视频的各级编号,论文把这种做法叫 Chained-MTP。每一级编号都有一张向量表。预测第 k 级编号时,把视频分支那个特殊 token 的输出向量,加上前面 k−1 级已确定编号在各自表里查到的向量,再过一个这一级专用的前馈网络,最后做 softmax 得到第 k 级每个编号的概率。所以第 k 级仍然受前面几级影响,但不需要再跑一遍 Transformer,几级编号可以在一次前向里连着算完。训练用每一级的交叉熵相加。
作者分支要回答推哪个作者。它先把作者特征(作者 ID、多模态向量)和用户兴趣向量投到同一个空间,用对比学习拉近“用户和他真正点过的作者”、推开同一批里其他作者。这样学出的作者向量带的是“谁会信任他”,而不只是“他发什么内容”。然后用 RQ-KMeans 把作者向量编成多级编号。为了不让大部分编号闲置不用,作者用了 SimVQ:编号向量表写成一张固定的表乘上一个可学习的矩阵,训练时更新的是这个矩阵,所有编号的向量会一起移动,不会有编号因为一直没被选中而停在原地;此外每一级的残差到最近编号向量的距离也作为一项损失,持续更新向量表。作者分支的生成目标是作者编号后面再接目标视频的第一级编号,既说推哪个作者,也说推他哪类内容。
第三步是让模型学会偏好点开后真正被看完的内容,论文叫 UCPA。用户点开 Push 之后,会在这次访问里接着看若干视频。每个视频按平台日志里已有的行为标签打分:带“有效播放”“进入作者主页”“评论区停留”标签的各 +2;点赞、关注、分享、评论各 +1;带“短播”标签(很快划走)的 −2;点不喜欢 −5;举报 −10,一个视频有几个标签就累加几项。同一次访问里的分数减去平均再除以标准差,得到每个视频比同组好多少。优化方法论文叫 GSISPO:对每个视频,先在每一级上算新模型和旧模型给出的概率之比,再对各级取几何平均(相当于整串概率之比开 L 次方,L 是级数),把结果限制在 1±ε 之内,再乘上前面那个比同组好多少的分数去更新模型。按整串编号算,是因为好坏是对整个视频而言的,不该拆到单个编号上。
整体训练同时优化视频生成、作者生成、作者向量表的更新和偏好对齐几项损失。推理时两个分支都用束搜索生成多条候选,直接送进精排,跳过粗排。
| 部件 | 一句话 | 解决什么 |
|---|---|---|
| Chained-MTP | 用户兴趣向量加上前几级编号的向量,一次前向算完所有级 | 逐级生成太慢 |
| 作者分支 | 作者向量先对齐用户兴趣再编号,目标是作者编号接视频第一级编号 | 只推视频、不推作者 |
| UCPA | 点击后的观看行为打分,组内比较后做强化学习 | 只看点击导致标题党 |
实验结果
数据是快手 Push 系统的线上流量,覆盖超过 4 亿日活用户。离线指标是 HitRate@100:看真实目标的整串编号有没有出现在前 100 个生成结果里,作者分支的整串编号就是作者编号加视频第一级编号。
| 模型 | 视频分支 | 作者分支 |
|---|---|---|
| SASRec | 0.3093 | 0.3495 |
| TIGER | 0.3802 | 0.4677 |
| HGenPush | 0.3915 | 0.4848 |
更能说明部署价值的是三种多级编号预测方式的对比:
| 方法 | HitRate@100 | 单卡最大 QPS |
|---|---|---|
| 各级独立预测(Parallel-MTP) | 0.1150 | 2.40k |
| 逐级用 Transformer 预测(DeepSeek-MTP) | 0.3954 | 1.27k |
| Chained-MTP | 0.3915 | 1.70k |
各级完全独立预测虽然最快,命中率却掉到 0.1150,说明编号各级之间的依赖不能丢。Chained-MTP 的吞吐比逐级 Transformer 高 33.86%,命中率只低 0.0039,这就是它的取舍。
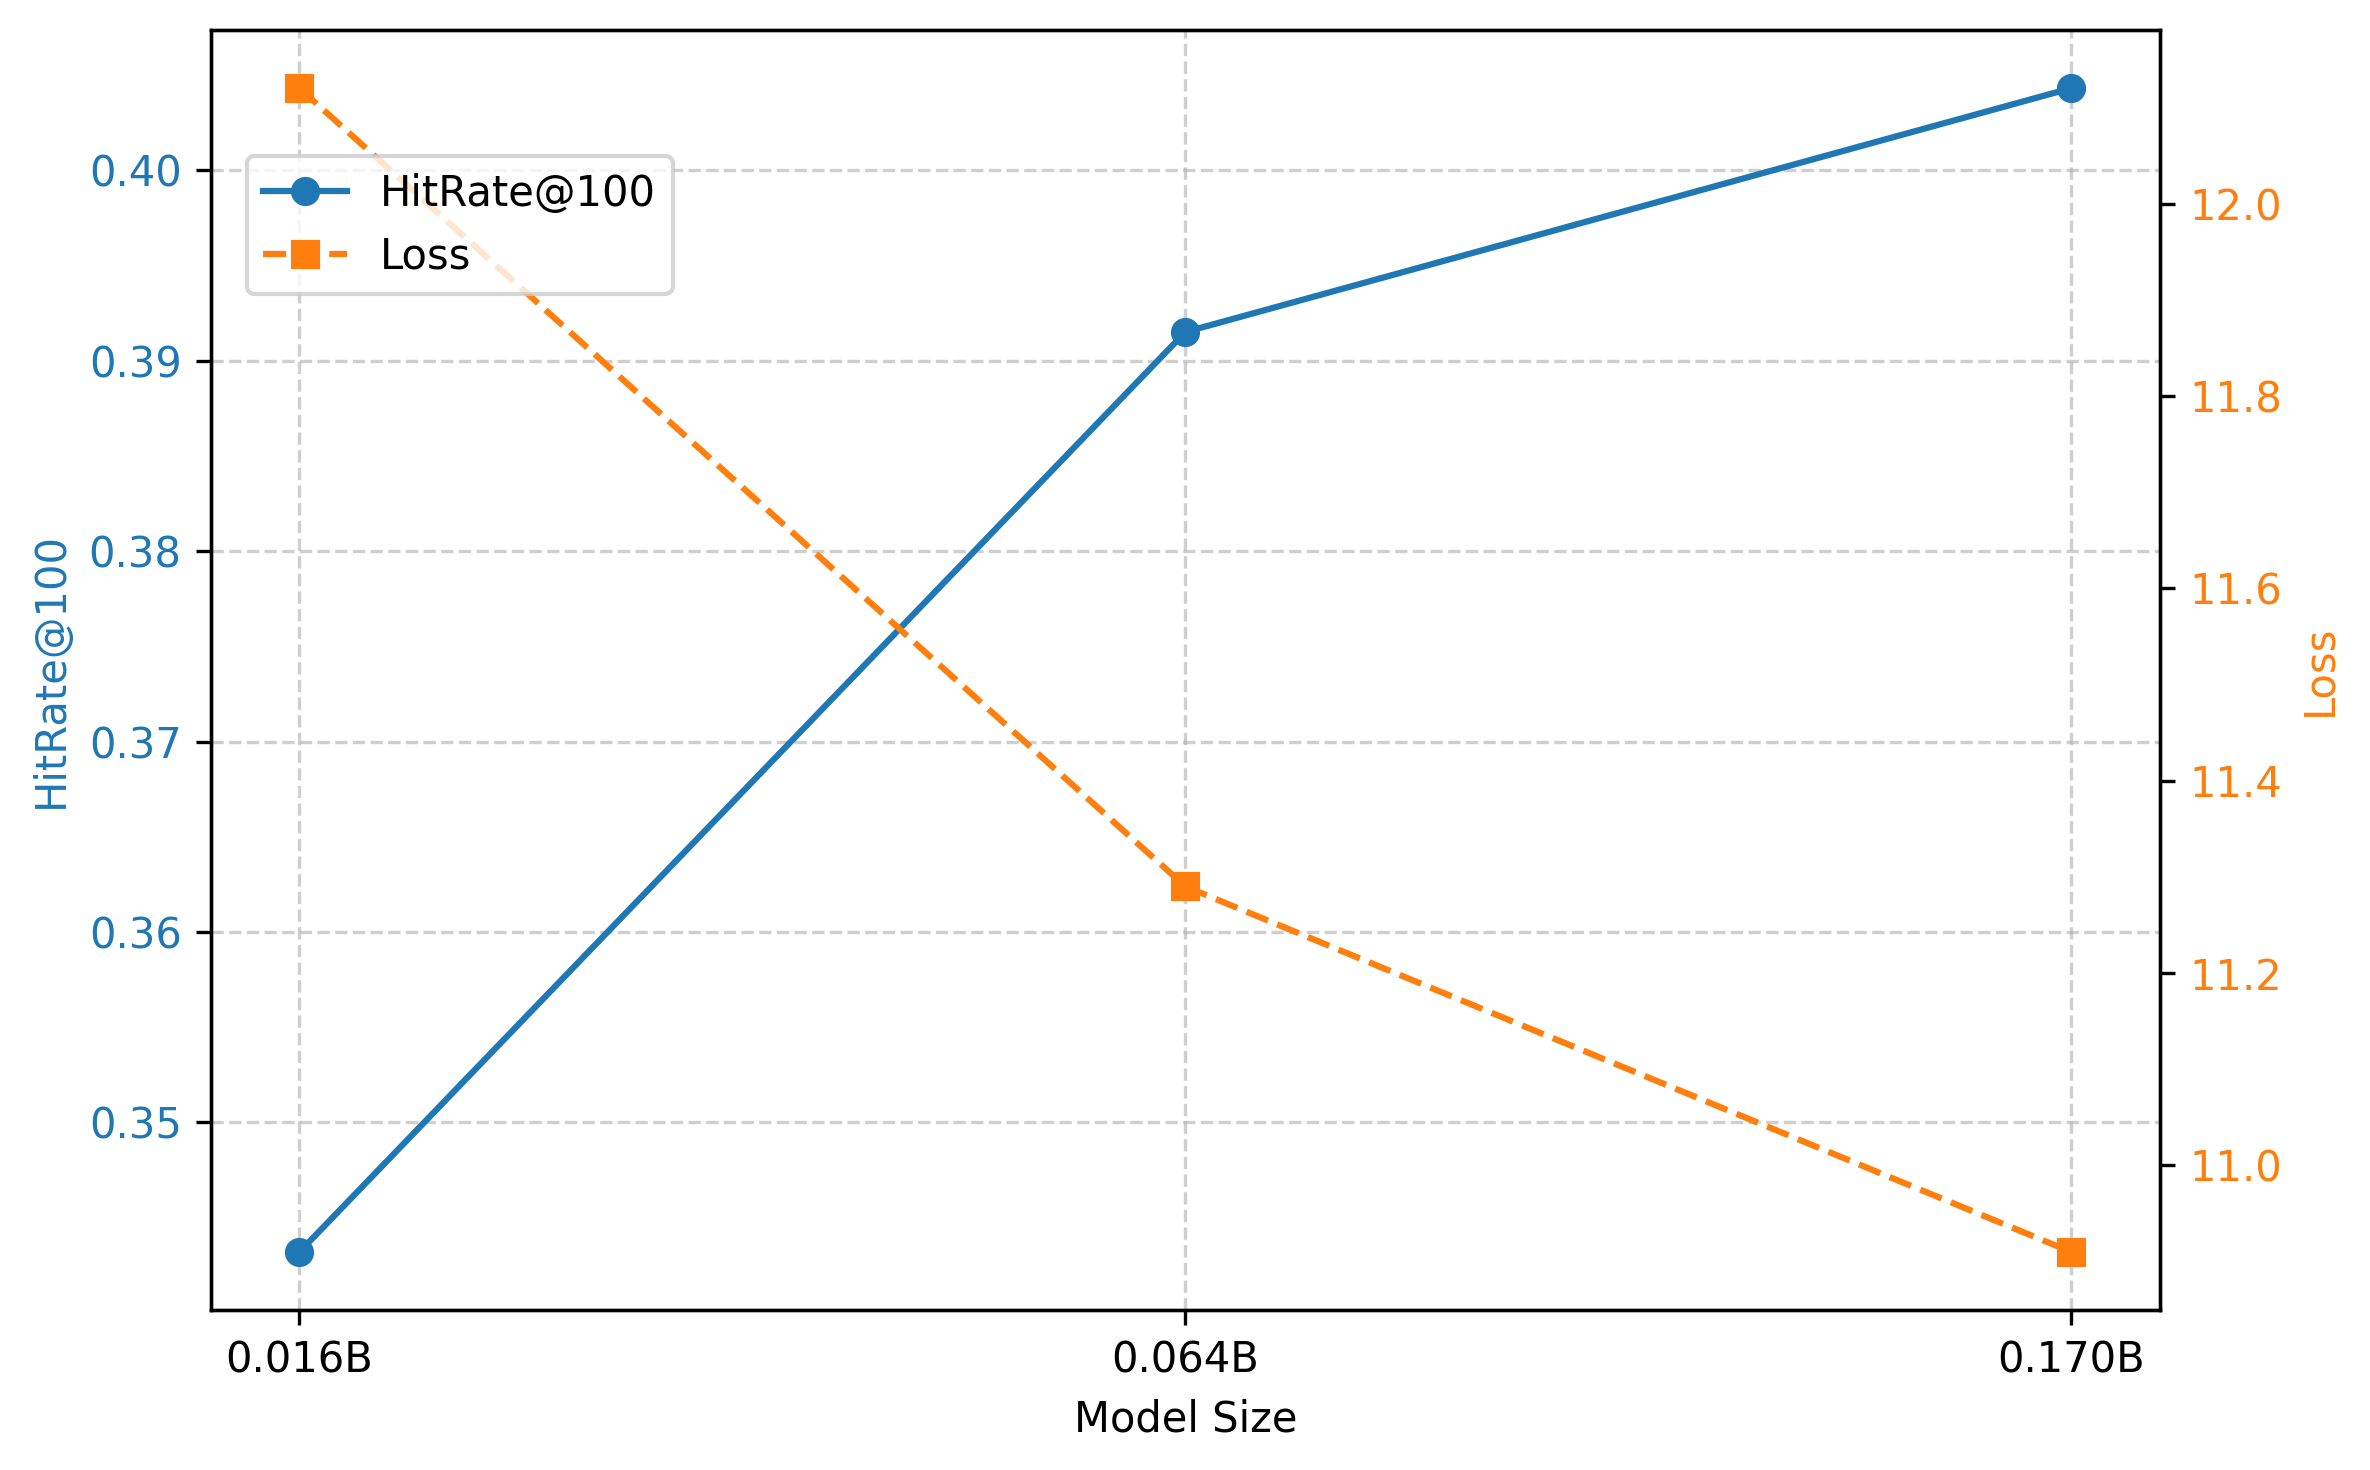
模型从 0.016B 扩到 0.064B(加深加宽),命中率相对提升 14.07%;再把前馈层换成稀疏专家扩到 0.170B,只再提升 3.27%,说明在这个范围里继续加参数的收益在变小。
偏好对齐的消融说明做法很关键:直接按观看时长给训练样本加权,命中率从 0.3964 掉到 0.3394;用 UCPA 只降到 0.3915,同时线上转发率 +7.57%、完播率 +0.90%。最终线上实验分三步上线:只有视频分支时日活 +0.126%,加上 UCPA 后 +0.153%,再加作者分支后达到 +0.181%,说明三个部件都有各自的增量。
局限
- 所有证据来自快手 Push 一个场景。Push 有发送频率限制,用户反馈密度也和信息流不同,换场景要重新验证。
- 作者分支依赖清楚的“内容—作者”关系;没有明确内容来源的平台,这部分收益可能变小。
- UCPA 的分数是人工定的固定规则,各项加减分的大小会直接改变模型学到的偏好,论文没有比较不同的规则。
- 候选跳过粗排直接进精排,论文没有讨论这样做对精排压力和内容安全的影响。
- 训练细节给得相对完整(学习率和权重衰减都是 1e-4,批大小 64,NVIDIA L20),但数据和工程栈都在内部,难以完全复现。
怎么借鉴
已经有 Semantic ID 生成式召回的团队,可以先离线比较三种多级编号预测方式的吞吐和命中率,再决定要不要换成 Chained-MTP,它不需要多轮生成,改动不大。如果平台有明确的作者或店铺,作者分支“先对齐用户兴趣再编号”的做法可以单独试。偏好对齐最值得记住的结论是:不要直接按时长给样本加权,而是在同一次访问内部比较,再用强化学习微调。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…