 已录用 NSDI 2027
目录 · 9 节
1它到底在解决什么问题?2整体流程:上报负载、选状态、下发档位3为什么每个服务只报一个负载值?4产品状态:一小组事先测好的组合5状态是怎么做出来的?6线上效果怎么样?7我认为它的局限8一个推荐/搜索团队可以怎么试9一句话结论
大流量来的时候,每个服务各自限流、各自降级,单个服务都活下来了,整个产品的效果却可能一塌糊涂。Bing 就遇到过一次:一个共享的模型服务在不到 10 分钟的流量尖峰里自保降级,上游调用方却照常狂调,延迟和报错一路传上去,相关性指标 OneDCG(Bing 自己的归一化 DCG)掉了 1.11 个点,结果稳定率从约 90% 跌到约 63%,四个多小时才恢复。微软这篇 HiLO 的做法是把“降级”从服务级提到产品级:事先定好 6 个经过验证的产品状态,运行时只根据负载在它们之间切换。上线后,2026 年 1 月 9 次真实流量冲击里,最高到基线峰值的 2.38 倍,OneDCG 最多只掉 0.425 个点,守住了 0.5 个点的运营目标。
做推荐、搜索在线服务的团队值得读这篇,尤其是排序链路里已经挂了 GPU 模型或 LLM 的团队。原因是 GPU 容量很难靠多买机器解决,过载会变成常态,而它回答的是一个比限流更基础的问题:过载时产品到底处在什么状态,这个状态的效果有没有被测过。核心思想一句话:每个服务上报一个归一化的负载值,中央控制器把它们汇总,从一小组事先测好的产品状态里选一个,再告诉每个服务该降到哪一档。它主动放弃了细粒度的最优,换来的是过载时效果可预测、可测试。这篇没有新算法,价值在 Bing 六年降级经验和一套可以照搬的工程流程。
它到底在解决什么问题?
用一个搜索请求的例子说明(示意)。一条 query 进来,要经过召回服务、一个 GPU 上的深度排序模型、一个 reranking 服务,最后可能还要调 LLM 生成摘要。现在流量突然涨到平时峰值的 1.8 倍(示意)。
| 做法(示意) | 召回 | 深度排序模型 | reranking | 产品最终状态 |
|---|---|---|---|---|
| 各服务自己降级 | 照常,候选 1000 条 | GPU 打满后开始丢请求 | CPU 高了,自己跳过一个特征 | 这 2^3 种组合里的某一种,没人测过 |
| HiLO 产品级降级 | 状态 L2:多路 query 减一路 | 状态 L2:少打分一批文档 | 状态 L2:第 2 档 | 事先 A/B 过的 L2 |
左边这一行的问题在于,三个服务各自看自己的 CPU 或队列,各自决定降不降、降多少。它们的组合数随服务数指数增长,产品最终落在哪一种组合上,取决于谁先过阈值,基本靠运气。更糟的是调用方和被调方之间没有协调:被调的模型服务自保丢请求,调用方不知道,照样按原来的量调用,压力并没有减少,只是变成了上游的超时和重试。论文把这种“触发事件已经过去,系统却长时间回不到正常”的现象叫亚稳态故障,开头那次事故就是一个例子:尖峰不到 10 分钟,稳定率四个多小时才恢复,OneDCG 在之后两天每逢负载升高还会波动。
这里的稳定率是 Bing 监控的一个指标:同一个 query 在同一时间窗口里重复请求,返回完全相同结果的比例。它掉下去,说明底层服务在不正常地超时、跳步骤。
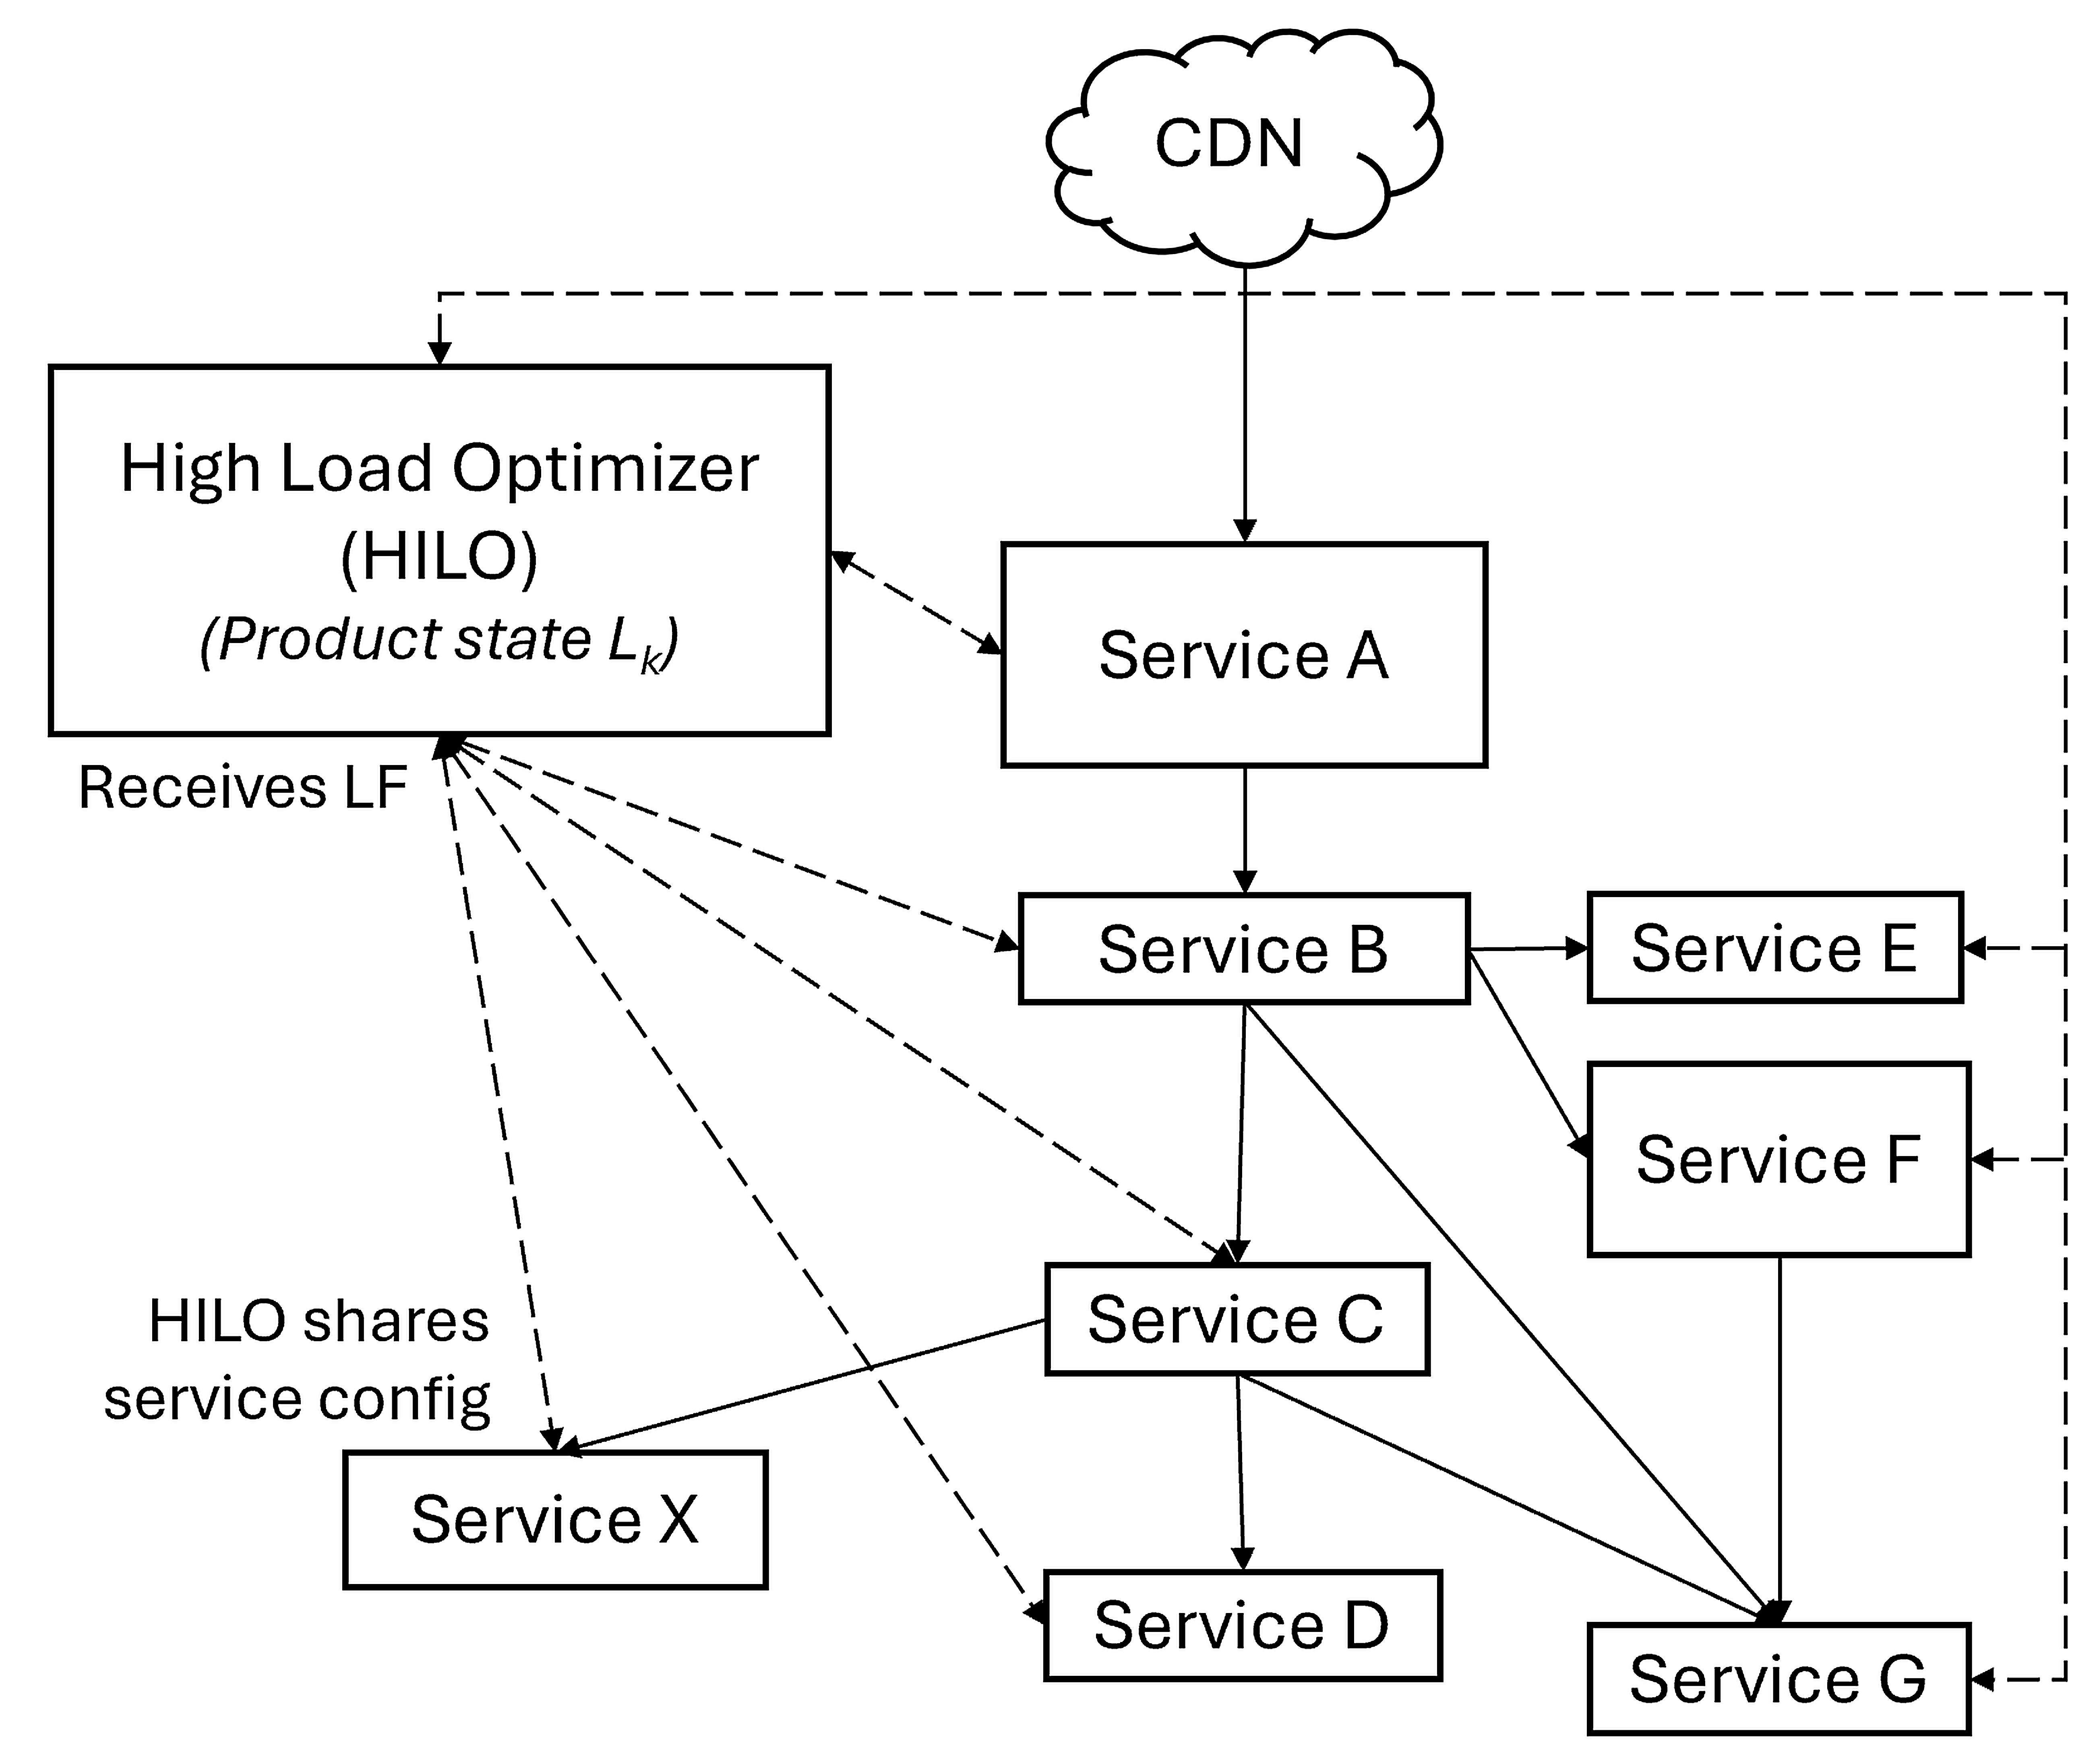
整体流程:上报负载、选状态、下发档位
HiLO 的运行时部分很简单,可以拆成四步:
| 步骤 | 谁来做 | 产出 |
|---|---|---|
| 上报负载值 | 每个参与的服务 | 一个归一化的数,越大越接近过载 |
| 汇总 | HiLO,每 2 分钟一次 | 产品级负载 |
| 选状态 | HiLO | L0 到 L5 中的一个,L0 是满血,L5 降得最狠 |
| 执行 | 每个服务 | 按状态查表,切到对应档位 |
设计上的关键分工是:复杂的依赖关系在设计期解决,运行时只做查表。HiLO 不在请求路径上,不做逐请求决策,也不在线推断调用图,所以它自己的开销很小:决策周期 2 分钟,内部 P95 延迟不到 1 毫秒,每个区域 64 个 CPU 核。下面拆开讲负载值、产品状态,以及状态是怎么做出来的。
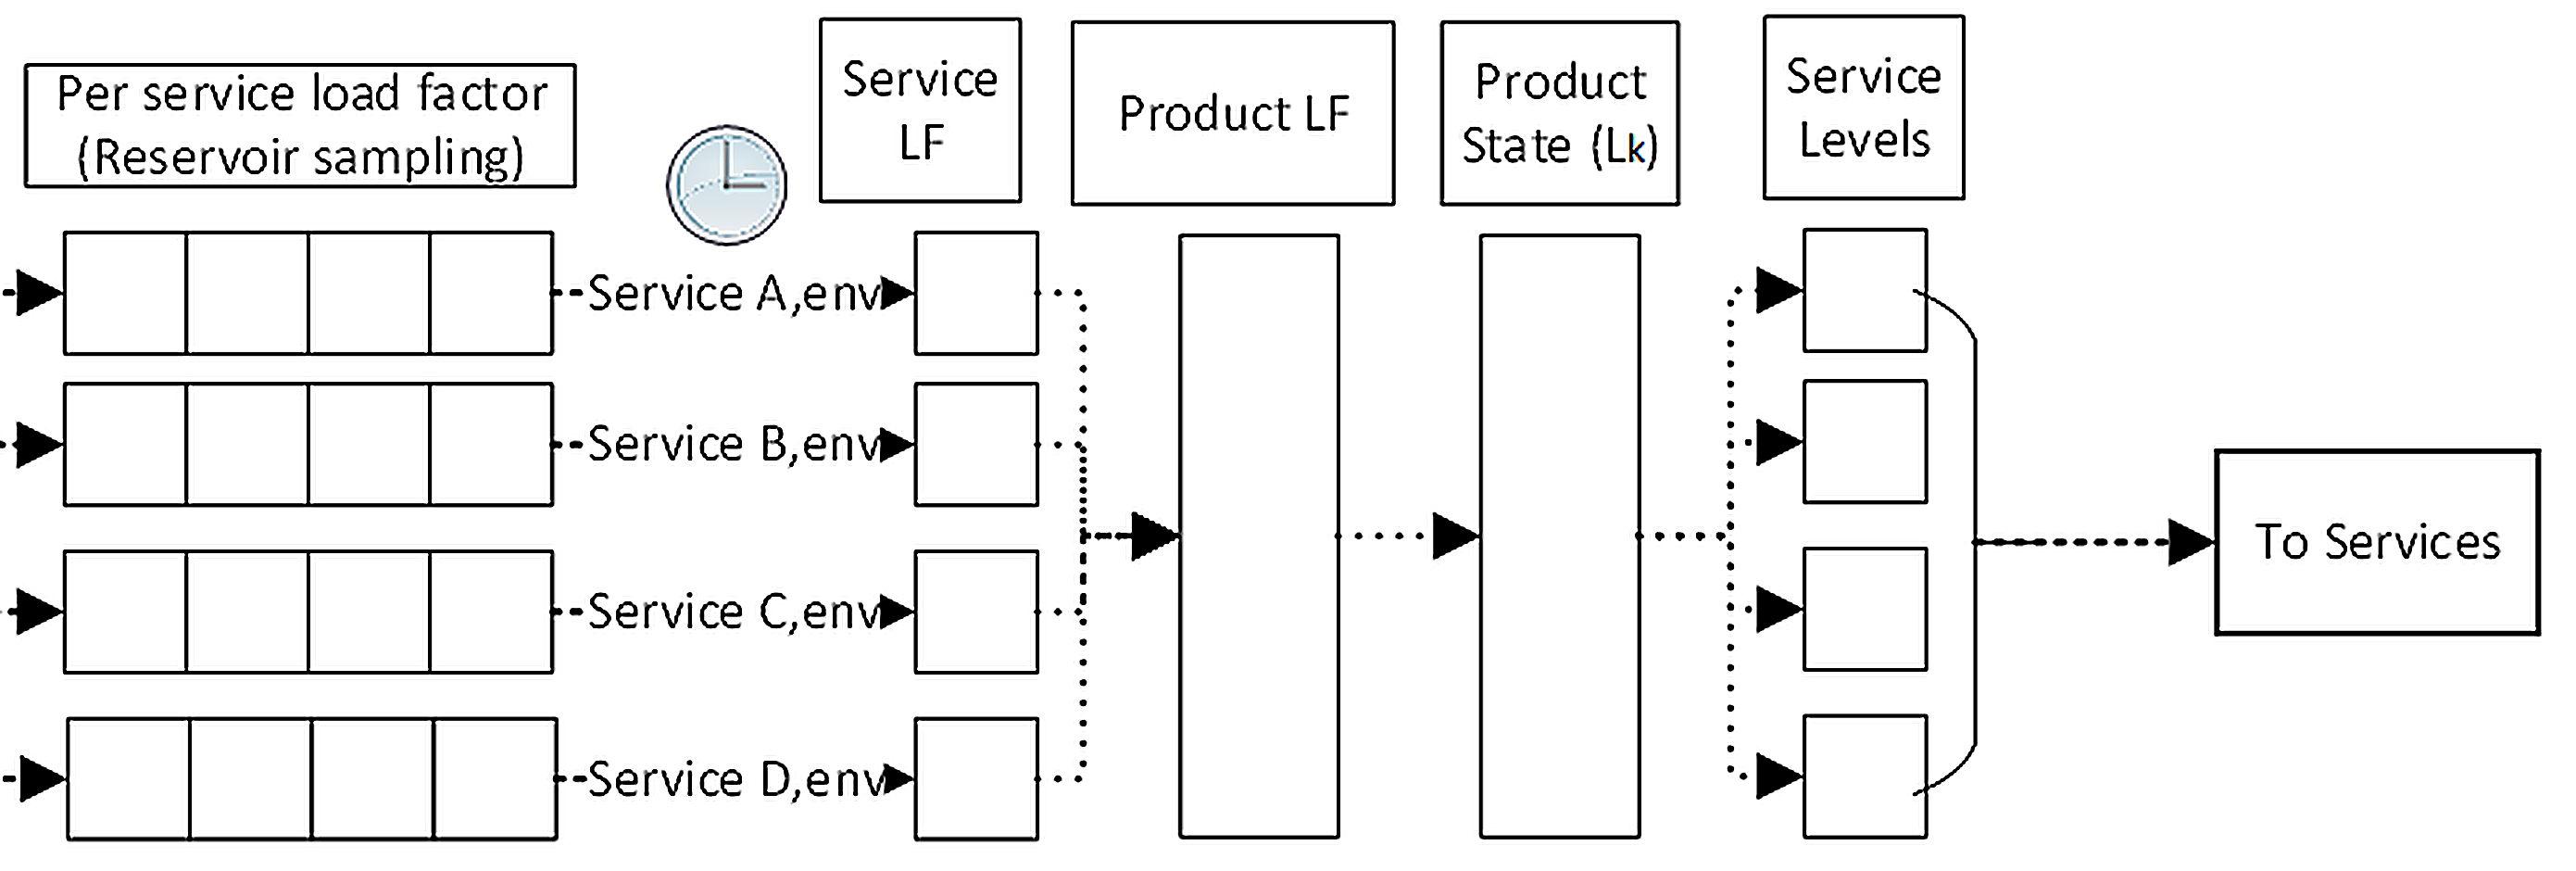
为什么每个服务只报一个负载值?
不同服务的瓶颈完全不同。论文的经验是:受网络限制的服务看队列长度,因为网络堵的时候 CPU 可能还很低;排序这类 CPU 密集服务看 CPU 利用率;模型服务看 GPU 利用率;有的服务把 CPU 和队列长度混在一起用。如果中央控制器要理解每一种信号,它就得维护一个全局容量模型,这在几十个服务的规模上不可行。
所以 HiLO 只要求一件事:每个服务自己选指标,折算成一个有上下界的负载值,并保证它单调,越大代表越危险。HiLO 把这些值只当作“拥堵程度的排序”,不当作精确的容量数字。HiLO 看到的不是某一次的瞬时读数。每个服务的多次上报先经过随机抽样,从一段时间的读数里留下一个固定大小的样本,HiLO 拿到的是这批样本的综合,单个异常读数的影响被摊薄;再加上 HiLO 每 2 分钟才决策一次,几秒钟的毛刺不会直接触发降级。
举个能手算的例子(示意):召回服务报 0.6,排序模型报 0.92,reranking 报 0.75。HiLO 不需要知道 0.92 对应多少张 GPU。论文没有公开具体的汇总公式,示意起见按最紧张的服务算:产品级负载就是 0.92,越过了 L1 的门槛 0.9(示意),产品从 L0 切到 L1。HiLO 只用这些数的高低,不把它们换算成机器数。论文提到一个容易误解的细节:流量到基线峰值的 1 倍,不等于负载值到 100%,因为有余量,query 构成也会变。这也是 HiLO 跟着负载值走、不跟着流量曲线走的原因。
产品状态:一小组事先测好的组合
产品状态是 HiLO 的核心。每个状态把每个服务映射到一个确定的档位,比如关掉某些特征、走简化的执行路径、减少扇出、换成更便宜的模型。状态按降级程度排成一个偏序,越高的状态回收的容量越多,效果损失也越大,但损失都在上线前测过。Bing 每个场景用 6 个状态,每个服务按自身弹性实现 2 到 6 档。
为什么不让每个特征一个开关,像 Meta 的 DefCon 那样?开关一多,组合就测不完,产品行为由开关之间的相互作用隐式决定。HiLO 把线上可能出现的状态压到 6 个,每一个都能端到端测试和 A/B。作者承认代价是控制粒度变粗。按他们的经验,把档位切得更细,每一档并不能多回收多少容量,回收速度也不会更快。
对 GPU 模型,论文给了一份降级手段清单,从轻到重:减少多路 query 改写(同一个请求发出的多条 query)、减少打分的文档数、加长缓存过期时间、减少模型层数、直接跳过模型。它特意没有用逐请求的分类器在大小模型之间路由:平时永远用大模型,只在过载时统一切到小一档,这样平时的效果没有任何损失。
运行时还有几条安全规则。负载上升时只往更严的状态走。负载回落后不会立刻切回满血,恢复节奏由运维配置。调慢,状态更稳但满血恢复得晚;调快,恢复得早,但可能刚切回去又被压垮,状态来回切换。每个服务执行的是 HiLO 下发档位和自己本地判断档位中更严的那个,所以 HiLO 挂了,服务退回原来的本地降级,可用性不受影响。
状态是怎么做出来的?
运行时简单,代价转移到了设计期,分三个阶段。
第一阶段,每个服务自己找能降级的动作。服务方先列出能降级的动作,估算每个动作能把负载值降多少、效果掉多少。一个动作执行得越频繁,换掉它省下的容量越多;优先级越低的动作越先放进较浅的档位。动作打包成几档后,用服务内部的 A/B 验证估算对不对。
第二阶段,解决依赖。有些被调方自己省不出容量,需要调用方少调或换个便宜版本调。这时两边一起把“少调用”写进调用方的档位里,再联合测一遍。图 5 里的意思就是:一次状态切换,不只改变一个服务自己的行为,也改变它怎么调用下游。
第三阶段,产品负责人把这些档位拼成 L0 到 L5,先在测试流量上跑:新状态在 HiLO 里登记成一个单独的测试场景,前端给测试请求或复制出来的一小部分线上请求打上这个场景的标记,HiLO 只对带标记的请求启用候选状态,真实用户不受影响。测试通过后再放到真实流量上 A/B,一般先 0.5% 跑 1 到 3 天,再升到 1% 和 5%。造成意外体验或用户指标掉得超标的候选状态被丢掉或调整。
产品级的生存目标决定了每档要省多少。比如定下“2 倍基线峰值不限流也能扛住”,每个服务就据此算自己需要几档、每档要把负载值降多少。不同搜索垂类(网页、图片、视频)作为不同场景,可以同时处在不同状态;同一垂类里,前端还会给请求标上高、中、低优先级,低优先级的请求先降级。
线上效果怎么样?
先看最核心的结果。2026 年 1 月 HiLO 覆盖了 Bing 全部数据中心,处理了 9 次越过过载门槛的真实流量冲击,最强的一次到基线峰值的 2.38 倍。可用性始终保持在 99.95% 以上,说明降级没有以丢请求为代价。
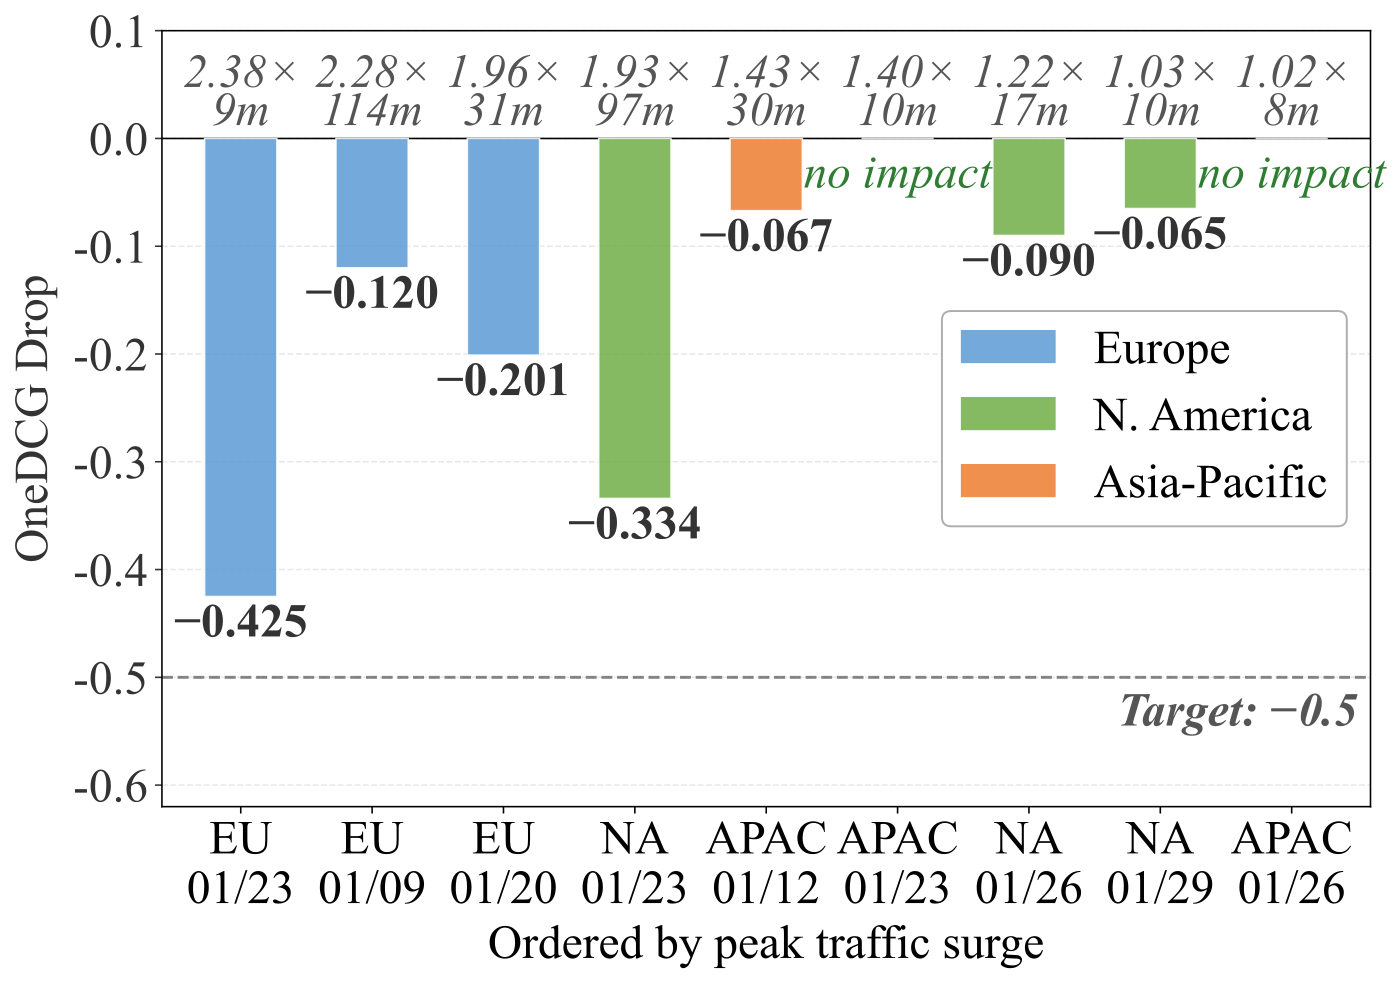
每次冲击中,真正处于降级状态的时间都短于过载时间。这说明 HiLO 只在负载值越线时降级,余量够用的那段过载时间里产品仍以满血运行。另一次由模型引起的过载里,OneDCG 只掉了 0.14 个点,对照开头那次事故的 1.11 个点。
和不用 HiLO 的对照来自容量测试:缓慢注入合成流量到约 2 倍基线峰值,对照组里各服务仍按本地策略降级。
| 数据中心 | 不用 HiLO:峰值 | 不用 HiLO:OneDCG 变化 | 用 HiLO:峰值 | 用 HiLO:OneDCG 变化 |
|---|---|---|---|---|
| 亚太 | 2.13 倍 | -0.05 | 2.06 倍 | 0 |
| 欧洲 | 2.06 倍 | -0.02 | 2.16 倍 | 0 |
差别看起来不大,作者也承认容量测试时间短、加压平缓,不如真实过载有代表性。更有说服力的是无结果率:不用 HiLO 时,后端返回不出结果的 query 比例一直更高,亚太那组到测试后段明显飙升。
降级到底省了多少、掉了多少效果,论文拿一个深度排序模型做了拆解:
| 状态 | 动作 | 模型调用量 | 单次延迟 | OneDCG 影响 |
|---|---|---|---|---|
| L1 | 减少 query 改写和文档数 | 约 -3% | 不变 | 小于 0.1 |
| L3 | 同上,力度更大 | 约 -13% | 不变 | 小于 0.1 |
| L5 | 再加减层 | 约 -29% | 约 -12% | 0.1 到 0.25 |
这张表说明减少上游调用是最便宜的第一步,前三档几乎不伤效果;减层要到后面才用。作为对照,直接跳过或限流这个模型,OneDCG 损失远超 0.5 个点。分档降级比一刀切关模型好得多,这是推荐排序团队可以直接借鉴的结论。不过减层这一档目前只完成了验证,还没在生产上线。
用户侧的 A/B 也很坦诚:L1 和 L2 对短期 DAU 没有可见影响,但结果里的新内容变少了:Bing 衡量新鲜内容出现比例的指标(SuperFresh Rate)在 L2 桌面端下降 15.21%;移动端 L1 的 query 改写率上升 3.49%,说明用户确实更常因为第一次没搜到想要的而换个说法。
我认为它的局限
第一,设计期成本很高。每个服务要找出可降级的动作、量化它、和上下游一起测,跨团队协调常常要几周到几个月。论文举的例子是一个有 9 万多个子流程的服务,光分析就花了三个月。没有专门的中心团队和管理层支持,很难推下去。
第二,OneDCG 守住不等于用户体验守住。表里的内容新鲜度在 L2 掉了 14% 到 15%,作者也说更深的状态里新鲜度和参与度会掉得更多。如果只盯一个主指标设计档位,其他维度的损失容易被忽视。
第三,状态振荡没有解决。一个数据中心停机维护 30 多小时期间,另一个数据中心的 GPU 模型容量不够,状态在降级和恢复之间来回切,直到几小时后补了模型容量才停。HiLO 守住了效果,但它本身补不了容量缺口。
一个推荐/搜索团队可以怎么试
- 先让每个在线服务上报一个归一化、单调的负载值,只观测不控制。判断标准是:过去几次过载,这个值能不能提前反映出来。
- 挑容量最紧的一两个环节,通常是 GPU 上的精排模型,设计 3 档降级:少打分一批候选、少走一路召回、换小模型。每档用离线评估加小流量 A/B 量出省多少、掉多少。
- 把档位拼成 3 到 4 个产品状态,接一个中央控制器,规则是只升不急降,并保留服务本地降级作为兜底。用压测验证在 2 倍峰值下主指标的损失是否在预算内。
- 把当前状态记进每条曝光日志,过载事件之后按状态拆看指标,再决定要不要扩展到更多服务。
一句话结论
过载时的效果不应该是多个服务各自降级碰出来的结果,而应该是一个事先测过、可以被说出来的产品状态。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。GPU 模型进入在线链路后,过载成为常态,产品级效果没人负责是真问题 |
| 方法创新性 | 中。Brownout(按延迟自动关掉单个应用里的可选组件)和 DefCon(运维手动拨的特征降级开关)早已有之,新意在把状态压到少数几个并在设计期解决依赖 |
| 实验证据 | 中高。全是 Bing 生产数据,有真实事故和对照,但对照组只有短时容量测试 |
| 工程成本 | 高。运行时便宜,设计期需要大量跨团队协作 |
| 是否值得尝试 | 值得,先从最贵的模型服务做分档降级,收益最直接 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…