
同一件白 T 恤,找同款、看搭配、问怎么洗,要的笔记完全不同:IntentFlow
你在小红书上拍了一件白 T 恤。同一张图,可以接着问三件事:帮我找一件差不多的,看看怎么搭配,这件该怎么洗。
找同款,要的是同一件或指定型号的白 T 恤笔记;只是看起来像,还不够。找搭配,要的是这件 T 恤已经穿进一套造型里的例子。问怎么洗,要的是面料对应的护理说明;配图可以是另一件衣服,只要材质和护理条件用得上。
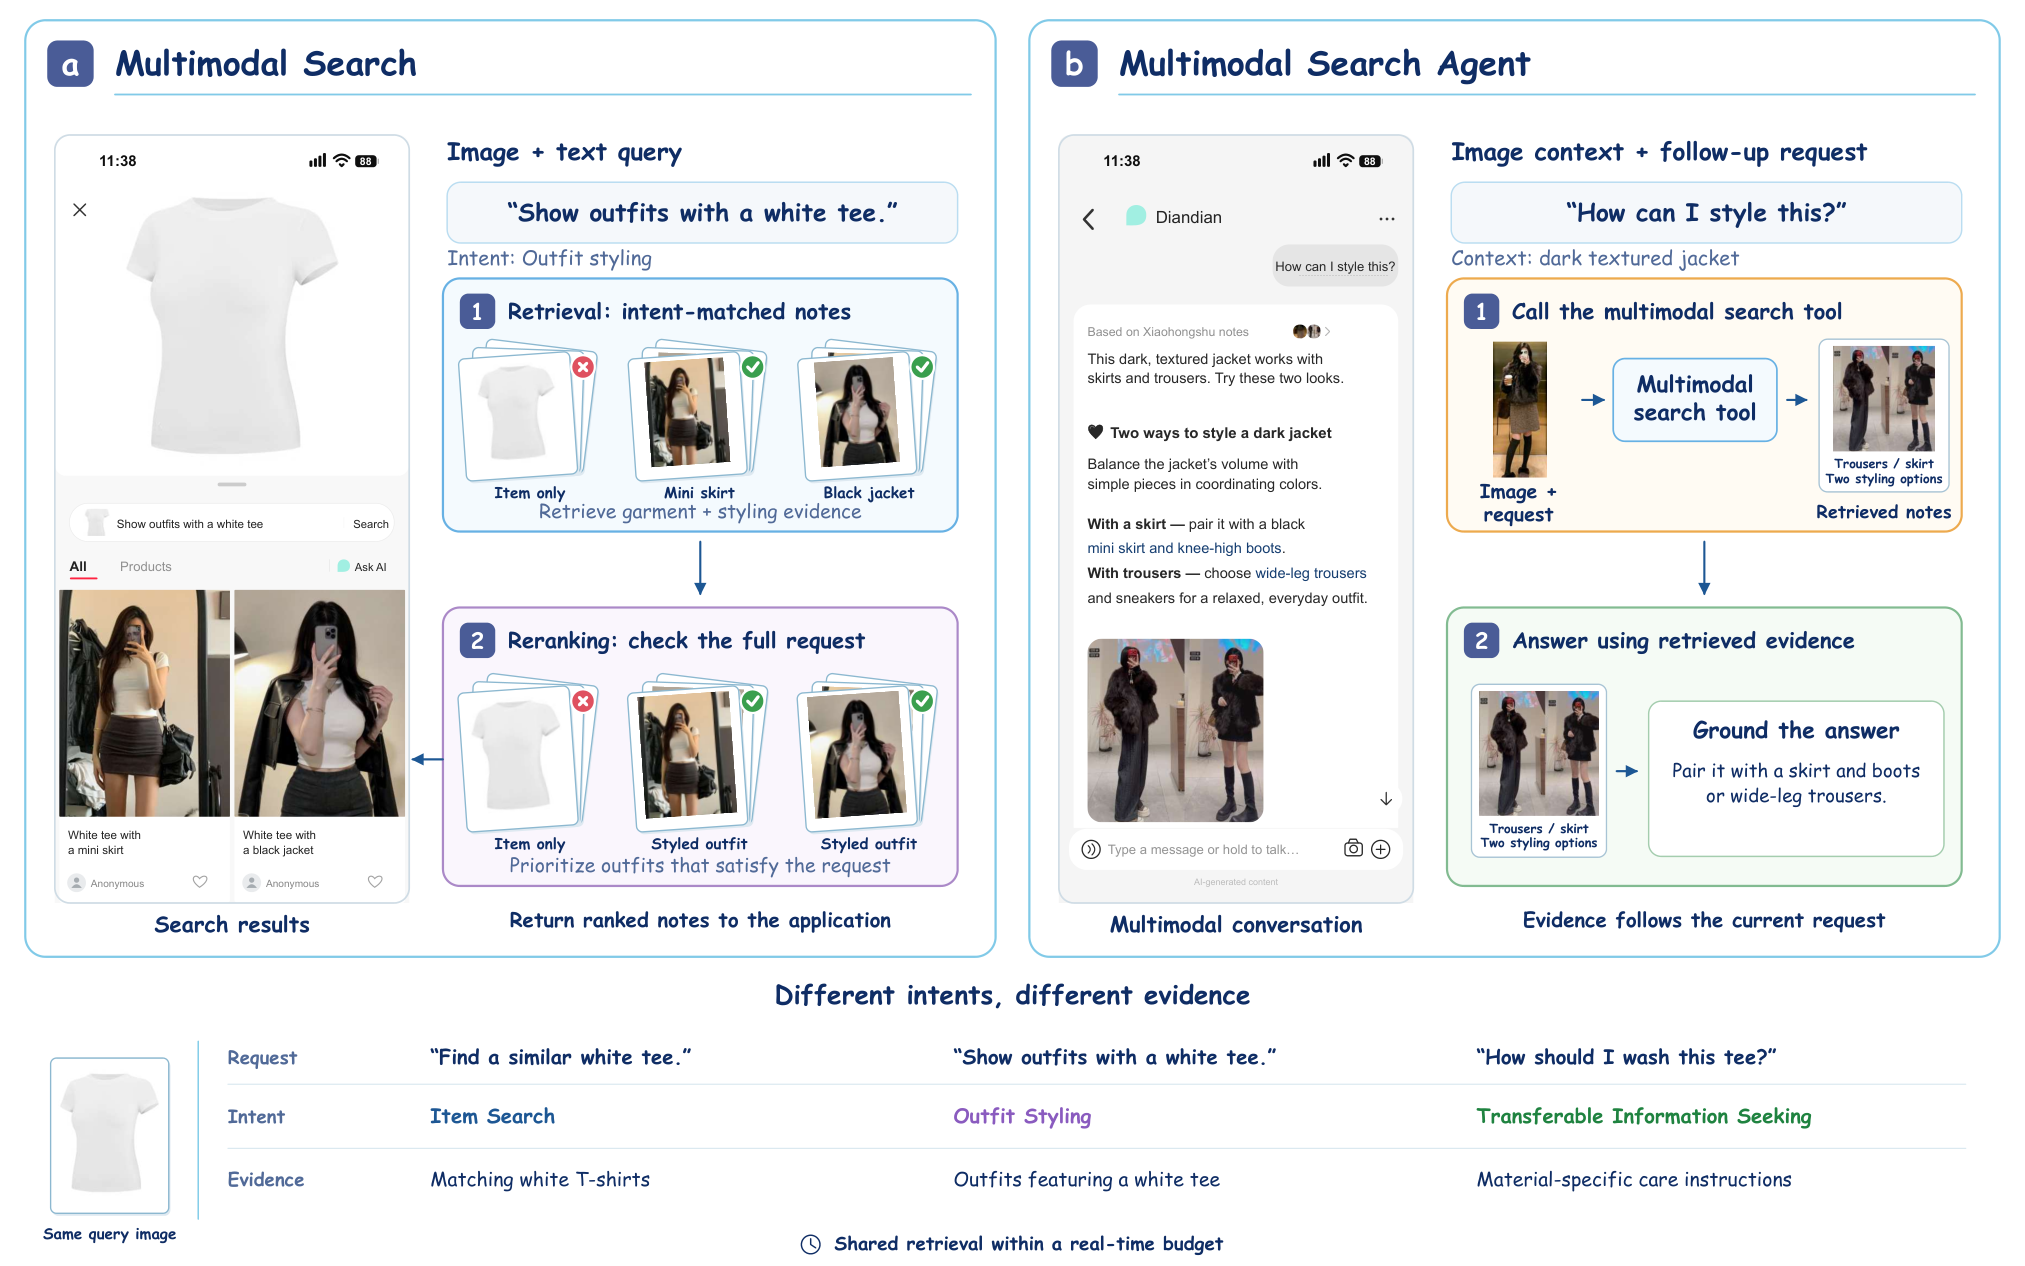
这篇论文来自小红书(Xiaohongshu Inc)。它做的是社区里「一张参考图加一句话」的实时搜索,同一套检索也给多模态搜索助手提供证据。现有线上系统先按图检索候选,再对结果精排。外观接近的笔记,不一定带上这句话要的证据。真正用得上的笔记如果没进候选集,后面再排也看不见。IntentFlow 先识别查询的分层意图,再用每类意图自己的相关标准去构造训练数据、学习检索向量,并按三个相关等级精排。系统跑在百亿量级索引上。在用户级对照里,相对原来「先视觉检索再精排」的线上系统,前四条查询点击率相对提升 28.17%,查询点击率相对提升 18.96%,人均在结果页停留时长相对提升 12.56%。前四条查询点击率指发出的查询里,前四条结果至少被点一条的比例;查询点击率不限制点击位置。服务监测的端到端 P50 延迟是 1.07 秒。
完整系统把同一套意图标准用到召回和精排,线上三项互动指标都高于只加意图精排的配置;在「可迁移信息寻求」这条意图上,意图感知监督把覆盖做高了,第一条命中却从 65.30% 降到了 58.46%。
同一张图,要的证据不一样
IntentFlow 把意图按「你想要什么结果」分层,不按图里是什么物品分类。第一层先把能执行的请求分成两类。视觉搜索:候选图本身就给出要的结果,比如一件商品、一张原图、一套穿搭。信息寻求:还要笔记正文里给出解答或可操作的说明。另有一类意图不明,只在图像和文本合在一起仍无法确定检索目标时使用。
第二层再把目标写细。单品搜索要的是查询指定的那件物品,或查询允许的相似款、替代品。如果问的是精确同款,只是同类或长得像,不能算命中。穿搭造型要看到组合关系。针对目标的信息寻求,护理说明必须适用于图里这种花。可迁移信息寻求允许答案来自另一件物品,只要使用条件用得上:讨论皮带耐不耐用时,不同手表的真皮佩戴经验可以共用。
相关程度用三档表示。0 分是没有具体对应。1 分是有关系,但缺了满足请求必需的某一条。2 分是给出了要的结果,并且满足查询里的对应关系和限制。等级的含义对所有意图一样,怎样才算「满足」则随意图变。
走一遍:同一块表,两种问法
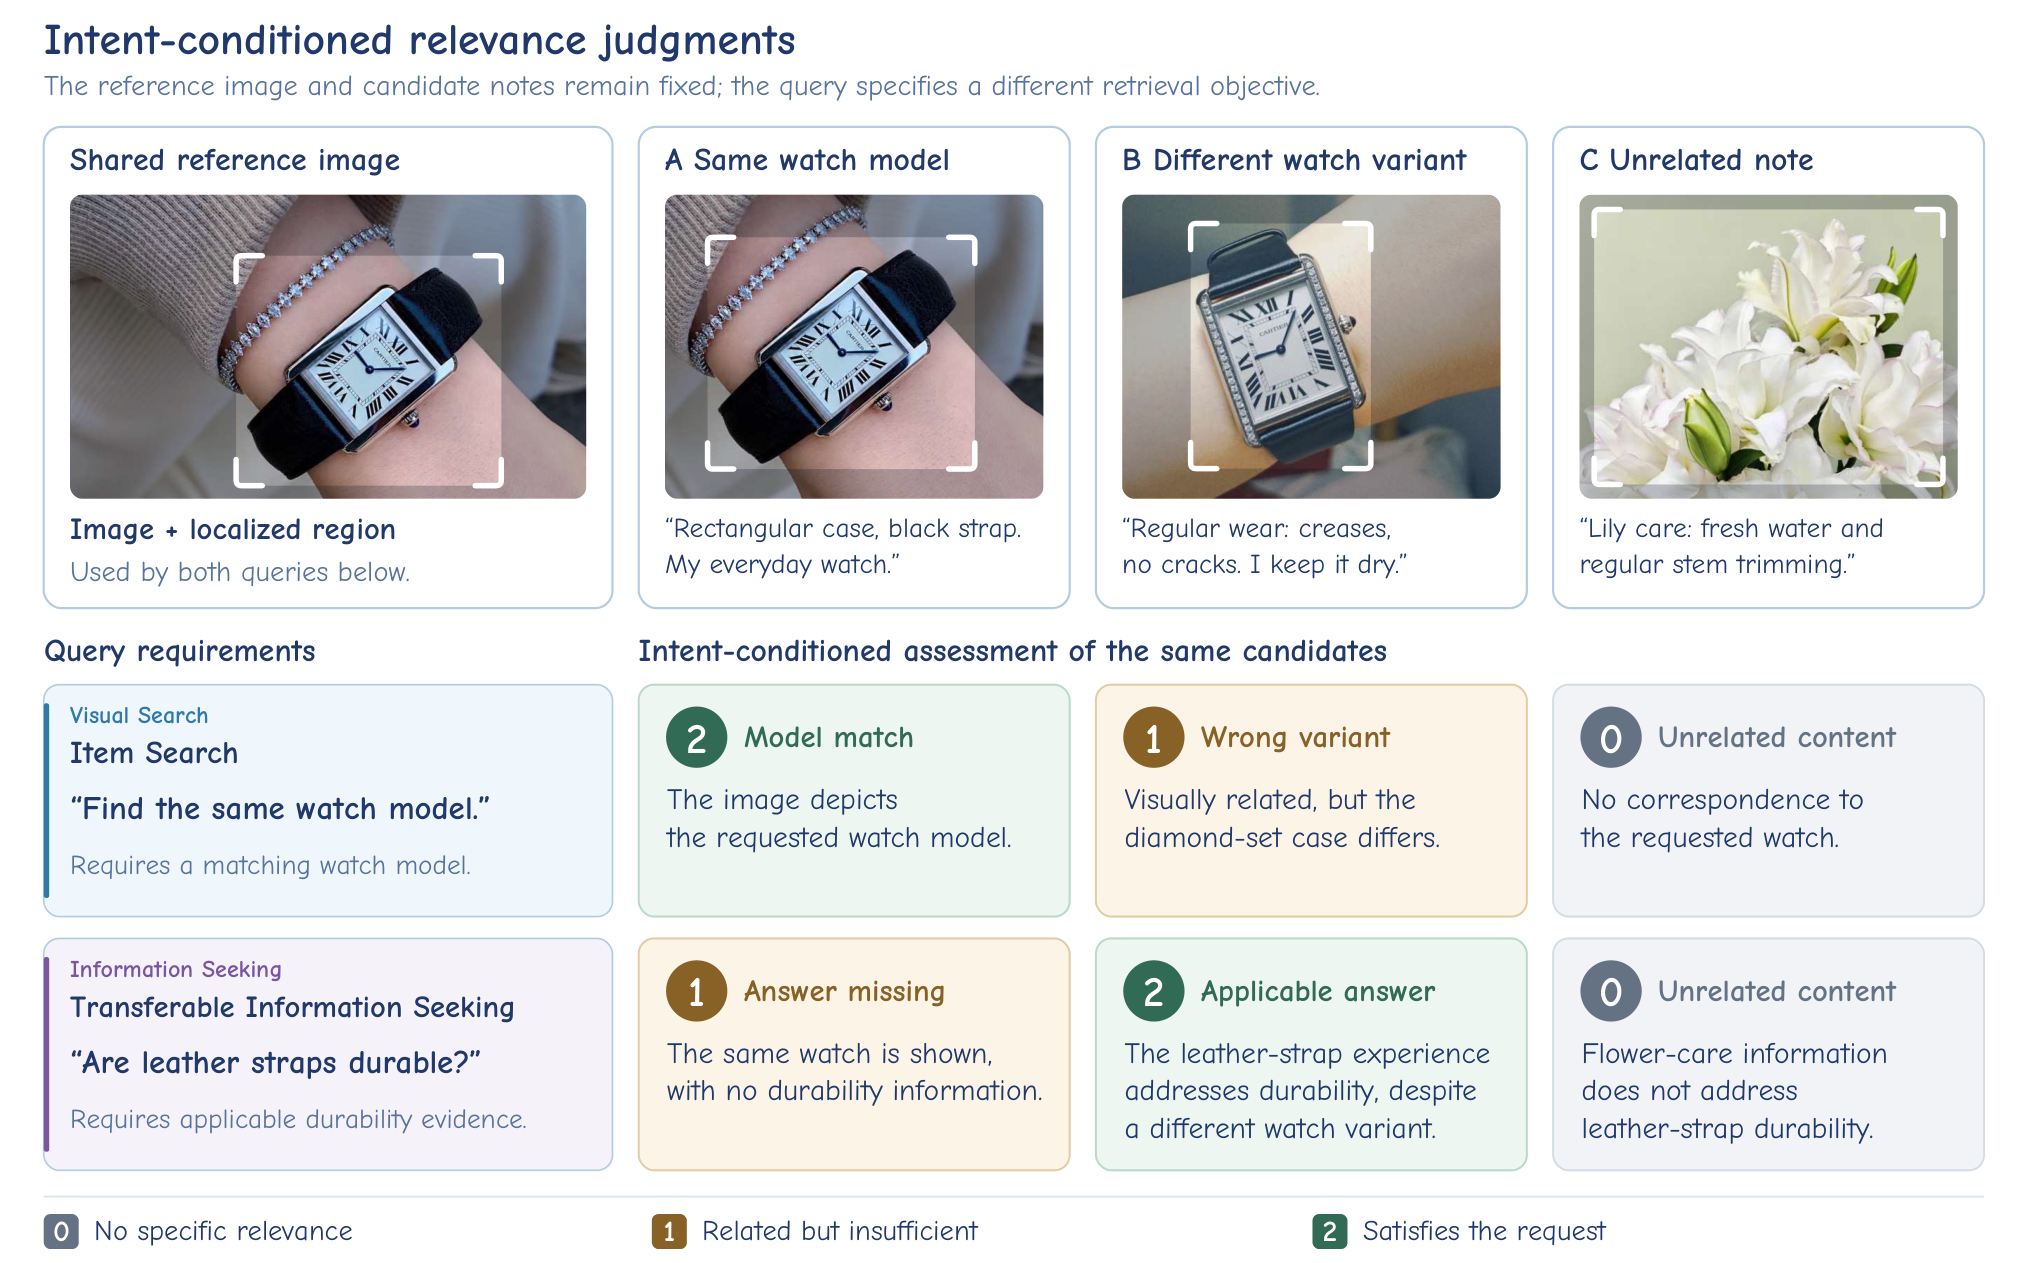
下面用论文 Figure 3 的例子。图中的笔记摘录是示意,三条候选的相关等级是论文给出的判定。
共享的是同一张参考图:一块方壳黑皮带手表。候选 A 是同一款,正文只写外观。候选 B 是带钻的另一款,正文写日常佩戴有褶皱、没有裂纹,而且皮带会保持干燥。候选 C 是百合花护理,和表无关。
第一步,先判定意图。问「找同一款表」,属于视觉搜索里的单品搜索,硬条件是型号要对应。问「皮带耐不耐用」,属于信息寻求里的可迁移信息寻求,硬条件是要有用得上的耐用性说明。查询编码和意图识别同时进行,互不等待。
第二步,按意图给这三条笔记打分。单品搜索里,A 型号对,得 2 分;B 看起来像,但表壳带钻,得 1 分;C 得 0 分。顺序是 A 高于 B,B 高于 C。
第三步,问题换成耐用性,三条笔记不动,分却对调了。A 是同款,但没写耐用性,从 2 分降到 1 分。B 不是同款,但真皮佩戴经验回答了问题,从 1 分升到 2 分。C 仍是 0 分。顺序变成 B 高于 A,A 高于 C。只看外观,A 会一直排在 B 前面;按当前问题,这个顺序是错的。
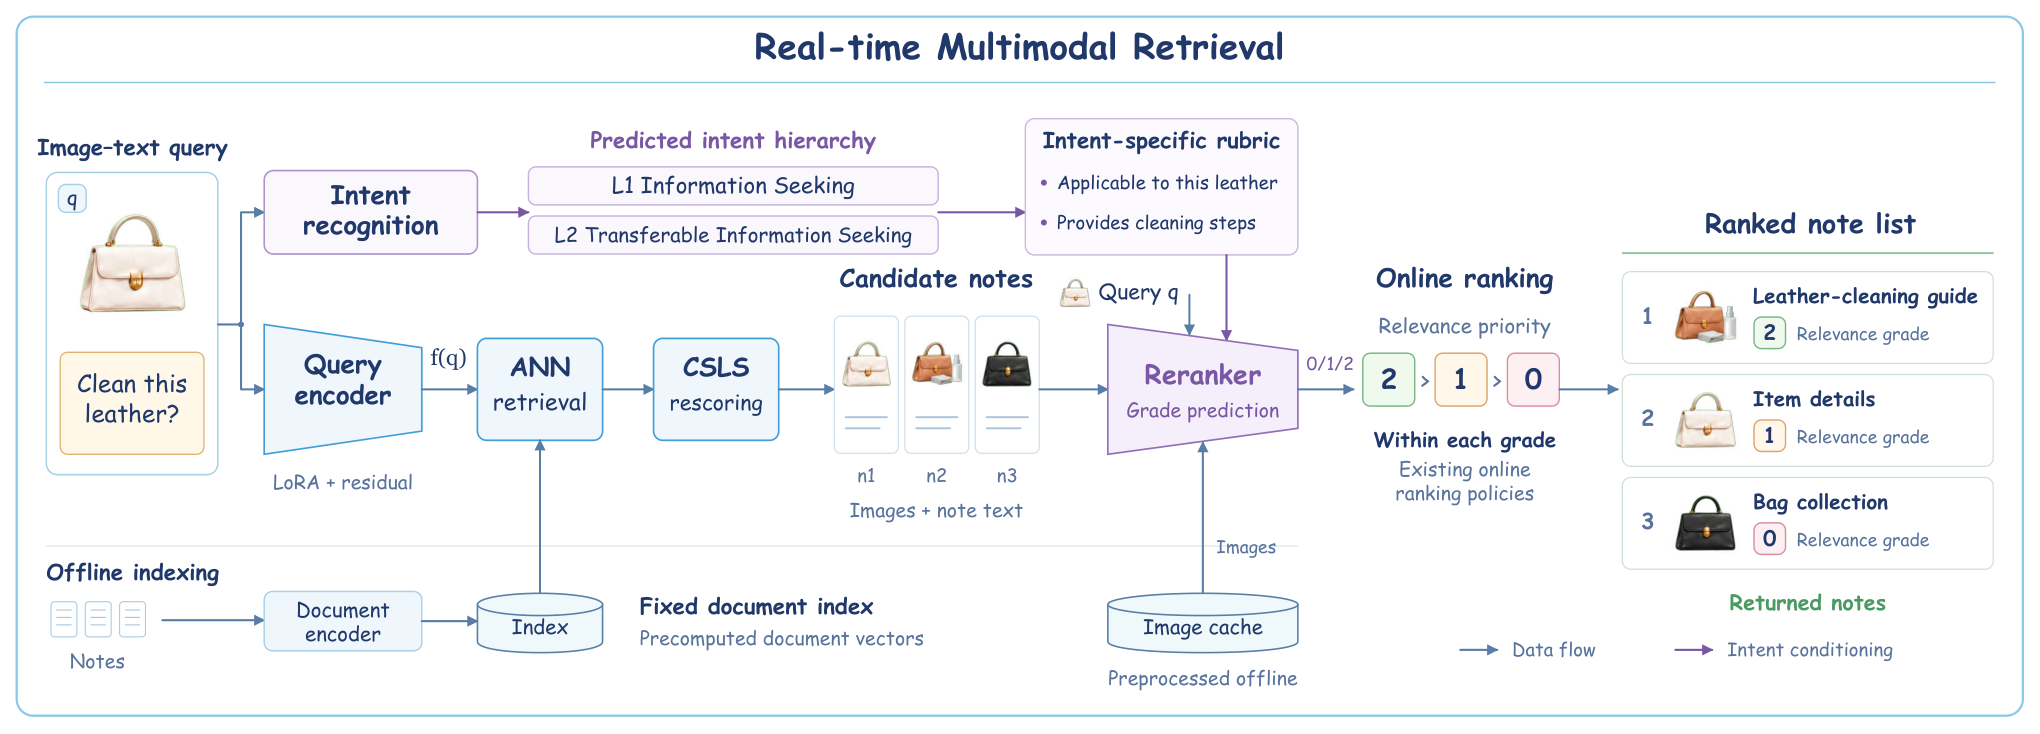
第四步,线上精排拿到识别器给出的两级意图,按对应标准预测三个相关等级,再按「满足请求」优先于「有关但不够」、后者优先于无关来排序;同一等级里沿用已有的线上排序策略。问耐用性时,B 必须排到 A 前面,因为这时 B 才是满足请求的笔记。
第五步,这件事回推到召回。如果候选集仍按外观来,B 这类「看起来不像、但文字用得上」的笔记进不了精排,后面的等级排序也用不上。所以检索向量也要用同一套标准来学:正例是得 2 分、真正满足请求的笔记;难负例是看起来很像、却在关键条件上不合格的笔记,比如只有单件衣服、没有穿搭组合,或商品对了、却没有报价。查询向量和文档向量各自由指定区域、整图上下文和正文合成。线上检索时,识别出的意图不进入编码器,只送给后面的精排;查询编码和意图识别是同时进行的。候选 B 的耐用性说明写在正文里,会进入文档向量,召回才有机会把它找出来。
意图识别是一个 0.8B 的生成模型,只输出两级意图标签。在 390 条人工标注查询上,二级准确率是 91.54%,和教师的 91.79% 接近,说明这个紧凑模型已经可以放到线上用。精排同样是 0.8B 模型,输入查询、候选和意图,只输出等级。
训练里,这三个等级还会变成排序监督。增益按 2 的 r 次方减 1 计算:2 分是 3,1 分是 1,0 分是 0。于是 2 分和 1 分的增益差是 2,1 分和 0 分的差是 1。位置折扣和分数差距相同时,把「真正答上」排到「只是相关」前面的那对组合,加权损失是后一对的两倍。这条损失会把 2 分笔记更靠前推。
换相关规则之后,召回差多少
离线对比里,通用匹配规则和意图特定规则共用同一套数据来源、候选获取流程、数据量和训练设置,只改用来构造正例和难负例的相关规则。评测只把 2 分笔记当作命中。测试查询 2 万条,对照两个候选库,分别有 512,655 和 1,904,054 篇笔记。
在 190 万候选库上,总体前一命中从 45.51% 升到 66.09%,差 20.58 个百分点。单品搜索从 16.25% 升到 59.09%,穿搭造型从 2.49% 升到 40.21%。这两类请求靠的是型号是否对应、有没有穿搭关系,通用的「长得像」规则最容易把正例和难负例搅在一起,所以换规则以后提升也最大。
| 意图 | 通用规则 Hit@1 | 意图规则 Hit@1 | 差值(百分点) |
|---|---|---|---|
| 单品搜索 | 16.25% | 59.09% | +42.84 |
| 穿搭造型 | 2.49% | 40.21% | +37.72 |
| 针对目标的信息寻求 | 44.65% | 70.65% | +26.00 |
| 可迁移信息寻求 | 65.30% | 58.46% | -6.84 |
| 总体 | 45.51% | 66.09% | +20.58 |
(数字来自论文表 4,1.9M 候选库,指标为前一命中 Hit@1。)
针对目标的信息寻求,前 100 召回从 52.77% 升到 85.61%。那换了规则,第一条就一定更准吗?可迁移信息寻求的前 100 召回从 66.24% 升到 85.97%,前一命中却从 65.30% 降到 58.46%。这说明意图规则能把用得上的说明找进列表,但还没有稳定地把最该看的那一条排到第一。这组对比能证明的是:其他条件对齐时,相关规则本身会改变召回。它不能证明每条意图的第一条命中都会变好,也不能直接解释线上点击为什么上升,因为线上对照的是原来的视觉检索加精排,对照对象里没有这个通用规则模型。
分档排序和蒸馏把 190 万库上的前一命中从 66.09% 推到 67.70%。查询侧适配在不重算文档向量的前提下,再把前一命中推到 68.54%。随后用 CSLS(跨语言词向量对齐里用来按局部邻域密度改分数的方法,这里用来校正候选分数)把分数校正到 68.84%。这些增量出现时,意图规则下的 Hit@100 已经是 98.57%,说明后面几步改善的是已经找得到之后的头部排序。
线上是两套累加配置,都对比同一套「先按图检索再精排」的生产对照。只加意图识别和意图条件精排时,前四条查询点击率相对提升 21.65%,查询点击率相对提升 15.12%,人均停留时长相对提升 9.66%。再加入多模态召回,三项变成 28.17%、18.96% 和 12.56%。三项一起升高,说明把意图标准同时用到召回和精排,线上互动也会跟着走高。
| 配置 | 前四条查询点击率 | 查询点击率 | 人均结果页停留时长 |
|---|---|---|---|
| 意图识别 + 意图条件精排 | +21.65% | +15.12% | +9.66% |
| 再加多模态召回(IntentFlow) | +28.17% | +18.96% | +12.56% |
(数字来自论文表 1,均为相对同一生产对照的百分比变化。)
这对做社区图文搜索的人意味着什么
如果同一张图配上不同问法,你的相关标注却不变,那么「找同款」的正例会污染「这件怎么护理」的训练。
先写下每类请求怎样才算满足,再把这套标准同时用于召回监督和精排。检查时可以固定参考图和候选集,只改那句话,看正例会不会换人。如果精排只吃视觉检索的候选,像候选 B 这样「看起来不像、但文字用得上」的笔记,你排不到它。
索引要迭代时,IntentFlow 把文档向量固定下来,只适配查询侧。在 190 万库上,这一步把前一命中从 67.70% 升到 68.54%,代价比整库重算小。
局限
意图识别的 33 个二级错误里,有 15 个出在「必须针对图中目标」和「允许迁移」这条边界上。两类都在找文字信息,差别只在答案是不是必须关于指定对象。精排在 5,977 对查询-候选上的三档准确率是 73.05%,仍有 26.95% 被分错档,说明三档判断还有明显误差。离线检索评测用的是 50 万和 190 万候选库,线上索引是百亿量级;线上报告的是相对生产对照的点击率和停留时长,没有报告离线相关性指标本身。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…