目录 · 9 节
1一次请求从拍照到出排序,要走哪几步2那句含糊的话,怎么变成一段明确的查询3几十家候选店的信息,为什么不用大模型逐家去读4两家店的名次是怎么翻过来的5大模型调了工具,怎么知道这次调得值不值6测试题是作者自己出的,这些分数能信到什么程度7IntentLens 的分数高在哪,又输在哪8换一批题、换一种问法,IntentLens 的提升还在吗9一次请求 4 秒,IntentLens 能用在哪
用户拍一张照片、说一句含糊的话时,推荐系统最该补的是这句话里缺的信息:IntentLens 先用工具把这些信息查出来、写成明确的文字,再交给一个计算量很小的双塔模型给候选店排序。
IntentLens 这篇论文举的例子很日常。用户用智能眼镜的摄像头对着咖啡馆的一道菜,说「要这种感觉,但便宜点、适合附近快速吃个午饭」。推荐系统手里有附近同品类的几十家店,要给这几十家店排序,让这位用户想去的店排在最前面。下文一直用这个例子。除了用户这句话,下文的店铺、色温和分数都是我为讲解编的,出现时都标「示意」。
这句话的麻烦在于,决定推荐哪家店的三条信息分散在照片、用户历史和候选店资料三个地方,用户的原话里一条也没写明。「这种感觉」在照片的像素里,可能是偏黄的灯光和木色的桌面。「便宜点」要对照这位用户平时去什么价位的店,价位线索在用户的历史评论里。「快速吃个午饭」要看候选店中午开不开门、评论里有没有人说出餐快,商家简介常常不写营业时间和出餐速度。
最直接的做法是把照片转成一段文字描述,和原话拼成查询,再用文本 embedding 算查询和每家店简介的相似度,按相似度排序。论文里的基线 BGE Retrieval 就是这么做的。放回这个例子(示意):一家人均 40 美元的精品咖啡馆,简介里写满了咖啡馆和意面,和查询的相似度很高。街角一家人均 12 美元的简餐店,简介只写「三明治和汤」,和查询的相似度低,于是排到了后面。两家店的简介里都没有「便宜」和「快」对应的内容,相似度也就反映不出用户这两个要求。
另外两类现有做法同样接不住这个请求。第一类是多模态推荐系统,它们把图片和文字当作商品的额外特征,再按用户的历史交互匹配商品,用户此刻拍的照片和说的话基本进不了匹配。这位用户过去常去早午餐店,系统就继续推早午餐店(示意)。第二类推荐系统假设用户已经用文字写全了要求,比如「暖光、人均 15 美元以内、中午营业」,可这位用户只说了「便宜点」。
IntentLens 改的是排序之前这一步。请求到来后,一个能同时读图和文字的多模态大模型(论文叫 MLLM,实现用 Qwen2.5-VL)先选工具,例如估算照片的色温、检索用户的历史评论、读取候选店的价格。大模型再把这些工具查到的结果写成明确的查询文本。作者做了一个只改一处的对照,用的是 Google Review-MMTool(作者用 Google 本地评论造的测试集)。排序模型、候选池和候选店的信息全部固定,只把查询文本从用户原话换成多模态大模型查完工具后写出的版本。结果 MRR(论文按百分制报告,下同)从 33.6 升到 40.2。这说明,同一个排序模型单靠查询文本写得更明确,就能多拿 6.6 分。
一次请求从拍照到出排序,要走哪几步
下面这张表是全程。前五步在每次线上请求时都会执行,第六步只在训练大模型时执行。
| 步骤 | 输入 | 操作 | 产出 | 只在训练时? |
|---|---|---|---|---|
| 1 第一轮规划 | 照片、原话、用户 ID,不含候选店 | 多模态大模型生成有序的工具计划 | 一段 JSON 计划 | 否 |
| 2 执行工具 | JSON 计划、照片、由历史评论整理成的用户记忆 | 外部工具程序依次运行计划里的视觉工具(分析照片)和记忆工具(读用户历史) | 色温、主色、用户偏好等工具结果 | 否 |
| 3 第二轮写查询 | 照片、原话、工具结果 | 多模态大模型写出澄清查询(把含糊要求写明确后的查询),并挑选候选侧工具(查候选店属性的工具) | 澄清查询和候选侧工具名单 | 否 |
| 4 拼候选文本 | 每家候选店、第 3 步的工具名单 | 从缓存读出这些工具提前算好的结果,连同店铺简介按固定顺序拼接 | 每家候选店的一段文字 | 否 |
| 5 双塔打分 | 查询文本、候选文本 | 编码后算内积 | 候选店的排序 | 否 |
| 6 计算奖励 | 排序结果,以及不带工具结果的两次对照排序(下文细讲) | 算奖励,用 GRPO 更新大模型 | 更新后的多模态大模型 | 是 |
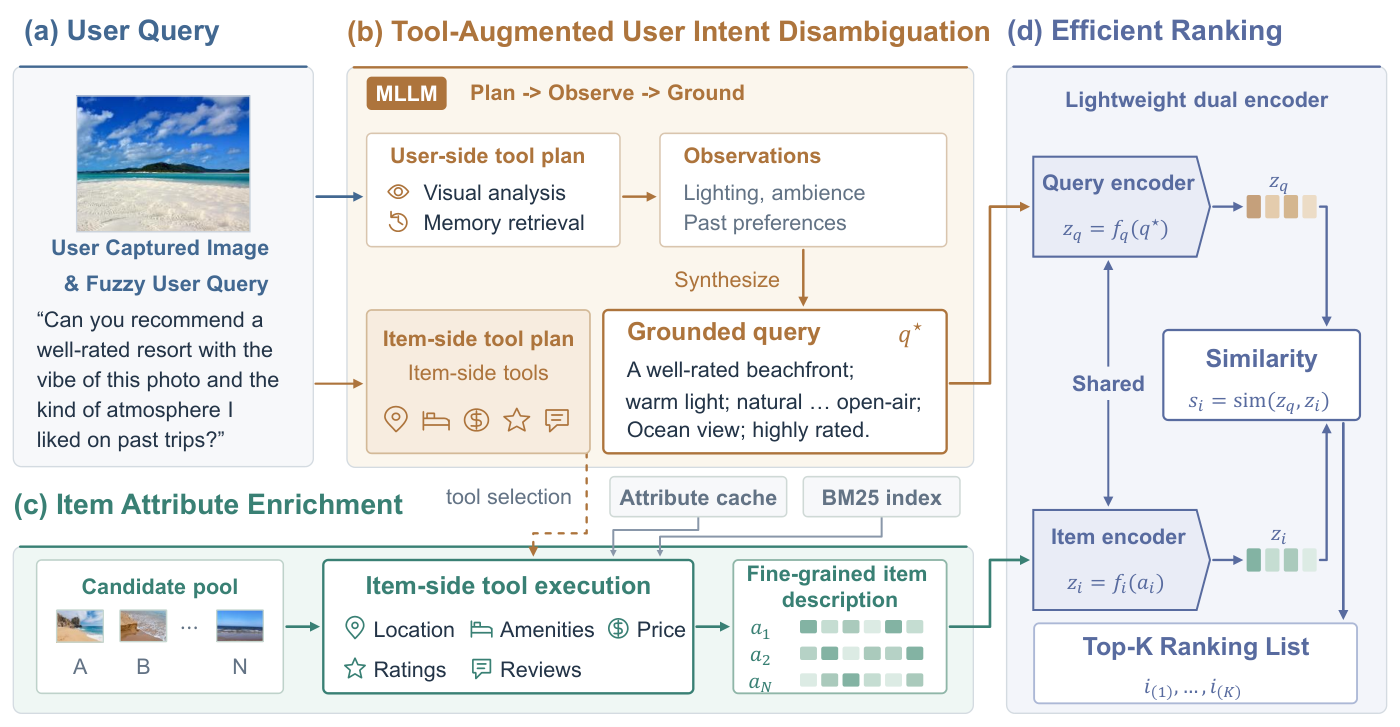
论文原图:多模态大模型先调用工具写出澄清查询,并选出候选侧工具。选中的工具再单独读取候选池里每家店的属性,最后由双塔给候选店打分。
这样分工后,多模态大模型只写查询、挑工具,给几十家店打分的工作全部交给双塔。大模型的调用次数因此不随候选店数量增加。
那句含糊的话,怎么变成一段明确的查询
第一轮要回答「该查什么」。多模态大模型可以从 8 个查询侧工具(处理用户这边的照片和历史的工具)里选。其中 5 个视觉工具负责裁剪、放大、取主色、算颜色直方图和估算色温。另外 3 个记忆工具负责取用户长期偏好的摘要、检索相关的历史评论和展开某条评论的完整内容。
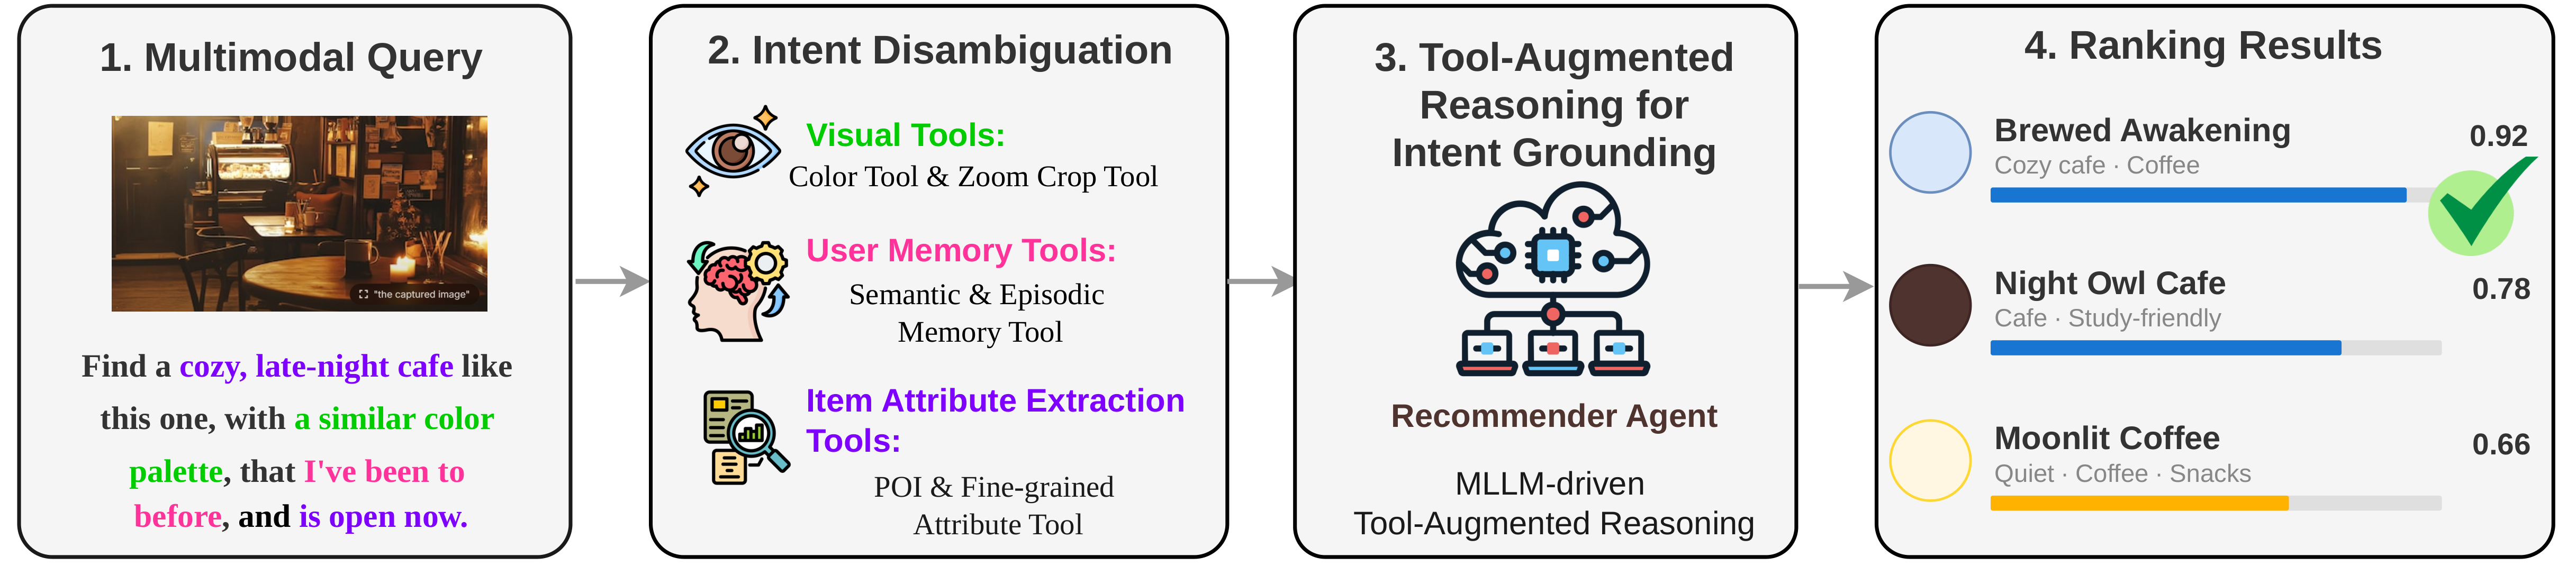
论文原图:视觉、用户记忆和候选属性三类工具分别补上一部分信息,最终产出澄清后的用户意图和候选店的具体属性(如价格、营业时间)。
这一轮的输出是一段格式严格的 JSON。咖啡馆的例子里,它大致长这样(示意,字段格式取自论文的 prompt):
{"actions": [
  {"id": "a1", "tool": "color_temperature", "input": "image_1", "arguments": {}},
  {"id": "a2", "tool": "dominant_color", "input": "image_1", "arguments": {}},
  {"id": "a3", "tool": "GetUserProfileSummary", "arguments": {}},
  {"id": "a4", "tool": "RetrieveUserMemory", "arguments": {"query": "午餐 价格"}}
]}
其中 image_1 指用户拍的那张照片,a1 到 a4 是每个动作的编号。计划里后一步可以用前一步的结果当输入。比如照片背景很乱时,计划可以先裁出菜品区域,再对裁出来的这块图算色温。
工具环境按顺序跑完计划,把结果还给大模型。假设四个工具分别返回(示意):色温约 3000K,主色是棕色和米白,用户画像是「偏好休闲小店,午餐预算不高」,历史评论里有一条「14 美元的简餐,上菜快,午休够用」。
第二轮大模型读这些结果,输出固定的三段(示意,最后的 TERMINATE 只是结束标记):
CLARIFIED QUERY:
附近的休闲午餐店,灯光偏暖(约 3000K),棕色和米白色调,
人均约 15 美元,中午营业,出餐快
ITEM-SIDE TOOLS:
["GetPrice", "GetHours", "GetReviewInsights"]
TERMINATE
CLARIFIED QUERY 下面这段文字就是整条流程的核心产物,也就是前面表格里的澄清查询。对照原话看,「这种感觉」变成了色温和颜色,「便宜点」变成了参考历史评论得到的人均约 15 美元,「快速吃个午饭」变成了营业时间和出餐速度。后面送进双塔的查询文本,就是澄清查询加上这四个工具返回的结果,下文把这些结果叫工具证据。
为什么不让大模型每跑完一个工具就重新规划一次?因为每重新规划一次,就多一次大模型调用。示意:一次请求要用 4 个工具,逐步规划要调用 5 次大模型(开始时规划 1 次,每跑完一个工具再规划 1 次),两轮结构固定调用 2 次。代价是大模型在第二轮不能再调用工具。工具报错或证据不够时,prompt 要求大模型在澄清查询里如实保留不确定的部分,不许编造偏好。
几十家候选店的信息,为什么不用大模型逐家去读
用户这边的请求写清楚了,候选店那边还是只有「三明治和汤」这样的简介。最直接的补法是把候选店全部放进大模型的上下文,让大模型逐家读,但候选店越多,大模型每次要读的内容就越长,所以论文在第一轮和第二轮都不给大模型看候选店。
论文改用 6 个候选侧工具:查店铺详情、查评论摘要、查评分、查价格、查营业时间、按条件筛选。系统提前为每家店算好这些工具的结果并存进缓存,大模型在第二轮给出的工具名单只决定这次读取哪些结果。 Hoot 说

- 先有完整计划,再执行。第一轮一次写好 3 步(示意),环境依次执行,中途不回到 MLLM。后面的步骤可以用前面的结果,比如先裁图再取色。
- 记忆提前整理好。评论离线变成笔记和索引,用户画像也提前汇总。线上只取画像、按查询检索笔记,需要时再展开某一条,不重读全部历史。
- 候选侧 0 次 MLLM。第二轮定下商品工具后,候选只读缓存,所以请求到来时 GetReviewInsights 的结论已经在缓存里。选的工具不同,拼出的文本就不同,论文公式编码的正是这段拼好的文本。
- 算一下这次的账:MLLM 1+1=2 次,示意工具 2+1=3 次。第一阶段 3,590 ms 加第二阶段 515 ms 共 4,105 ms,第一阶段占 87%。
两轮 MLLM 是仅有的两次模型调用,记忆库和商品侧缓存是请求到来前备好的数据,clarified query 是交给排序的查询。图中请求沿用咖啡馆例子,工具步骤和返回内容都是示意。原文写到商品字段读缓存、不调 MLLM,没有展开缓存内容的生成过程,也没有说工程上是否缓存候选向量;图按论文公式画成先拼文本再编码。
出处
论文 §3 记忆笔记;§4.1 式 (1)–(4) 两轮流程与缓存的商品工具;§4.3 式 (10);附录 B.1 用户记忆工具与 Algorithm 1;附录 C 规划提示词;Table 5(b) 延迟。按上面的名单,两家店拼出来的文字大致如下(示意,$ 越多表示越贵):
精品咖啡馆:意面和手冲咖啡,木质内饰。价格档 $$$。营业 17:00–23:00。评论摘要:适合约会,上菜慢。图片色温 2900K,主色棕色。
>
街角简餐店:三明治和汤。价格档 $。营业 10:30–15:00。评论摘要:出餐快,午休够用。图片色温 3100K,主色棕色和米白。
每段末尾的色温和主色也是提前算好的。查询侧跑过哪种颜色工具,候选文本里就带上对应的颜色信息,这样查询文本里的「约 3000K」和候选文本里的色温才能放在一起比较。
示意:50 家店、3 个工具,一次请求要读 150 个字段,全部来自缓存,额外的大模型调用是 0 次。如果让大模型逐家总结,就要多调用 50 次。这说明读取候选店信息的开销只随候选店数量线性增长,而且完全不经过大模型。
两家店的名次是怎么翻过来的
查询文本和候选文本都备好后,排序这一步(论文称第二阶段,前面查工具、写查询、拼候选文本都算第一阶段)不再调用任何工具。同一个 BGE-M3 encoder 分别编码两边,取 CLS 向量做 L2 归一化,内积就是分数。
还是这两家店(示意)。用原话当查询时,精品咖啡馆得 0.7,简餐店得 0.5,用户想去的简餐店排第 2。换成澄清查询加证据后,精品咖啡馆得 0.6,简餐店得 0.8,简餐店排第 1。MRR 是把每条查询第一个正确结果名次的倒数取平均,这条查询的倒数从 1/2 变成了 1。
这个双塔要提前训练好。测试集是作者自己构造的,造题时就知道每条查询该调哪些工具,下文把这些工具叫标准工具链。作者跑标准工具链得到查询文本和候选文本,用 InfoNCE 训练双塔,负样本里难的那部分取同品类的其他店。训练完之后把它冻结,下一节要用它给大模型打分,排序模型不变,同一段输出拿到的奖励才前后一致。
大模型调了工具,怎么知道这次调得值不值
预训练的多模态大模型本来就会调工具,SFT 也能给它打底,但这些都不保证查回来的东西对排序有用。所以作者在 SFT 之后又接了一段强化学习微调(论文叫 RFT,reinforcement fine-tuning),奖励直接来自上面冻结的双塔,算法用 GRPO。
最简单的奖励是第一个正确结果名次的倒数,记作 。它分不清功劳:一条输出排得好,可能光靠澄清查询就够了,附在后面的工具证据根本没起作用。于是作者给每条输出多算两次排名,一次用同一句澄清查询但拿掉附在后面的工具证据(澄清查询里已经写进的色温、预算等信息保留不动),名次倒数记作 ,一次直接用用户原话,名次倒数记作 。三次用的候选文本完全相同。
这里 把负数截成 0。 取两项里较小的那个,所以一条输出要拿到正的加分,必须同时赢过「拿掉证据的澄清查询」和「用户原话」。下面用三条输出算一遍(示意):
| 这条输出的情况 | 带证据的排名和 | 拿掉证据 | 用原话 | 加减分 | |
|---|---|---|---|---|---|
| 证据有用 | 第 1 名,1 | 第 2 名,0.5 | 第 4 名,0.25 | 0.5 | +0.02 |
| 附加证据没起作用 | 第 2 名,0.5 | 第 2 名,0.5 | 第 4 名,0.25 | 0 | 0 |
| 证据添乱 | 第 4 名,0.25 | 第 2 名,0.5 | 第 4 名,0.25 | −0.25 | −0.02 |
第一行的 取 0.5 和 0.75 里较小的 0.5,先截到 0.1,再乘 0.2,得 +0.02。第三行的 −0.25 截到 −0.1,乘 0.2 得 −0.02。第二行最能说明这个设计。这条输出比用户原话好了 0.25,但一分加分都拿不到,因为拿掉附加证据后名次没变。这说明提升已经体现在澄清查询里,附在后面的工具证据没有带来额外增益。第三行的证据把名次拉低了,于是被扣分。
±0.02 看起来很小,它起作用是因为 GRPO 只在同一道题的 4 条采样之间比较,算优势时减去组内均值、除以组内标准差。示意:4 条采样都把简餐店排第 1,其中两条的证据有用(加 0.02),另两条的附加证据没起作用(不加分),奖励是 1.02、1.02、1.00、1.00(先不算工具奖励)。均值 1.01,标准差约 0.01,归一化后约等于 +1、+1、−1、−1。名次打平时,这点加分决定了哪些采样的优势为正,模型就朝生成这些输出的方向更新。
奖励里还有一项管工具选得准不准。如果只奖励排序,多调几个工具几乎没有代价。作者把模型选的工具和标准工具链对比,在查询侧和候选侧各算一个 F1,再按多余工具的占比扣分,系数是 0.3。示意:候选侧共 6 个工具,标准答案是价格和营业时间,模型多选了评分。查准率 2/3,查全率 1,F1 是 0.8。多余 1 个占 1/6,扣 0.05,这一项得 0.75。作者记录到,训练过程中工具选择的 F1 持续上升,工具调用频率下降,也就是多余调用在减少。
最后一处改动在 RFT 的 loss 计算上。一条轨迹里混着两种 token:大模型自己采样出来的计划和澄清查询,以及工具返回的「3000K」这类结果。工具结果要留在上下文里,第二轮才读得到,但计算 policy loss 和 KL 时把这些位置排除,论文称之为 observation masking。示意:一条轨迹里大模型生成 100 个 token,工具返回 300 个 token。不排除的话,loss 里四分之三的 token 都不是大模型采样出来的,却会被当成大模型的输出去更新。
测试题是作者自己出的,这些分数能信到什么程度
现成的数据集里没有「照片加含糊请求」这种查询,作者就从 Google Local Review 和 Yelp 2019 各造了一个。Google Review-MMTool 有 773 条查询,平均每条 40 家候选店、3.2 家正确答案。Yelp-MMTool 有 1,727 条查询,平均每条 63 家候选店、2.0 家正确答案。这组数字说明,这里考的是在几十家附近的店里把两三家正确答案排到前面,和从全量商家里召回是两回事。
造题的方向是倒着来的。作者先定好工具组合,在用户历史和参考照片上跑一遍工具,让 LLM 把工具结果写成明确的需求,再改写成含糊的说法。示意:明确版是「找一家 3000K 暖光、价格档 $ 的午餐店」,改写后是「要这种感觉,但便宜点」。改写后露出颜色名、精确评分或价格符号的句子会被过滤掉。查询按需要的工具分成四档:只要视觉工具,视觉加用户记忆,视觉加候选属性,三类全要。
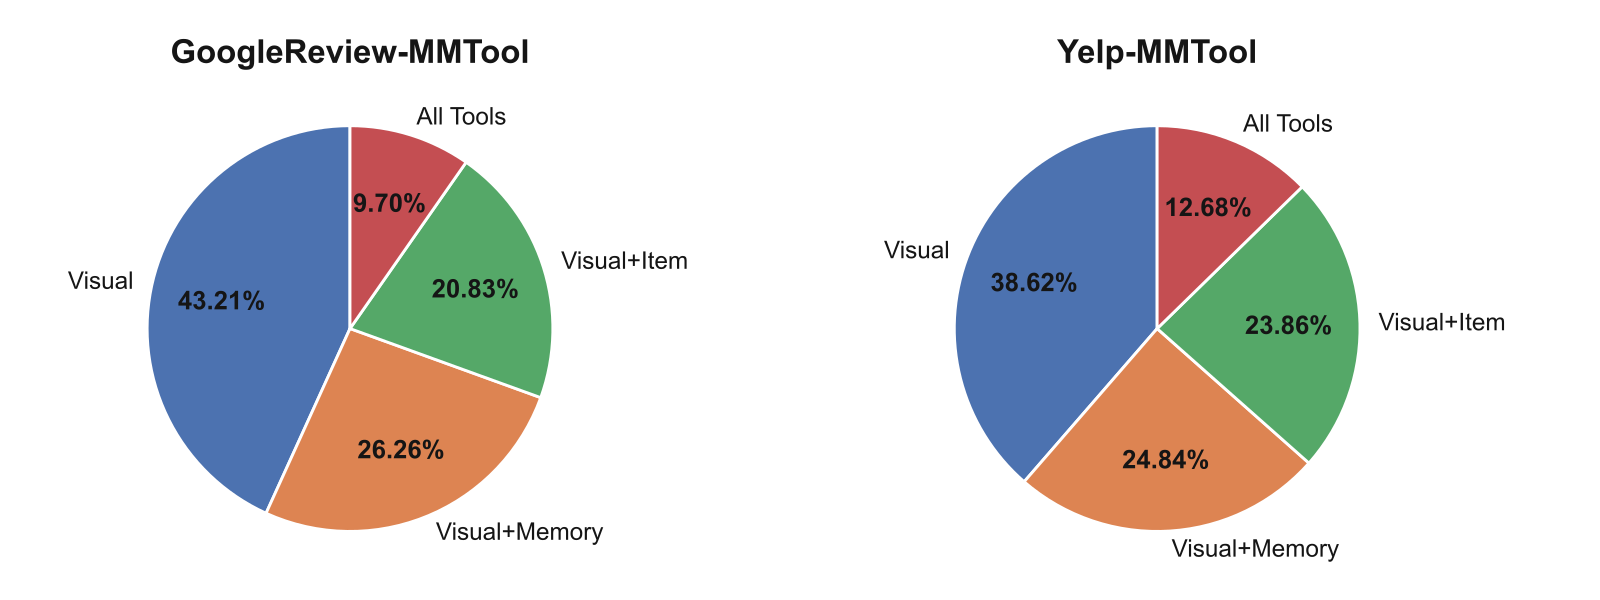
论文原图:四档查询(T1 到 T4)在两个测试集上各占多少。T1 到 T4 依次对应上面四档,档位越高,一条查询需要的工具越多。
候选池来自附近同品类的店,里面特意放了难的负样本(容易被排到前面的错误答案):照片风格很像的店、和用户历史矛盾的店、和这次场景矛盾的店,另外还有随机的店。一家候选店要同时满足文字描述、照片风格、用户偏好和店铺属性四方面的要求,才算这条查询的正确答案。
三位外部标注者抽查了 400 条查询,374 条(93.5%)合格,合格指语句通顺、自然、读得懂,并且确实需要外部证据才能解答。他们在看不到正确答案标记的情况下,确认了 1,290 家标为正确答案的店里的 1,224 家(94.9%)。这说明题目大体通顺、标注大体可靠。
抽查解决不了另一件事:查询、标准工具链和正确答案出自同一条造题流程,作者承认这可能带来语言、文化、偏好和所用模型方面的偏差,也会让结果依赖这条流程。作者因此又补了没参与训练的排序模型和人工盲评,这两项结果放在后面。
IntentLens 的分数高在哪,又输在哪
所有方法排的都是同一批候选店。主要结果如下,分数都是 MRR。
| 方法 | 怎么排序 | Yelp | |
|---|---|---|---|
| BGE Retrieval | 照片描述拼原话,算文本相似度 | 25.7 | 32.2 |
| Qwen2.5-VL 7B 直接排 | 不用工具、不看历史,由大模型直接输出候选店排序 | 28.0 | 25.4 |
| UniMP 式实现(3B) | 读照片、原话和历史评论,直接排 | 33.9 | 43.7 |
| GPT-5.4 | 只读原话和候选店资料,由模型直接输出排序 | 38.1 | 33.6 |
| GPT-4o | 读照片、原话和候选店资料,由模型直接输出排序 | 36.8 | 41.4 |
| GPT-5.4 带证据 | 读 IntentLens 产出的澄清查询和证据 | 41.6 | 41.5 |
| IntentLens 3B | 完整流程,大模型用 3B | 34.5 | 33.5 |
| IntentLens 7B | 完整流程,大模型用 7B | 40.2 | 46.7 |
| Oracle Ranker | IntentLens 用的 BGE-M3 双塔,读测试集里标注好的澄清查询和证据 | 44.4 | 53.7 |
同样是 Qwen2.5-VL 7B,直接给候选店排序只有 28.0 和 25.4,放进完整流程后是 40.2 和 46.7。这说明光有多模态大模型不够,分数差来自工具调用、强化学习微调和下游排序这一整套流程。
GPT-5.4 读原话时是 38.1 和 33.6,读 IntentLens 产出的文字后升到 41.6 和 41.5。这说明澄清查询和证据换一个排序模型也有用,价值并不绑定在双塔上。
这张表也说明 IntentLens 没有全面领先。Google 上带证据的 GPT-5.4 比 IntentLens 7B 高 1.4 分,两者 Hit@1 都是 31.0。Yelp 上 IntentLens 7B 的 46.7 高于 41.5。这说明读同样的证据时,便宜的双塔在 Google 上略低于 GPT-5.4,在 Yelp 上更高。
大模型的规模影响很大。从 3B 换到 7B,MRR 在 Google 上从 34.5 升到 40.2,在 Yelp 上从 33.5 升到 46.7。3B 版在 Yelp 上甚至低于同样用 3B 模型直接排序的 UniMP 式实现(43.7)。作者的解读是,模型能力足够时,工具使用才能完全发挥作用。
回到开头的对照,这次把第三个数也放上。同一个双塔、同一批候选文本,查询文本用原话是 33.6,用大模型写的版本是 40.2,用标注好的版本是 44.4。大模型写的查询把这段 10.8 分的差距补上了 6.6 分,还差 4.2 分。在 Yelp 上,IntentLens 7B 离 Oracle Ranker 还差 7.0 分。这说明排序模型不变时,第一阶段写出的查询还有提升空间。Oracle 只代表这个双塔读到标注输入时的分数,不是所有系统的上限。
拆开各部件的消融都在 Google 上做,完整版是 40.2。工具这组里,查询侧工具一个都不跑时掉到 33.5,只关视觉工具是 35.7,候选店只用原始简介是 38.0,只关记忆工具是 38.1。这说明查询侧的补全影响最大,单类工具里视觉工具影响最大。我的理解是,这也和造题方式有关,因为四档查询全都需要视觉工具。
训练目标这组里,只用 SFT、不做 RFT 是 33.1,奖励里不做那两次无证据对照是 35.0,loss 里不排除工具返回的 token 是 35.1,去掉候选侧工具选择奖励是 35.5。拿掉任何一项都掉 4.7 到 7.1 分。这说明只靠 SFT 不够,前面讲的那几处奖励和 loss 设计各自都影响分数,其中 RFT 整体的影响最大。
换一批题、换一种问法,IntentLens 的提升还在吗
作者先测了三种迁移。训练和测试都在同一个数据集上时,MRR 是 40.2 和 46.7。一部分店铺品类不参与训练、只在测试时出现,两个数据集分别降到 36.2 和 43.5。一部分工具不参与训练,是 35.8 和 44.1。在另一个数据集上训练,是 34.7 和 38.9。这说明换品类、换工具配置的损失相对小,跨平台的损失最大。
为了检查学到的东西是否只对训练用的那个双塔有效,作者把 RFT 前后的大模型产出的查询和证据交给 all-MiniLM-L6-v2 排序,这个模型既没参与 RFT,也没在这批数据上调过。候选池固定时,用 RFT 之后的查询和证据比用 RFT 之前的,MRR 高 4.6 个点。这说明 RFT 带来的提升在没参与训练的排序模型上依然存在。
真人这边有两组结果。参与者只看图片和任务说明,看不到合成查询、候选店和标签,写了 100 条请求,其中 78 条通过质检。在通过质检的请求上,IntentLens 7B 不重新训练,MRR 比 BGE Retrieval 高 7.3 分。另外三位外部标注者在看不到系统名称的情况下,比较 100 条查询的前三名推荐列表。按多数票算,89% 的查询上 IntentLens 胜出,6% 的查询上 BGE Retrieval 胜出。
这两组说明提升不只存在于 LLM 合成的句子上。但它们的对手都是 BGE Retrieval,真人请求也是照着已有任务说明写的,所以还代表不了真实线上流量。
一次请求 4 秒,IntentLens 能用在哪
作者在单张 NVIDIA H20 上测了 7B 版本的延迟。第一阶段 3,590 ms,含 2 次大模型调用和 3 到 5 次工具调用。第二阶段 515 ms,只有双塔打分。合起来约 4 秒,这位拍照的用户要等 4 秒才看到结果。这说明要提速就得先压第一阶段,双塔已经不是瓶颈。
这个延迟的条件是每条查询 40 到 63 家候选店,候选工具的结果都已缓存。所以 IntentLens 在这里做的是给一小批附近的店重排序,还不能代表从全量商家里召回的开销。系统还要读取用户拍的照片和个人历史,真要上线得解决隐私和授权问题,作者也把这一点列为部署障碍。
回到那张咖啡馆的照片。排序模型自始至终是一个 BGE-M3 双塔,变的是送进去的文字:「要这种感觉」变成了约 3000K 的暖光和棕色米白色调,「便宜点」变成了这位用户的预算。排序模型和候选都固定时,这一步值 6.6 分 MRR,而大模型写的查询离标注查询还差 4.2 分,后续最该继续打磨的也正是这一段。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…