
电商搜索要判断“这个商品和用户的搜索词相不相关”,现在很多团队用大模型来做。京东这篇论文发现,大模型持续判错的难例里,六成以上不是推理过程有问题,而是模型压根不知道相关的领域知识:不认识某个小众品牌的俗称,或者拿不准“勉强相关”和“完全相关”的分界。所以继续用强化学习优化推理过程帮不上忙。论文提出 K-CARE(Knowledge-driven Contextual Anchoring and Analogical Prototype Reasoning):给模型补两类外部知识,一类是从搜索行为里来的(这个词搜出过哪些商品、这个商品被哪些词搜到),一类是一批专家判过、附带理由的难例。在 12.4 万条人工标注测试集上,三档相关性的 Macro F1 从强化学习基线的 81.18 提到 82.58;线上前 10 条结果里出现不相关商品的搜索词比例从约 12.10% 降到 11.39%。
做搜索相关性、尤其是想把大模型用到长尾词上的人值得读:它把“缺知识”和“推理差”分开处理,并且给出了从 8B 模型到线上小模型的落地方式。证据来自京东一个平台,所有实验只用了 Qwen3-8B 一个基座模型。
它到底在解决什么问题?
任务是三分类:给一个搜索词和一个商品,判断完全相关、勉强相关还是不相关。测试集的分布很不均匀,不相关 46.02%,勉强相关只有 11.83%,完全相关 42.14%。
论文把大模型的知识缺口分成两类:
- 不认识:俗称、新词、小众品牌、长尾品类,模型的参数里没有这部分知识,推理再仔细也推不出来。
- 拿不准边界:意思懂了,但“什么程度算勉强相关”这类细的判断标准不稳定。
同期很多工作用 DPO、GRPO 这类方法优化推理过程。作者的看法是,对第一类问题这没有用,因为参数里本来就没有可以展开的知识。
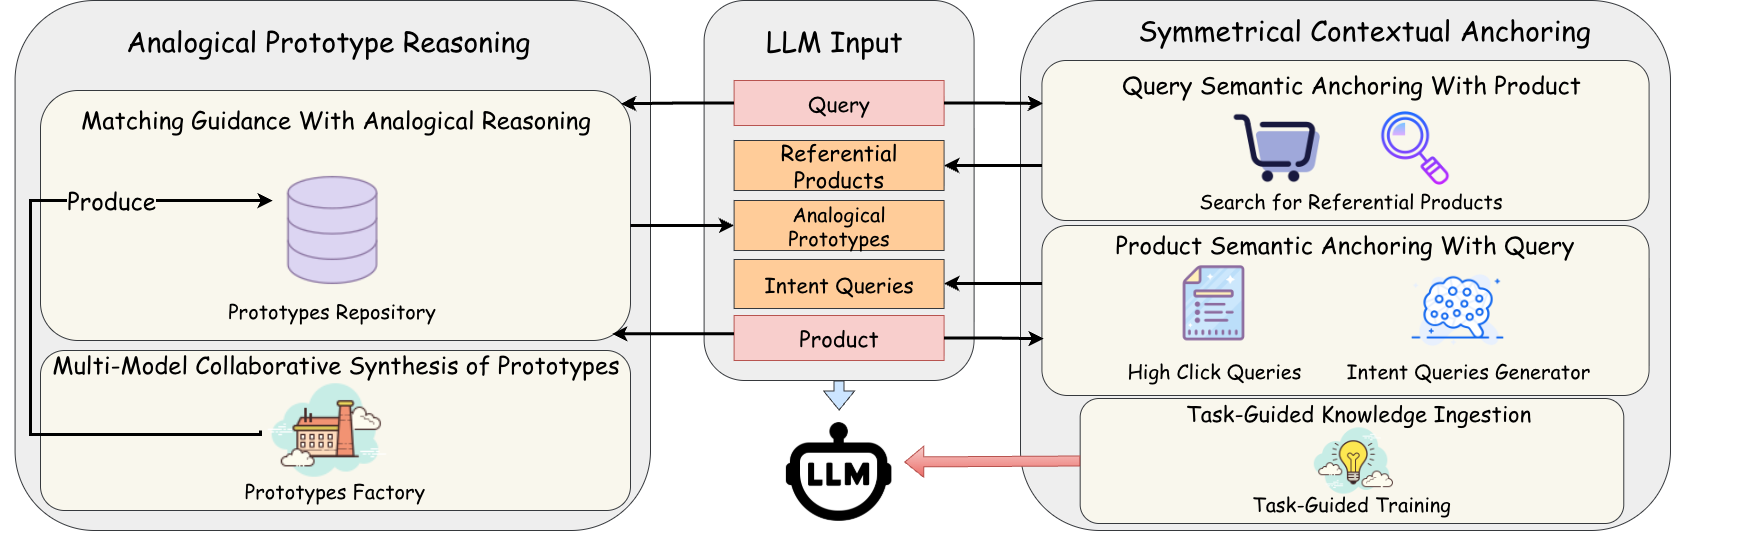
方法:补两类知识
第一类知识从搜索行为里来,作者称这部分为 SCA(Symmetrical Contextual Anchoring),有两个方向:
- 用商品解释搜索词:把搜索词直接丢给线上搜索系统,拿排在前面的商品作为参考,告诉大模型“这个词通常对应这些东西”。作者没有用点击日志,因为长尾词和新词的点击太少;线上排序结果覆盖所有词,虽然有噪声,但大模型能从有噪声的参考里提取有用信息。
- 用搜索词解释商品:商家写的商品描述偏营销,用户怎么搜才说明它实际是什么。作者训练了一个“商品→搜索词”生成模型,在历史点击日志上学,给每个商品生成 5 到 6 个可能的搜索词,小众商品也有。
参考信息塞进输入以后,模型不一定会用。所以作者先用四个辅助任务训练(论文叫 TGKI,Task-Guided Knowledge Ingestion):看搜索词和它的前排商品,说出搜索意图;看一个前排商品,预测可能的搜索词;看商品和点击过它的词,写出商品画像;只看搜索词,预测商品属性。这些任务的答案由更强的模型(GPT-5.2)生成。先训完这四个任务,再单独训主任务,分两步是为了避免辅助任务和主任务的梯度互相干扰。
第二类知识是专家判例,作者称这部分为 APR(Analogical Prototype Reasoning)。一条判例包括搜索词、商品、正确标签和一段判断理由,论文把这样一条叫原型(prototype)。判例库分四步自动构建:
| 步骤 | 做什么 |
|---|---|
| 挖难例 | 用一个稍弱的模型去判人工标注数据,留下它判错的那些 |
| 多模型提议 | 几个不同的模型分别判断“人工标签对不对”,并各自写理由 |
| 仲裁 | 一个更强的模型综合所有提议做最终判断,只保留认定人工标签正确的样本 |
| 语言质检 | 再用一个模型审核并润色理由,保证逻辑通顺 |
判断新样本时,把搜索词和商品拼起来,用向量模型编码,到判例库里找最相似的一条,把它和理由一起放进输入,让大模型照着这条判例的思路判断。
基座是 Qwen3-8B,在 32 张昇腾 910B 上训练 1 轮,推理用温度 0。
实验结果
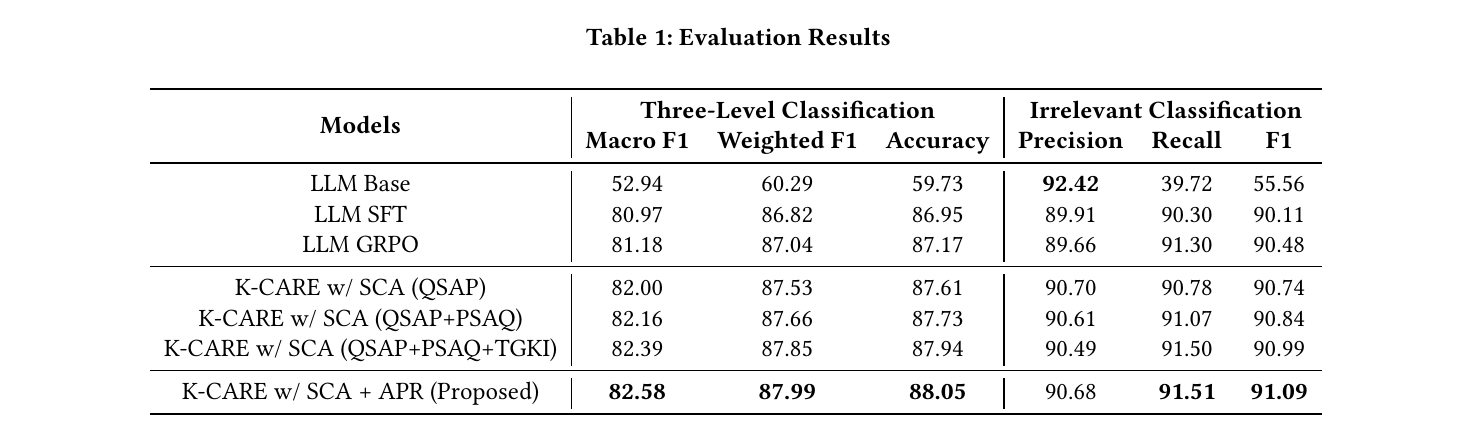
几个要点:
- 没有微调的 Qwen3-8B 判“不相关”的精确率高达 92.42%,召回只有 39.72%,因为它倾向于把大多数样本都判成相关。微调后召回升到 90.30%。
- 从强化学习基线(GRPO,Macro F1 81.18)到完整的 K-CARE(82.58),提升 1.4 个百分点。逐步加部件时,用搜索结果解释搜索词这一项单独贡献最大,Macro F1 从 81.18 到 82.00;其余每一步都只再加零点几,但每一步都是正的。
- 测试集有 12.4 万条,又是在已经做过强化学习的基线上比,所以这 1.4 个百分点意味着错例数量的实际减少。
线上不直接跑 8B 模型。作者让 K-CARE 在大量无标注数据上打相关性标签,再用这些标签训练一个 BERT 小模型上线,延迟比 8B 模型低一个数量级。线上实验选了 1 万个有代表性的搜索词,同时走三条通道:两条跑现有模型,一条跑蒸馏后的 BERT。指标是“前 10 条结果里至少有一个不相关商品的搜索词比例”:
| 通道 | 比例 |
|---|---|
| 现有模型 1 | 12.11% |
| 现有模型 2 | 12.09% |
| K-CARE 蒸馏的 BERT | 11.39% |
两条对照通道几乎一样,说明对照稳定;论文按此报告相对下降 5.87%。
局限
- 线上排序结果当参考必然带噪声,方法依赖大模型能容忍这些噪声。
- 判例库要人工标注加多个模型协作生成,成本不低。
- “商品→搜索词”模型本身要靠历史点击数据训练,完全没有历史的新平台用不上。
- 实验只用了 Qwen3-8B 一个基座;线上只用“前 10 条含不相关商品的比例”这一个指标衡量,换到更小的模型或以点击、成交为目标时,收益需要自己重新验证。
怎么借鉴
最容易复制的是“用线上搜索结果解释搜索词”:不用新数据,只要把排在前面的商品塞进输入,单这一项就是最大的收益来源。如果要加参考信息,先用几个辅助任务教模型怎么读这些参考,再训主任务。判例库成本较高,适合先针对最容易判错的几类边界情况建一个小库试效果。上线时照着它的做法,用大模型离线打标签、小模型在线服务,而不是直接上线大模型。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…