目录 · 6 节
1生成式推荐训练时少了一步比较2三个标记,把选择题接进 TIGER3走一遍:历史是两件商品,下一件要从三个候选里选4四个数据集上,相对 TIGER 提升多少5这对做生成式推荐的人意味着什么6局限
买了钢琴和耳机,系统却先推荐已经买过的琴凳:一道选择题怎么改生成式推荐
有人在乐器类目里先后买了 Yamaha 便携钢琴、配套琴凳、双 X 琴架,以及一副录音监听耳机。下一件他真正买下的,是一支 Blue Yeti 麦克风:从弹琴转到录音和直播,这是很顺的下一步。
原来的生成式推荐模型 TIGER 看完这段历史,给出的前三名却是:已经买过的那张琴凳,再加两件键盘配件。语义上都贴着「钢琴」,但没走到「这人在搭一套录音设备」。加上一道选择题辅助任务之后,同一套模型把这支 Blue Yeti 排到第一,第二名是麦克风防喷罩。
这篇论文来自台湾大学和 Coupang,讨论的是序列推荐里的生成式范式。现有做法里,TIGER 用 RQ-VAE 给商品编 SID。RQ-VAE 原本是把连续向量分层量化成离散记号的方法,这里用来把商品文本语义写成一串记号,再用 encoder-decoder 生成下一件的 SID。后来的方法 LETTER 在 SID 里加入协同信号并控制多样性,ETEGRec 把 tokenizer 和生成检索做成端到端训练,两者都要加更多对齐任务或约束。这篇把改动放在训练目标上:在 TIGER 里加一道选择题辅助任务,训练时让模型从候选里把下一件挑出来,推理时仍然直接生成,不用给候选。四个公开数据集上,相对 TIGER 的 NDCG@10 提升从 4.9% 到 79%。
训练时加一道选择题,就能给生成式推荐补上正负比较信号;文中的相对提升是对 TIGER 而言,在 Yelp 上 TIGER 本身明显落后于 SASRec。
生成式推荐训练时少了一步比较
TIGER 的主任务很直接:给定用户历史,最大化下一件商品各个 SID 记号的生成概率。训练里没有把「下一件」和「不是下一件」摆在一起比较。这和 BPR 的思路不一致。BPR 要的是正样本排在负样本前面。
后果有两头。一是模型容易只记住训练里见过的组合,遇到没见过的组合就弱。论文举过一个例子:喜欢吉他的人更常买吉他配件,很少同时买管弦乐相关的东西;这类组合在训练里几乎不出现,测试时就不稳。二是两件商品语义接近、行为模式却不同时,预先定好的语义 SID 会把它俩拉近,主任务又没有负样本来拆开。
选择题要做的事很具体。每次除了历史,再给模型看一个候选集合,里面有一件正样本,以及从用户没见过的商品里均匀抽出的若干负样本,让它生成正样本的 SID。候选每个 epoch 都会重抽,并且打乱顺序。
更简单的做法,是只在损失里加负样本,不把候选放进输入。先前也有工作用选择题,比如 P5,但商品常用原始 ID,并且依赖预训练语言模型的权重。这篇选择把候选的 SID 直接接到历史上,让模型在同一次前向里看见正样本和负样本,再生成正确答案。生成过程本身不依赖预训练语言权重。
三个标记,把选择题接进 TIGER
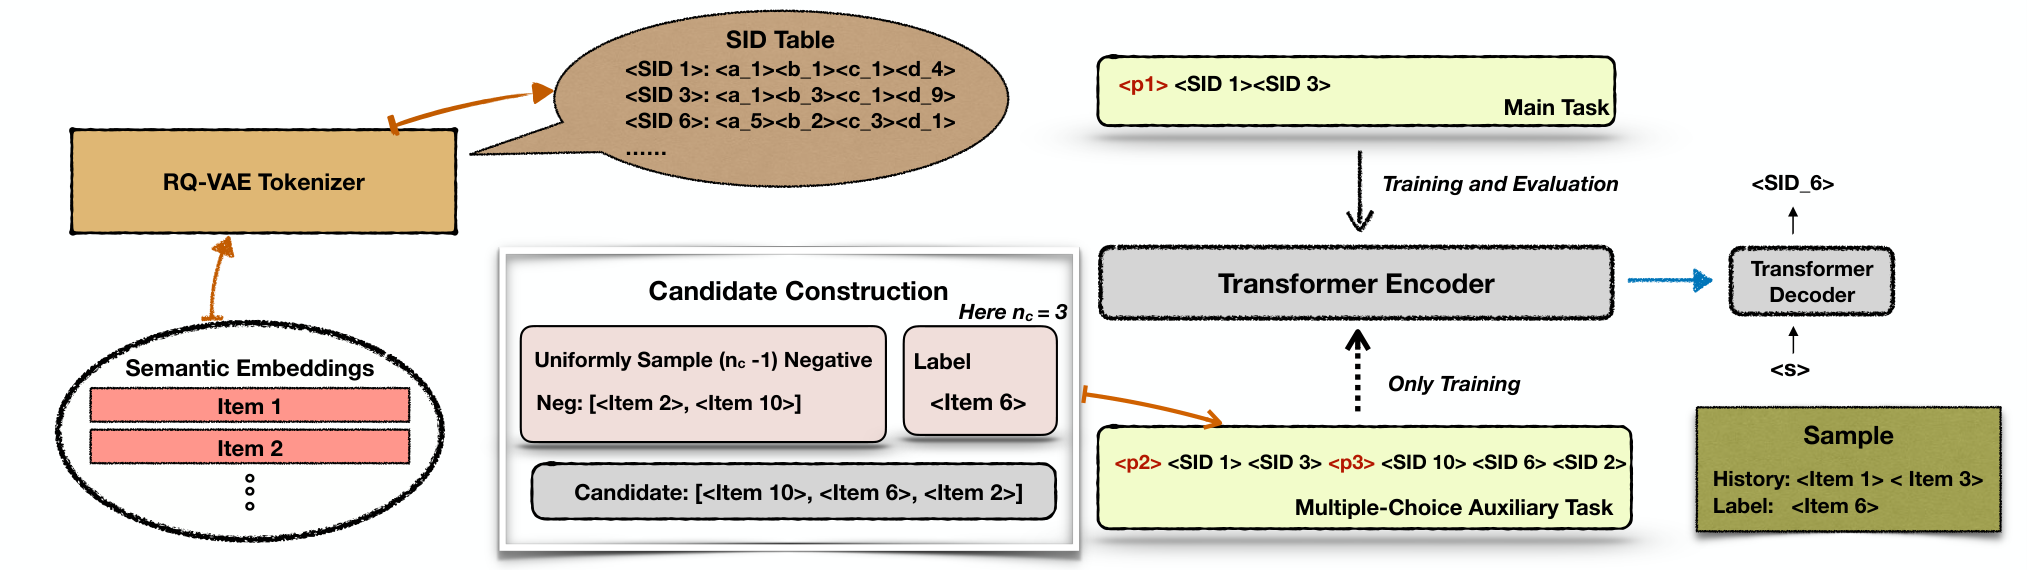
为了把两道题分开,作者加了三个可学习标记。p1 表示主任务,p2 表示选择题,p3 用来隔开历史和候选,各有独立的 embedding。主任务的输入是 p1 加上历史 SID,里面没有候选;历史部分仍按原来的 TIGER 方式组织。选择题的输入是 p2,加上历史 SID,再加 p3,然后接上打乱后的候选 SID。
两个任务的解码目标相同,都是下一件商品的 SID,这样是为了减少目标冲突。总损失就是两项负对数似然相加。每个 epoch 里,同一条序列会各走一遍主任务和选择题,batch 把两种样本混在一起抽。
候选数记作 nc,等于 1 个正样本加 nc-1 个负样本。当 nc=1 时,输入里没有负样本,只是把正确答案放进了输入,相当于在记答案。论文在若干数据集上仍看到提升,只是幅度通常更小。这说明哪怕只是把「这段历史对应这一件」再写进输入,也对测试有帮助。 Hoot 说
正文已经按图 1 走完 nc=3:历史是商品 1 和商品 3,选择题里打乱后的候选是 10、6、2,上线时不再给候选。这里只追一个还没拆开的边界:候选数降到 1、错误选项被拿掉以后,辅助任务还在训练什么。下面仍用同一条序列和同一个正样本商品 6。
nc=3 时输入里有 2 个负样本,正确答案旁边是错误 SID → nc=1 时负样本为 0,正负比较消失 → 解码目标仍是商品 6 的 SID,这仍是一道辅助训练题 → 若干数据集在 nc=1 仍有提升,但不能据此证明原因
- nc=3 的选择题输入 → 正确答案旁边还有 2 个错误 SID正文走一遍里,nc=3 表示 1 个正样本加 2 个负样本,打乱后商品 6 的 SID 旁边还有商品 10 和商品 2 的 SID。这一步仍然是在比较。nc − 1 = 3 − 1 = 2 个负样本
- 候选数降到 nc=1 → 输入里不再有负样本,正负比较消失当 nc=1 时,负样本个数是 1 − 1 = 0,p3 后面只接上商品 6 的 SID。输入里没有错误选项,正负样本不再被摆在一起比较。nc − 1 = 1 − 1 = 0 个负样本
- 解码目标仍是商品 6 的 SID → 这仍是一道辅助训练题解码目标没有改,还是下一件商品 6 的 SID,和主任务相同。所以 nc=1 虽然不再构成正负比较,却仍是在每个 epoch 里多做一道题:把「这段历史对应这一件」写进输入。目标 = 商品 6 的 SID,与主任务相同
- 若干数据集在 nc=1 仍有提升 → 不能据此证明原因论文在若干数据集上仍看到提升,只是幅度通常更小。这只能说明多做了这道辅助题之后测试数字可以变好,并不能证明提升来自比较信号,或来自把答案放进输入。nc=1 的提升 ≠ 已证明的原因
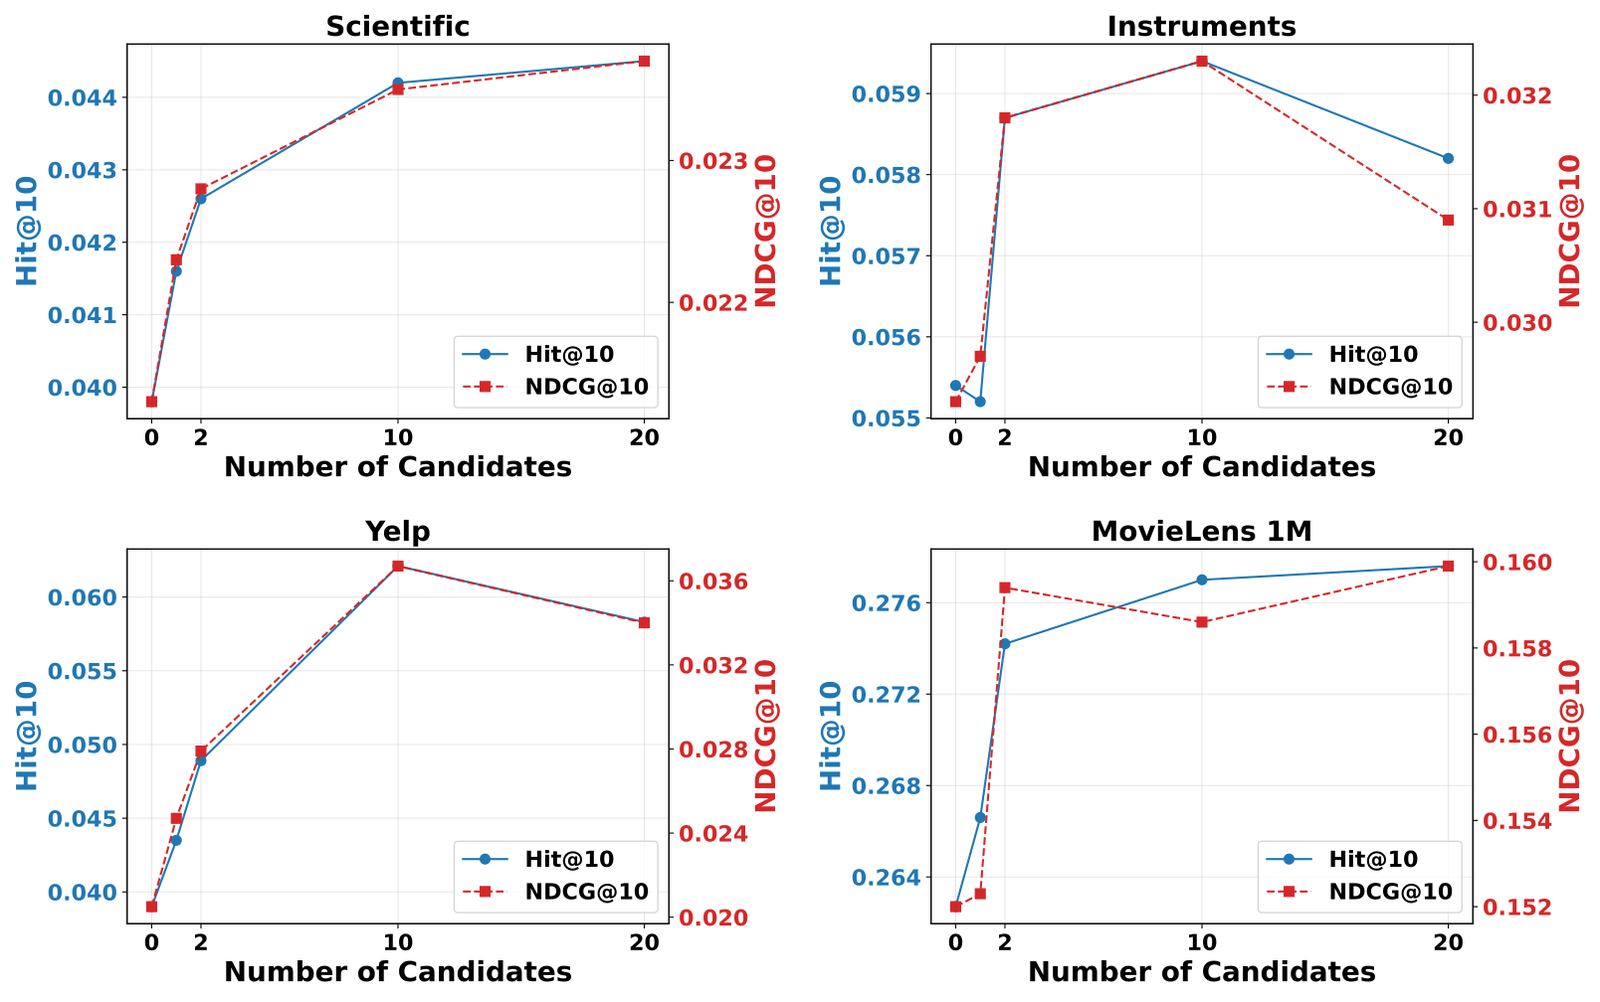
图 2 的横轴上有 nc=0(原来的 TIGER)和 nc=1。下面只用来对照这个边界,不重述 nc=10、nc=20 的走势。
出处
正文与论文 §3.2 / Figure 1:nc 等于 1 个正样本加 nc-1 个负样本;图 1 示例是 nc=3,正样本为商品 6,打乱后的候选是 10、6、2。§4.2 与正文:nc=1 时输入没有负样本,若干数据集仍有提升,幅度通常更小。Figure 2 的横轴含 nc=0(原 TIGER)和 nc=1。推理和验证都只用主任务。上线时不给候选,用大小为 20 的约束 beam search 生成 SID。早停也只看主任务的验证损失。
走一遍:历史是两件商品,下一件要从三个候选里选
下面按论文图 1 的例子走一遍,候选数 nc=3。商品编号来自这张图。开头那条钢琴和麦克风的真实记录来自论文表 6,用来对照训练之后排序会怎么变。
第一步,看输入和标签。历史是商品 1 和商品 3,要预测的下一件是商品 6。RQ-VAE 把每件编成 4 个记号,商品 6 写成 a5、b2、c3、d1。
第二步,做主任务。输入是 p1,加上商品 1 和商品 3 的 SID。解码器要从头写出商品 6 的 4 个记号。这一步和上线推理时用的格式相同,输入里没有候选。
第三步,做选择题。从用户没见过的商品里均匀抽出 2 个负样本,这里是商品 2 和商品 10,再和商品 6 打乱,得到候选顺序:10、6、2。输入变成 p2,加上历史 SID,再加分隔标记 p3,然后接上这三个候选的 SID。解码目标仍然是商品 6 的四个记号。这样,答案就在输入里,旁边还摆着两个错误的 SID。
第四步,把两个任务的负对数似然加在一起,更新同一套 encoder-decoder。一个 epoch 里,这条序列会各走一遍主任务和选择题。
第五步,测试时只走第二步:不给候选,用大小为 20 的约束 beam search 生成。论文表 6 里,只做主任务的 TIGER 把已经买过的琴凳排第一;按上面的方式加了选择题训练之后,第一名变成 Blue Yeti 麦克风,也就是真实的下一件。
这组安排能说明的是:推理方式不变,只改训练,排序就会变。它不能说明上线时如果也给候选会怎样,因为论文默认推理不用候选。作者另外做了一次检查:如果在测试样本上真的构造候选,模型几乎总能把第一名落在候选集合里,准确率接近 1.0。
四个数据集上,相对 TIGER 提升多少
实验用了四个公开数据集:Amazon 的 Scientific 和 Instruments、Yelp,以及更稠密的 MovieLens 1M。预处理是 5-core 过滤和 leave-one-out,历史最长截到 20。SID 用 Sentence-T5 的文本 embedding,再经 4 层、每层大小为 256 的 RQ-VAE 得到。
下面这张表只看 NDCG@10。TIGER+nc=10 表示训练时每个选择题放 10 个候选。SASRec 是传统的自注意力序列模型,用来对照生成式底座本身强不强。
| 数据集 | SASRec | TIGER | TIGER+nc=10 |
|---|---|---|---|
| Scientific | 0.0193 | 0.0213 | 0.0235 |
| Instruments | 0.0272 | 0.0293 | 0.0323 |
| Yelp | 0.0383 | 0.0205 | 0.0367 |
| MovieLens | 0.1164 | 0.1520 | 0.1586 |
(数字来自论文表 3,指标是 NDCG@10)
相对 TIGER,四个数据集的 NDCG@10 提升分别是 10.3%、10.2%、79.0% 和 4.9%。最后这个 4.9% 来自 TIGER+nc=2 的 0.1594,因为 MovieLens 上 nc=2 比 nc=10 略好。论文表 3 注明,这些相对 TIGER 的提升在逐用户指标的配对 t 检验下显著(p<0.05)。Scientific 上,TIGER+nc=10 是全表最好。Yelp 上 TIGER 的 NDCG@10 是 0.0205,SASRec 是 0.0383,TIGER+nc=10 是 0.0367;同一表里的 Hit@10,TIGER+nc=10 是 0.0621,SASRec 是 0.0613。
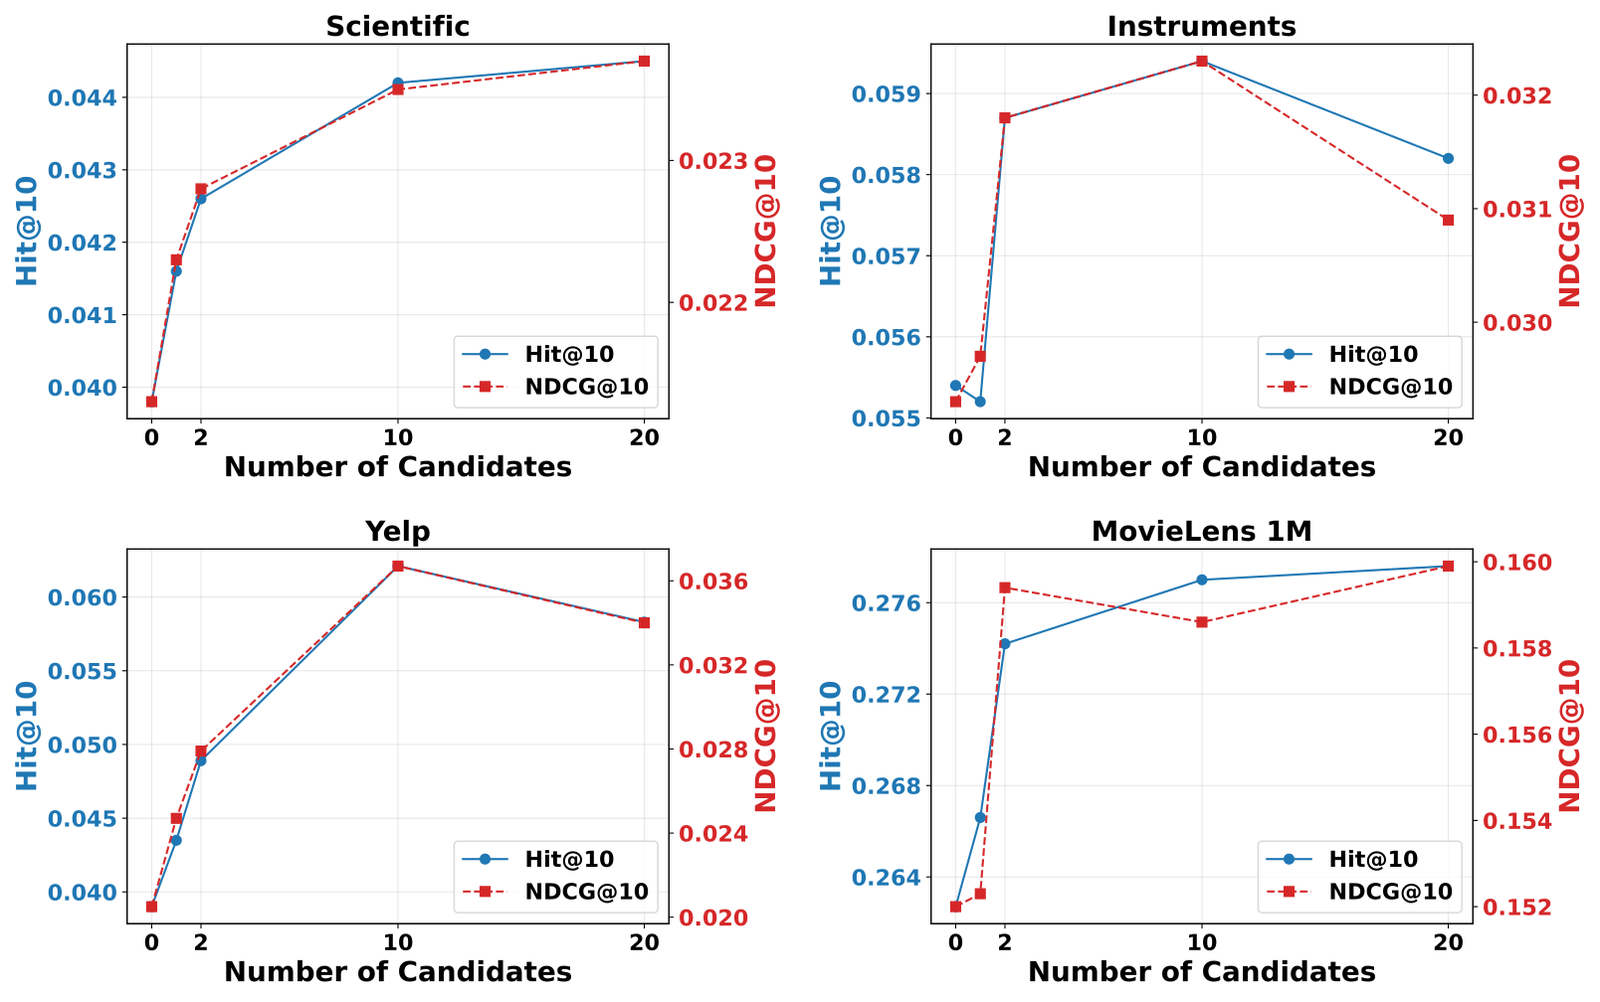
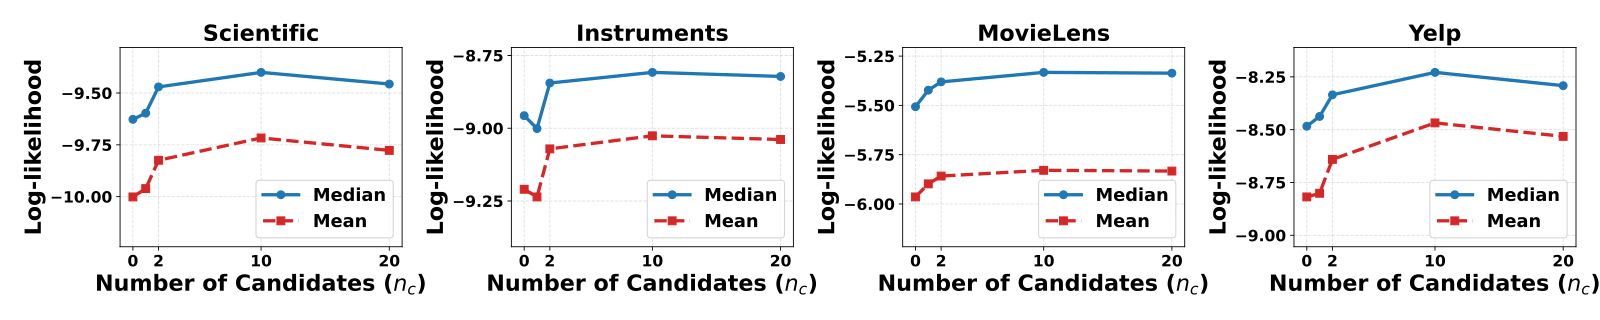
候选数加大,性能先升,随后饱和,有的数据集还会回落。作者的解释是:模型已经学到足够的组合模式,再加负样本会变得多余,而且更大的候选更容易抽到假负例——用户没见过、但其实符合当前意图的商品。nc=1 没有负样本,若干数据集仍有提升,只是通常更小。
按下一件商品在训练集里的流行度切开,结果说明辅助任务在 popular 子集上稳定变好,medium 和 long-tail 没有明显变差。Yelp 的 medium 和 long-tail 上升很多,Hit@10 分别从 0.0070 升到 0.0354,从 0.0038 升到 0.0432。Scientific 和 Instruments 的长尾下一件几乎还是零:Hit@10 分别是 0.0004 到 0.0004、0.0007 到 0.0009,说明长尾下一件在这两个数据集上仍然很难。
默认设置里,两个任务各用一次,比例相同。如果改成按概率只抽其中一道题,主任务占比过高时,三个数据集的效果都会下降;占比过低时,Scientific 和 Yelp 也会下降。作者的结论是:换到新数据集时,让两个任务保持平衡仍然最有效。负采样方面,均匀抽样已经够用。改成长尾、非长尾(Warm-set),或从长尾逐渐转到非长尾的动态调度,相对均匀抽样都没有明显的额外收益。
再看一条电影记录,来自论文表 5。用户最近看的多是 Drama,但里面有一部 Children's 电影 Babe。TIGER 给出的前三名全是 Drama。加上选择题后,第一名变成同属 Children's 和 Drama 的 E.T.,而这正是真实的下一件。作者把表 5 和表 6 放在一起,用来说明模型开始抓更高层的行为意图,而不只是商品元数据上的语义相近。
这对做生成式推荐的人意味着什么
如果你已经在用 TIGER 这类 SID 生成式推荐,可以先加一道只在训练期出现的选择题,不必先上更复杂的对齐任务。
推理接口不用改,还是直接生成 SID。可以先用均匀负采样、候选数 10、两条任务在每个 epoch 各走一次。另外核对底座 TIGER 在你的数据上是不是已经落后于 SASRec 这类传统序列模型。如果底座弱,相对提升会被放大。
局限
这个辅助任务只接到 TIGER 上做过完整实验。换到其他生成式架构,是论文写明的未来工作。
Scientific、Instruments 上,下一件如果是长尾商品,Hit@10 仍然接近 0:TIGER 是 0.0004 和 0.0007,加上选择题后是 0.0004 和 0.0009。
MovieLens 上,TIGER+nc=10 的 Hit@10 是 0.2770,略低于 ETEGRec 的 0.2790。
实验是四个公开数据集,5-core 过滤,leave-one-out,历史最长截到 20,没有线上对比。候选数放到 20 时,Instruments 和 Yelp 已经出现回落。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…