目录 · 7 节
1它到底在解决什么问题?2先说清楚:多目标 on-policy 蒸馏是怎么做的3KL-MOPD:按距离给老师分权重4这套方案真的更好吗?5我认为它的局限6一个推荐或搜索团队可以怎么试7一句话结论
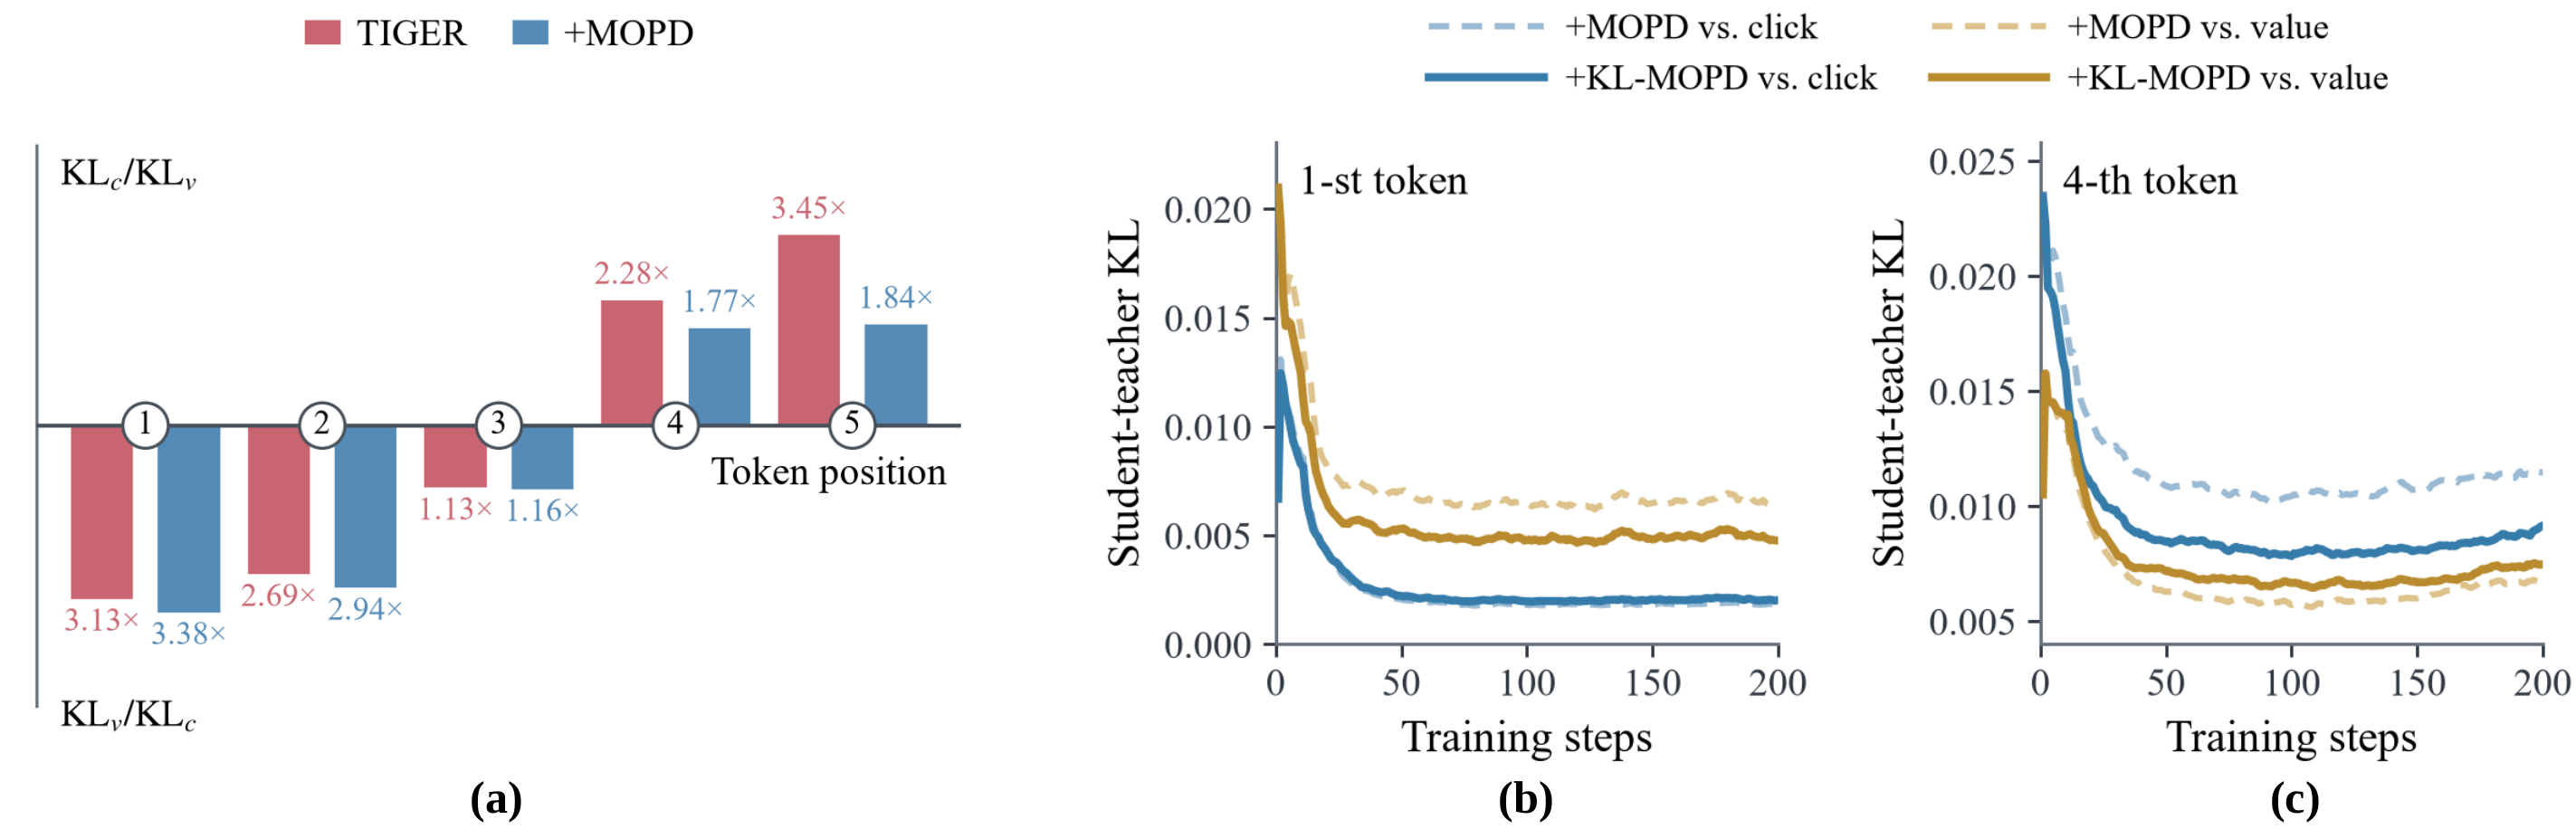
生成式推荐要同时照顾点击和成交时,一种越来越常见的做法是先训两个只管单一目标的老师模型,一个专攻点击,一个专攻转化或 GMV,再把两个老师蒸馏进一个学生模型,每生成一个 token 都让学生同时向两个老师靠拢,权重各一半。浙大和阿里的这篇论文发现,这样平分并不公平:在 TencentGR 数据集上,学生生成第 1 个 token 时离价值老师的距离(KL 散度)是离点击老师的 3.13 倍,平分权重训练完仍是 3.38 倍;而且难学的老师会换人,前三个 token 是价值老师难学,后两个 token 换成点击老师。他们的方法 KL-MOPD 只改一处:在每个 token 上,按训练前学生离两个老师的距离分配权重,离得远的老师权重更大。在 15 亿条交互的工业广告数据上,联合指标比平分权重高 3.19%;10% 流量的线上 A/B 中,广告收入提升 1.63%,GMV 提升 2.20%。
做多目标生成式推荐、或者在用多个老师做蒸馏的团队值得读,因为它的改动小到几乎没有成本:权重在训练前算一次,训练时不多一次前向,也不加任何模块,现有的蒸馏流程换一行损失权重就能用。更有价值的是它指出的现象:平分权重蒸馏出来的学生,联合指标在三个公开数据集上都不如最好的那个单目标老师;TIGER 经过等权蒸馏后,联合指标比初始学生高,但仍没有超过最好的单目标老师。需要留意的是,公开数据集上用的是两层编码器、两层解码器的小模型,绝对指标很低,工业离线也只和平分权重的版本比了。
它到底在解决什么问题?
生成式推荐把每个物品编成一串 SID,逐个生成。这带来一个硬约束:只要中间有一个 token 选错,这个物品就召不回来了。所以多目标优化不能只在物品层面对齐,每一个 token 都得学好。
看一个示意场景。一个广告推荐模型给每个广告编 5 个 token,前面的 token 粗分品类,后面的细分到具体广告。点击老师偏爱封面抢眼、价格低的广告;价值老师偏爱转化高、客单价高的广告。
| 生成到第几个 token | 学生和点击老师的分歧(示意) | 学生和价值老师的分歧(示意) | 谁更难学 |
|---|---|---|---|
| 第 1 个(大品类) | 小 | 大 | 价值老师 |
| 第 5 个(具体广告) | 大 | 小 | 点击老师 |
如果每一步都平分权重,学生会自然向离得近的老师靠拢,因为那边的损失更容易降。结果是前几步学不好价值老师,后几步学不好点击老师。两个目标各自都有几步没学好,又因为任何一步选错都会丢掉物品,两个目标的召回都受损。
论文在 TencentGR 上量出了真实的分歧(论文表 1,学生在训练前离两个老师的逐 token KL 散度):
| token 位置 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 离点击老师 | 0.00637 | 0.02301 | 0.03036 | 0.02319 | 0.05058 |
| 离价值老师 | 0.01995 | 0.06189 | 0.03437 | 0.01019 | 0.01467 |
前三个 token 离价值老师更远,后两个反过来离点击老师更远,和示意表的形状一致。
先说清楚:多目标 on-policy 蒸馏是怎么做的
论文的出发点是多目标 on-policy 蒸馏(MOPD),这是大模型里用来合并多个专家模型的方法。流程分三步:
| 步骤 | 做什么 |
|---|---|
| 准备老师 | 从同一个预训练好的推荐模型出发,分别用点击数据和价值数据微调出两个老师 |
| 学生采样 | 学生用自己当前的模型生成一串 SID,训练就在学生自己会走到的路径上进行 |
| 逐 token 对齐 | 在学生生成的每个前缀上,两个老师各给出下一个 token 的概率分布,学生最小化自己到两个老师的 KL 散度,平分权重 |
为什么要在学生自己生成的路径上学?因为线上解码时学生走的就是自己的路径。如果只在老师生成的或者日志里的序列上学,训练和线上会有分布差。论文还证明,在老师是标准 KL 正则化最优策略的假设下,这个损失等价于直接最大化「点击收益加价值收益」减去一个偏离初始模型的惩罚。
为什么要逐 token 对齐?因为传统多目标方法只对齐整个物品的概率,而物品概率是各 token 概率的乘积,整体对齐了,中间某一步的概率仍可能很低,解码时就在这一步走岔。
KL-MOPD:按距离给老师分权重
KL-MOPD 只改了权重。先让初始学生(即两个老师微调前的同一个预训练模型)对每个请求自己生成 SID,在它生成的每个前缀上,比较学生和老师 j 给出的下一个 token 分布,算 KL 散度,再对所有请求取平均,得到第 t 个 token 上的 。前缀用的是学生自己生成的,和后面蒸馏时的采样方式一致。然后第 t 个 token 上老师 j 的权重是:
其中 c 代表点击老师,v 代表价值老师。离得越远的老师,权重越大;两个老师一样远时,权重回到各一半,方法退化成原来的平分版本。
用上面表 1 的数字手算一下。第 1 个 token,价值老师的权重是 0.01995 ÷(0.00637 + 0.01995)≈ 0.76,点击老师只有约 0.24。第 5 个 token 反过来,点击老师的权重是 0.05058 ÷(0.05058 + 0.01467)≈ 0.78。也就是说,同一个学生在前几步主要补价值老师的课,在最后几步主要补点击老师的课。
为什么用训练前的距离,而不在训练中动态更新?作者的理由是成本:权重只依赖初始学生和两个固定的老师,训练前算一次就够,训练时不需要额外前向,也不占额外显存。动态调权的基线 TrustMOPD 需要每步更新权重,在论文的速度对比里每步训练时间更长,效果也不如 KL-MOPD。
理论部分给了一个下界:KL-MOPD 相对平分版本的联合目标提升,至少是 β×S 减去 D×L³/β²。S 把每个 token 上「两位老师距离之差的平方 ÷ 距离之和」加起来,两位老师难度差越大,S 越大;β 是老师训练时相对初始模型的正则强度,L 是单个物品收益的上限,D 只取决于 SID 的长度。所以只要 S 大于 D×L³/β³,提升就一定为正。直觉是:两个老师的难度差别越大,按难度分权重相对平分的好处就越大。作者在 TencentGR 上代入估计值(SID 长度 5、L 为 1,D 约 7.03,β 约 6.48,S 约 0.05),验证了这个条件成立。
这套方案真的更好吗?
评测指标是按目标加权的 Recall@K:在测试物品里,被前 K 个结果召回的那部分按目标收益加权计算召回率,点击目标用点击收益加权,价值目标用转化、GMV 或 eCPM 加权,每个目标的结果都归一化到 0 到 1 之间。联合指标是两者的平均。下表是 TIGER 主干、前 10 个结果的联合指标:
| 方法 | TencentGR | YooChoose | Taobao |
|---|---|---|---|
| 点击老师 | 0.0225 | 0.4776 | 0.1314 |
| 价值老师 | 0.0199 | 0.4830 | 0.1317 |
| 平分权重蒸馏 | 0.0213 | 0.4726 | 0.1297 |
| KL-MOPD | 0.0240 | 0.5034 | 0.1356 |
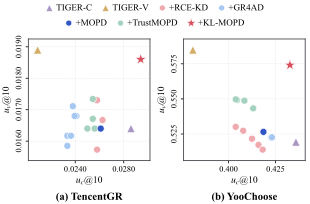
最值得注意的是第三行。平分权重蒸馏出的学生,联合指标在三个数据集上都低于最好的单目标老师。这说明两个老师一起教时,学生在不同 token 上各漏学一个老师,两边都没学好。KL-MOPD 在表 3 的所有设置中都取得最优联合指标,在每个数据集和主干上,和最强的基线、两个单目标老师中表现最好的那个相比,联合指标平均高 4.12%。换成另一个主干 REG4Rec,KL-MOPD 的联合指标仍然最高。不过,在 Taobao 上看前 10 个结果时,平分权重蒸馏的联合指标已经超过两个老师。
距离是不是真的被拉平了?论文表 1 也给了训练后的 KL:平分权重时,学生到两个老师的整物品 KL 各降了一半多;KL-MOPD 在此基础上又平均多降了 13.70%,前三个 token 离价值老师的距离明显比平分版本小。这说明收益确实来自把难学的那位老师学得更好。
权重为什么要逐 token、为什么要用 KL?作者在 TencentGR 和 YooChoose 上换了三种算法:
| 权重算法 | TencentGR 联合指标 | YooChoose 联合指标 |
|---|---|---|
| 平分权重 | 0.0213 | 0.4726 |
| 整个物品共用一个按 KL 算的权重 | 0.0209 | 0.4814 |
| 逐 token,但用概率的平方差算距离 | 0.0213 | 0.4851 |
| 逐 token,只在学生概率最高的 16 个 token 上算 KL | 0.0207 | 0.4848 |
| 逐 token,完整 KL(本文) | 0.0240 | 0.5034 |
在 TencentGR 上,整个物品共用一个权重几乎没有收益,因为难学的老师在中途换了人,一个权重只能偏向一边。只在学生概率排名前 16 的 token 上算 KL 也不行,因为老师之间的分歧常常落在学生概率不高的 token 上,截掉就看不到了。
工业验证更能说明问题,因为这里的模型和数据都是真实规模:约 15 亿条交互、每个广告编 8 个 token。KL-MOPD 的前 100 个结果联合指标从平分版本的 0.3139 提到 0.3236。线上 5 天、实验组和对照组各 10% 流量,广告收入提升 1.63%,GMV 提升 2.20%,报告的两个线上业务指标均有提升。
我认为它的局限
第一,公开实验的模型很小,绝对值很低。公开数据集用的是隐藏维度 64 的两层小模型,TencentGR 上联合指标只有 0.02 左右,所以公开集上的相对提升不宜直接外推到大模型。真正有说服力的是工业数据和线上结果。
第二,工业离线只和平分版本比。作者说明因为资源有限,工业数据上没有跑其他七个基线,所以「比所有方法都好」的结论只在公开小模型上成立。
第三,只处理了两个目标。权重公式可以直接推广到三个老师,但理论保证和全部实验都只覆盖两个,作者也把三个以上列为后续工作。真实广告系统往往还要兼顾时长、多样性等目标。
一个推荐或搜索团队可以怎么试
- 如果已经在用多个老师蒸馏生成式模型,先用初始学生在一份验证数据上算逐 token 的 KL,看各个 token 上离哪位老师更远、远多少。如果各 token 上两位老师的距离差不多,这个方法的收益会很小,可以不做。
- 差别明显时,把损失里的平分权重换成按 KL 比例算的权重,其他不动。成本只是训练前多跑一遍推理。
- 评估时除了联合指标,还要对比最好的单目标老师。如果蒸馏后的学生还不如单个老师,说明问题就出在权重分配上。
- 线上先看收入和 GMV 这类同时受两个目标影响的指标,再拆开看点击和转化,判断是否有一个目标被牺牲。
一句话结论
多个老师一起教时,每一步该听谁的,要看学生在这一步离谁更远;权重只需在训练前算一次。论文报告的离线实验中,学生的联合指标超过了两个单目标老师。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。点击和价值的平衡是广告和电商推荐的日常问题,生成式推荐又要求每个 token 都学好 |
| 方法创新性 | 中。按难度加权是很朴素的想法,贡献在于发现逐 token 的不平衡和难学老师的换位,并给出理论下界 |
| 实验证据 | 中高。三个公开集、两个主干、八个基线、工业离线和线上 A/B;但公开集模型小,工业只比了平分版本 |
| 工程成本 | 低。训练前算一次权重,训练时没有额外开销 |
| 是否值得尝试 | 值得,已有多老师蒸馏流程的团队几乎零成本就能验证 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…