目录 · 13 节
1它到底在解决什么问题?2为什么只读本地盘不够3KVStream 的四个做法4两头往中间读:一个手算例子5实验怎么做6结果一:离线吞吐7结果二:固定切分到底差多少8结果三:在线服务里,排队把小收益放大9什么时候它没用,甚至更慢10拆开看每一步贡献了多少11我认为它的局限12一个团队可以怎么试13一句话结论
长上下文推理会反复用到同一段前缀,比如系统提示、整份文档、代码仓库和多轮会话历史。这些前缀的 KV cache 早已放不进 GPU 显存和主机内存,只能落到硬盘上,下次命中再读回来,读盘就卡在了每一步推理的关键路径上。现有系统只读节点本地的 NVMe,集群早已挂载的并行文件系统却几乎闲着。这篇论文做了 KVStream(从多层存储并行读回 KV cache 的引擎):每块 KV 在本地盘和共享存储各写一份,读的时候两边同时读,谁先读完谁接着领下一批。接进 LMCache 实测,离线吞吐最高是 LMCache 的 1.49 倍,突发流量下平均 TTFT 最多快 6.1 倍。
做长上下文推理服务、尤其是 agent 和代码助手这类多轮会话的团队值得读。它的价值不在某个新算法,而在一个很实际的观察:GPU 节点旁边本来就有第二条存储通道,只是没人在推理时用它。做法也简单,不需要预测哪些前缀会被用到,也不需要调切分比例。代价是每块 KV 要写两遍,所以它只在“读得多、写得少”的场景里划算,论文把它变慢的情况也测了出来。
它到底在解决什么问题?
先说清楚场景。推理引擎(vLLM、SGLang)会把算过的前缀 KV 缓存起来,下一个请求如果用到同一段前缀,就不用重算。LMCache 是一个开源的 KV cache 连接器,它把放不下的 KV 按每 256 个 token 切成一块,存到主机内存和本地硬盘上,命中时再读回 GPU。
问题在于前缀的总量太大。作者的测试机每个节点 4 张 GPU,扣掉模型权重后约剩 140 GB 放 KV,主机内存 512 GB。14B 模型在几个文档数据集上要缓存的不重复前缀有 0.5 到 1 TB,是 GPU 能放下的 3.3 到 7.2 倍。到了 110B 模型,这个量接近 2 TB。所以大量前缀只能放在硬盘上。
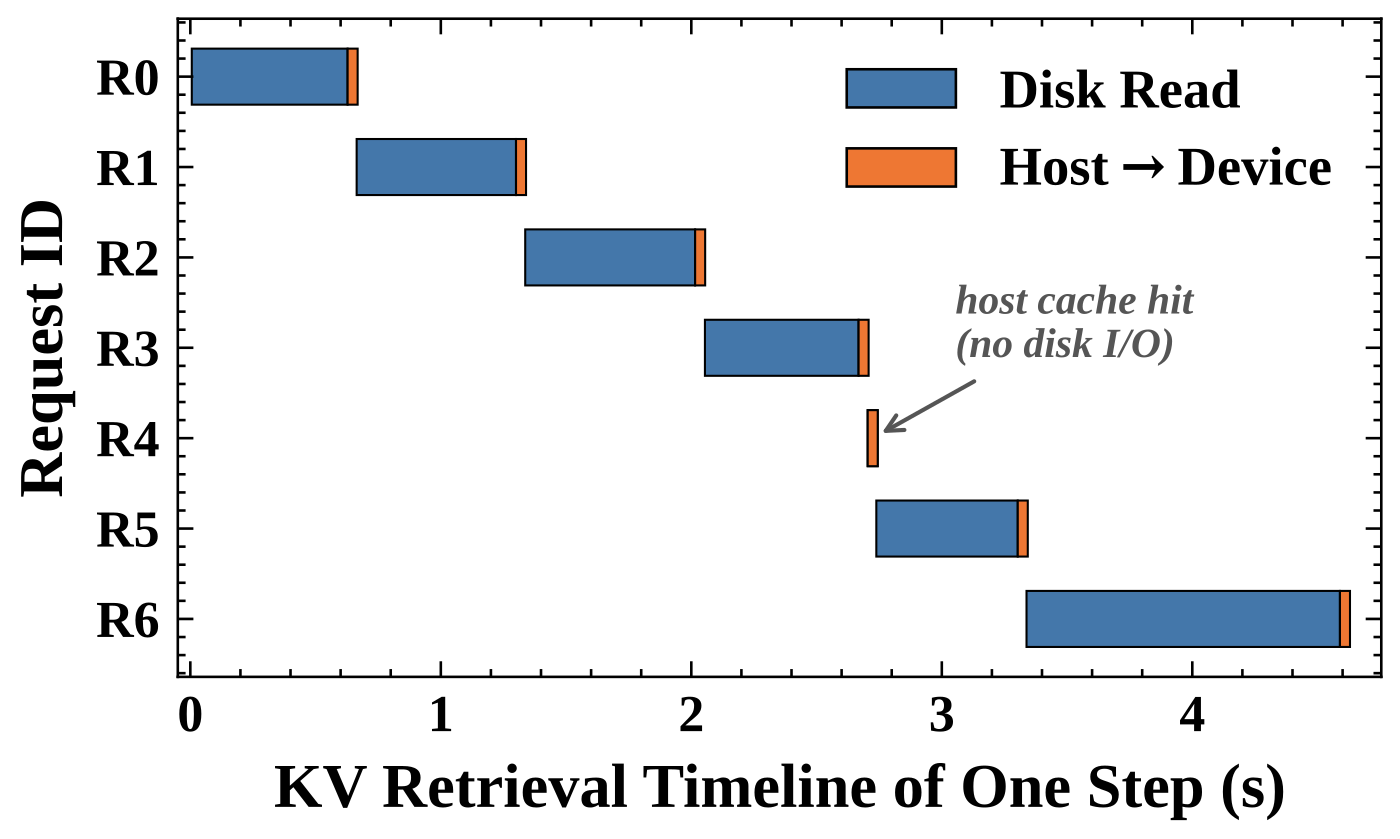
读盘有多慢?上图是一个具体例子:70B 模型的一步里有 7 个请求,LMCache 一个请求一个请求地读,每个要 600 到 1300 毫秒,整步光读盘就花了 4.7 秒。而且前向计算要等这一步所有请求的 KV 都到齐才能开始,先读完一个请求没有任何好处。作者在 LooGLE 数据集上拆了总耗时,四种模型大小下读盘都占了 LMCache 总时间的 80% 到 88%。即便这样,从盘上读回来仍比重算快,大模型上最多快 2.2 倍,因为重算的成本随模型层数涨,读盘只随字节数涨。
为什么只读本地盘不够
作者先做了一组测量,结论有三条。
第一,第二条通道一直闲着。超算集群和云上的 GPU 节点通常都挂着一个共享的并行文件系统(下文简称 PFS,比如 Lustre 或云上的托管文件系统)。单独测读速度,本地 NVMe 只比 PFS 快 2.2 倍(测试机 1)和 3.2 倍(测试机 2)。但推理时 PFS 除了加载模型权重之外几乎没有流量,这份带宽相当于白送。
第二,同一块盘又读又写会互相干扰。每一步刚算出的新 KV 要写盘,下一步要读的旧 KV 也在同一块盘上。读写各 512 GB 同时进行,比分开做慢 6%(测试机 1)和 27%(测试机 2)。所以按“空闲时测出的带宽”去分配读取量,到真跑推理时就不准了。
第三,单块数据的读取延迟有很长的尾巴。测试机 2 上,本地 NVMe 单独读时中位数 123 毫秒、P99 是 216 毫秒;一旦读写混在一起,P99 涨到 898 毫秒。PFS 的中位数是 102 毫秒,P99 却有 795 毫秒,因为整个集群的作业都在用它。这说明每一层存储能给的带宽,在不同推理步之间一直在变。
KVStream 的四个做法
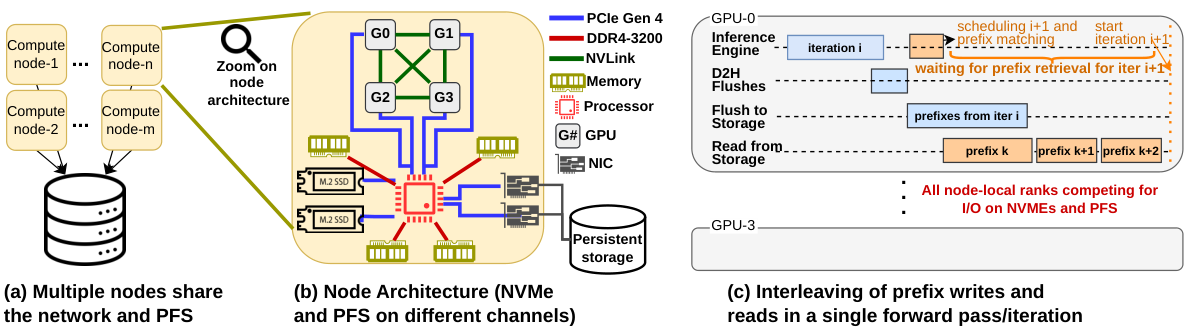
针对上面的问题,KVStream 做了四件事。
第一个改动是整步一起读:不再一个请求一个请求地读,而是把这一步所有请求要读的块放进同一个读队列,一次性提交。NVMe 只有在很多读请求同时在飞的时候才能跑满,排成一队一个一个读会浪费它的并行能力。读回来的块也是到一块就往 GPU 送一块,不再等。
第二个改动是把写盘往后推:新算出的 KV 先放在主机内存里,等下一步前向计算开始后再写盘。前向计算期间盘是空闲的,所以写操作基本不会挡住读。
第三个改动是每块写两份:每块 KV 在本地 NVMe 和 PFS 上各存一份。这样读的时候任何一块都可以从任何一层读,不需要提前猜哪块会被用到、该放在哪。存储容量通常是 TB 级,多存一份不是大问题,代价是写的字节数翻倍。
第四个改动是两头往中间读、谁快谁多读:把这一步要读的块排成一列,NVMe 从头往后读,PFS 从尾往前读,每次领 m 块。哪一层先读完手上这批,就马上领下一批,两边在中间某处会合。快的那层自然多读,慢的那层自然少读,不需要测带宽,也不需要调比例。会合处可能有几块被两边都读了,因为内容相同,先到的那份直接用,另一份丢掉即可。
实现上,KVStream 是一个用 io_uring(Linux 的异步 I/O 接口:程序把一批读写请求放进队列一次提交,不必每次都等读写完成)做异步读写的 C++ 库,读和写用两个独立的队列,作为 LMCache 的存储后端接入。所以 vLLM 这类已经接了 LMCache 的引擎不用改代码。
两头往中间读:一个手算例子
为什么不干脆按固定比例切,比如 75% 从 NVMe 读、25% 从 PFS 读?论文举了一个例子,这里把它算一遍。
假设一步要读 12 GB,NVMe 读速 3 GB/s,PFS 读速 1 GB/s。两层加起来是 4 GB/s,所以理论上最快 3 秒读完,这就是论文说的“总带宽下限”。按 75:25 切,NVMe 读 9 GB 用 3 秒,PFS 读 3 GB 也用 3 秒,正好同时读完。
现在 NVMe 因为同时在写盘,慢到 2 GB/s。固定切分下它读 9 GB 要 4.5 秒,PFS 早就读完闲着了。总带宽是 3 GB/s,理论最快 4 秒,所以固定切分慢了 12.5%。如果反过来是 PFS 被别的作业抢了带宽,掉到 0.5 GB/s,它读那 3 GB 要 6 秒,比只用 NVMe 读完 12 GB(4 秒)还慢。
两头往中间读就没有这个问题。NVMe 从头读、PFS 从尾读,哪边慢了,会合点就自动往那边偏,两边总是差不多同时读完。论文用一个简单的模型证明了这种读法在每一步都能贴着总带宽下限,只差最后一批 m 块的零头。固定切分只在带宽比例恰好等于切分比例时最优,带宽一变就吃亏,而推理时带宽一直在变。
实验怎么做
实验用了两台超算集群的测试机:测试机 1 每节点 4 张 H100,测试机 2 每节点 4 张 A100,各自挂着一个共享文件系统,节点本地都有 NVMe。模型从 14B 到 110B 共 4 个,都用 TP=4,这样能覆盖“重算便宜”和“读盘便宜”两头的情况。
离线测试用三个长文档数据集:LooGLE(长文档问答)、NarrativeQA(整本小说阅读理解,平均每个请求 4.6 万 token)和 CUAD(法律合同条款抽取)。在线测试用三条真实流量:阿里云百炼上一个 Qwen 代码生成集群的约 7000 个请求、Chutes 平台的 agent 会话,以及 SWE-bench 上的编程 agent 会话。这些数据里 80% 到 96% 的 prompt token 能命中缓存的前缀。
对比方法有:只用 GPU 和主机内存、放不下就重算(下文叫“只用内存”);LMCache 加本地 NVMe;Mooncake 的 KV 存储;SGLang 自带的分层缓存 HiCache。LMCache 是最强的基线,后面大部分对比都以它为准。
结果一:离线吞吐
| 模型 | 相对 LMCache 的吞吐 |
|---|---|
| 14B | 1.17 倍 |
| 32B | 1.37 倍 |
| 70B | 1.48 倍 |
| 110B | 1.49 倍 |
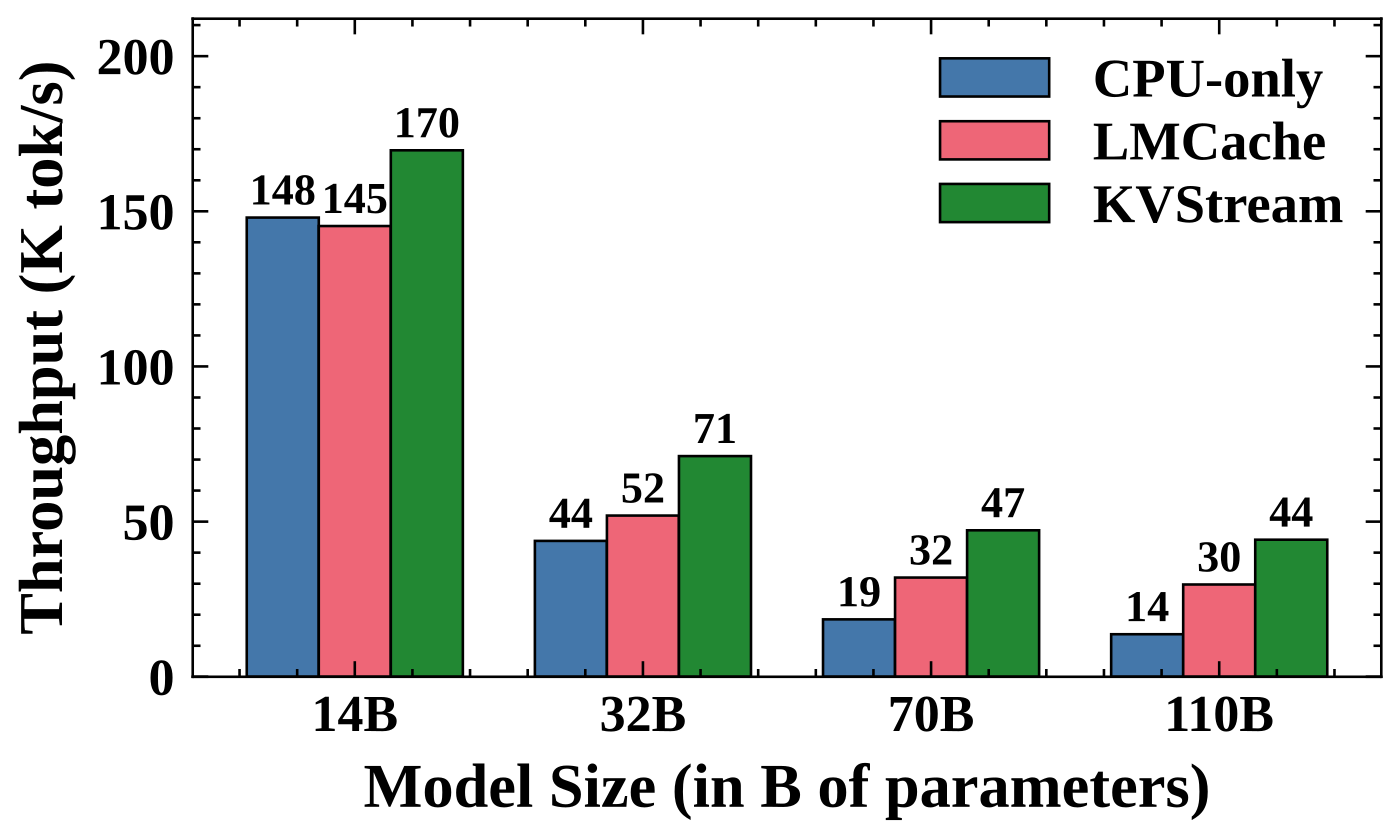
在 LooGLE 上,模型越大,KVStream 的优势越明显。原因有两个:大模型每个 token 的 KV 更大,内存里放得下的前缀更少,更多读取落到盘上;而且重算的成本随层数增长得比 KV 大小更快,70B 模型参数是 14B 的 5 倍,每个 token 的 KV 只多 1 倍。
吞吐为什么能提高,看读速就明白了。一个节点上 LMCache 从 NVMe 读出 6.0 到 6.7 GB/s;KVStream 从 NVMe 读得差不多,又从 PFS 多读了 2.8 到 4.9 GB/s,合计 8.1 到 11.8 GB/s。两边从盘上读的总量差不多,所以提速完全来自并行读。换数据集看,32B 模型在 CUAD 上只快了 1.05 倍,因为 CUAD 的请求最短,平均 1.1 万 token,读盘占一步的比例本来就小。
结果二:固定切分到底差多少
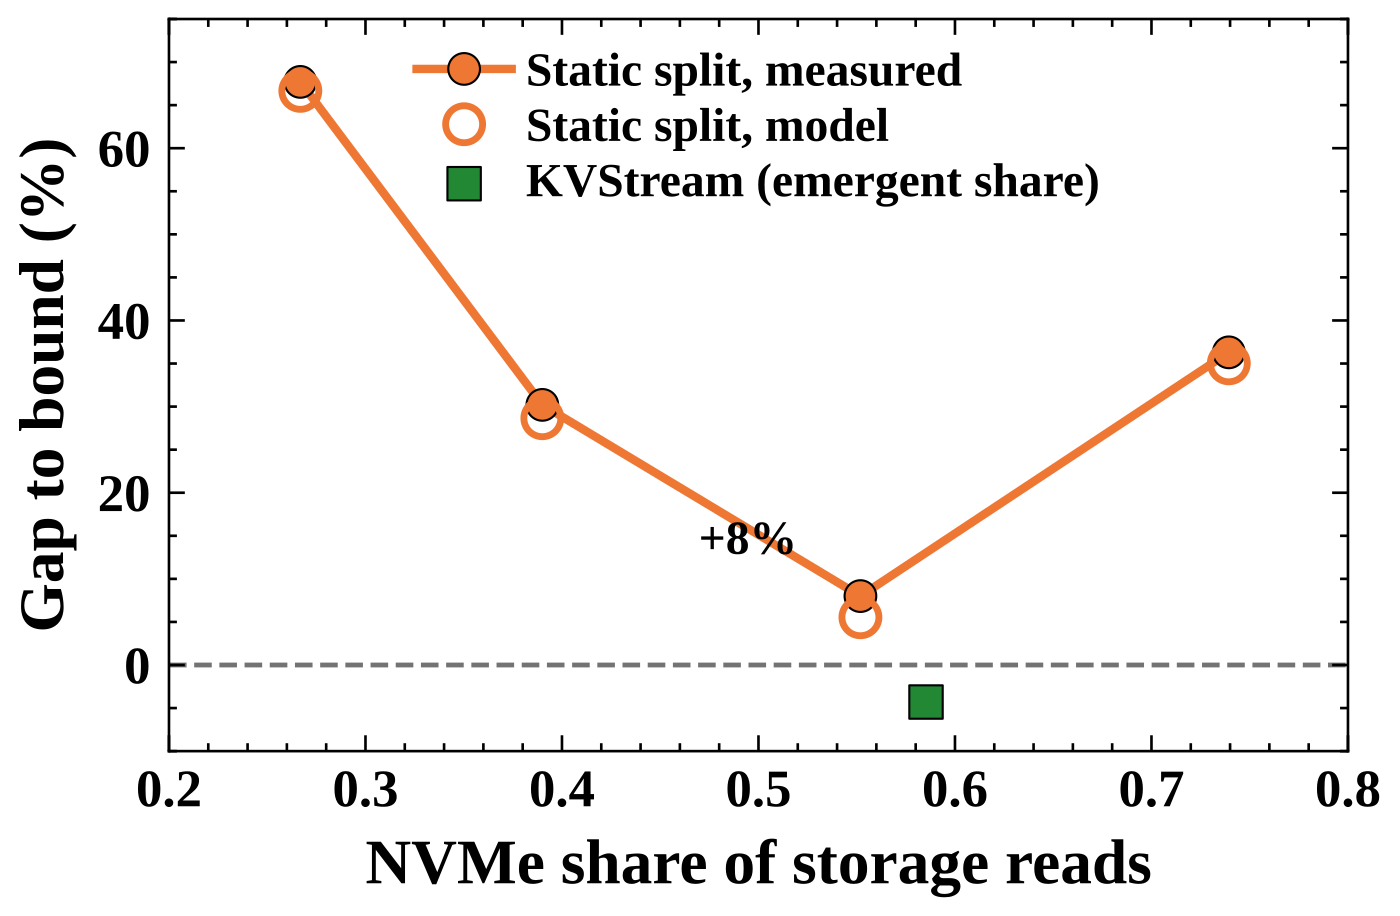
作者在测试机 2 上用 32B 模型专门检验上一节的推论。在没有其他作业干扰的文件系统上,固定切分比总带宽下限慢的幅度呈 V 形:切分比例刚好对上平均带宽比例时最好,也要慢 8.0%,切偏了最多慢 67.7%。KVStream 不用调比例,始终在下限的 4.3% 以内。这说明即便把固定比例调到最好,因为每一步的带宽都在变,它也只能在平均意义上对上。
再让另一个作业往 PFS 上打周期性、突发或持续的流量,模拟集群里别人的作业。这时固定切分最好也要慢 11.8% 到 23.6%,KVStream 仍然在 4.3% 以内。这说明即使把固定比例调到最优,只要共享存储上有别人在跑,它就会吃亏。
结果三:在线服务里,排队把小收益放大
在线场景看的是 TTFT(首 token 延迟),它等于请求自己处理的时间加上排队等前面请求的时间。读盘快一点,不仅这一批请求早完成,排在后面的请求也早开始,所以负载越高,收益越大。
在 SWE-bench 编程 agent 流量上,以 1 秒 TTFT 为目标,KVStream 有 84% 的请求达标,LMCache 是 70%,其余基线都在 55% 以下。这说明多读一层存储带来的提速,用户端能直接感受到。
在代码生成流量上,请求到达率从低到中到高,KVStream 相对 LMCache 的平均 TTFT 提速从 1.07 倍涨到 1.61 倍,再到 3.12 倍。但单看每个请求的读盘时间,它只比 LMCache 少 15% 到 22%。差别在排队:高负载下 LMCache 平均有 128 个请求在等,KVStream 只有 54.3 个。所以 TTFT 的大幅改善主要来自队列排得更快,而不是单次读得多快。
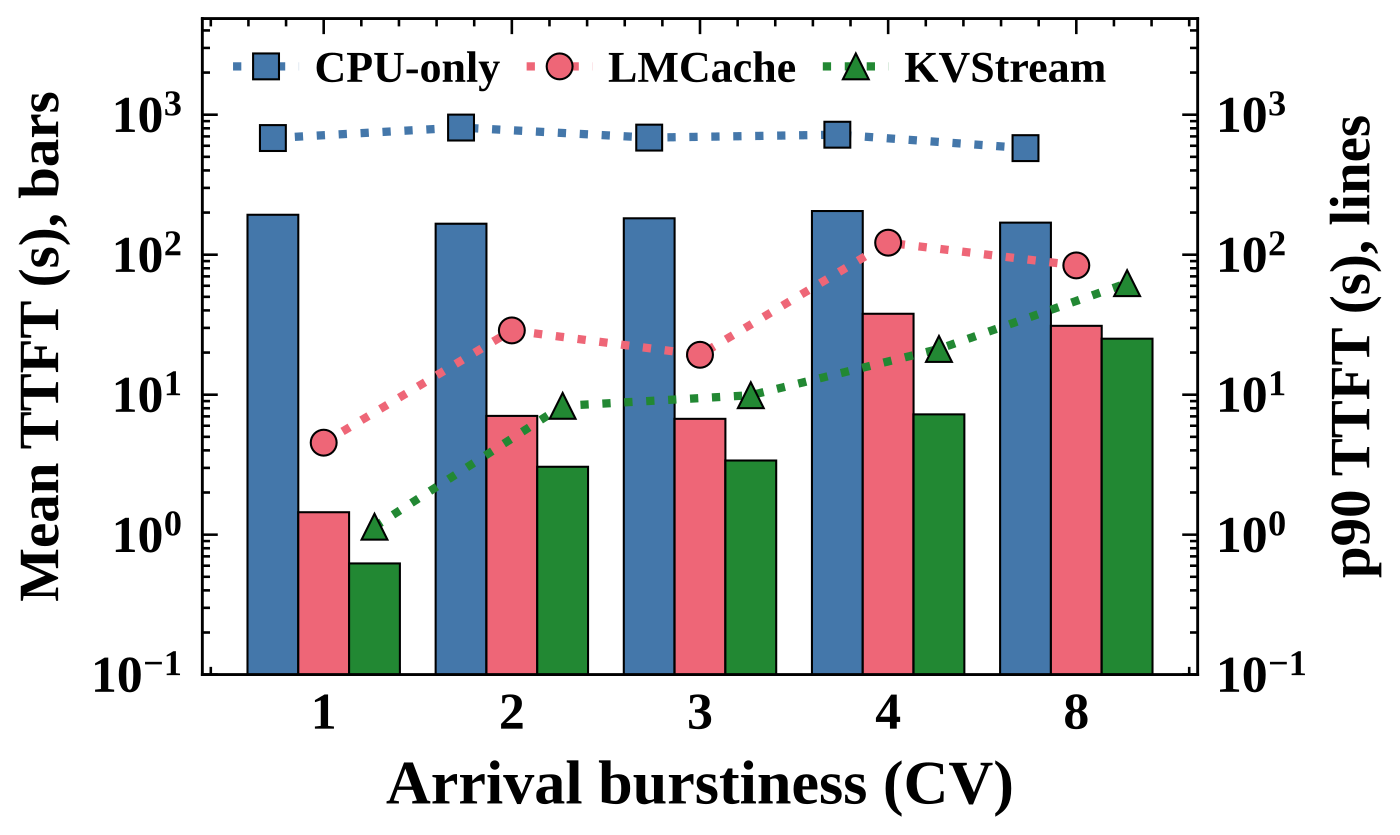
流量越扎堆,排队效应越明显。作者用到达间隔的变异系数衡量“扎堆程度”:变异系数=相邻两个请求到达间隔的标准差除以平均间隔,均匀到达时是 0,完全随机(泊松)到达时是 1,越大说明请求越是一阵一阵地涌来。真实生产流量约为 4.3。在变异系数为 4 时,KVStream 的平均 TTFT 比 LMCache 快 6.07 倍;扎堆到 8 这种超出真实流量的极端情况,优势缩小到 1.17 倍。
扩展到更多节点也成立。测试机 2 上从 4 个节点扩到 32 个节点(128 张 GPU),每个副本都有自己的 NVMe,但所有副本共享同一个 PFS。KVStream 在每个规模上仍比 LMCache 吞吐高 1.23 到 1.36 倍,因为每个节点各自按完成情况分配读取,PFS 拥挤时自然多读本地盘,节点之间不用协调。
什么时候它没用,甚至更慢
这部分是我觉得论文最有用的地方,因为作者把自己方法吃亏的情况也测了出来。
第一,主机内存放得下时没用。在 Chutes 流量上,主机内存从每卡 40 GB 加到 80 GB,几乎所有复用都能在内存里命中,盘上的读取量降了 98.6%。这时 KVStream 相对 LMCache 是 0.98 倍,略慢一点,因为它还在多写一份。
第二,请求顺序决定了要读多少。同一条代码生成流量,如果同一会话的几轮请求挨着来,大部分前缀还在内存里,KVStream 只快 1.05 倍。如果多个会话轮流交错,每一轮之间夹着别人的大量 KV,它就能快 3.12 倍。在线服务通常必须按到达顺序处理,不能为了缓存命中去重排请求,所以后一种情况更常见。
第三,复用率低时会变慢。作者人为降低 SWE-bench 流量的前缀复用率:复用率 88% 时 KVStream 快 6.0 倍,77% 时两者持平(0.97 倍),降到 4% 时只有 0.81 倍。因为复用越少,要写的新 KV 越多、要读回的越少,写两份的成本就压过了并行读的收益。
拆开看每一步贡献了多少
| 配置 | 离线吞吐(token/秒,70B) | 在线平均 TTFT(秒,32B) |
|---|---|---|
| 只用内存 | 18513 | 340.7 |
| LMCache(本地 NVMe) | 31977 | 31.1 |
| +整步一起读 | 32115 | 20.2 |
| +写盘往后推 | 32177 | 19.8 |
| +第二层存储、固定切分 | 39631 | 122.1 |
| +谁快谁多读(完整 KVStream) | 47210 | 13.0 |
离线吞吐几乎全靠第二层存储:只有一块 NVMe 时,怎么排读写都受它的带宽限制,前两步改动不到 1%。加上 PFS 并按 70:30 固定切分,吞吐到了 LMCache 的 1.24 倍,换成谁快谁多读后到 1.48 倍。
在线这一列有个反直觉的结果:固定切分反而把 TTFT 拖到 122.1 秒,比 LMCache 还慢得多。原因是这一档在线实验的固定切分不存两份:每个前缀的前 80% 块只放在 NVMe,后 20% 块只放在 PFS。固定切分在每块写入时,按它在当时整个前缀里的位置定下放哪层,之后不再搬动;前缀变长、80:20 的分界后移时,旧块也留在原层。每轮新对话追加的块总在当时前缀的最末尾,写入那一刻落在后 20% 里,所以新写入的块大多只存在 PFS 上。结果 PFS 承担了 47% 的读取,却只有 15% 的带宽,成了瓶颈。这说明在多层存储里,按位置或按比例提前分配数据很容易出错,读的时候动态分配才稳。
我认为它的局限
第一,写入量翻倍是实打实的成本。作者在模拟器里试过两个折中:某一层变慢后才补写副本,写入量只有 1.19 倍,但读取比下限慢 12% 到 74%,因为副本补上时这一步已经卡住了;只让每个前缀的一部分块(固定 40%)存两份,写入量是 1.43 倍,读取最多只比下限慢 5%。所以如果你的存储写带宽紧张,部分复制是值得先试的方向。
第二,收益高度依赖负载形态。它最适合长 prompt、短输出、多会话交错、内存放不下的场景。输出很长时,解码时间稀释了读盘的占比,按 Amdahl 定律提速有上限:输出从 16 到 256 token,离线优势在 1.19 到 1.37 倍之间。
第三,实验都在超算集群上,共享存储是专门的高性能并行文件系统。云上换成托管文件系统或对象存储,带宽和延迟特性可能差很多,需要自己测。另外节点之间不协调,同一个前缀在 PFS 上可能被多个节点各存一份,浪费容量和写带宽,作者把跨节点共享留给了以后。
一个团队可以怎么试
- 先确认读盘是不是你的瓶颈:统计每一步里从盘上读 KV 的时间占比。如果主机内存已经能放下大部分复用前缀,这套方法帮不上忙。
- 看看节点上有没有第二条独立的存储通道,比如共享文件系统、第二块 NVMe 或远端 NVMe,并分别测它们在推理负载下的读写带宽。
- 如果已经在用 LMCache,接入成本最低;没有 LMCache 的话,“两头往中间读、谁先读完谁领下一批”这个调度逻辑本身也很容易移植到自己的 KV 存储层。
- 上线前用自己的真实流量回放,重点看高峰期和突发流量下的 TTFT,以及复用率低的业务会不会变慢。
一句话结论
长上下文推理的 KV 读盘瓶颈,不一定要靠更快的盘解决,把集群里闲着的共享存储一起用起来,再让每层存储按实际速度自己领活,就能稳定贴近总带宽的上限。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。agent 和代码助手的长会话让 KV cache 远超内存,读盘已经成为瓶颈 |
| 方法创新性 | 中。每个机制都不新,组合起来并配上性能模型,解释得很清楚 |
| 实验证据 | 高。4 个模型、6 个数据集、最多 128 张 GPU,还测了变慢的情况 |
| 工程成本 | 中低。作为 LMCache 后端接入,推理引擎不用改;写入量翻倍 |
| 是否值得尝试 | 值得。长会话、多用户交错、内存放不下的推理服务可以优先评估 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…