 已录用 CIKM 2026
目录 · 9 节
1它到底在解决什么问题?2整体流程3每一步为什么只学残差?4推理 token 和历史摘要:每个候选怎么各自修正5为什么冻结原模型?6实验结果7我认为它的局限8一个推荐或搜索团队可以怎么试9一句话结论
生成式排序模型通常把用户画像、行为序列和一批候选物品排成一条 token 序列,一次前向就给所有候选打完分,打完就结束。这篇美团和中科大的论文问的是:能不能在这之后多算几步,专门修正每个候选的分数?他们的做法 Refiner 给每个候选接一个「推理 token」,再过一遍 Transformer,每一步只预测一个加到原分数上的修正量,而不是重新打分;原模型完全冻结,只训练 LoRA 和一个新的输出层。在 Steam 数据集上,它把美团线上生成式排序模型 MTGR 的 AUC 从 0.7698 提到 0.7872;接在线上 15 层 MTGR 之后做 7 天 A/B,按曝光算的点击率提升 0.75%,GMV 提升 0.46%。
做排序、尤其是已经上了 HSTU 或 MTGR 这类 Transformer 排序模型的团队值得读,因为它给的是一个能直接挂在现有模型后面的插件:原模型一个参数不动,Refiner 跟着原模型的日更节奏增量训练,出问题拔掉即可。最值得借鉴的是「每一步只学残差」这个约束,它让多算的几步在原分数上累加修正量,以改善候选排序。需要留意的是,公开数据集上每次只排两个候选(一个正样本加一个随机负样本),工业离线集上的提升只有千分之一到千分之二点五,延迟也只报告了相对值。
它到底在解决什么问题?
排序和召回不同。召回只要把好物品捞进候选池,排序要在一批都还不错的候选之间分出细微高下。分数差 0.02 就可能决定谁排第一。
一次前向打分的模型没有机会「回头看」。看一个示意例子:一个用户最近常买咖啡豆,偶尔买过磨豆机。两个候选,A 是热门速溶咖啡,B 是冷门的手冲滤纸。
| 候选 | 原模型分数(示意) | 真实标签 | 修正量(示意) | 修正后分数 |
|---|---|---|---|---|
| A 速溶咖啡 | 0.62 | 未点击 | −0.10 | 0.52 |
| B 手冲滤纸 | 0.58 | 点击 | +0.15 | 0.73 |
原模型把热门的 A 排在前面,因为 A 的 item embedding 学得充分,B 太冷门,表征不可靠。如果能在第一次打分之后,让 B 单独再结合一次用户历史(买过磨豆机,说明在手冲),给它补一个正的修正量,顺序就翻过来了。这正是 Refiner 想做的事:多出来的计算不重新打分,只在原分数上做加减。
已有的「隐式推理」推荐方法,比如 ReaRec,是在用户表征上反复迭代,服务的是召回里的下一物品预测。排序不同,候选是明确给出的,每个候选需要自己的修正,所以作者要重新设计推理放在哪、学什么。
整体流程
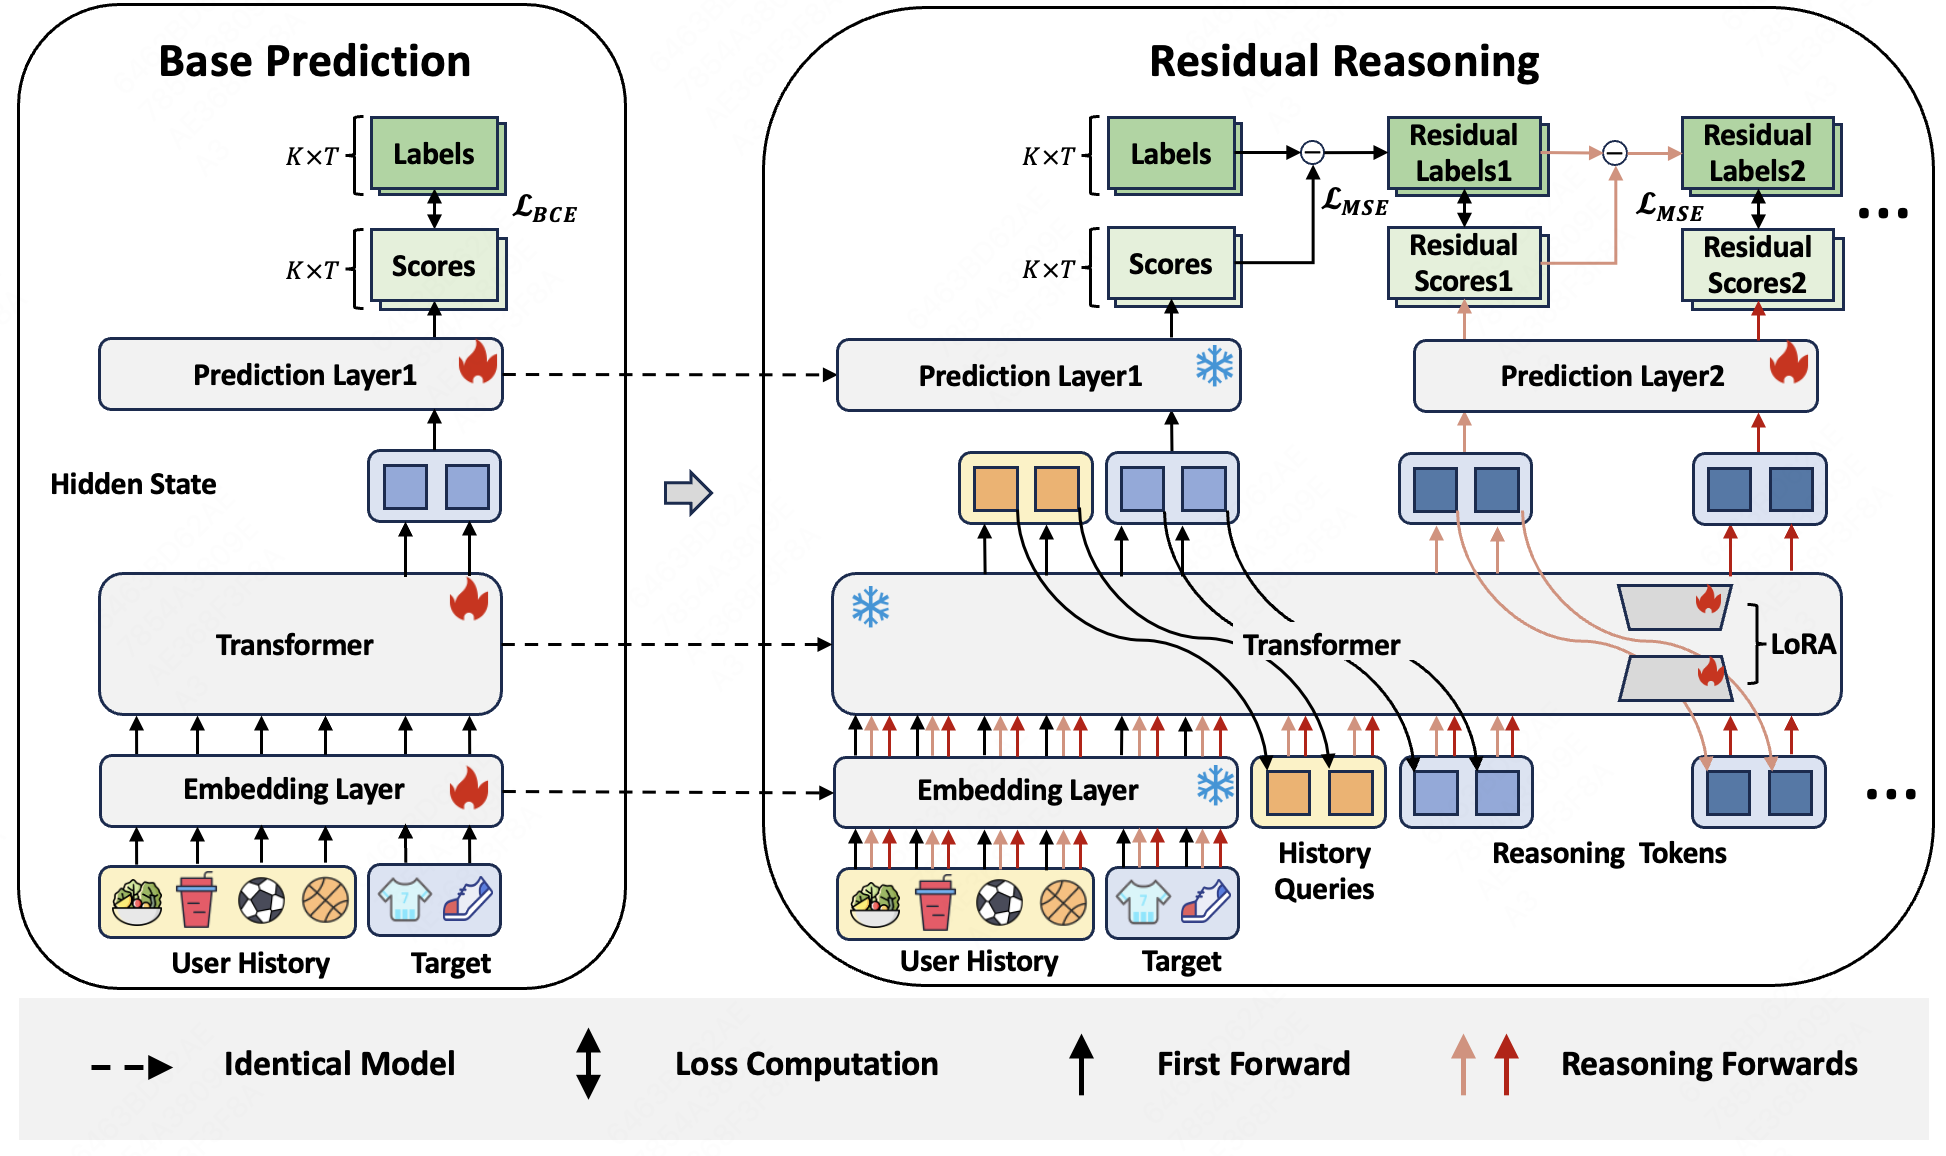
整条链路分三步:
| 步骤 | 输入 | 做什么 | 输出 |
|---|---|---|---|
| 第 0 步 | 用户画像、行为序列、K 个候选 | 冻结的原模型跑一次前向 | 原始分数,每个候选的输出向量,历史段的输出向量 |
| 构造输入 | 第 0 步的输出 | 取每个候选位置的输出当作第 1 步的推理 token,取历史段最后几个位置的输出当作历史摘要 token | 一条更长的序列 |
| 第 r 步 | 原输入 + 历史摘要 + 第 1 到第 r 步的推理 token | 整条序列从第一层起重新过一遍带 LoRA 的 Transformer,取最后 K 个位置过新输出层 | 每个候选一个修正量 |
最后的分数是原分数加上每一步的修正量之和。关键分工是:原模型负责打底分,推理步只负责改错,两部分参数分开,训练目标也分开。下面拆开讲三个设计。
每一步为什么只学残差?
最直接的做法是每一步都重新预测一个完整分数,用 BCE 监督。问题在于,每一步都可以把上一步的结论整个推翻,推理步和原模型在做同一件事,互相干扰。
Refiner 的做法是把第 r 步的累计分数写成原分数加各步修正量:
其中 是冻结的原模型给的分数, 是第 i 步推理输出层预测的修正量。训练时让每一步的累计分数都去逼近 0/1 标签,用平方误差:,再把各步的误差加起来。
用上面的候选 B 算一下(示意):标签是 1,原分数 0.58,平方误差是 0.42² ≈ 0.176。第一步预测 +0.15,累计 0.73,误差变成 0.27² ≈ 0.073。第二步继续预测修正量,训练时将各步累计分数的平方误差相加,以鼓励减少预测误差。作者在实验中观察到,后续步骤的修正量逐渐变小。
为什么用平方误差而不是 BCE? 是原模型输出的概率(原模型本身就是对分数直接用 BCE 训练的),但后面加上的修正量没有上下限,累计分数可能小于 0 或大于 1。BCE 要对分数取对数,超出 0 到 1 就没有定义;平方误差对任何实数都能算。另一种做法是把修正量加在 sigmoid 之前的 logit 上,累加完再过 sigmoid、用 BCE 监督,这样累计分数一定落在 0 到 1 之间,不过论文没有试这个方案。
消融里有一个相关的变体:去掉残差,每一步都直接预测完整分数、用 BCE 监督。Steam 上 AUC 从 0.7872 降到 0.7763,和去掉历史摘要的损失差不多。不过这个变体同时改了两处:不再累加修正量,损失也从平方误差换成了 BCE。所以它只能说明「累加修正量 + 平方误差」这套组合比「每步重新预测 + BCE」好,分不清是哪一处在起作用,也不能证明收益全部来自「只修不改」这个约束。
推理 token 和历史摘要:每个候选怎么各自修正
每个候选在每一步都分到一个推理 token。第 1 步的推理 token 直接取第 0 步原模型在该候选位置的输出向量,第 r 步的取第 r−1 步的输出,所以推理是一步接一步往下传的。
多个候选要并行修正,又不能互相偷看,所以要改注意力掩码。
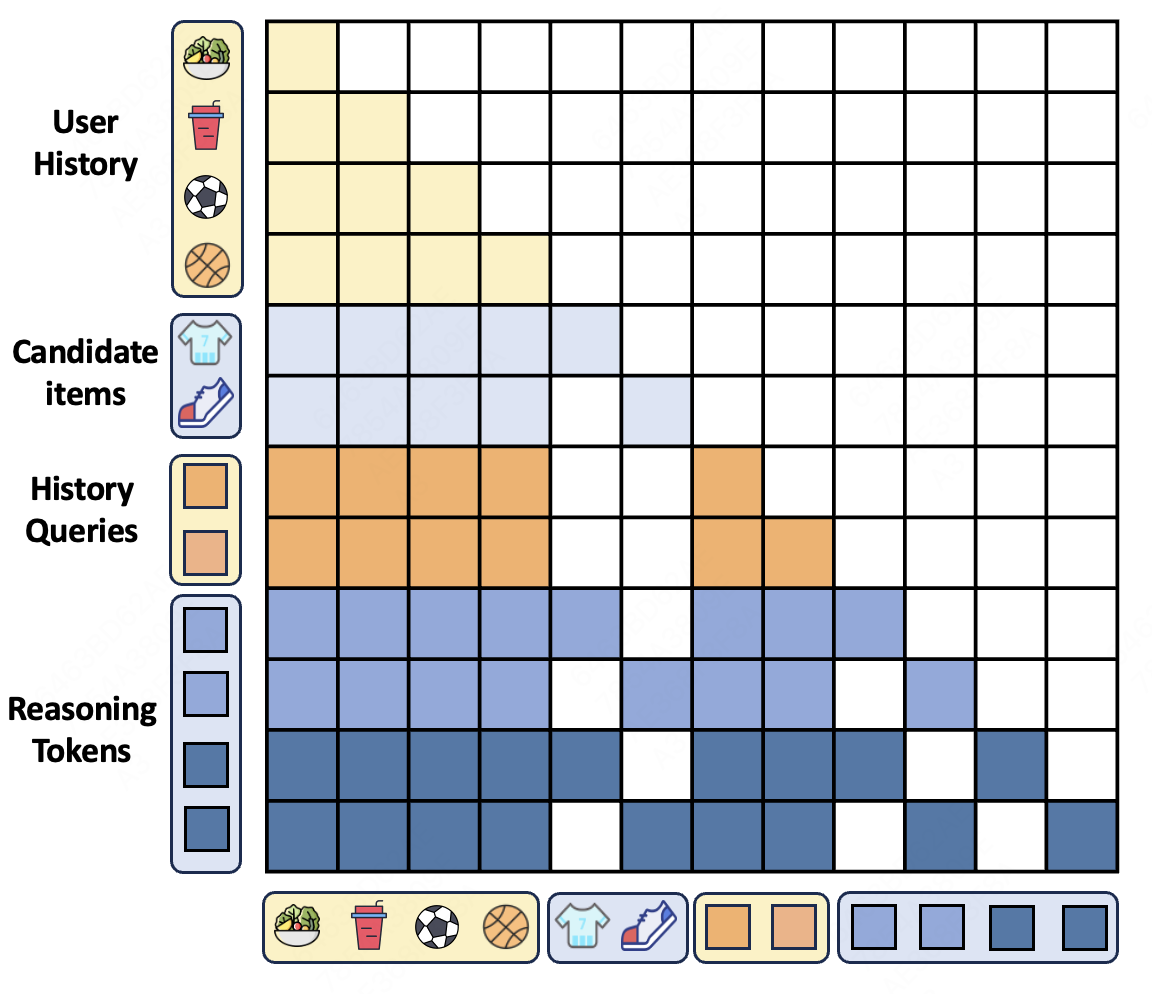
规则只有两条:候选 B 的推理 token 能看到用户画像、全部行为、历史摘要、候选 B 本身和 B 之前步骤的推理 token,看不到候选 A 和 A 的推理 token;历史摘要 token 的可见范围和行为序列一样。这样一次前向就能同时修正所有候选,候选之间不会互相泄露信息。
历史摘要(论文里叫 history queries)是这样来的:第 0 步,冻结的原模型把原始输入完整跑一遍,得到每个位置最后一层的输出。取其中用户行为序列那一段的最后 个位置,就是历史摘要 token;同一次前向里最后 K 个位置(K 个候选)的输出,就是第 1 步的推理 token。历史摘要只算这一次,之后每一步都原样拼进输入,不再更新。
要注意,第 r 步(r≥1)并不是只算新加的 token:原输入、历史摘要和第 1 到第 r 步的推理 token 拼成一条序列,从第一层开始整条重新过一遍带 LoRA 的 Transformer。所以行为序列每一步都会重新编码一遍,推理 token 每一步也都会重新对它做注意力。
那为什么还要历史摘要?差别在于推理 token 在前几层能用上什么。行为 token 进入第一层时只是原始 embedding,要经过后面几层(加了 LoRA 的那套参数)才能重新汇总出对整条历史的理解;历史摘要则是原模型跑完所有层之后得出的结论,作为现成的 token 放在输入里,推理 token 从第一层起就能直接对它做注意力,不必全靠 LoRA 层自己重新拼出来。这是我们对它为什么有用的理解;论文本身只说它提供「浓缩的全局用户上下文」,没有进一步分析,支持它的是下面的实验。
去掉历史摘要,Steam 上 AUC 从 0.7872 降到 0.7764。摘要条数并不是越多越好,作者从 0 试到 16,2 或 4 条最好,因为条数太多会带进冗余信号;加 2 到 4 条带来的额外推理时间不到 10%。
为什么冻结原模型?
线上的排序模型往往已经训练很久、每天增量更新,重训一个更大的模型风险和成本都很高。Refiner 把原模型的 embedding、Transformer 和输出层全部冻结,第 0 步完全用原模型;从第 1 步开始,在同一套 Transformer 上加 LoRA,再加一个专门输出修正量的新输出层。只有 LoRA 和新输出层参与训练。
这样做的好处有两个。原模型的打分行为被完整保留,推理步出错最多是修正量偏了,不会让底分变差。上线时也可以跟着原模型日更:每天加载当天的原模型并冻结,Refiner 的参数从前一天的版本接着训。
消融里最有意思的是端到端版本:不加 LoRA 和新输出层,直接把原模型和推理目标一起训练。它在 Steam 上的 AUC 只有 0.7650,比完全不加推理的 MTGR(0.7698)还低。作者认为,这一结果提示直接联合优化全模型可能削弱基础预测与推理修正的功能分工。
实验结果
主实验里推理步数固定为 1。公开数据集上每个正样本配一个随机负样本,相当于每次在两个候选里排序;工业数据集来自线上曝光日志,候选数跟随线上链路。
| 方法 | Steam AUC | Steam GAUC | MovieLens10M AUC | 工业 CTR AUC | 工业 CTR GAUC |
|---|---|---|---|---|---|
| MTGR | 0.7698 | 0.7397 | 0.7674 | 0.7404 | 0.6909 |
| MTGR + ReaRec | 0.7785 | 0.7443 | 0.7719 | 0.7410 | 0.6913 |
| MTGR + Refiner | 0.7872 | 0.7594 | 0.7864 | 0.7417 | 0.6920 |
ReaRec 是一个为召回设计的隐式推理方法,作者把它改成能同时给多个候选打分,用来对比。Refiner 在所有设置上都高于它,说明针对排序设计的残差目标和候选级推理比搬用召回里的做法更合适。
工业集上的提升小得多,CTR GAUC 只高了千分之一点六。作者的解释是原模型已经在线上打磨过,剩下的空间本来就小;他们也提到工业界通常认为千分之一的提升就有意义,这个差异的配对检验 p 值是 0.008。
分组分析里,Refiner 在冷门物品组上提升最大,在最热门的物品组上提升最小。这和开头的示意例子一致:原模型对冷门物品的表征不可靠,修正的空间也最大。
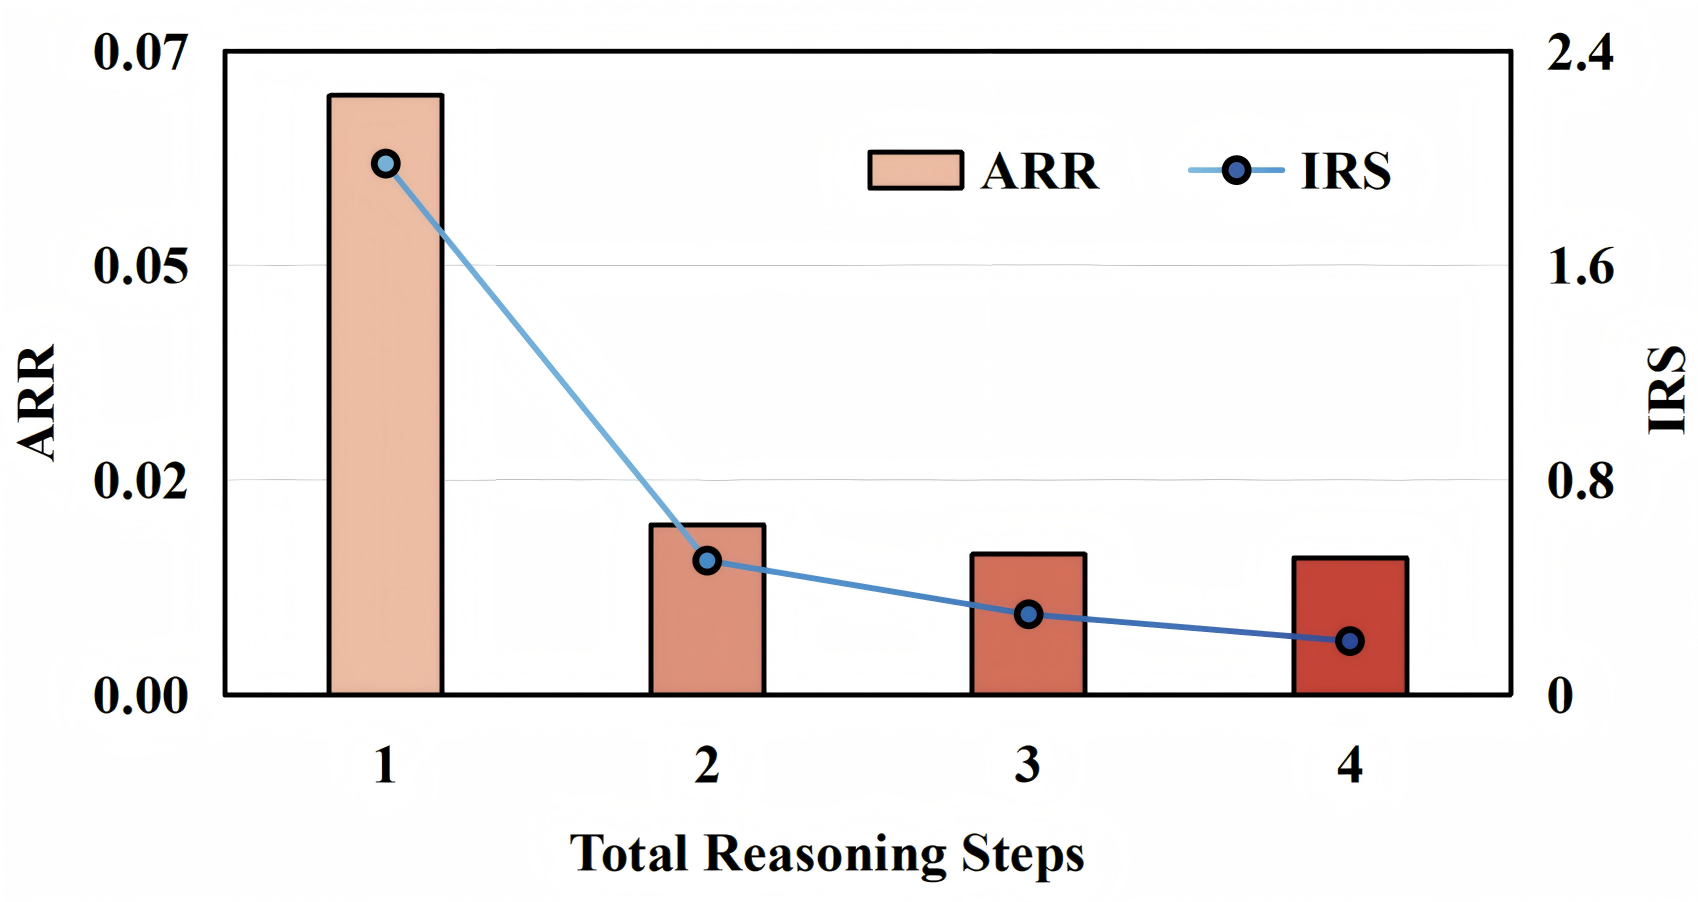
推理步数从 1 加到 4,收益很快递减。图 5 显示每一步修正量的大小逐步缩小,后面几步只做很小的调整,而推理时间随步数持续增加,所以作者建议 1 到 2 步。
线上实验接在 15 层 MTGR 之后,因为延迟只用 1 步推理,1% 流量,先预热 7 天再观察 7 天。
| 指标 | 按曝光点击率 | 按用户点击率 | 按用户点击转化率 | 订单数 | GMV |
|---|---|---|---|---|---|
| 相对 MTGR 提升 | +0.75% | +0.12% | +0.21% | +0.19% | +0.46% |
7 天里每天的提升都为正,没有某一天单独拉高均值。这说明增量训练的方式能稳定跟住原模型每天的更新。
我认为它的局限
第一,公开数据集的设置太简单。每次只在一个正样本和一个随机负样本之间排序,随机负样本往往很容易区分,所以公开集上 2% 到 4% 的相对提升,到了真实的工业候选集上缩到千分之一点六到千分之二点五。读者应该以工业数字为准。
第二,延迟没有给出绝对值。每多一步推理就要在更长的序列上再跑一次 Transformer,工业集用户的平均行为长度是 1,363。论文只给了相对推理时间,并说明推理步还没有做服务端优化,线上也因此只用了 1 步。要评估上线成本,得自己测。
第三,对比对象偏少。唯一的隐式推理基线 ReaRec 是改造过来的,同类工作 OnePiece 因为需要候选之间互相交互、主干不同,没有正面比较。
一个推荐或搜索团队可以怎么试
- 在已有的 Transformer 排序模型后面只加 1 步推理:冻结原模型,加 LoRA 和一个修正量输出层,用平方误差训练累计分数。先离线看 GAUC,因为它对候选内部的细排序更敏感。
- 历史摘要先取 2 条,取原模型历史段最后两个位置的输出。这一步额外开销小,消融里贡献明显。
- 重点看冷门物品和长序列用户这两组,论文里收益集中在这里。如果这两组没有提升,大概率整体也不会有。
- 线上先测清楚多一次前向的延迟,再按原模型的日更节奏做增量训练。多于 1 步的收益很小,不建议一开始就加。
一句话结论
让多算的几步预测对原分数的加性修正,并冻结原模型、只训练附加模块,是在已上线排序模型上加推理的一种低风险做法。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。排序阶段能否用额外计算换精度,是生成式排序下一步要回答的问题 |
| 方法创新性 | 中。推理 token 和 LoRA 都是现成部件,残差目标和候选级掩码的组合是本文的贡献 |
| 实验证据 | 中。有工业离线和线上 A/B,但公开集设置偏简单,工业提升只有千分之一到千分之二点五 |
| 工程成本 | 中。不改原模型,但要多一次全序列前向,并维护一条跟随原模型的增量训练流程 |
| 是否值得尝试 | 值得,适合已有 Transformer 排序模型、冷门物品占比高、能接受一次额外前向的团队 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…