目录 · 9 节
1它到底在解决什么问题?2整体流程3为什么一层隐藏状态加一个线性层就够?4换了领域怎么办?用结束的请求在线修正5放在 CPU 上会不会拖慢调度?6实验:服务真的更快吗?7我认为它的局限8一个推荐/搜索团队可以怎么试9结论与评价
做大模型推理服务的团队值得读,因为 LEAP(这篇论文的长度预测系统)把按长度调度里最贵、最容易失效的一环,也就是长度预测器,换成了一个几乎不花钱、上线后还能自己修正的小部件。让短请求先跑能明显降低平均延迟,前提是提前知道每个请求大概要生成多长,而现有的长度预测器换个领域排序就会变差,本身还要占 GPU。LEAP 发现,服务模型做 prefill 时算出的隐藏状态里已经带着输出长度的信号,在一层隐藏状态上接一个线性层就能读出来,不用另跑一个编码器。这个线性层放在 CPU 上算,和 GPU 上剩下的 prefill 同时进行,不占 GPU。每个请求结束后,LEAP 用递推最小二乘法拿这条请求的真实长度按公式直接修正线性层权重,不用算梯度,也不用回放旧数据。在 ShareGPT 流量的单卡实验里,平均每个 token 的延迟比几种现有预测器低 15.9% 到 40.8%。长度预测好不好,要看调度后的延迟和预测本身的成本。
它到底在解决什么问题?
推理引擎每一步 decode 能同时推进的请求数是有限的。论文的实验里,显存里最多驻留 512 个请求,每一步只有 64 个 decode 名额。请求多于名额时,就要决定谁先走。先到先服务(FCFS)的问题是,一个要写 2000 个 token 的长回答会占着名额,后面几个只要几十个 token 的短回答都得陪着等。
用一个示意例子看。三个请求同时到达,每步只能推进一个:
| 请求(示意) | 真实输出长度 | FCFS 下的完成时刻 | 短的先跑时的完成时刻 |
|---|---|---|---|
| A:写一份长报告 | 1000 步 | 1000 | 1150 |
| B:翻译一句话 | 50 步 | 1050 | 50 |
| C:回答是或否 | 100 步 | 1150 | 150 |
| 平均 | 1067 | 450 |
短的先跑,平均完成时间从 1067 降到 450(示意)。但调度器事先并不知道 A 要写 1000 步,只能靠预测。这里有两个要求。第一,预测要能分清 50 步和 500 步,猜成 53 还是 50 没什么区别,论文把这点作为设计出发点:调度要的是排序对。第二,预测本身不能太贵,否则省下的 GPU 时间又被预测器吃掉。
现有预测器在排序质量和自身成本上都有问题。TIE(估计长度不确定性的预测器)和 SSJF(用一个小代理模型预测长度)都另外跑一个文本编码器读 prompt;LTR 另外训练一个排序模型,只给出请求之间的先后分数,不输出长度。这三种方法的参数在 1 亿到 2 亿之间,还和服务模型抢 GPU。TRAIL(在隐藏状态上接 MLP 的预测器)和 EGTP(按每个 token 的熵给隐藏状态加权汇总,再预测长度)复用服务模型的隐藏状态,但后面接的是几百万参数的 MLP。更麻烦的是,这些预测器在一个数据集上训好后,换到别的任务或语言上排序会明显变差,要恢复只能重新收集数据、重新训练、重新部署。
整体流程
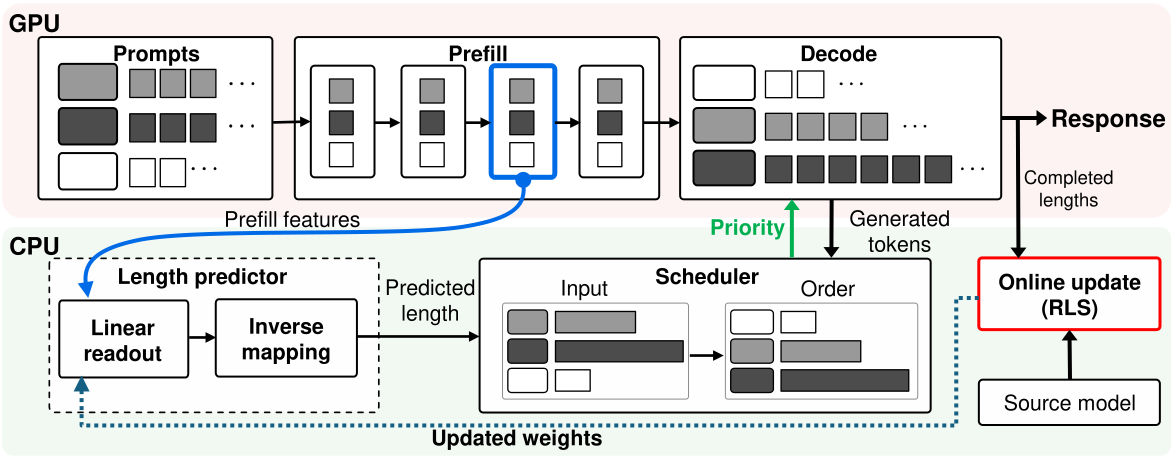
LEAP 有三个核心部件:线性读出、在线修正和 CPU 异步执行。下表按一个请求经过的顺序排列,其中“倒计时调度”是使用预测结果的调度器:
| 阶段 | 在哪算 | 输入 | 输出 |
|---|---|---|---|
| 取特征(CPU 异步执行) | GPU → CPU,与剩余的 prefill 同时进行 | prefill 进行到第 30 层时最后一个 prompt token 的隐藏状态 | 一个 4096 维向量 |
| 线性读出 | CPU | 这个向量 | 预测的总输出长度 |
| 倒计时调度 | CPU | 预测总长、已生成的 token 数 | 剩余长度,名额不够时剩余短的先走 |
| 在线修正 | CPU 后台线程 | 已结束请求的特征和真实长度 | 新的线性层权重 |
关键的分工是:服务模型负责“理解”请求,线性层只负责把这份理解换算成一个长度,递推最小二乘(RLS,下文细讲)负责在部署后把换算关系校准到新的流量上,CPU 异步执行保证这些计算不拖慢 GPU。下面拆开讲。
为什么一层隐藏状态加一个线性层就够?
服务模型 prefill 时已经完整读过 prompt,而且它就是之后要生成回答的那个模型。它的隐藏状态里既有 prompt 的内容,也有“这个模型打算怎么回答”的信息。另外再跑一个编码器读一遍 prompt,等于把同样的工作做两遍。
LEAP 取 Qwen3-8B 第 30 层(靠后但不是最后一层)最后一个 prompt token 的隐藏状态,先按训练集上的均值和尺度做标准化,再用岭回归(Ridge)拟合一个线性层。整个预测器只有 4,097 个参数,FP32 下 16.39 KB,能放进一个 CPU 核的私有缓存。
拟合目标不是长度本身,而是长度的平方根。原因是不同的目标会让模型在意不同的错误。直接拟合长度,几个极长的回答会主导损失;拟合对数长度,同样差 100 个 token,长请求上的惩罚又小得太多,长请求之间就分不清了。平方根介于两者之间。用一个能心算的例子看,同样猜错 100 个 token(示意):
| 真实长度 | 平方根目标上的误差 | 对数目标上的误差 |
|---|---|---|
| 100 → 猜成 200 | √200 − √100 ≈ 4.1 | ln2 ≈ 0.69 |
| 1000 → 猜成 1100 | √1100 − √1000 ≈ 1.5 | ln1.1 ≈ 0.10 |
对数目标下,长请求上的这次猜错几乎不受罚(0.10 对 0.69);平方根目标下还剩 1.5 对 4.1。论文的消融(表 6)给出了三种目标各自的强项:不超过 256 token 的短请求上,对数目标的平均误差最小(50.7),直接拟合长度最差(105.4);超过 1024 token 的长请求上,直接拟合长度最好(266.3),平方根目标接近(279.3),对数目标最差(310.4)。平方根目标两头都不差,整体误差最低(149.6),所以默认用平方根。预测时先把线性层的输出截到 1 到 √M 之间(M 是输出长度上限,实验里取 2048,所以上界约 45.3),再平方回长度,避免一个很负的值平方后变成一个很大的长度。
一层够不够?表 7 里,把所有层的隐藏状态拼起来,平均误差只降 3.3%,但每个请求要传到 CPU 的数据从 16 KiB 涨到 592 KiB。这说明在第 30 层之外再加别的层,收益很小,搬运成本却大很多。第 30 层是论文沿用的默认设置,没有在测试集上专门挑选。
换了领域怎么办?用结束的请求在线修正
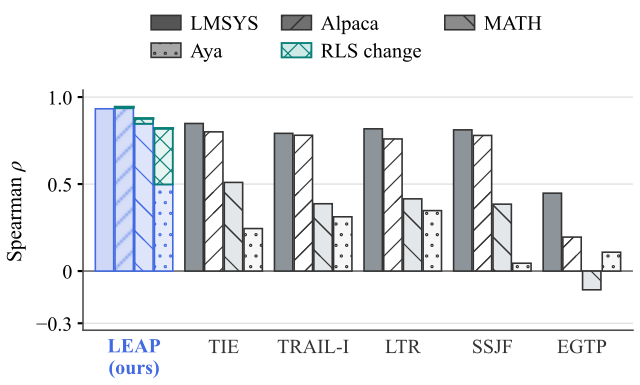
线性层在 LMSYS 对话数据上训好后,换到别的流量会怎样?论文把它直接搬到三个新场景:Alpaca 指令、MATH 数学题、多语种的 Aya。在 Alpaca 和 MATH 上排序仍然不错,在 Aya 上 Spearman 相关掉到 0.498。这说明语言变了以后,隐藏状态和长度之间的换算关系也变了。
修正的信号是现成的:每个请求结束时,真实输出长度就知道了。LEAP 用 RLS 来用这个信号。RLS 是线性回归的增量版本:它维护一个矩阵 ,记录特征在各个方向上还剩多少不确定:老数据覆盖充分的方向 小,很少见过的方向 大。每来一批新样本,就用一个闭式公式算出修正量,不用算梯度,也不用把旧样本重新拿出来。核心更新只有一行:
是线性层当前的权重, 是这批已结束请求的特征, 是它们真实长度的平方根, 就是这批请求上的预测误差, 决定误差在多大程度上改动权重,算法是先算 ,再算 ,更新完再令 ,供下一批使用。 的初值是 , 是 LMSYS 训练特征。直觉是:老数据里证据充分的方向,修正量小,权重不太动;新流量里才出现的方向,修正量大,权重改得多。
还有一个设计是“锚定”。RLS 的起点不是零,而是在 LMSYS 上训好的权重。所以新反馈少的时候,模型基本保持原样,反馈多了才逐渐偏向新流量。论文证明,逐批更新的结果和把全部反馈一次性放进来、求解同一个“以 LMSYS 权重为锚”的目标完全一样,批大小只影响更新时机。
在 Aya 上,经过 RLS 修正,Spearman 相关从 0.498 升到 0.820,相对提升 64.7%,只动了线性层,服务模型一个参数都没改。
放在 CPU 上会不会拖慢调度?
预测器放在 CPU 上的风险是,GPU 都准备好 decode 了,长度还没算出来,调度器只能干等或者用旧信息。LEAP 的做法是:prefill 走到第 30 层就把那个隐藏状态拷到 CPU,GPU 继续跑剩下的层,CPU 同时做一次点积,算出长度并排好初始顺序。论文在最后的 RMSNorm 之前放了一个 GPU 探针检查结果是否就绪:144 次异步试验全部就绪,72 次“prefill 完才开始算”的对照全部没就绪。
吞吐也够:一个 CPU 核每秒能处理到 1 万次预测不排队,约 5.8 万次时饱和,P95 延迟始终低于 3 毫秒。RLS 更新在另一个线程里做,每攒够 8 个结束的请求更新一次,调度器在更新期间继续用已发布的旧权重,剩余长度照常倒数。
实验:服务真的更快吗?
最关键的实验是表 3:ShareGPT 流量,每秒 2.65 个请求,所有方法回放同一批请求、同一组生成轨迹,用同一个调度规则,只换长度预测器,预测成本全部计入。PTL 指每个请求从计划到达时刻到完成的延迟(含预测、排队和执行)除以它实际输出的 token 数,再对请求取平均;它不是 token 间延迟。
| 方法 | 平均 PTL(ms/token) | P90 PTL | 平均 TTFT(ms) | 吞吐(token/s) |
|---|---|---|---|---|
| FCFS | 250.97 | 359.96 | 55.10 | 1094.03 |
| TRAIL | 107.42 | 189.32 | 67.18 | 944.71 |
| TIE | 78.48 | 152.33 | 66.50 | 1089.84 |
| SSJF | 76.07 | 154.50 | 62.27 | 1108.46 |
| LTR | 75.62 | 151.95 | 60.40 | 1120.88 |
| LEAP | 63.58 | 127.47 | 55.27 | 1141.93 |
LEAP 的平均 PTL 比最强的 LTR 低 15.9%,比 TRAIL 低 40.8%,吞吐比 LTR 高 1.9%,首 token 延迟和不做预测的 FCFS 几乎一样。这和预测器放在 CPU、不占 GPU 的设计相符,不过表 3 是单次运行。
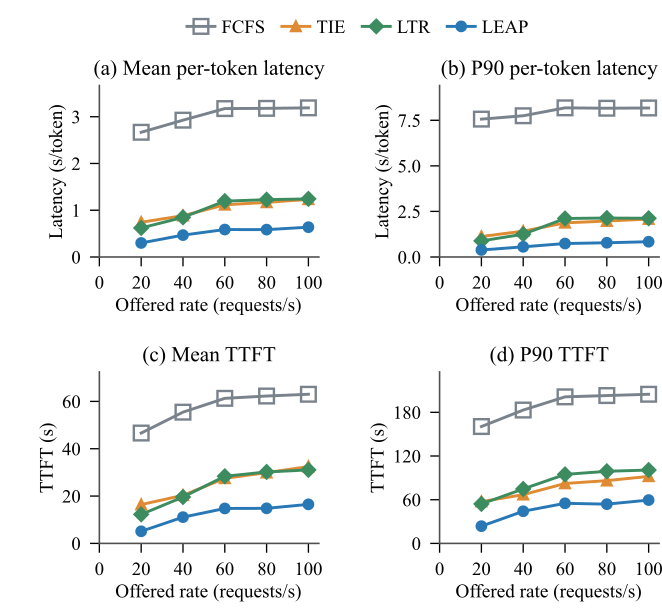
图 6 的负载扫描里,三种预测器都远好于 FCFS,所以相对 FCFS 的大部分收益来自按长度排序本身。LEAP 剩下的优势混合了更准的排序和不占 GPU 两个来源,这个单次实验没有把两者拆开。
换领域后的调度用模拟做(表 4,不计预测成本,所有方法用同一套等待保护)。把到达速率调到 FCFS 模拟所测处理能力的 1.5 倍,RLS 在 Aya 上帮助最大:平均响应时间从冻结的 LEAP 的 180.59 秒降到 161.18 秒。MATH 上,同样负载下,平均响应时间从 TIE 的 118.34 秒降到 LEAP 的 100.94 秒,加上 RLS 再降到 94.36 秒。负载越高差距越大,因为队伍越长,排序对不对越要紧。
预测更准不一定服务更快,表 2 给了一个反例:decode 过程中不断刷新隐藏状态重新预测,误差确实下降,但 LEAP 的平均响应时间反而变长 8.37% 到 9.42%,TRAIL 变长 9.16% 到 12.89%,因为反复预测本身有成本。论文也提醒,两种预测头的训练目标不同,这个对比没有单独隔离“刷新特征”这一项的影响。这正是论文选择“只在 prefill 取一次特征、平时倒数”的理由;只有 RLS 发布新权重时,才用缓存的特征给还在跑的请求重新打一次分。
我认为它的局限
第一,长请求会更慢。按长度调度天生偏向短请求。表 4 里所有方法已经用了同一套等待保护(TIE 的指数老化规则,请求等得越久优先级越高),但 MATH 上 RLS 仍让 P95 上升,LEAP、LEAP 加 RLS 和 TIE 的 P95 都比 FCFS 高。真实引擎里另有一个 128 步的等待上限。对长任务有 SLA 的服务,要单独测尾延迟,并调整这类保护的力度。
第二,服务环境很简化。原型只在单卡、eager 模式的 vLLM 0.8.5 上跑,没有前缀缓存、没有分块 prefill,也没有多卡并行。分块 prefill 下,“第 30 层隐藏状态什么时候可用”会变复杂,CPU 能否赶在 prefill 结束前算完需要重新测。
第三,预测不看解码参数。线性层只读 prefill 的隐藏状态,温度、top-k 这些解码设置不同,同一个 prompt 的输出长度会不同,它无法区分。表 3 是单次运行,没有给方差。
一个推荐/搜索团队可以怎么试
做 LLM 生成式搜索摘要、对话式推荐的团队,推理服务往往同时有短回答和长回答,可以这样试:
- 先离线验证信号:从线上日志里取一批请求,用自己的服务模型跑 prefill,取一层靠后的隐藏状态,拟合平方根长度的岭回归,看 Spearman 相关。作为参照,论文里冻结的 LEAP 在 Aya 上只有 0.498,调度结果仍比 TIE 好。
- 在回放环境里只换调度:保留现有引擎,用预测出的剩余长度决定 decode 名额,对比 FCFS 的平均和 P90 延迟,同时盯住长请求的 P95,加上等待上限。
- 再加 RLS:用一周后的流量或另一类业务的流量做迁移测试,看在线修正能把相关拉回多少。RLS 状态在 4096 维时只占约 64 MiB 内存,成本很低。
- 最后才接到线上:确认 CPU 预测在你的 prefill 时长内能完成,再小流量 A/B。
结论与评价
最关键的启发是:长度预测服务于排序,评价它要看调度后的延迟和预测本身的成本,只看预测误差会选错方案。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。按长度调度是推理服务的常见优化,预测器的成本和迁移性一直是落地障碍 |
| 方法创新性 | 中。复用隐藏状态预测长度已有先例,新意在线性读出、平方根目标和锚定 RLS 的组合 |
| 实验证据 | 中高。三个模型、多个数据集,服务实验计入了预测成本;但服务结果是单次运行、单卡环境 |
| 工程成本 | 中低。预测器只有 4,097 个参数、CPU 一次点积;但要在模型前向里截取第 30 层隐藏状态、异步拷到 CPU,再加 CPU 工作进程和 RLS 更新线程 |
| 是否值得尝试 | 值得。离线验证只要一批日志和一次岭回归,失败成本很低 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…