目录 · 10 节
1CTR 在训练前做的六步2能挪哪些时间,由任务专用的处理程序决定3挪完之后,同一段动作配上了更多种对侧进度4主相机画面靠前景合成,人为等待用 IdleMask 屏蔽5探针实验:独立阶段对对侧的依赖降了下来6换一个起始进度,最差成功率从 56% 升到 76%7训练时没有的暂停和进度组合下,CTR 依然稳住8需要配合的地方,违规率降到 0% 和 4%9提升来自重排本身,还是来自合成画面和 IdleMask10普通条件下 24 个组合里 19 个提升,Place Dual Shoes 没涨
双臂机器人策略会学出「另一只手没动,这只手也不动」的毛病,这篇论文把原因指向示教(人操作机器人录下的演示)里太单一的时间安排,办法是不加示教,在训练前把录好的动作按任务允许的范围重新错开时间。
双臂模仿学习的做法是:人先操作两只机械臂把任务做若干遍,系统录下画面和两只手的动作,策略模型再根据当前画面和两只手各关节的角度预测两只手接下来的动作。全文用一个示意场景:机器人要把一个物体放进抽屉,右手拉开抽屉,左手抓起物体再放进去。这个任务只有一条硬要求,就是左手放入之前抽屉必须已经开着。左手什么时候抓起物体,和抽屉开没开没有关系。
难就难在,示教把「要做什么」和「这一遍恰好什么时候做」录在了同一条时间线上。假设示教者每次都习惯右手先拉开抽屉,左手再去抓(示意)。那么在每一条示教里,左手开始抓的时候抽屉都已经开着。对模型来说,「抽屉开了」就成了预测「左手该抓了」的完美信号,用上它不会让训练损失变差。上线后右手只要慢一点,左手就可能跟着停在原地。作者把这种现象叫虚假的跨臂耦合:两只手本来各干各的,一只手的动作却依赖上了另一只手的进度。
最直接的补救是多录示教。可是按同一种习惯再录 1000 遍(示意),左手开始抓时抽屉仍然开着,新数据还是分不清这个先后是任务要求还是示教者的习惯。稍好一点的做法是把右手先做、左手先做(一只手这段做完,另一只手再开始)、两只手同时开始这三种安排混在一起训练,论文里这个基线叫 Mixed。放到抽屉例子里,Mixed 只提供三种时间差,「左手刚抓了四分之一、右手拉到三分之二」这样的中间状态,训练时仍然一次都没出现过。
时间安排单一在公开数据集里很普遍。作者统计了 RoboTwin 2.0、RoboCOIN、DexMimicGen、BiCoord 四个双臂数据集,716 个任务里有 266 个(37.2%)含有可以换先后的独立动作,也就是可以换时间安排,而这 266 个任务里只有 3.4% 在数据中出现过不止一种可行安排。这说明可换的时间安排大多没有被录下来,直接拿现成数据集训练,模型很难见到它们。
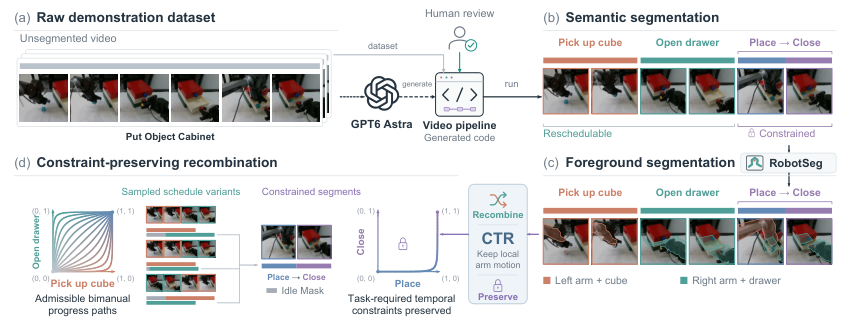
这篇论文的 CTR(Constraint-preserving Temporal Recombination)改的是训练数据:模型结构不动,示教条数不加。CTR 在训练前按检测到的交互把每只手的录制切成段,每段的内容和时长都不变,只在任务允许的范围内改每段的开始时间。放到抽屉例子里,左手的抓取有时排在抽屉打开之前开始,有时和拉抽屉同时进行,而左手的放入永远排在抽屉打开之后。
效果最直观的一组数字来自真实机器人上的 Sort Letters 任务,两只手在这个任务里各自分拣不同的字母。作者用视觉-语言-动作模型 π0.5(输入画面和文字指令,输出动作)训练,再在执行中途人为暂停一只手 4 秒。只用「两只手同时开始」的数据训练时,另一只手的完成时间被拖慢 2.56 秒;用 CTR 数据训练时只慢 0.25 秒。这说明在两只手互不相干的任务上,CTR 训练出的策略基本不再让一只手替另一只手等待。
CTR 在训练前做的六步
CTR 的全部工作都发生在训练之前。部署时策略拿到的还是普通的画面和关节状态,读不到任何约束标注。下面这张表是抽屉例子里一条示教走过的路径。
| 步骤 | 输入 | 操作 | 产出 | 发生在什么时候 |
|---|---|---|---|---|
| 生成处理程序 | 任务描述 | GPT-6 Astra(OpenAI 的大模型)写一个该任务专用的视频处理程序 | 处理程序 | 任务设置时,每个任务一次 |
| 切段、找约束 | 一条示教 | 处理程序检测交互,把每只手切成有序的段,列出必需的跨臂关系 | 段表和关系表 | 构造数据时 |
| 抽新的时间安排 | 段表和关系表 | 保持同一只手内部的顺序,冻结受约束段的时间差,其余段随机挪动 | 每段的新开始时间 | 构造数据时 |
| 重组数据 | 新开始时间和原始录制 | 每只手按新时间读取原始片段,主相机画面用前景合成 | 一条新示教 | 构造数据时 |
| 屏蔽人为等待 | 新开始时间 | 标出挪动时插入的等待,这些位置的动作不计模仿损失 | IdleMask | 构造数据时生成,训练时生效 |
| 训练 | 新示教和 IdleMask | 用原有的 DP(Diffusion Policy,扩散策略)、ACT(后文解释)或 π0.5 照常训练 | 策略模型 | 训练时 |
能挪哪些时间,由任务专用的处理程序决定
表里第二步决定了这件事安不安全。「抽屉必须先开」和「示教者习惯右手先动」在时间线上长得一模一样,只看录制时序分不出来,所以判断必须来自时序之外的任务知识。CTR 的任务知识来自 GPT-6 Astra 在任务设置时写好的处理程序。GPT-6 Astra 每个任务只调用一次,之后由这个程序跑完所有视频,GPT-6 Astra 不给单个视频打标签。
抽屉例子里,处理程序对一条 10 秒的示教会产出类似下面的结果。数字和写法都是示意,这里只列两只手真正在干活的段:
右手段表:开抽屉 [0, 3]
左手段表:抓物 [3, 7],放入 [7, 10]
必需关系:放入 必须在 开抽屉 之后,两段的开始时间差固定为 7 秒
CTR 不改受约束两段在原始录制里的开始时间差(这里是 7 秒),所以开抽屉和放入要挪只能一起挪,CTR 在这条示教里可以单独挪动的只有左手的抓物。抓物的内容和 4 秒时长都不变,开始时间可以从第 3 秒改到第 0、1 或 2 秒,因为它只需要赶在第 7 秒的放入之前结束。论文的实现在可行范围内均匀采样这个偏移。
为什么不把所有段都随机挪?如果放入也可以随便挪,CTR 就可能造出「放入排在抽屉打开之前」的示教,模型学到的就成了把物体往关着的抽屉里塞。
CTR 的做法比「只要求先后顺序」还保守:受约束的两段连时间差都不动。示意里开抽屉不动、放入再晚 1 秒开始本来也合法,CTR 也不去采这个安排。它放弃一部分合法安排,优先保证重组出来的数据不违反任务约束。
切段、找约束这一步出错,错误会直接进训练数据。处理程序如果检测错交互、切错段边界,或者写错关系逻辑,CTR 就会造出无效的重组。所以 CTR 还加了任务专用的几何、接触和观测一致性检查作为保守过滤,例如挪动后两只手的新位姿组合无法确认不相撞,这条安排就被丢弃。
挪完之后,同一段动作配上了更多种对侧进度
盯住「左手抓物的第 1 秒」这一小段动作。下面四种时间安排里,这一段左手动作完全相同,只有同一时刻右手的进度不同(示意,进度按开抽屉这段已经过的时间占全段 3 秒的比例算,0 表示还没开始,1 表示已经完成):
| 时间安排(示意) | 左手抓物开始于 | 右手开抽屉开始于 | 左手抓满 1 秒时的右手进度 |
|---|---|---|---|
| 右手先做(原始录制) | 第 3 秒 | 第 0 秒 | 1 |
| 左手先做 | 第 0 秒 | 第 4 秒 | 0 |
| 两只手同时开始 | 第 0 秒 | 第 0 秒 | 1/3 |
| CTR 抽到的一种 | 第 1 秒 | 第 0 秒 | 2/3 |
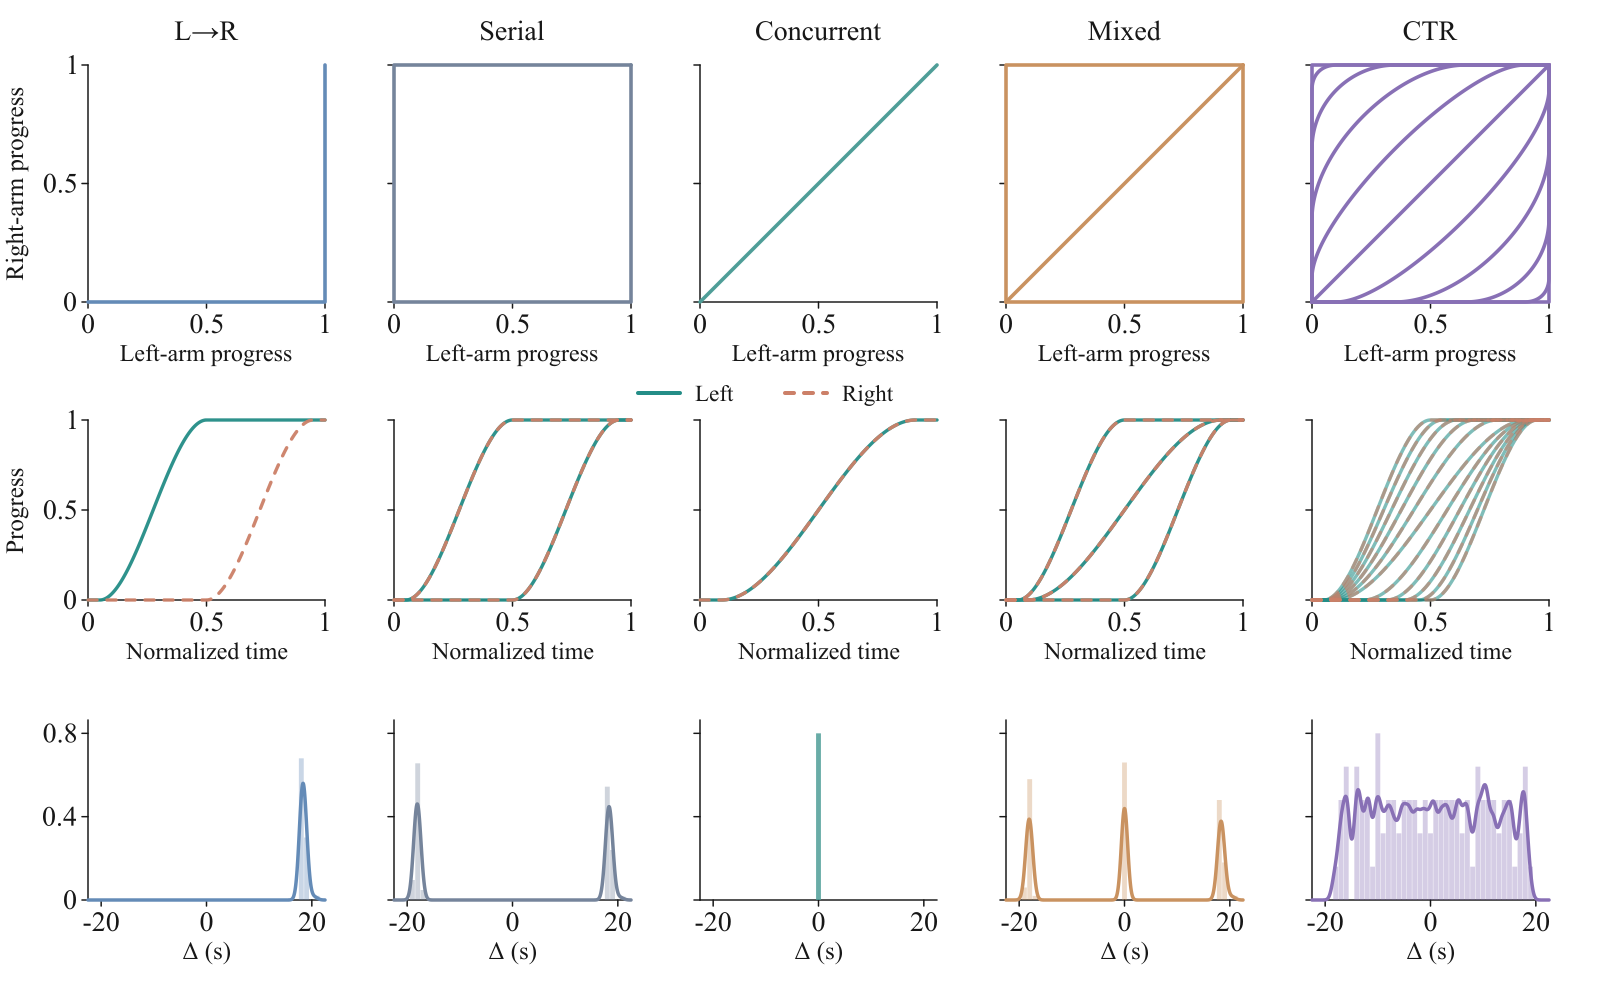
前三行对应 Mixed 的三种安排,示意里每种安排只有一个固定时间差,所以同一段左手动作只配过三种右手进度。CTR 可以在可行范围内取到中间的其他值,比如第四行的 2/3。我的理解是,同一段左手动作配上各种右手进度之后,右手进度就很难帮模型预测左手的下一步,模型靠这条捷径也降不了多少损失。
论文把(左手进度,右手进度)这一对数叫 bimanual progress state,下文叫进度组合。实验对比五种训练时间安排:L→R 是左手先做的一种串行顺序(一只手这段做完,另一只手再开始),Serial 包含左先右、右先左两种串行顺序,Concurrent 是两只手同时开始,Mixed 是两种串行加同时开始,CTR 在可行范围内采样相对时间。
主相机画面靠前景合成,人为等待用 IdleMask 屏蔽
先看画面。每只手的关节数据和手腕相机画面,按新时间读取原始录制就行。主相机却同时拍着两只手,挪完之后需要的画面原始视频里根本没有。
示意:CTR 抽到「抓物从第 1 秒开始」时,新时间线的第 2 秒里,左手要用原始第 4 秒的内容,右手要用原始第 2 秒的内容。原始视频第 2 秒时左手还没开始抓,第 4 秒时抽屉已经开完,没有哪一帧同时满足两边。
CTR 的办法是用前景分割把两只手和相关物体抠出来,按各自的原始时间贴到场景背景上。合成图只是近似真实的同时场景,所以接触敏感的段和两只手耦合的段(比如两只手同时作用于同一个物体)都被保护起来,不参与重排。左手单独抓物只涉及左手自己和物体,属于可以单独挪动的段。
再看等待。上面这个安排里,左手在第 0 到 1 秒、第 5 到 7 秒没有动作,一共等了 3 秒(示意)。这两段空档都由重组后的时间表产生:一段在抓物之前,一段在抓物和放入之间。示教者并没有按这个时间表等过,它们是拼接出来的等待。如果照常计算模仿损失,左手动作标签里就有 30% 在教模型原地不动。
IdleMask 把这些由重组插入的等待对应的动作维度和时间步屏蔽掉,让模仿损失在这些位置为零。屏蔽只针对人为插入的等待。右手拉开抽屉后第 3 到 10 秒的保持属于收尾保持,任务必需的保持和支撑也一样,这些都继续计入监督。 Hoot 说

- 受约束的段对:相对偏移冻结
t3、t4 这两列里,左手干活照常学,只有右手那两行被屏蔽。右手 t6、t7 不动,但这是录制里就有的保持,照常监督。
- 本该监督、却被一起丢掉的动作
这张图是误读,论文的做法是左边那张。只要有一只手在等就丢整帧,另一只手的有效动作也没了监督。
- 录制片段里的动作:计损失
- 必需保持或收尾保持:计损失
- 人造等待:损失置零
- 数一数(示意):4 个坐标 × 10 个时间步 = 40 格。每只手有 3 步人造等待、2 个坐标,3×2×2=12 格置零,其余 28 格计损失,损失的分母也只数这 28 格。
- 按整帧丢弃:前 5 步每步都有一只手在等,5×4=20 格全丢,比该屏蔽的多丢 8 格,多丢的正是抓方块和开抽屉。
- 把所有不动的都屏蔽:两只手共 6 步保持,6×2=12 格也没了监督,其中 2×2=4 格记录的正是左手放入时右手不动。
示意:一条重排后的抽屉任务时间线,10 个时间步、每只手只画 2 个动作坐标,分段和步数都是示意。等待时这只手的状态、腕部画面、主视角前景和动作标签都按同一个录制时刻读取,也就是保持一个录制过的姿态。这条时间线只是可行集合 Ω(τ) 里的一个样本:先要满足约束标注,再过几何、接触和观测一致性筛选,通不过就被拒绝。必需和可重排的逻辑写在 GPT-6 Astra 按任务描述生成的程序里,部署时不再调用。
出处
论文 §4.2–§4.3;附录 F 算法(按任务描述 ξ 生成程序);F.3 式 16(等待时 source-time map 停在第一段起点或上一段终点);F.5 式 18–19(按批次、预测步、手臂、动作坐标索引的掩码,分母只数未屏蔽项);附录 G(等待保持录制姿态,几何/接触/观测一致性筛选)。时间线、坐标数和格子数均为示意探针实验:独立阶段对对侧的依赖降了下来
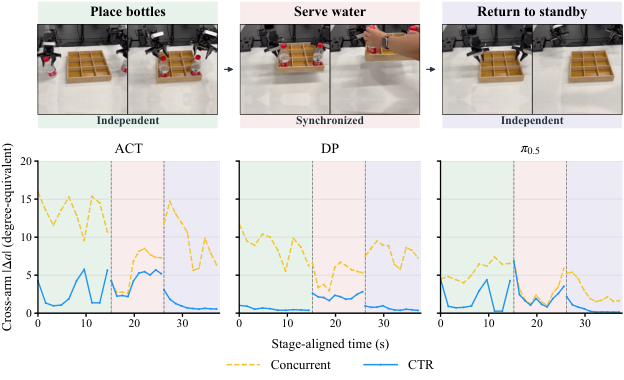
第一个检验直接量动作。作者在真实机器人的 Deliver Water 任务上做探针实验,这个任务分三段:放瓶子时两只手独立,倒水时两只手必须同步,回待机时又独立。探针固定一只手的状态和观测,只改对侧的状态和观测,量这只手的预测动作变了多少。数值越大,这只手的动作越受对侧影响。
用 Concurrent 数据训练的 ACT(Action Chunking with Transformers,一次预测一整段动作的模仿学习策略),放瓶子、倒水、回待机三段的敏感度分别是 13.28、5.82、9.77。这说明该模型在两个不需要管对侧的阶段,反而比必须同步的倒水阶段更受对侧影响。
用 CTR 数据训练的 ACT,三段分别是 2.79、4.19、1.07。两个独立阶段被压得很低。倒水阶段也从 5.82 降到了 4.19,但仍高于 CTR 自己的两个独立阶段。这说明 CTR 降的主要是独立阶段的依赖,同步阶段仍保留了比独立阶段更强的响应。这个探针只说明动作预测怎么变,任务成败要看下一节。
换一个起始进度,最差成功率从 56% 升到 76%
上一节的探针说明,策略的动作预测会随对侧进度变化。如果起步时的进度组合在训练里少见,这种依赖就可能让任务失败。作者在真实机器人的 Sort Letters 上用 π0.5 测了六个起始状态。下表表头的括号是(左手进度,右手进度),1 表示这只手这段独立工作已经做完。
| 训练数据 | C00 标准起点 (0, 0) | Cmid 都到一半 (0.5, 0.5) | L-lead (0.75, 0.25) | R-lead (0.25, 0.75) | CL (1, 0) | CR (0, 1) | 最差成功率 |
|---|---|---|---|---|---|---|---|
| L→R | 90 | 82 | 36 | 72 | 92 | 98 | 36 |
| Serial | 92 | 0 | 18 | 50 | 96 | 88 | 0 |
| Concurrent | 92 | 92 | 54 | 52 | 42 | 28 | 28 |
| Mixed | 74 | 94 | 58 | 56 | 96 | 74 | 56 |
| CTR | 94 | 94 | 76 | 96 | 100 | 100 | 76 |
表中是成功率(%),每格 50 次试验,一次成败就是 2 个百分点。
L→R、Serial、Concurrent 从标准起点都有 90% 到 92%,最差状态却分别跌到 36%、0%、28%。这说明标准起点的成功率发现不了这个问题。Serial 两种串行顺序都见过,在两只手都走到一半的 Cmid 上却一次也没成功,这说明见过两种顺序不等于见过中间的进度组合。
Mixed 把最差成功率提到 56%,CTR 提到 76%,说明覆盖更多时间安排有帮助。两者相比,右手领先的 R-lead 从 56% 升到 96%,右手已完成、左手未开始的 CR(表中最后一个状态)从 74% 升到 100%,Cmid 都是 94%。这说明只混三种固定安排还不够,覆盖三种之外的中间安排之后,最差起始状态上的成功率更高。
仿真的 Put Object Cabinet(和抽屉场景同类的放物入柜任务)上幅度小一些,最差成功率从 Mixed 的 48% 升到 CTR 的 56%。这个任务上 Concurrent 在 Cmid 有 98%,四个两手进度不对称的状态全部是 0%。这说明只见过同时开始的策略,一离开两手同步的进度就可能完全失败。
训练时没有的暂停和进度组合下,CTR 依然稳住
六个起始状态可能恰好落在 CTR 的训练覆盖里,所以作者又做了两个训练中没有的测试。
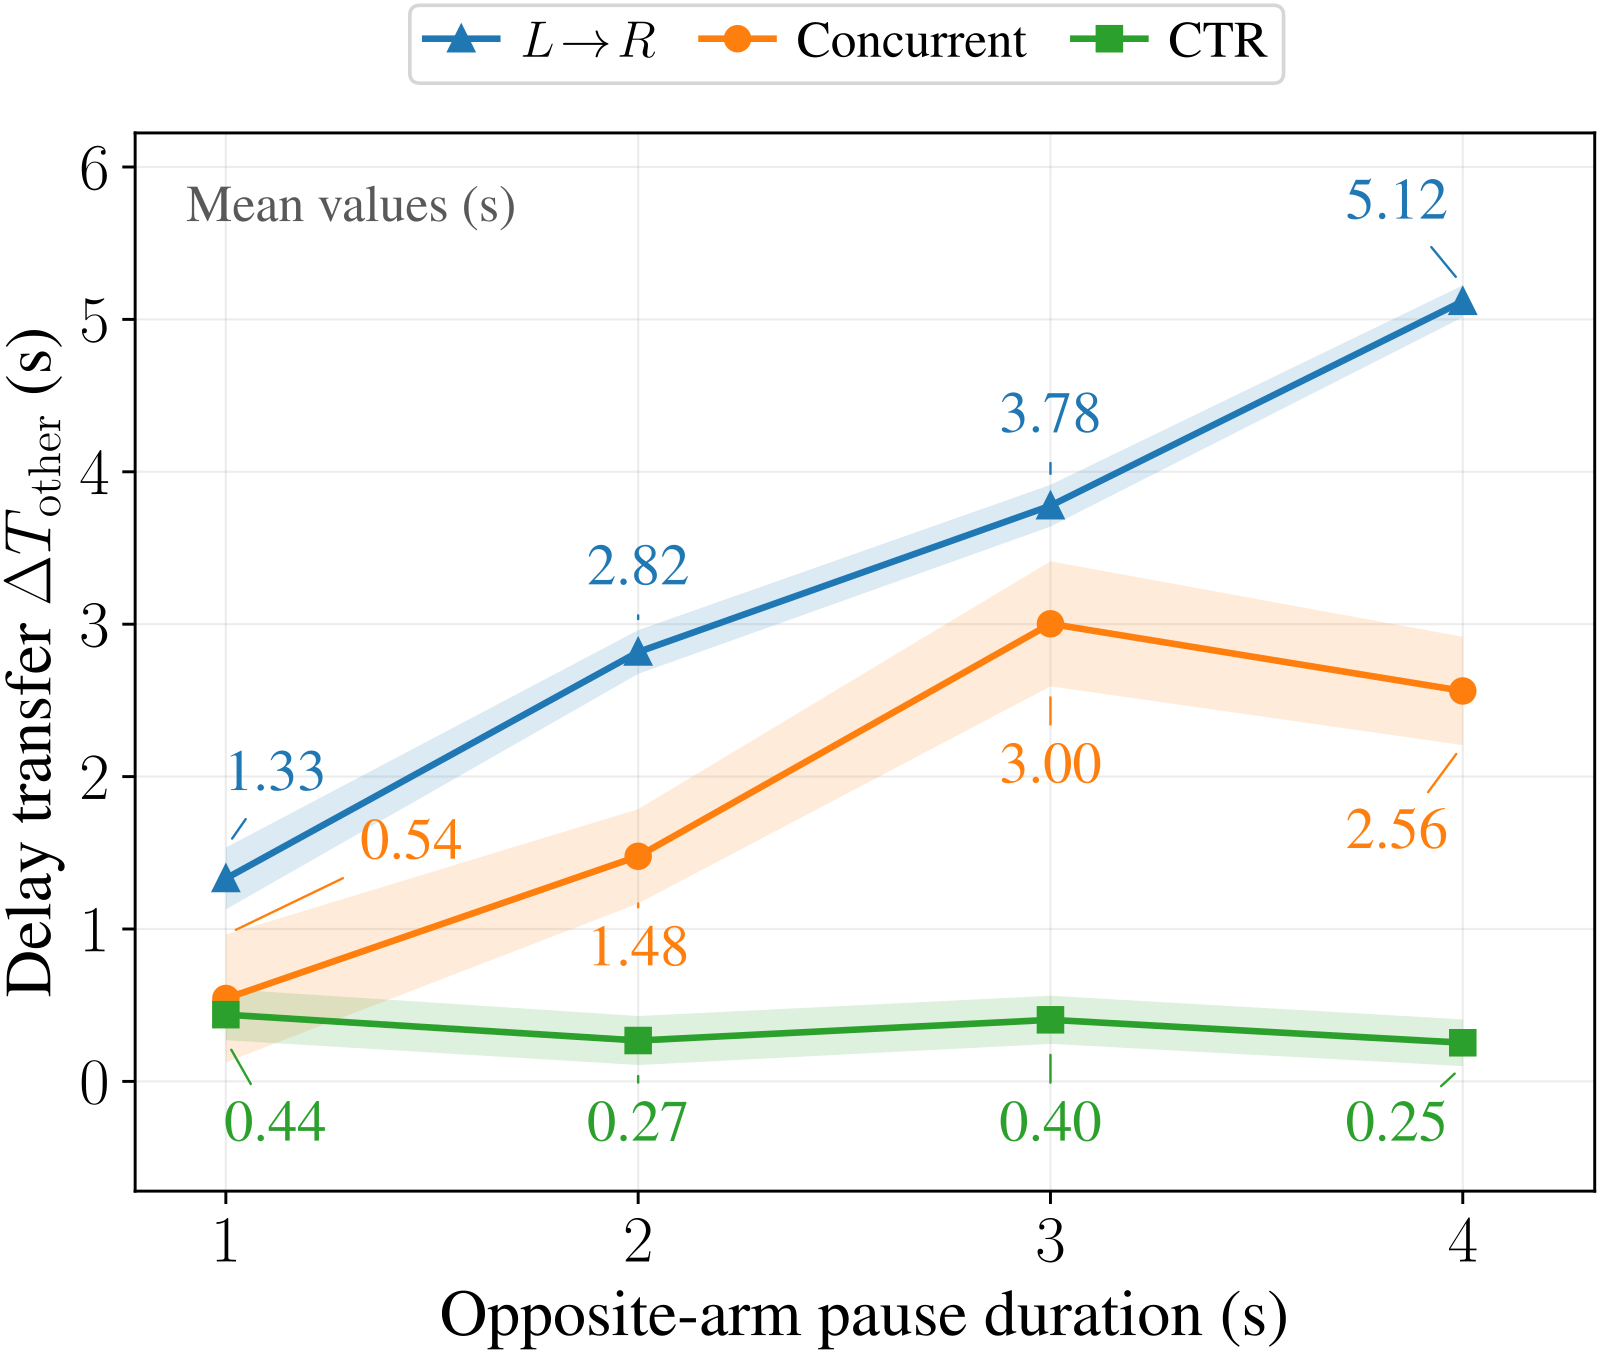
第一个是执行时暂停。在 Sort Letters 上,作者从外部暂停一只手,量另一只手比不暂停时多花多少时间。因为另一只手的任务要求没有变,理想情况下它一点都不该慢。暂停 4 秒时,L→R 拖慢 5.12 秒,Concurrent 拖慢 2.56 秒,CTR 拖慢 0.25 秒。
作者还在 1 到 4 秒四种暂停时长上,把多花的时间对暂停时长拟合成直线,斜率接近 1 表示暂停多久对侧就慢多久,接近 0 表示几乎不受影响。三者的斜率是 1.232、0.758、−0.042。L→R 的斜率比 1 还大,说明它练出的策略把暂停完整传给了另一只手,甚至略有放大;CTR 的斜率略低于 0,可以看作基本不传。放回抽屉例子,就相当于右手拉抽屉时卡了 4 秒,左手的抓取几乎不跟着晚(示意)。
第二个测试更严格,因为暂停产生的进度组合,CTR 训练时仍可能见过。作者在 Sort Letters 上挖掉一块进度区域:左手进度在 0.20 到 0.30、右手进度在 0.70 到 0.80 的组合。单只手的这些进度训练时都见过,见不到的只有这个组合。CTR-hole 版本从训练数据里删掉落在这块区域的样本,CTR-full 不删,Mixed 的三种安排本来就走不到这块区域。
从这块区域内起步,CTR-hole 成功率 74%,Mixed 58%,CTR-full 76%。这说明删掉这块区域之后,CTR 的成功率只比不删少了 50 次试验里的一次,依然高于 Mixed,好处不全靠提前见过测试状态。标准起点上三者分别是 92%、74%、94%,CTR-hole 同样没有因为少了这块数据而明显变差。
需要配合的地方,违规率降到 0% 和 4%
把时间打散最大的风险,是把真正需要的依赖一起打散。作者在两个真实机器人任务上用 π0.5 直接测这件事。
第一个任务是真实机器人上的 Put Object Cabinet,和抽屉场景同类。作者在左手放入前把抽屉关上,这时正确做法是等抽屉重新打开,强行放入算违规。L→R 基线的训练数据里从没出现过在抽屉前等待,98% 的试验都违规了;CTR 训练的策略每次都在抽屉前等待,违规率是 0%。
第二个任务 Organize Hardware 让两只手操作不同的五金件,但共用一块工作区,一只手占着时另一只手不能进。违规率从 Concurrent 基线的 36% 降到 CTR 的 4%。这两个任务的基线不同,不能合成一个总数看。
代价落在释放延迟上,也就是条件恢复后手臂开始动作的时间差。CTR 在抽屉任务上从基线的 0.01 秒变成 0.27 秒,在工作区任务上从 0.09 秒变成 0.15 秒。
这说明 CTR 把违规压下来的同时,条件恢复后起步慢了零点几秒。回到前面的段表,重组后的每条数据里,放入都排在抽屉打开之后,这条关系没有被打乱。配合 Deliver Water 的探针结果,可以说独立阶段对对侧的响应降了,需要协调的地方响应还在。
提升来自重排本身,还是来自合成画面和 IdleMask
CTR 同时引入了重排、主相机合成和 IdleMask 三样东西,作者分开测了后两样。
只给 L→R 加上主相机合成、完全不重排时,Sort Letters 的成功率是 90%,和不加时一样。仿真的 Scan Object 任务需要两只手共同保持扫描姿态,成功率从 68% 变成 62%。这说明合成画面本身解释不了这两个任务上的提升。
从 CTR 里只去掉 IdleMask,Sort Letters 从 94% 变成 92%,也就是 50 次试验里差一次。Scan Object 从 70% 变成 56%,差得明显。这说明屏蔽人为等待的监督也有贡献,在 Scan Object 上尤其大。
普通条件下 24 个组合里 19 个提升,Place Dual Shoes 没涨
最后一个问题是,不做任何干扰的普通执行条件下,CTR 有没有提升。作者在 8 个任务、3 类模型上和 Serial 对比,24 个任务-模型组合里有 19 个提升。这个数字要看基数:DP 和 ACT 在很多任务上本来就接近 0,比如 Organize Hardware 上 DP 从 0% 到 2%,只多了一次成功,ACT 仍是 0%。这样的提升说明不了什么。
π0.5 的提升更能说明问题:仿真 Put Object Cabinet 从 36% 到 66%,真实 Deliver Water 从 78% 到 92%。这说明在模型本身能完成任务时,换训练时间安排也能改善普通条件下的成功率。Place Dual Shoes(两只手放鞋、放置区域重叠的任务)上 CTR 没有提升。这 19 个提升是相对 Serial 的,并不是相对 Mixed 的。
回到抽屉:CTR 动的只是「左手什么时候开始抓」,「放入前抽屉要开着」这条要求一直保留。这件事的前提是有人或程序先把任务约束写对。如果你的示教也只有一种习惯性的先后顺序,标准起点的成功率看不出问题,换一个进度组合起步,或者暂停一只手量另一只慢了多少,就能很快看出策略有没有学到这条捷径。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
 Embodied · 2026-11-03Contact Imitation Interface: Transferring Dexterous Skills by Showing How Contact Unfolds用人手示范教机器人灵巧手,难点在于人手和机器手形状不同:转换时如果只追求手形相似,机器手指尖碰到物体的位置往往和人当初碰的不一样,抓取和拨动就会失败。CIMI 把接触放在第一位:示范时记录手指与物体的接触面和指尖摄像头画面,转成机器手动作时先让接触点对齐,再顾及手指姿态;学到的策略也是先预测接触面接下来怎么移动,再由控制器协调手腕和手指去对齐。在 LEAP 和 Wuji 两款机器手的六组手与任务组合上,任务完整做完的平均成功率比基线策略至少高 50 个百分点。迁移人手技能时,对齐接触比对齐手形更关键。
 Embodied · 2026-11-02UMI-Live for In-The-Wild Bimanual Robotics Data Collection主要用手持夹爪采的示范,采集地点和灯光都与测试现场不同,只混入少量真机遥操作,微调后的 π0.5 就在双臂把橘子放进碗的任务上 10 次全部成功。这些示范来自论文开源的双臂手持采数系统 UMI-Live:相机、激光雷达、计算和电池都装进夹爪,操作员按一个键就能接着录下一段,后台同时把录好的片段重建成可训练的数据。UMI-Live 的价值不在新算法,而在一套能照着复现的采数流水线,作者同时公开了约 40 小时数据。
 Embodied · 2026-10-27Coupling Execution Horizon and Sampling Depth in Flow-Matching VLA Policies这篇论文发现,基于流匹配的视觉语言动作模型里,求解动作的迭代步数和每次执行的动作步数是耦合的,最优选择还会反转。这类模型从一段随机噪声出发,用数值求解一步步把它推成一段平滑的动作。部署时通常把两者分开调:执行步数用来摊薄推理延迟,迭代步数则保持很高以求精确。频繁重新规划时,迭代步数少确实更差;一次执行很长一段动作时,迭代步数少反而更好,因为粗略求解让动作更集中在平均轨迹附近,减少了开环执行中误差的累积。每次只执行 5 步时,迭代 10 步更好。每次执行 20 步时,迭代 2 步反而更好。这个规律在多个基准和真机上都成立,不用训练就能降延迟、提成功率。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…