
做可解释推荐的人值得读,因为它说明,给每个用户挑第一条推荐理由,微调一个文本 embedding 模型比专门的协同方法更准。给用户挑推荐理由时,以往的方法常常连一个简单基线都赢不了,这个基线只看用户历史里哪些说法出现得最多。任务是从这件商品的所有评论里抽出、合并好一批简短说法,挑出最能打动这个用户的几条。LMStaR 用微调的文本 embedding 模型把它当成检索:一个编码器读入用户以前的评论和这件商品的信息,另一个编码器读入每条说法。训练时两者一起微调,让用户对这件商品真正写下的评论里的说法排到前面。在亚马逊美妆、玩具和 Yelp 上,它排第一位的理由都最准,比此前最强的方法 CLER 高 1.06 到 8.25 个点。
它到底在解决什么问题?
推荐一件商品时,系统可以顺带给几条理由,比如“适合硬科幻迷”。这类理由不是现写的,而是事先从大量评论里抽出来的简短说法,意思相同的说法合并成一条。
论文做的是商品内排序:候选理由只来自这件商品自己的评论。所以难点不在于找到和商品相关的理由,而在于从这件商品的理由里挑出和这个用户最对得上的几条。
评测时,用户后来真的给这件商品写了评论,评论里出现的说法就算答案。推荐的那一刻,模型看不到这条评论,它只看得到用户以前的评论和这件商品的信息。
这个任务里,最简单的基线 UserPop 很难打败:它只看用户以前的评论里哪些说法出现得最多。在三份数据上,基于邻居和矩阵分解的方法,包括加了语义信息的版本,排第一位的准确度和前 5 名的排序质量都没超过它。此前最强的是 CLER,它用对比学习训练用户、商品和说法的编号向量,但不直接对文字建模。
数据按每个用户的时间切开:最近一次互动做测试,倒数第二次做验证,更早的都用来训练。测试商品都在训练里出现过,所以这里不考新商品。
LMStaR 怎么挑理由
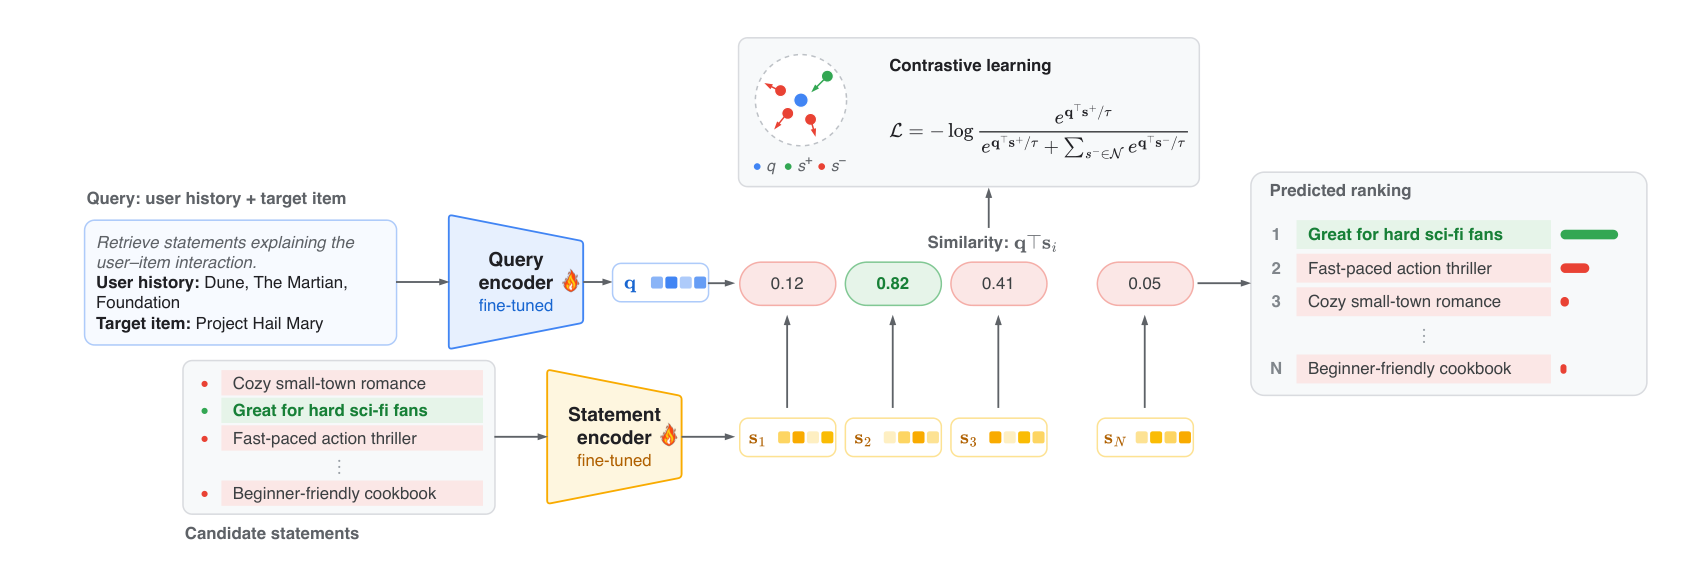
LMStaR 不给用户和商品分配编号向量,全部用文字表示。它有两个编码器。
第一个编码器读一段拼好的文字:一句任务说明,用户以前的互动,再加上这件商品的信息。每条以前的互动包括当时那件商品的信息和用户评论里抽出的说法。编码器把这段文字压成一个向量,代表“这个用户看这件商品”。
第二个编码器把每条候选理由各自压成一个向量。两个向量的余弦相似度就是这条理由的分数,按分数从高到低排。
论文图 1 的示意例子可以这样读。用户历史里都是科幻小说,目标商品也是一本科幻小说。四条候选里,“适合硬科幻迷”得 0.82,“节奏快的动作惊悚”得 0.41,“温馨小镇爱情”得 0.12,“新手菜谱”只有 0.05。所以排第一的就是“适合硬科幻迷”。这些分数只用到用户以前的评论和商品信息,用户对这本书的新评论此时还不存在。
怎么训练
训练数据按时间顺序构造。对用户的第 t 次互动,查询里只放这之前的互动,所以每个用户的第一次互动只当历史,不当训练目标。
正样本是这次评论里真写到的说法,负样本是这件商品的其他说法,训练时从中抽一部分。
一次互动常有好几个正样本。论文让每个正样本各自和负样本比一次,再把这几次的损失平均。这样,一个排得好的正样本不能替另一个排得差的正样本“兜底”,每个都得排到负样本前面。 Hoot 说

示意例子。两条正确理由分开算损失。排得好的那条损失很小,帮不了排得差的那条。平均之后,训练主要去推排得差的那条。 出处: 论文 §3.3.2 多正样本对比损失;分数和温度为示意
两个编码器都从 Qwen3-Embedding-8B 初始化,用 LoRA 微调,两边各有一套参数,一起训练。
结果:第一条理由最准
| NDCG@1(%) | 美妆 | 玩具 | Yelp |
|---|---|---|---|
| UserPop | 10.18 | 12.54 | 5.41 |
| CLER | 11.22 | 12.52 | 8.97 |
| Qwen3-Embedding-8B(不微调) | 10.11 | 10.67 | 5.78 |
| LMStaR | 14.72 | 20.77 | 10.02 |
(数字来自论文表 1)
LMStaR 在三份数据上的 NDCG@1 都最高,比 CLER 高 3.50、8.25 和 1.06 个点。这说明它排第一的理由选得最准。
前 5 名的排序质量 NDCG@5 在美妆和玩具上也最好。Yelp 是例外:前 5 名上它比 CLER 低 1.10 个点。
不微调的 Qwen3-Embedding-8B 已经超过所有基于邻居和矩阵分解的方法。微调之后,NDCG@1 再涨 4.62、10.10 和 4.24 个点。
换别的底座也成立。五个底座从 3 亿参数的 EmbeddingGemma 到 80 亿参数的 Qwen3-Embedding,微调后在美妆和玩具上都超过 CLER。任何一个微调过的底座,都比任何一个没微调的底座好。在比较过的两个底座上,LoRA 微调的 NDCG@5 比全部参数一起微调高 0.84 到 2.66 个点。
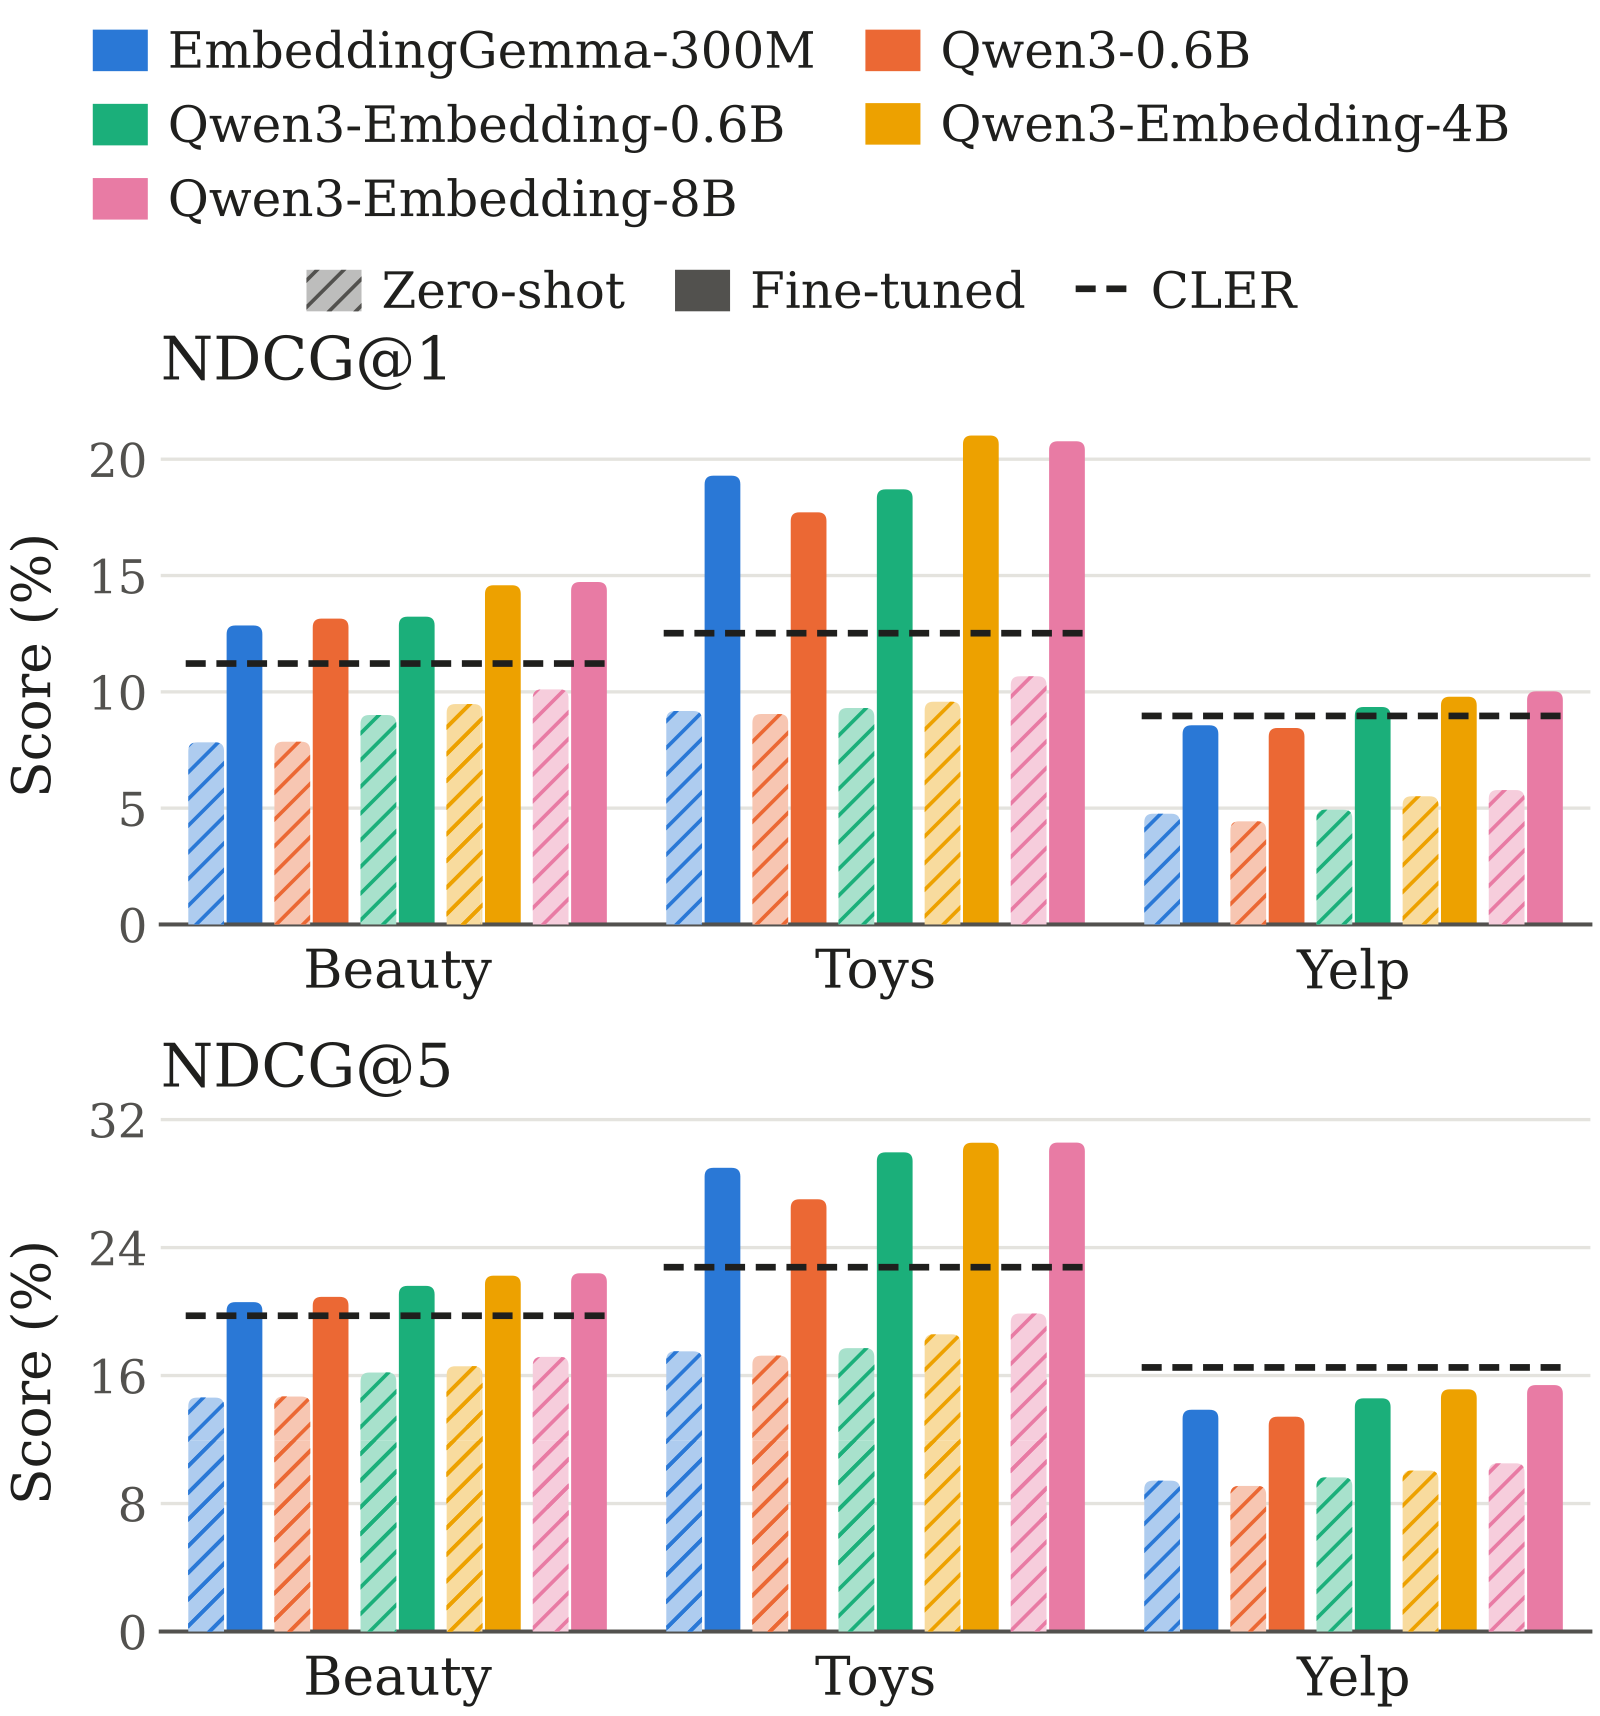
微调学到的东西还能跨领域用。在美妆上训练、直接拿到玩具上用,NDCG@1 仍比在玩具上训练的 CLER 高 6.01 个点。不过跨过去的效果都比不上在本领域训练。
模型到底靠什么挑理由?
作者在测试时改动查询,看分数掉多少。候选理由和答案都不变。
| 改动查询(NDCG@5 下降,点) | 美妆 | 玩具 | Yelp |
|---|---|---|---|
| 换成另一个用户的历史 | 6.73 | 13.20 | 5.65 |
| 目标商品换成随机商品 | 0.97 | 0.41 | 0.36 |
(数字来自论文表 4)
换掉用户历史,分数掉得最多。换成别人的历史后,它在三份数据上都低于 UserPop。换掉商品信息几乎没影响。作者提醒,这部分是因为候选理由本来就只来自这件商品,商品信息能补充的东西不多。
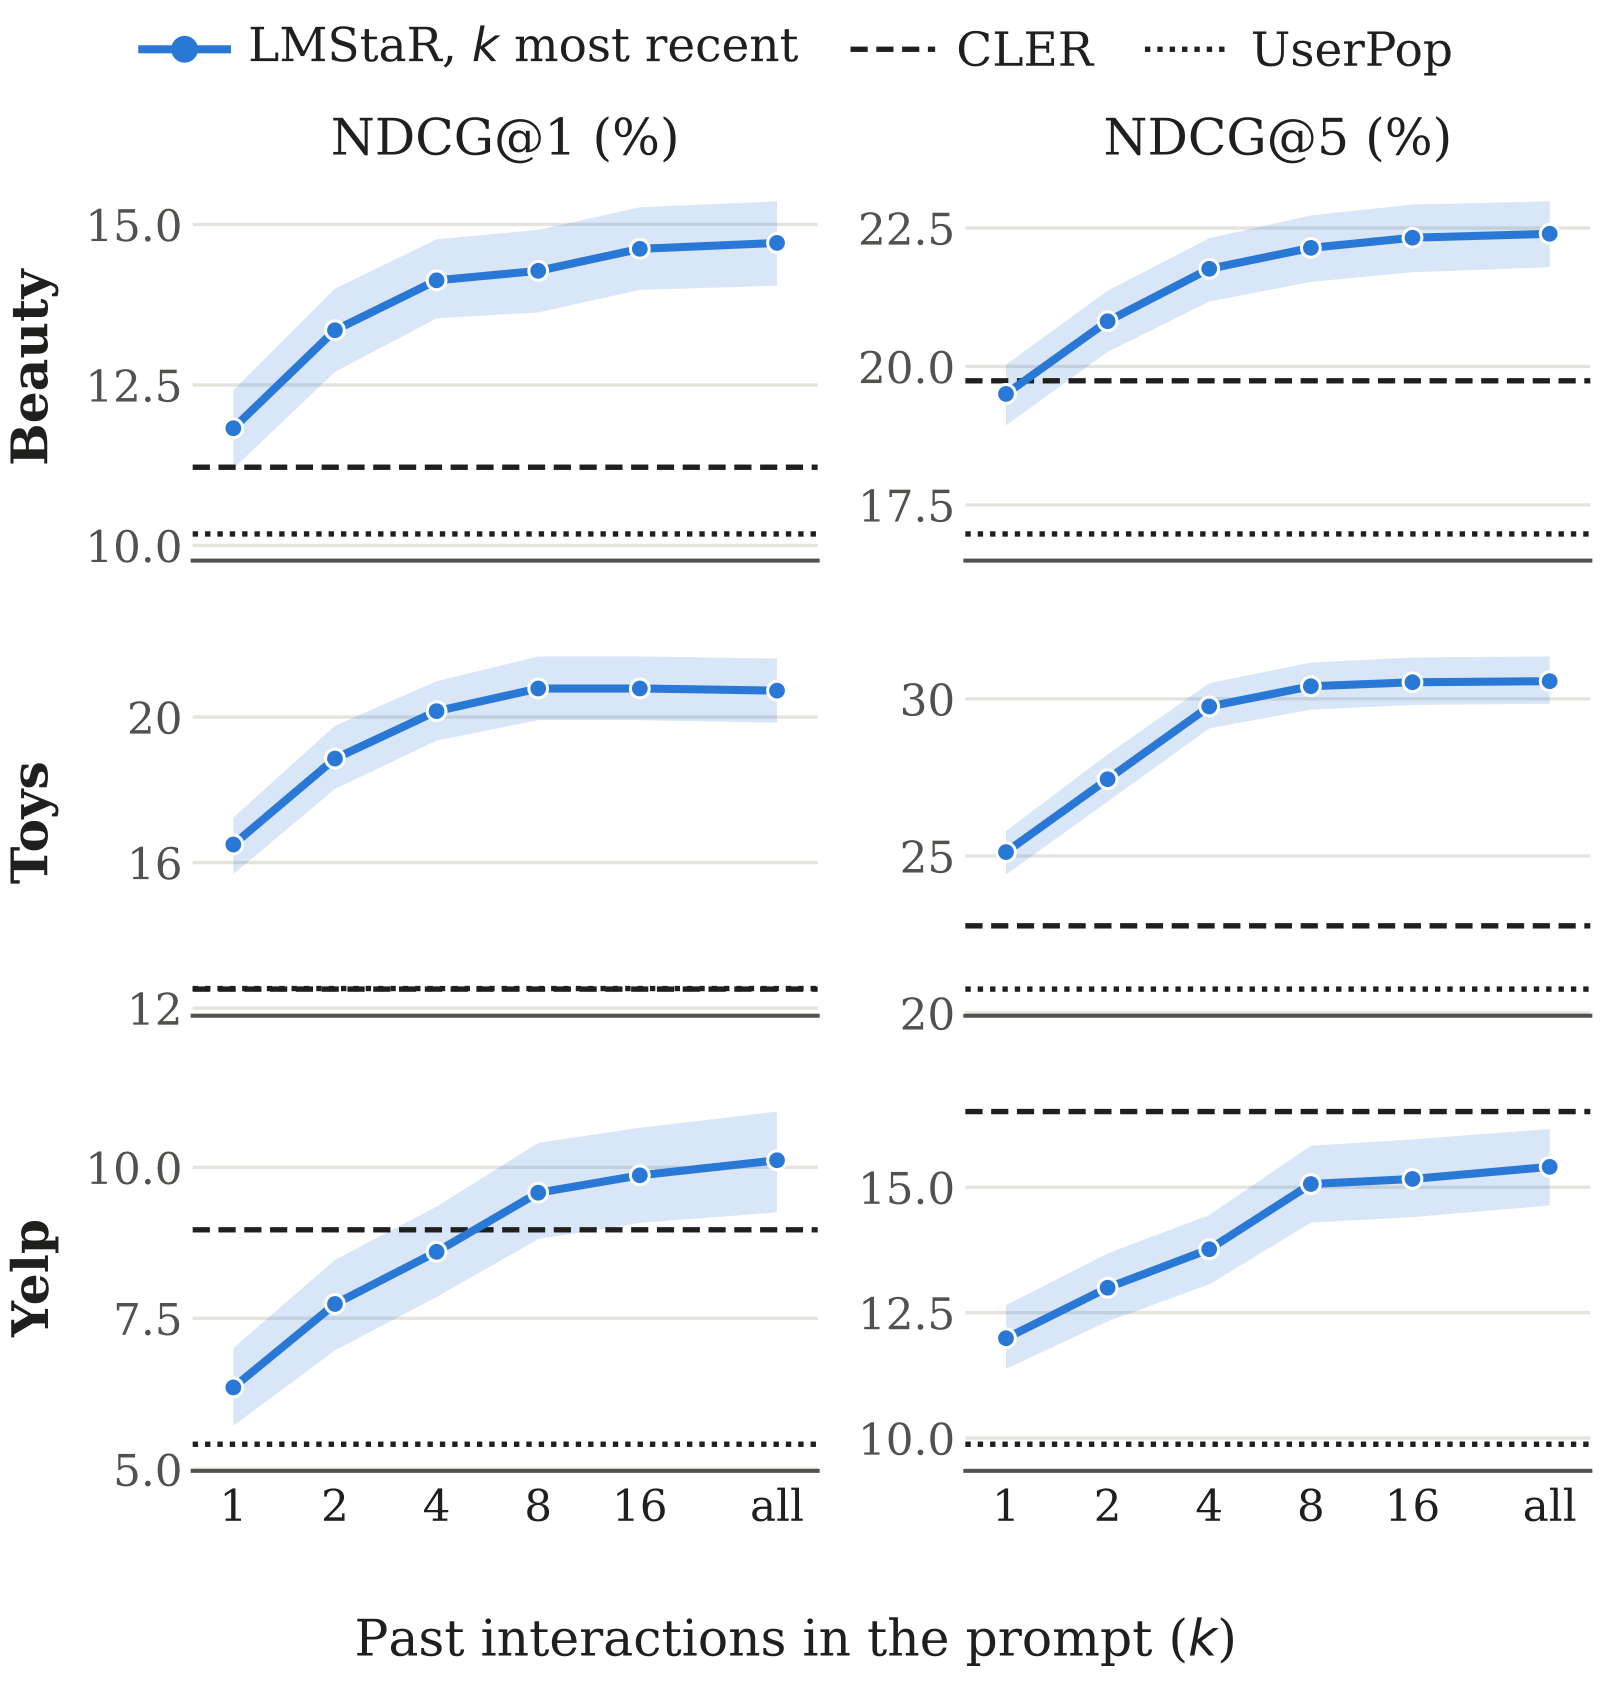
历史的收益主要来自最近几次互动。只放最近 1 次互动,三份数据上就都超过 UserPop。
从 1 次加到放满,NDCG@5 在美妆上从 19.5 升到 22.4,在玩具上从 25.1 升到 30.6。曲线在前几次涨得最快,说明最近几次互动已经带了大部分有用的信息。
挑哪几次历史也试过。除了按时间挑最近的,作者还试了按和目标商品的相似度挑。结果没有一种稳定好过按时间挑。只挑 1 次时,按语义相似度挑在美妆上让 NDCG@1 高约 1.4 个点,挑得多了差别就很小。所以按时间挑最近几次是个够用的默认做法。
Yelp 前 5 名为什么输,也能看出一点线索。按历史长短把测试用户分组后,CLER 的优势主要在历史只有 4 到 7 次的用户上,这组占 Yelp 测试用户的 49.2%。历史更长的组里,差距变小或者反过来。作者提醒,这只是分组观察,各组用户在别的方面也不同。
我认为它的局限
第一,答案是自动抽取、自动合并出来的。用户没写到的说法,未必就不合适。排序指标高,也不等于用户觉得这条理由有用、真实。
第二,候选池里可能有测试期评论抽出的说法,推荐当时其实还不存在。测试商品也都在训练集里出现过,冷启动的新商品没有测。
第三,Yelp 前 5 名为什么输给 CLER,还没有定论。作者提了两种猜测,都没有验证:一个查询向量可能装不下好几种理由,或者 CLER 的协同信号补上了文字里没有的信息。
一个推荐团队可以怎么用
- 如果已经从评论里抽好了理由库,可以先用现成的文本 embedding 模型不微调试一下,它已经比很多协同方法强。
- 查询里一定要放用户自己的历史评论,最近几次就够起步。
- 想要前几条都准,不只是第一条,最好和 CLER 这类协同信号一起用,至少在 Yelp 这类数据上先对比。
结论
这篇论文的价值在于把推荐理由排序改成纯文字检索,并说明微调后的 embedding 模型主要靠用户自己的历史评论挑理由。第一条理由在三份数据上都最准,前 5 名在 Yelp 上还不如 CLER。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中。可解释推荐是常见需求,但离线指标和用户感受之间还有距离 |
| 方法创新性 | 中。双编码器加对比学习是检索里的成熟做法,新意在用到理由排序上 |
| 实验证据 | 中高。三份数据、五个底座、跨领域和改查询实验都有,但答案是自动构造的 |
| 工程成本 | 中。8B 底座加 LoRA,需要 GPU 训练 |
| 是否值得尝试 | 值得。已有评论理由库的团队可以直接替换现有的排序模块做对比 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…