
推理写对了「喜欢迪士尼动画」,目标却还排不进前十:用预测增益训练生成式推荐的推理
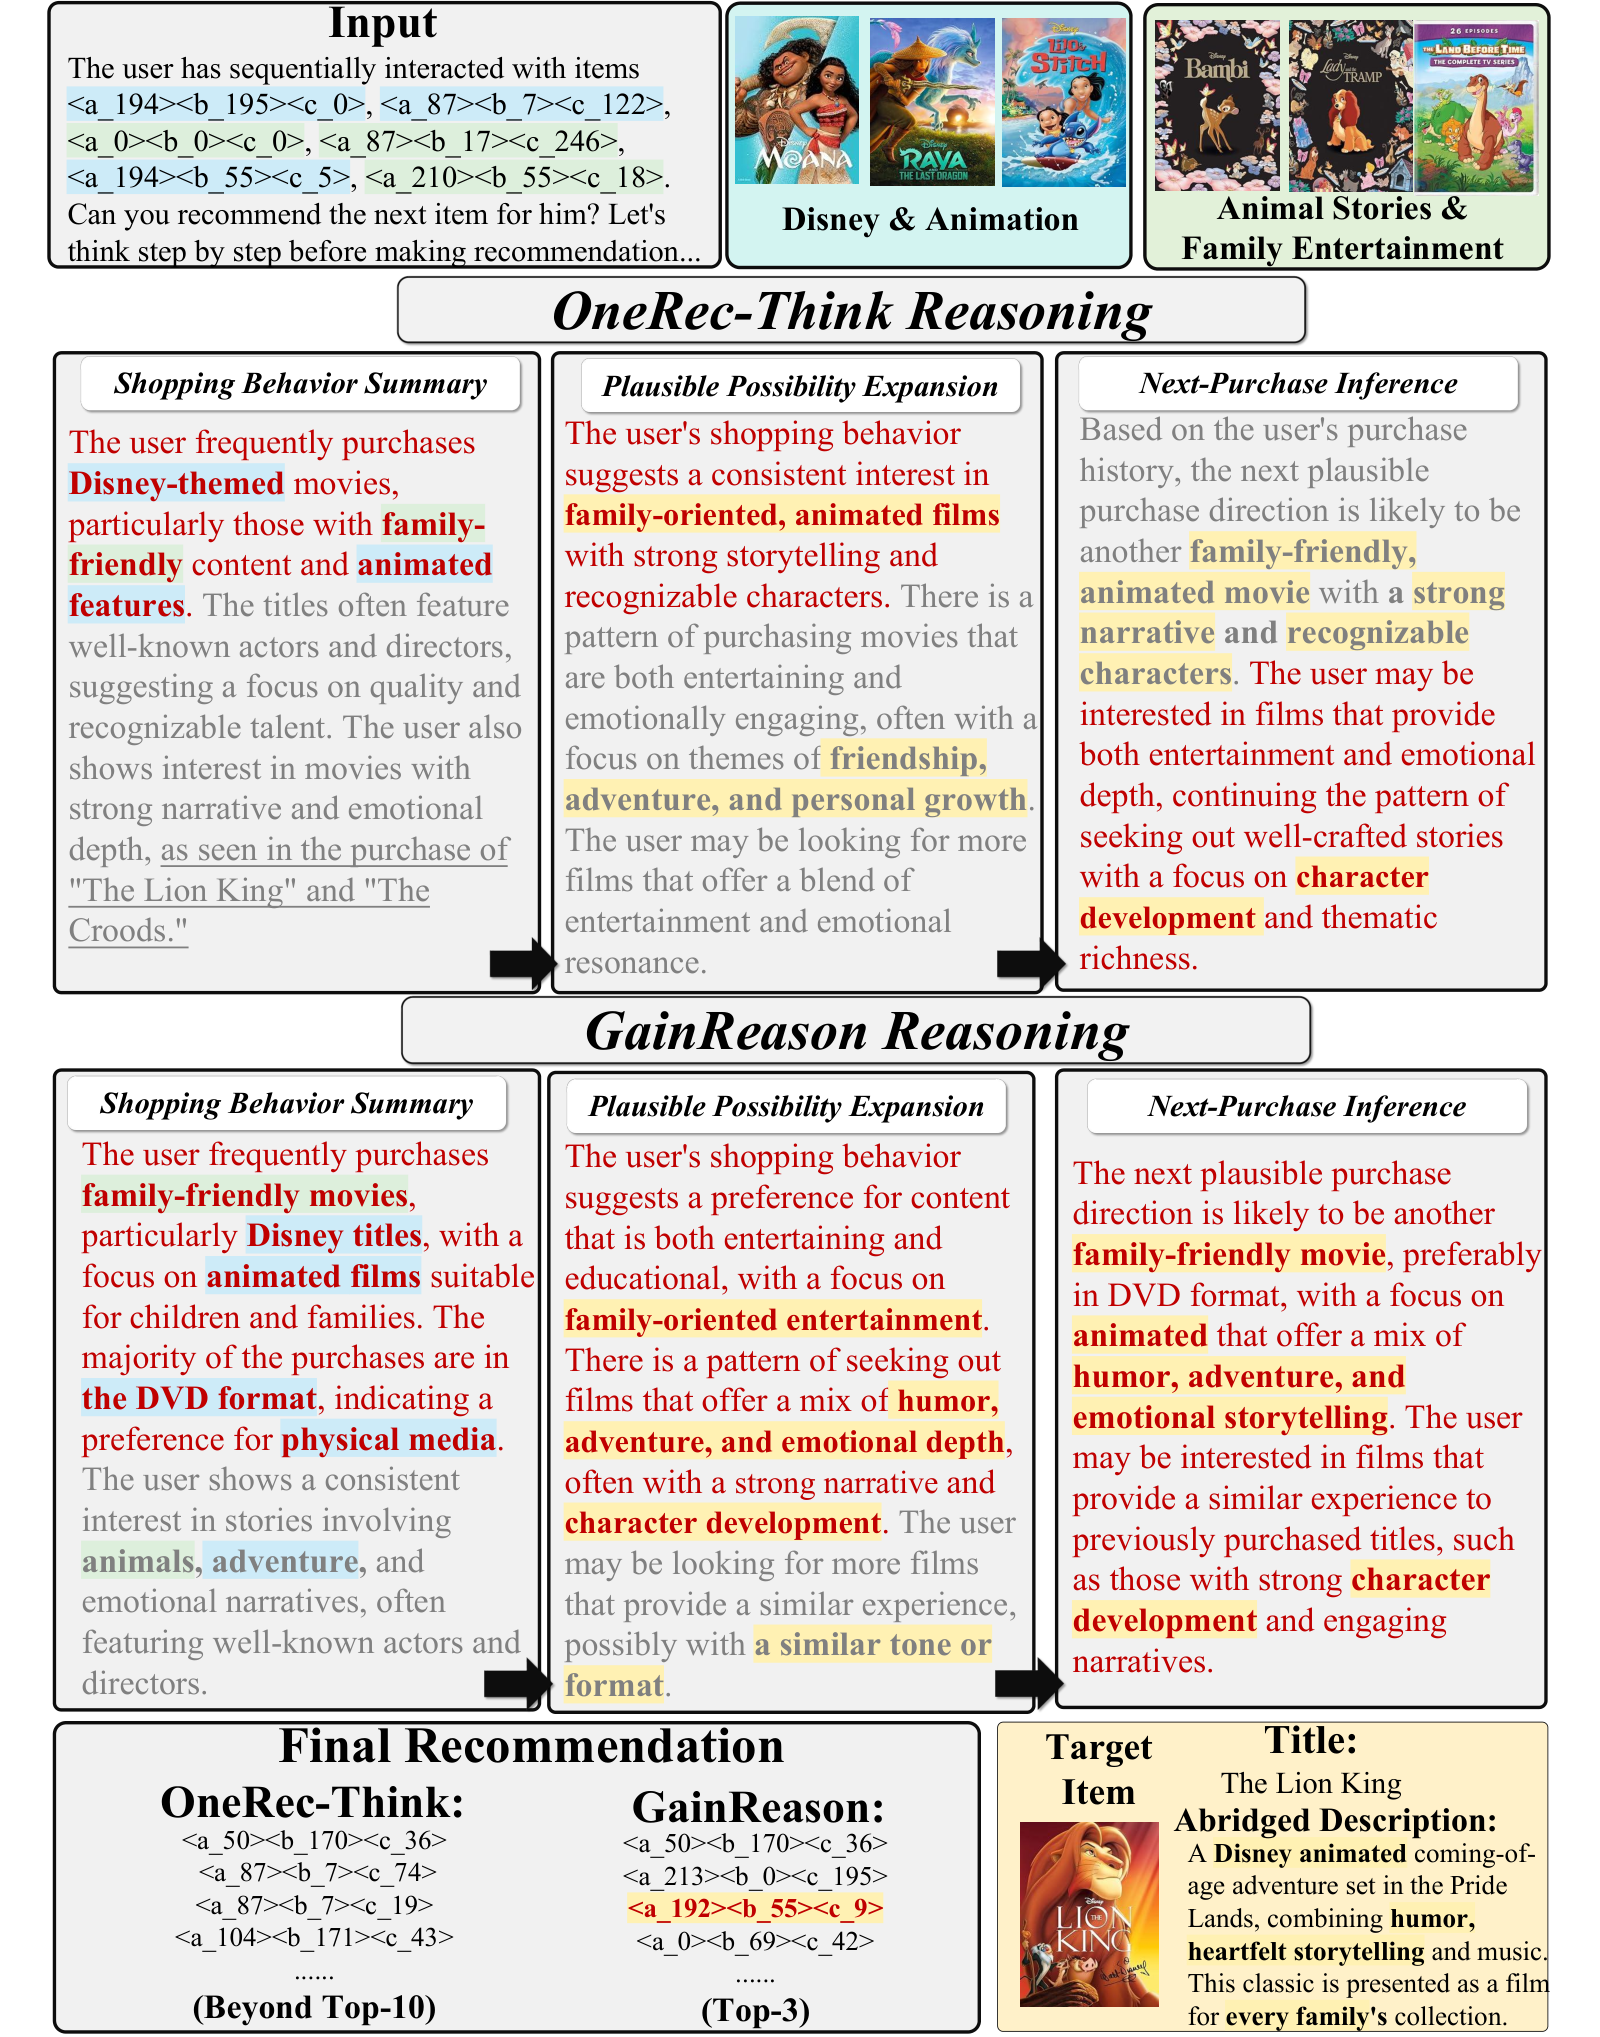
用户最近看过迪士尼、家庭向的动画,下一件其实和「冒险」有关。一个会先写推理再生成商品 SID 的推荐模型,把「迪士尼相关」「家庭友好的动画」都写进了推理,却把历史里的片子认错,甚至把要预测的目标当成已经看过的。这套推理里,只有 3 句真正提高了目标 SID 的似然,最后目标排不进前 10。
另一套同样从用户历史写起的推理,正增益句子有 6 句,写得更贴历史,目标进了前 3。这是论文图 8 里 OneRec-Think 和 GainReason 的对照。看起来都会「推理」,但每句话对预测下一件到底是加分还是减分,差得很远。
这篇论文来自中国人民大学高瓴人工智能学院、对外经济贸易大学和阿里国际数字商业集团。现有做法里,TIGER 这类生成式推荐直接生成下一件的 SID。OneRec-Think、SIDReasoner、Evo-Rec 等再给模型加上显式推理,并用组内相对策略优化(GRPO)来训练:奖励通常由最终推荐表现决定,比如 SID 是否命中,再打给整条推理轨迹。方法 SAPO 把这类匹配奖励分到推理块,仍然不是在测量每句话对预测的贡献。这篇提出方法 GainReason:看每多写一句推理,目标 SID 的对数似然变了多少,把这个差值叫做预测增益(PG),用它来优化推理。三个公开数据集上,相对最强基线的平均提升是 6.2%、2.7% 和 6.1%。
用每句推理给目标 SID 似然带来的变化来打分,比只看最终推得对不对更有区分度;数字来自三个公开数据集上的离线全量评估。
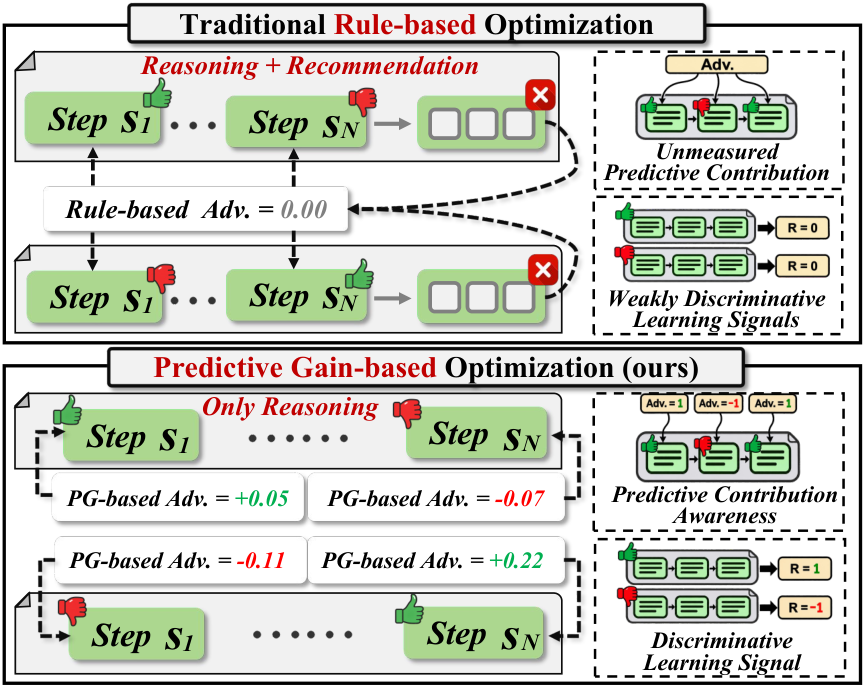
只看最后推得对不对,中间那些句子就没被量到
生成式推荐把下一件商品写成一串 SID。这篇用 Sentence-T5 把标题、品牌、类目等元数据编成向量,再用 RQ-KMeans 量化成 3 个离散记号。显式推理是在生成 SID 之前,先用自然语言写出对用户兴趣的判断,希望把大模型里的世界知识用起来。
问题是,模型往往已经在推荐数据上训练过,最后推得准,并不等于这些推理句子帮了忙。规则奖励看的是推理结束之后的推荐结果,中间哪一句提高了目标 SID 的概率、哪一句把它拉低,并不会直接出现在训练信号里。作者在训练过程中看到,正增益和负增益的句子数量接近一半对一半,规则方法却反映不出这个差别。
另一个问题出在一组 rollout 内部。从海量商品里正好生成目标 SID 本来就难,不同推理轨迹的预测贡献不一样,按命中规则却常拿到同一个奖励。于是组内相对优势变成 0,策略更新推不动。作者还观察到,相当比例的组里所有奖励完全相同。
换个更简单的做法,是请另一个模型给中间步骤打分,但评估「这句推理对推荐有没有用」既贵也容易偏。GainReason 选择直接看目标 SID 的似然变化。
走一遍:一句话的预测增益怎么算,案例里又差在哪
预测增益的定义来自论文公式 7 和 8。目标 SID 有 3 个记号。给定用户历史,以及已经写出的前几句推理,模型会对这三个记号给出一个平均对数似然。第 j 句的预测增益,就是加上这句之后的似然,减去加上这句之前的似然。第 0 步只用历史、还没有推理。下面先用一组示意数字把账算清,再回到图 8 的真实对照。
第一步,只看历史。示意里,目标 SID 的平均对数似然是 -2.00。
第二步,模型写下一句「用户喜欢迪士尼和家庭动画」。似然变成 -1.70,这一句的预测增益是 -1.70 减 -2.00,等于 +0.30,是加分句。
第三步,若下一句误把目标当成已经看过,似然掉到 -1.85,增益是 -1.85 减 -1.70,等于 -0.15,是减分句。整条轨迹的净增益是各句相加,这里是 +0.15。
规则奖励如果只看最终有没有命中,整条轨迹只会拿到一个分。句级预测增益仍能在同一条轨迹里分出 +0.30 和 -0.15,说明加分句和减分句可以被分别量到。
第四步,训练时,GainReason 对一组 rollout 里所有句子的预测增益做标准化,再按 GRPO 的方式更新写推理的策略,这一部分称为 PGRO。预测增益在更新时不再反传。作者还用定制的因果注意力,一次算清各个推理前缀下的似然,不必为了给奖励再把推荐结果解码出来。
第五步,净增益接近零,有两种情况:推理本身没提供新信息,或者信息写出来了,预测时没用上。PGRU(推理利用任务)专门在净增益接近零的轨迹上,加强「带着这些推理去预测目标 SID」。净增益很大的正值说明推理已经帮上忙;很大的负值会被看成误导性推理,再加强监督会把错误写得更牢,所以不优先拿来做这个辅助任务。
论文图 8 是一条真实用户记录上的对照,不再用上面的示意数字。OneRec-Think 和 GainReason 都写出了「迪士尼相关」「家庭友好的动画」,并推断出和目标有关的「冒险」。但 OneRec-Think 还误认了历史中的物品,并把目标写进已经看过的列表,泛泛而不落地的句子也更多。结果是正增益句子 3 句对 6 句;GainReason 把目标排进前 3,OneRec-Think 没有排进前 10。作者也写到:推理写对了,也不总是带来正增益,尤其在 OneRec-Think 上。若信息已经写出来、预测却没用上,这正是 PGRU 要补的那一层。
三个数据集上,相对最强基线高多少
数据是 Amazon 的 Industrial & Scientific、Movies & TV,以及 Yelp 商户评论。预处理为 5-core 过滤,按全部交互的绝对时间排序后 8:1:1 划分,避免时间泄漏。用户历史用滑动窗口,最长 10 条。评估在全部商品上进行,不抽样候选。为了公平比较强化学习阶段,所有显式推理方法都从同一个准备后的检查点出发。
| 方法 | Industrial NDCG@5 | Movies NDCG@5 | Yelp NDCG@5 |
|---|---|---|---|
| SASRec | 0.0727 | 0.0118 | 0.0157 |
| OneRec-Think | 0.0915 | 0.0415 | 0.0191 |
| Evo-Rec | 0.0902 | 0.0422 | 0.0188 |
| GainReason | 0.0985 | 0.0435 | 0.0204 |
(数字来自论文表 2)
相对各数据集上最强的基线,四个指标的平均相对提升分别是 6.2%、2.7% 和 6.1%。Industrial 上,NDCG@5 相对 OneRec-Think 提高 7.7%,HR@5 相对 SIDReasoner 提高 6.8%,HR@10 提高 4.2%。Movies 上四个指标的提升在 2.1% 到 3.1% 之间。Yelp 上 NDCG@5 提高 6.8%。OneRec-Think、SIDReasoner 和 Evo-Rec 彼此接近,说明只改最终奖励的设计,差别并不大。
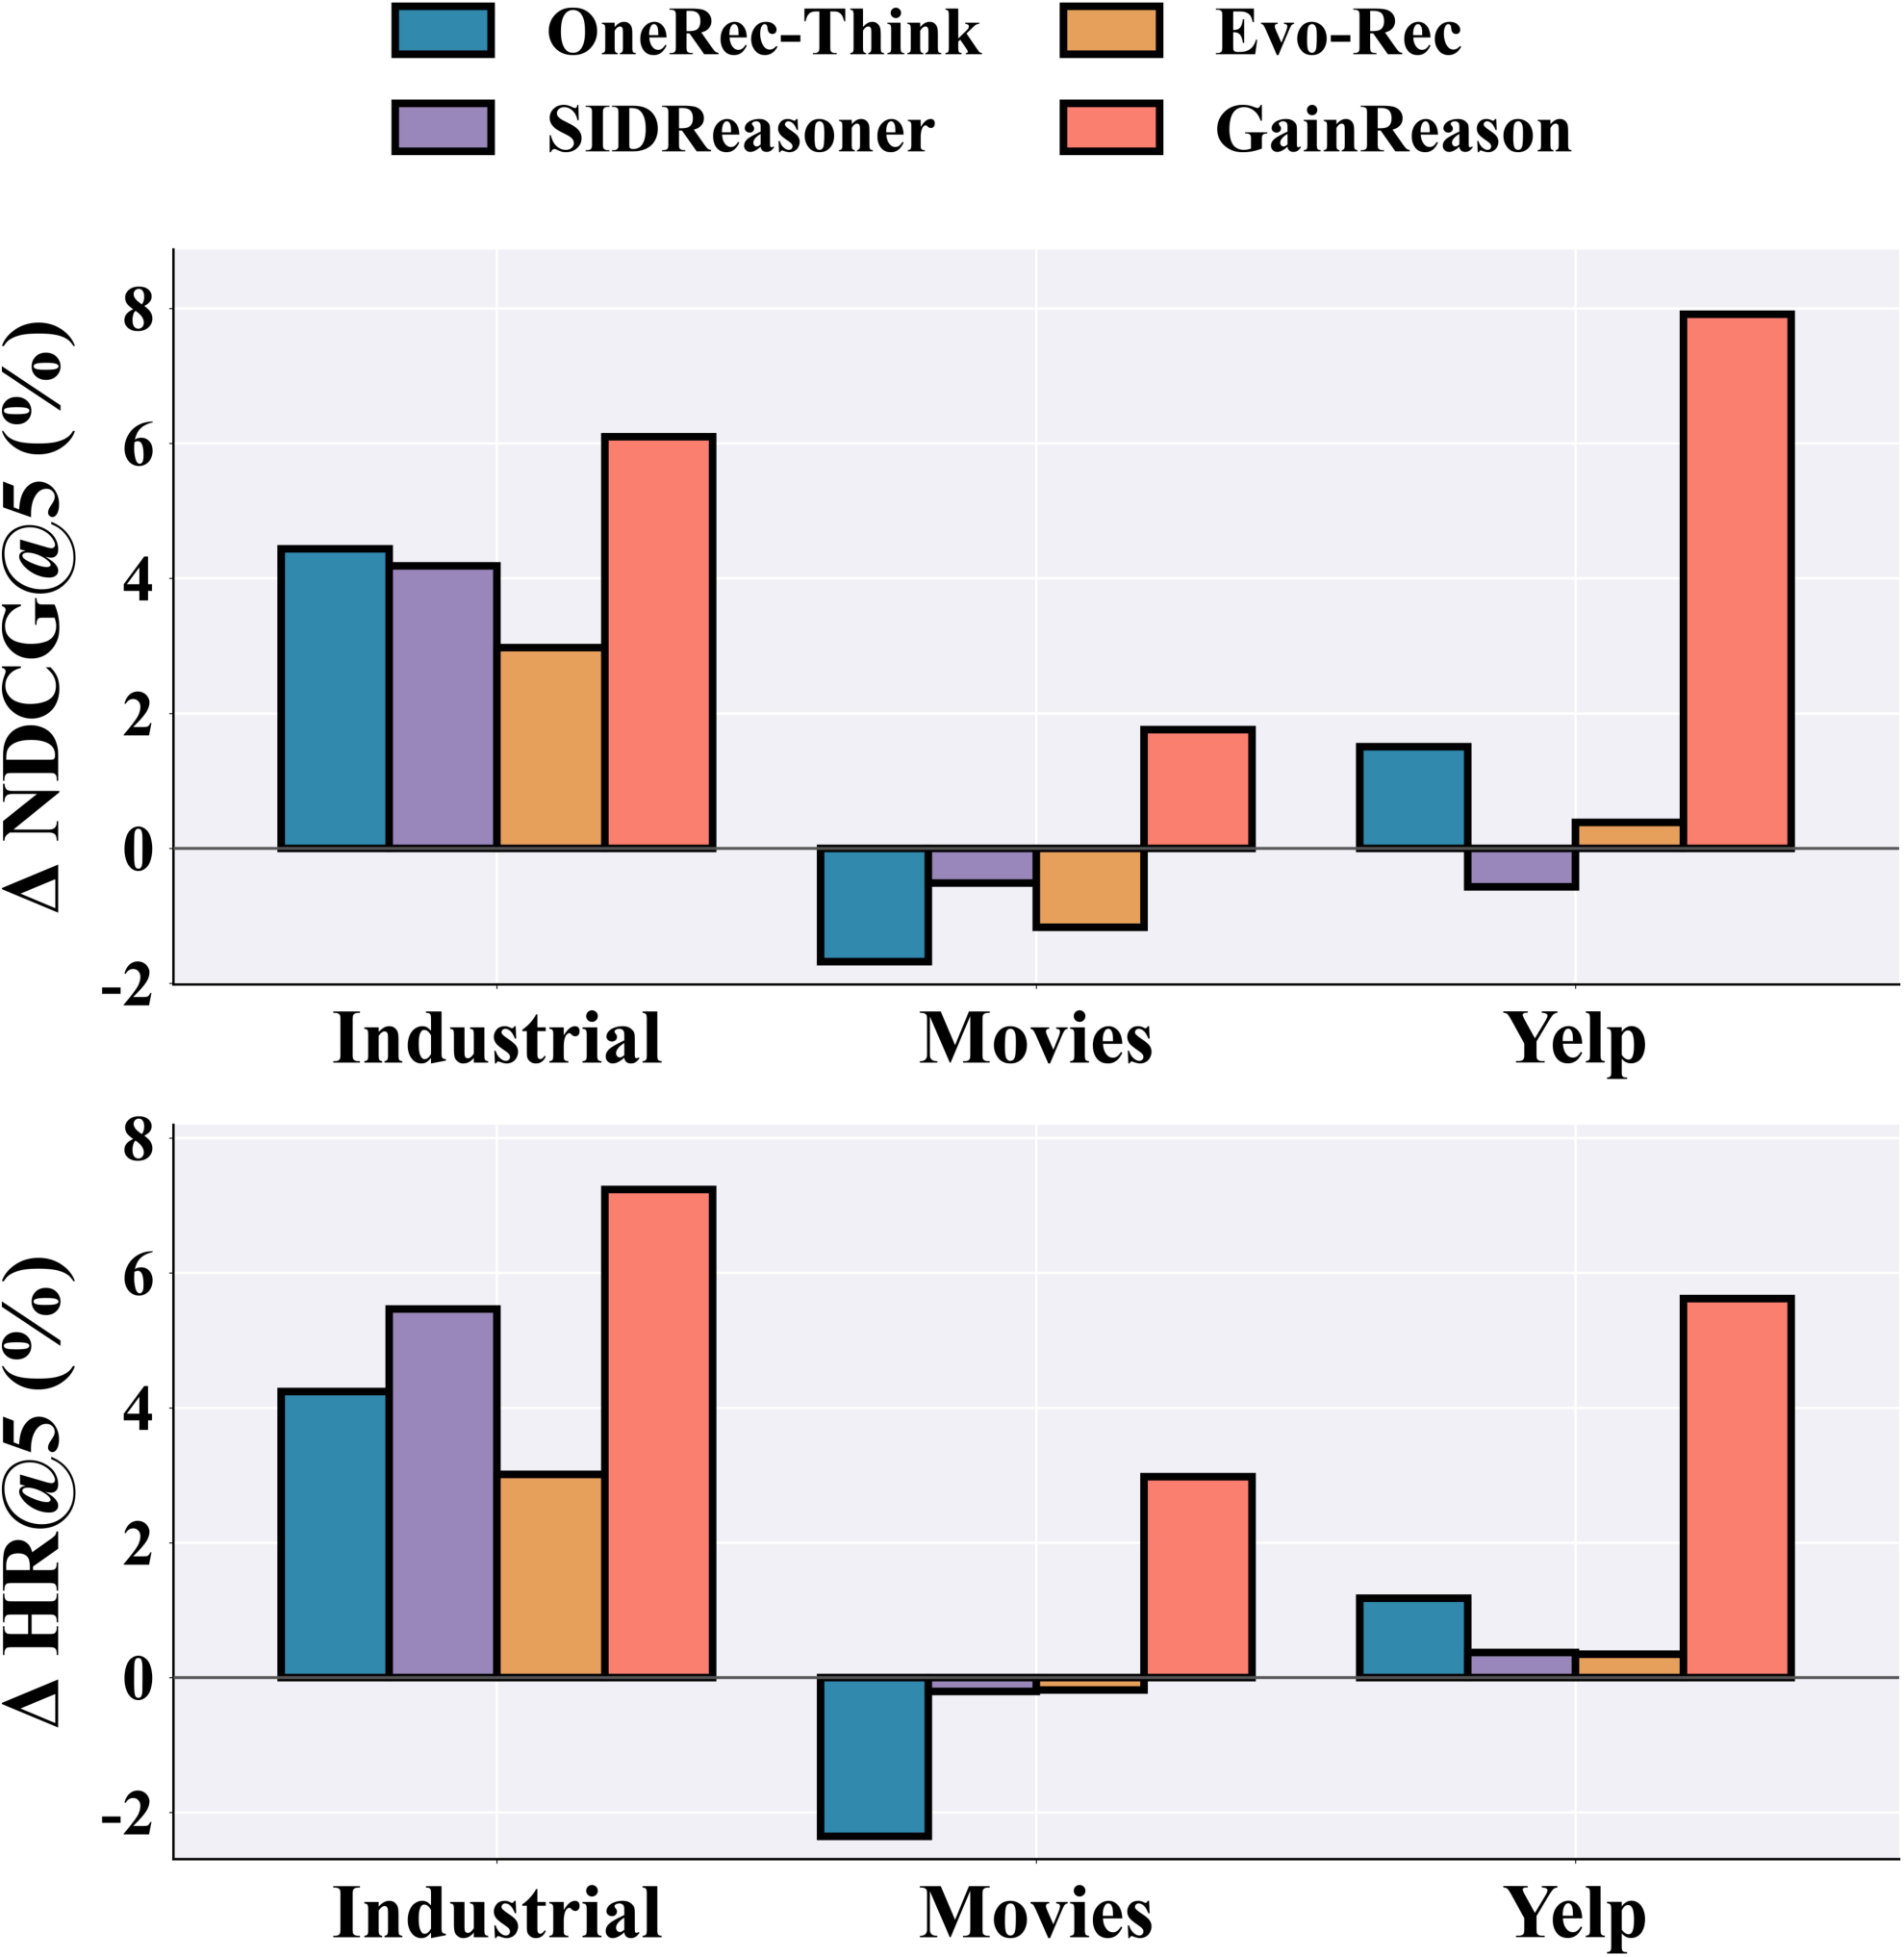
更关键的是推理本身有没有帮上忙。打开推理后,规则方法在 Industrial 上通常变好,在 Movies 上却常变差,在 Yelp 上提升也有限。GainReason 打开推理后,三个数据集上的平均相对提升是 5.8%、2.3% 和 7.4%,而且在 Movies 上仍然为正。Movies 上,不开推理时 GainReason 的 HR@5 是 0.0525,略低于 Evo-Rec 的 0.0528;打开推理后变成 0.0541,超过了 Evo-Rec 的 0.0526。Yelp 上也是推理把领先幅度拉开的。说明它的优势,很大一块来自「推理真正提高了推荐」,而不是准备阶段的直接生成就更强。
去掉 PGRO 之后,Industrial 的 NDCG@5 从 0.0985 降到 0.0892,接近只完成准备阶段的 0.0881。只留下 PGRO、去掉 PGRU,是 0.0954;把 PGRU 的自适应加权改成对所有轨迹均匀监督,是 0.0963。去掉 PGRO 时下降更大,PGRU 还有额外贡献。
这对做生成式推荐的人意味着什么
如果你已经在用 GRPO 训练带推理的生成式推荐,先检查奖励是不是只看最终 SID 是否命中,以及一组 rollout 里是不是经常出现完全相同的分。
一个可做的对照,是在训练日志里算一算:每句推理之后,目标 SID 的对数似然到底升了还是降了。如果正、负增益句子各占一半,而组内优势又经常是 0,句级预测增益会直接打在那些该加分和该减分的句子上。也要看推理写对了之后,似然有没有真的上去;如果常常写对却不加分,可能是推理没有提供新信息,也可能是预测头还没有把推理用起来。后一种正是 PGRU 要补的位置。
局限
实验是三个公开数据集上的离线评估,历史最长 10 条,SID 为 3 个记号,没有线上对比。Movies 上相对最强基线的平均提升只有 2.7%,打开推理后的平均提升是 2.3%,明显小于另外两个数据集。
预测增益在训练时要用到目标 SID 的似然,依赖这条监督信号。图 8 是定性案例。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…