
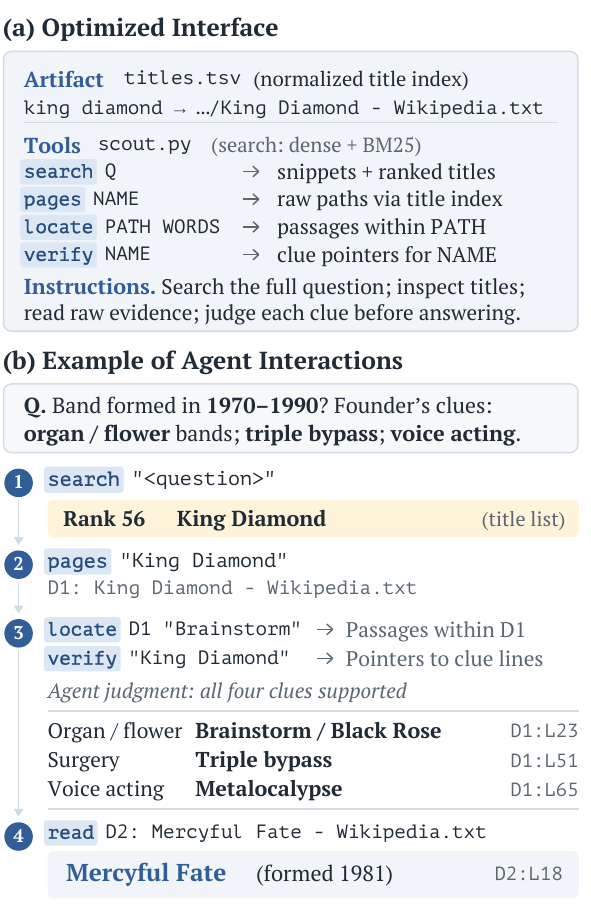
让大模型智能体在一个文档库里查资料时,它能用哪些工具、文档库预先整理成什么样、提示词里怎么教它用这些工具,三者合起来叫"搜索接口"。现在的接口都是人手工设计、对所有文档库通用的,比如 DCI(直接语料交互)直接给智能体一个终端,让它用 grep、cat 之类的命令翻原始文档。韩国大学和韩国科学技术院的 SearchWeaver 改让另一个编码智能体(Claude Code,背后是 Claude Opus 5.5)来设计接口:它读搜索智能体的完整执行记录和每题得分,找出失败原因,然后同时改三样东西,即预先生成的索引文件、可执行的搜索脚本和给搜索智能体的使用说明;改完再跑一遍、看分数,如此循环 10 轮。搜索智能体用 GPT-5.4-nano,在 BrowseComp-Plus 上的答对率从 DCI 的 71.6% 升到 78.4%,BRIGHT 四个子集的平均 nDCG@10 从 45.7 升到 55.0;把优化好的接口直接交给 Gemini 3.5 Flash-Lite 用,也比 DCI 好。论文的结论大体站得住,但 BRIGHT 上的提升有一部分来自一个基线拿不到的强检索排序,这一点在正文里不太显眼,下文会单独说明。
1. 问题:同一套接口不适合所有文档库
近期的智能体检索方法都在固定接口上做文章。RAG 只把检索器返回的段落交给模型;DCI 让智能体用终端命令直接翻原始文档;DR-DCI 先用向量检索把文档拉进一个工作区再翻;RISE(受限交互空间检索)圈定一个受限工作区,并给文档补上模型生成的目录和章节锚点。这些方法谁好谁坏会随文档库变化:DR-DCI 在 BrowseComp-Plus 上比 DCI 好(73.1% 对 71.6%),在 BRIGHT 上却更差(42.1 对 45.7);RISE 在 BrowseComp-Plus 上还有 65.0%,到 BRIGHT 上只剩 25.9。作者据此认为,接口应该针对具体的文档库、具体的模型来设计,而这种设计工作可以交给编码智能体。
这个想法和此前的 DSPy 等提示词优化、Meta-Harness 等"改运行框架代码"的工作一脉相承。区别在于优化对象:提示词优化只改文字,Meta-Harness 改模型外围的调度代码,SearchWeaver 改的是智能体面对的文档库本身的组织方式和能调用的操作。
2. 方法:让编码智能体反复改接口
2.1 接口由哪几部分组成
一个候选接口包括三部分。第一部分是预先生成的文件:在任何问题到来之前,对整个文档库处理一次,比如生成"标题到文件路径"的索引表,供所有问题复用。第二部分是可执行工具,即 Python 脚本,可以调用提供的 BM25 和向量检索,可以把检索范围限制在某个子目录,也可以把智能体对文档的判断和检索排名合并。第三部分是使用说明,告诉搜索智能体什么时候用哪个工具、怎么核对线索。三者必须一起设计:一个"把智能体的判断并入排序"的工具,需要配套说明告诉智能体何时去读文档、怎样把判断传给工具。
候选接口还可以替换搜索智能体的基础系统提示词和上下文管理策略(决定早先的工具输出何时截断或清除)。搜索智能体本身的模型参数始终不动。
2.2 优化循环
设计者每一轮查看文档库和之前所有候选接口,写出一个新接口;新接口在优化用的题目上跑一遍,返回每题得分和完整执行记录,包括敲了哪些命令、工具返回了什么、最终答案是什么。优化题的标准答案文档 ID 也会提供给设计者,帮助它区分"没找到"和"找到了却没认出来"。每个候选的结果不管好坏都保留下来作为后续参考。跑满 10 轮后,挑优化集平均分最高的接口,在测试题上评估。
防泄漏的措施写在附录里:候选接口的文件中如果出现优化题原文、题目编号或标准答案,会在评估前直接被拒;测试题和标签文件在优化期间设为不可读。搜索智能体每题最多 300 轮交互、30 分钟。
3. 实验结果
BrowseComp-Plus 要求在固定网页库上回答多线索问题,下文简称 BCP(多线索问答基准),由 GPT-4.1 判对错,30 题用于优化、800 题用于测试。BRIGHT 是需要推理的文档检索,选了生物、地球科学、经济、机器人四个子集,共 213 题优化、210 题测试,看 nDCG@10。每个文档库单独优化一个接口。
3.1 主结果
| 方法 | BCP 答对率 | 生物 | 地球 | 经济 | 机器人 | BRIGHT 平均 |
|---|---|---|---|---|---|---|
| DCI | 71.6 | 61.6 | 51.5 | 31.3 | 38.2 | 45.7 |
| 智能体检索(向量) | 62.6 | 58.2 | 51.4 | 34.6 | 35.7 | 45.0 |
| 智能体检索(BM25) | 47.5 | 48.8 | 41.6 | 30.2 | 35.4 | 39.0 |
| RISE | 65.0 | 34.9 | 29.4 | 17.7 | 21.7 | 25.9 |
| DR-DCI | 73.1 | 54.4 | 43.4 | 31.7 | 39.0 | 42.1 |
| SearchWeaver | 78.4 | 74.6 | 64.6 | 38.3 | 42.4 | 55.0 |
SearchWeaver 在两个基准、四个子集上全部领先。BCP 上 800 道测试题,6.8 个百分点大约是 54 道题,这个差距是可靠的。BRIGHT 每个子集只有 50 道左右的测试题,单个子集上几分的差距要谨慎看待,但生物和地球科学上 13 分左右的提升已经远超这个噪声。
3.2 各文档库学到了什么
附录把 BRIGHT 四个子集的最终接口都画了出来。四个接口的骨架相同:智能体仍然用终端搜索、阅读原始文件,最后由一个工具把智能体的判断和现成的向量排序合并成提交的文档列表。区别在于检索从哪一步介入,以及智能体的判断占多大分量。生物子集把搜索限定在题目所属的主题目录里,智能体把读过的文档标成百科、论文或网页三类,最后由合并工具从三路候选里排出提交的 20 篇:标为百科的文档、目录内的向量排序、和第一篇百科文档相似的文件。附录只交代了这三路来源,以及标为论文或网页的文档只按一半权重计入,没有给出合并公式和各路名额;附录的例子里,标为百科的两篇排在第 1、2 位,第 3 到 5 位是两个网页和另一个同源片段;地球科学的搜索过程和普通 DCI 一样,只在最后排序时才用检索;经济子集从向量候选出发,保留智能体给出的顺序,剩下的位置用向量排序补齐;机器人子集则把智能体判定为"能回答问题"的文档排在最前面。
这些策略没有一个是人事先写进去的,而且各不相同,这正是论文想证明的"接口应该按文档库定制"。但它们也有一个共同点:BRIGHT 上的四个接口最终都依赖论文提供的 ReasonEmbed-Qwen3-8B 现成排序。DCI 基线没有任何向量检索,"智能体检索(向量)"基线用的是更小的 ReasonEmbed-Qwen3-4B,DR-DCI 用的是 BGE-large。论文没有报告"只用这份 8B 排序、不经过智能体"能得多少分,所以 BRIGHT 上 9.3 分的提升里,有多少来自接口设计、有多少来自更强的检索资源,无法从正文分开。
3.3 只改提示词够不够
第 3.2 节的疑问,可以用下面这组对比部分回答。对比两种变体:一是同样的优化循环,但只允许改说明文字,不能生成文件、工具,也不能用检索资源;二是把 SearchWeaver 最终接口里生成的文件、工具和对应说明删掉,不再重新优化。
| 方法 | BCP | 生物 | 地球 | 经济 | 机器人 | BRIGHT 平均 |
|---|---|---|---|---|---|---|
| DCI | 71.6 | 61.6 | 51.5 | 31.3 | 38.2 | 45.7 |
| 只优化提示词 | 75.6 | 71.4 | 56.2 | 41.8 | 38.8 | 52.0 |
| SearchWeaver | 78.4 | 74.6 | 64.6 | 38.3 | 42.4 | 55.0 |
| 删掉生成的文件和工具 | 72.5 | 64.9 | 53.1 | 38.8 | 38.0 | 48.7 |
只改提示词、完全不用检索资源,BRIGHT 平均就从 45.7 升到 52.0,占了全部提升的三分之二左右。这说明大部分收益来自"告诉智能体怎么在这个文档库里查",而不是额外的检索排序。剩下约 3 分才需要文件、工具和检索资源。这部分的收益集中在生物和地球科学:去掉文件和工具后,这两个子集分别掉了 9.7 和 11.5 分;经济子集去掉后反而略高(38.8 对 38.3),而且只优化提示词在经济上得分最高(41.8)。也就是说,经济子集优化出的那套工具并没有帮上忙,选中它只是因为它在优化集上平均分最高,这也说明 10 轮、几十道优化题的选择过程会带入一定噪声。
3.4 工具耗时
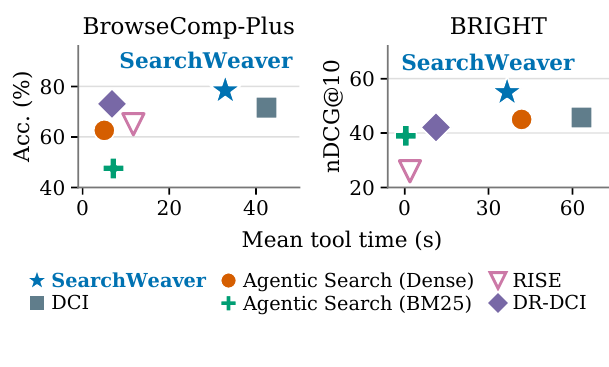
论文强调 SearchWeaver 比 DCI 更省时间:每题工具执行时间(不含模型推理)在 BCP 上从 42.4 秒降到 32.9 秒,在 BRIGHT 上从 63.2 秒降到 36.6 秒。附录按子集给出了明细:
| BRIGHT 子集 | DCI 平均(秒) | SearchWeaver 平均(秒) | DR-DCI 平均(秒) | RISE 平均(秒) |
|---|---|---|---|---|
| 生物 | 62.2 | 12.3 | 8.0 | 1.7 |
| 地球科学 | 78.8 | 63.5 | 9.8 | 2.2 |
| 经济 | 43.3 | 26.3 | 10.1 | 1.9 |
| 机器人 | 66.6 | 40.7 | 17.2 | 1.7 |
节省主要来自生物子集,因为它把搜索限定在一个主题目录里;地球科学的接口沿用了 DCI 的全库搜索,所以几乎没省。和其他方法比,SearchWeaver 并不快:DR-DCI 和 RISE 的工具耗时只有它的几分之一。它是用比这两者多的工具时间换来了更高的分数,所以作者说它在评估的方法中处于帕累托前沿,这个说法准确,但"更省时间"只是相对 DCI 而言。另外,这里只算工具执行时间,不算模型推理时间,而后者在多轮交互里很可能占更大比重,论文没有报告。
3.5 换模型还有效吗
把用 GPT-5.4-nano 优化出的接口原样交给 Gemini 3.5 Flash-Lite,BCP 答对率为 73.9%(DCI 为 60.9%),BRIGHT 平均 nDCG@10 为 58.8(DCI 为 50.7),四个子集全部高于 DCI,BRIGHT 上每题工具时间从 23.1 秒降到 15.5 秒。不重新优化也有效,说明优化出来的东西有相当一部分属于文档库本身,而不只是针对某个模型的技巧。值得注意的是,换成 Gemini 后 RISE 和 DR-DCI 在 BCP 上分别有 69.1% 和 69.6%,都比 DCI 高出 8 分以上,各方法之间的差距随模型变化很大,单一模型下的排名不宜当成定论。
4. 局限
作者明确承认的局限是:实验只在固定不变的文档库上做,文档增删后,预先生成的索引和依赖它的工具何时需要更新、能否增量更新,没有研究。
此外还有几点。其一,优化成本没有报告。每一轮都要让 Claude Opus 5.5 读完整执行记录,再让搜索智能体把优化集跑一遍,10 轮下来的调用量和费用是采用这个方法时最需要知道的数字。其二,BCP 只用 30 道题做优化,接口是否对这 30 题过拟合,论文没有分析;测试集上的提升说明至少没有严重过拟合,但同样的问题在别的文档库上未必成立。其三,BRIGHT 上检索资源不对等,如第 3.2 节所述。其四,每个文档库只跑了一次优化,没有报告换随机种子或换设计者模型后结果的波动。
5. 实践意义
对搭建企业内部知识库问答智能体的团队,这篇给了一个可以照做的流程:准备一小批带标准答案的问题,让编码智能体看着执行记录去改提示词、生成索引文件和检索脚本。从消融看,最划算的第一步是只改提示词,BCP 答对率从 71.6% 升到 75.6%,BRIGHT 拿到了三分之二的提升,而且不需要额外的检索资源。如果文档库有明显的目录结构,或者有质量不错的向量检索,再让设计者生成工具,把检索范围限定到相关目录、把智能体的判断和检索排序结合起来。文档库更新频繁时,生成的索引需要自己设计维护方式。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…