 已录用 ICLR 2026
目录 · 8 节
1它到底在解决什么问题?2稠密检索:把每个词的向量提前算好3稀疏检索:查询连模型都不用4两路融合:先各自缩放到 0 到 1 再加权5实验结果:快了多少,掉了多少?6我认为它的局限7一个检索团队可以怎么试8结论与评价
在线检索的查询量大、又想用大模型做 embedding 的团队值得认真看这篇。它的核心一句话:文档侧保留完整大模型,查询侧在线时只做一次查表加平均。在单张 A800 上,查询编码时间从 109.5 秒降到 0.04 秒,代价是英文 BEIR(15 个英文检索数据集)上的排序质量从 56.8 降到 54.4。这说明对大部分普通相关性检索,查询侧那台大模型其实可以拿掉。
它到底在解决什么问题?
向量检索有两个编码器:文档编码器和查询编码器。文档可以提前离线编码、建好索引;查询却是用户实时输入的,必须在线编码。最近效果最好的检索模型两边都用 7B、8B 这样的大模型,于是每来一条查询,都要在 GPU 上跑一次完整的大模型前向计算,这成了在线服务的瓶颈。
作者的问题是:查询真的需要和文档一样深的建模吗?传统的 BM25(按关键词重合和词频打分的经典方法)几乎不花计算,在很多任务上仍然有竞争力。这说明查询侧也许可以大幅简化,只要文档侧足够强。
| 环节 | 普通大模型检索 | LightRetriever |
|---|---|---|
| 文档编码 | 完整大模型,离线 | 完整大模型,离线(不变) |
| 查询编码(稠密) | 完整大模型,在线 | 查表加平均 |
| 查询编码(稀疏) | 完整大模型,在线 | 直接数分词个数,不用模型 |
| 最终分数 | 单路 | 稠密和稀疏两路加权相加 |
稠密检索:把每个词的向量提前算好
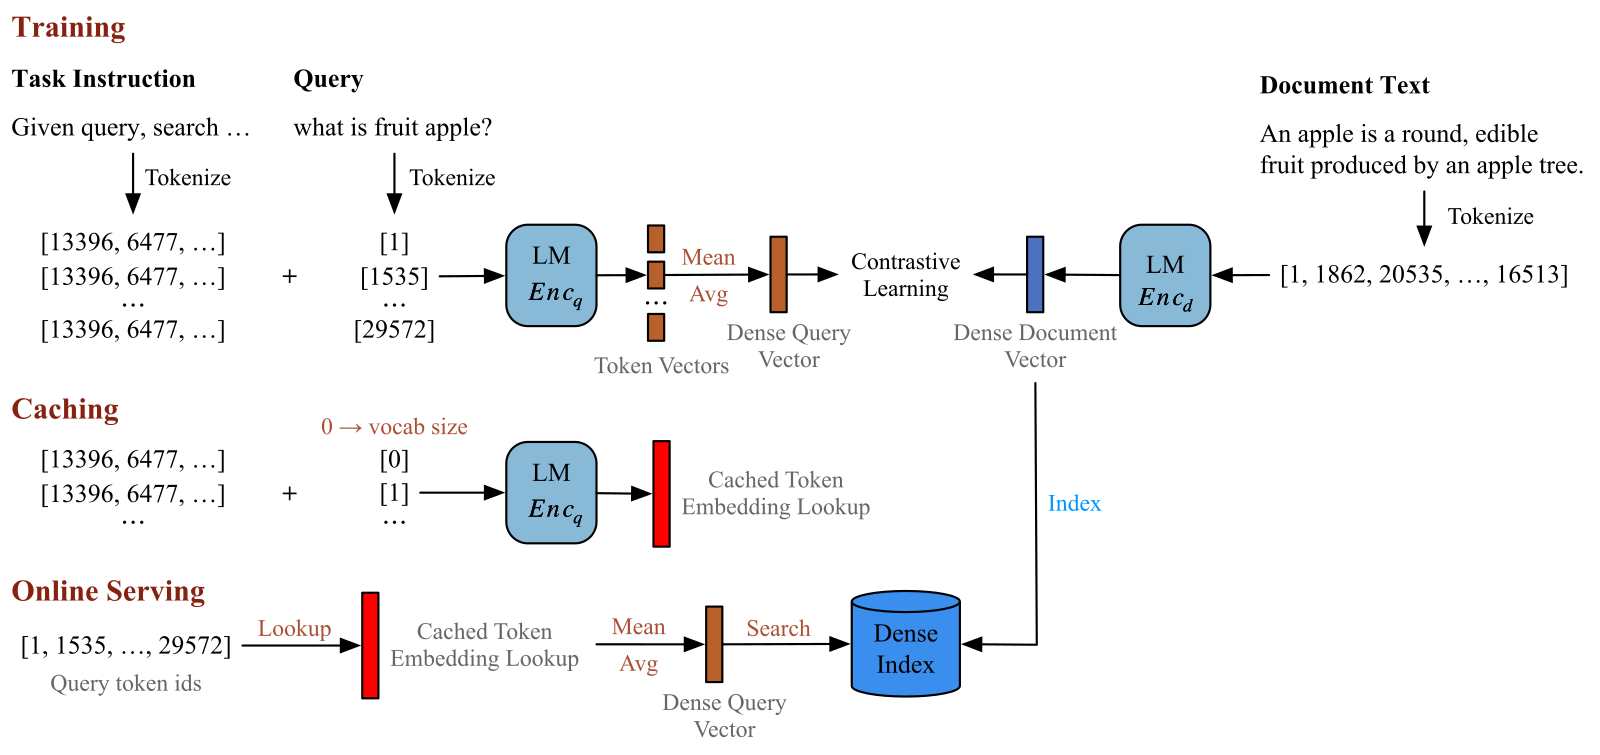
第一步,训练。普通做法是把整条查询送进大模型。LightRetriever 改成:每个查询词单独接在任务指令后面送进大模型,取最后一个位置的输出作为这个词的向量;整条查询的向量就是这些词向量的平均。这样做的原因是,词和词之间在模型里不再互相影响,所以每个词的向量只取决于“指令加这个词”,可以提前算好。训练用的是标准的对比学习:让查询向量和相关文档的点积大、和 7 个难负样本的点积小。
第二步,缓存。训练完以后,把词表里的每个词都按同样方式算一遍,存成一张查表矩阵。Llama-3.1-8B 的词表有 128256 个词、向量 4096 维,用半精度存约 1.05 GB 内存;在 8 张 H800 上算完整张表不到 20 秒。
第三步,线上服务。来一条查询,先分词,再按词编号查表、取平均,就得到查询向量,完全不需要大模型。手算例子(示意):查询分成“苹果”“水果”两个词,表里分别是 (0.8, 0.2) 和 (0.6, 0.4),查询向量就是 (0.7, 0.3)。
为什么训练时还要完整大模型?作者做了对照:训练时查询侧也只用一张 embedding 查表(不经过大模型),以 Llama-1B 的稠密检索为例,BEIR 从 48.7 掉到 37.5。我认为这说明,大模型在训练时把“这个词在检索里应该指向什么”的知识写进了每个词的向量,查表只是把这些知识取出来。
稀疏检索:查询连模型都不用
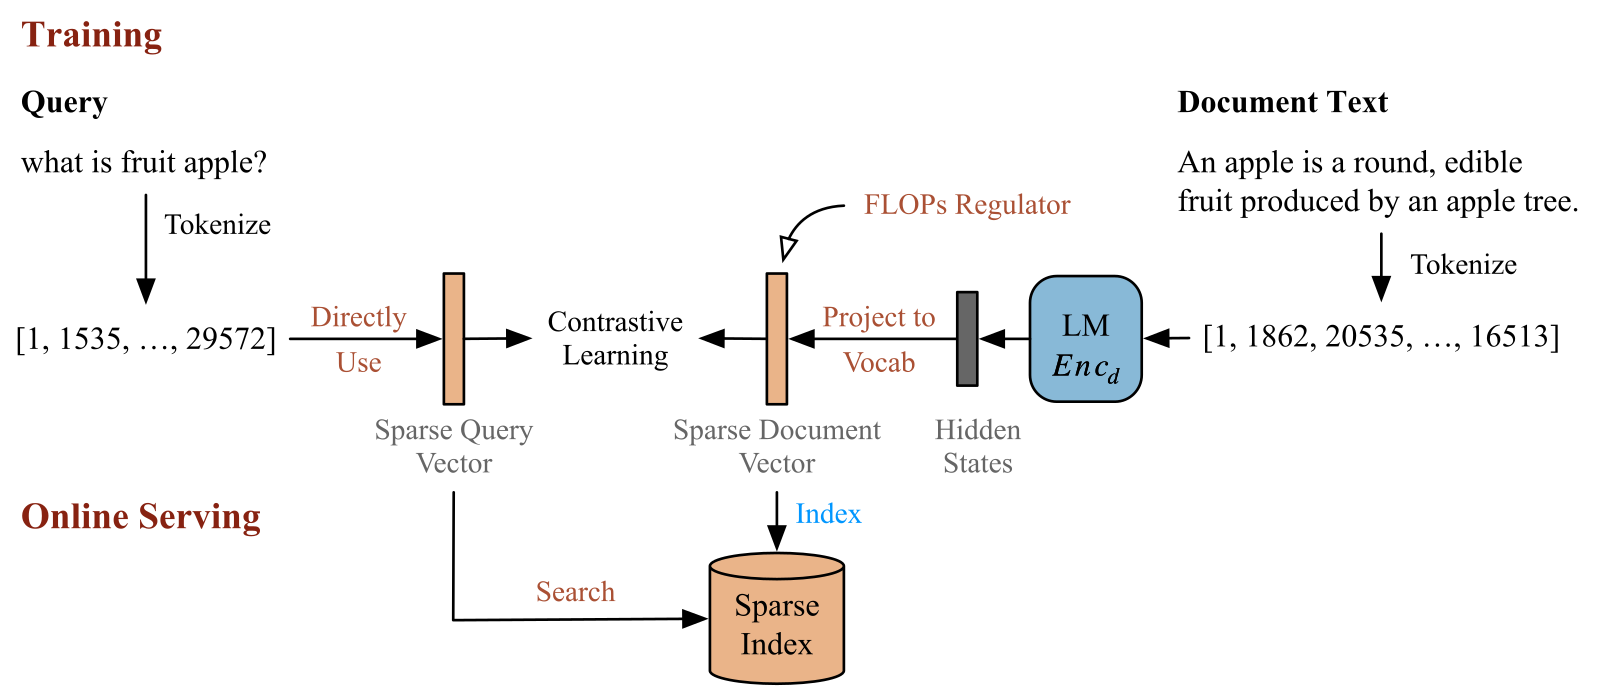
查询侧的稀疏向量就是“每个词出现了几次”。文档侧则用大模型把每个位置的输出投影到整个词表上,对每个词取 log(1+max(值,0)),再在所有位置上取最大值,得到文档在每个词上的权重。因为是模型算出来的,文档可以给原文里没出现、但意思相关的词也分一些权重。
查询和文档的分数就是两者对应位置相乘再相加。手算例子(示意):查询是“苹果 水果 苹果”,向量是苹果 2、水果 1;某文档的权重是苹果 2.1、水果 1.3、果树 0.8,分数就是 2×2.1+1×1.3=5.5,“果树”因为查询里没有,不贡献分数。
文档向量天然不够稀疏,存索引会很大,所以训练时加了一个 FLOPs 正则项:每个词的权重先在一个批次的文档上取平均,再平方,所有词加起来。手算例子(示意):某个词在两篇文档里的权重是 2 和 0,平均 1、平方 1;如果两篇都是 1,平均 1、平方也是 1,但很多词都“小而不为零”时,平方和会累积起来,所以这一项会推动大部分词的权重变成 0。系数是 0.001,前 4000 步逐渐加大,避免一开始就压得太狠。
两路融合:先各自缩放到 0 到 1 再加权
最终分数把稠密和稀疏两路相加。论文只写了“归一化后线性相加”,我在官方代码里找到了具体做法:每条查询的候选结果里,两路分数各自做最小最大缩放,即 (分数−最小值)÷(最大值−最小值),缩放到 0 到 1;再按稠密 0.7、稀疏 0.3 的默认权重相加。手算例子(示意):某文档稠密分在本查询候选里排中间,缩放后 0.5,稀疏分是最高,缩放后 1,融合分就是 0.7×0.5+0.3×1=0.65。
为什么要缩放?因为稠密分是 −1 到 1 的余弦,稀疏分可能是几十,直接相加会被稀疏分主导。以 Llama-1B 为例,只用稠密一路时 BEIR 是 48.7,加上稀疏一路融合后到 52.0,只比两侧都用完整模型低 1.1。这说明稀疏一路虽然连模型都不用,却补上了关键词精确匹配的能力,比如型号、人名这类在稠密向量里容易被“平均掉”的词。
实验结果:快了多少,掉了多少?
指标先说清楚:nDCG@10 衡量前 10 个结果的排序质量,相关文档排得越靠前分越高,满分 100;BEIR 取 15 个英文数据集的平均,CMTEB(中文检索基准)取 8 个中文检索数据集的平均。
速度测试是在单张 A800 上,用 65536 条必应查询检索 100 万篇 MS MARCO 段落。
| 方案 | 查询编码耗时 | 总耗时 | 每秒查询数 | BEIR | 中文 CMTEB |
|---|---|---|---|---|---|
| 完整 Llama-8B 两侧 | 109.5 秒 | 119.4 秒 | 549 | 56.8 | 67.6 |
| 完整 Llama-1B 两侧 | 19.9 秒 | 29.6 秒 | 2210 | 53.1 | 63.8 |
| 查询侧只用 Llama-8B 第一层 | 2.34 秒 | 11.8 秒 | 5533 | 50.1 | 54.4 |
| LightRetriever(Llama-8B) | 0.04 秒 | 9.4 秒 | 6999 | 54.4 | 63.0 |
这张表说明三件事里最重要的一件:编码时间降到几乎为零以后,总耗时主要剩下搜索的 8.5 秒,所以端到端只快了约 13 倍,而不是编码那一步的 2500 倍。另外,“只保留第一层”这个直觉上的简化办法,效果和速度都不如 LightRetriever。
和外部方法比,LightRetriever-Llama-8B 在 BEIR 上 54.4,高于 BGE-m3 稠密加稀疏的 49.6,接近 E5-Mistral 的 56.9。六个骨干上,相对两侧都用完整模型,BEIR 平均掉 1.1 到 2.8 分,中文掉 2.1 到 4.6 分,所以中文损失更明显。
按任务类型看,生物医学(TREC-COVID)、论点检索甚至比完整模型更好,保留率分别是 115% 和 107%;但实体检索(DBPedia)和引用预测(SCIDOCS)只保留约 87%。附录里代码检索和推理型检索也明显变差,因为这些任务更依赖理解整句话的结构。
我认为它的局限
- 查询词之间在线时没有交互。作者用几个人工例子说明它能处理否定,但推理型、代码类检索掉得多;对“A 不是 B”这类依赖语序的查询要自己验证。
- 加速比依赖测试环境。论文用的是 GPU 上的精确搜索,搜索本身占了总耗时的大头;换成近似最近邻索引,编码占比不同,收益也会不同。文档侧仍是完整大模型,8.8M 篇段落的稠密索引就要约 135 GB。
- 按公式,每个词的缓存向量和任务指令绑定,换一种指令就要重算一张约 1 GB 的表;多任务服务时内存要按指令数量计算。
一个检索团队可以怎么试
- 先量瓶颈:统计线上一次查询里编码、搜索、排序各占多少时间。只有编码占大头时,这个方法才有明显收益。
- 用官方代码在 1B 级骨干上复现,拿自己的查询日志比较完整双塔和 LightRetriever 的召回,重点看长查询、否定查询。
- 调融合权重:默认 0.7 比 0.3 只是起点,在自己的验证集上扫一遍。
- 如果内存紧张,试附录里的维度截断,把查表矩阵变小,再看召回掉多少。
结论与评价
LightRetriever 把“查询在线、文档离线”这个不对称性用到了极致:训练时两侧都用大模型,服务时查询侧只剩一张表。对查询量大、查询偏短、以普通相关性为主的检索系统,这是一个成本很低、收益很直接的方案。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。大模型检索的在线成本是真实的部署障碍 |
| 方法创新性 | 中高。“训练时完整、服务时查表”的拆法简单而有效 |
| 实验证据 | 中高。六个骨干、中英文两个基准、速度分解清楚;但推理型任务掉得多 |
| 工程成本 | 低。代码开源,训练 8B 约 15 小时,服务只需约 1 GB 内存 |
| 是否值得尝试 | 查询编码是瓶颈的团队值得马上试;推理型检索场景谨慎 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…