 已录用 SIGIR 2026

RAG 系统一般只接一个固定的检索器,但不同问题适合的检索器不同,有些问题干脆不检索、只靠模型自己答更好。这篇论文把选检索器当成排序问题:对每个训练问题,记下每个检索器让答案质量比不检索提高了多少,再训练一个排序模型给检索器排名,不检索也是候选之一。在六个由稀疏、稠密检索和不同重排组合出的检索器上,pairwise XGBoost 路由把答案正确率分从最好单一检索器的 0.5776 提到 0.5900,而每题都选对的上限是 0.7948。路由的收益是真实的,但离上限还很远,而且训练标签选哪种答案质量指标影响很大。
做 RAG 的团队值得读这篇,主要是两个可以直接拿来用的做法:训练标签用“比不检索好多少”,而不是检索指标;把“不检索”放进候选里一起排。前者让路由器直接对齐生成质量,后者把“要不要检索”和“去哪检索”合成一个决定。需要留意的是,提升只有约 2%,学出来的路由器和最好的免训练规则相比,差距在统计上也不显著。而且它的特征要先把六个检索器都查一遍才算得出来,省不了检索成本。
它要解决什么问题?
同一个 RAG 系统会收到风格很不一样的问题。下面三个问题(示意)各自适合不同的做法:
| 问题 | 更适合的做法 | 原因 |
|---|---|---|
| “ISO 27001 第 8.2 条讲什么” | 关键词检索(BM25) | 编号和专有名词要求字面命中,语义检索容易找成相近条款 |
| “远程办公对员工心理健康有哪些影响,又有哪些应对办法” | 语义检索(稠密向量)加多样化重排 | 问题有两个方面,结果需要覆盖两类文档 |
| “法国首都是哪里” | 不检索 | 模型本身就知道,检索回来的网页反而可能带进噪声 |
现在的系统大多只接一个检索器,所有问题都走同一条路。已有的路由方法有两个问题。一是很多方法按检索指标来选,比如看哪个检索器的召回率高,但对大模型来说,召回率高不等于答案好。二是很多方法要用到语料统计,比如问题和语料的相似度,可在实际系统里,检索器往往只是一个搜索接口,拿不到它背后的语料。
论文把场景设定得很贴近这种现实:路由器看不到检索器内部,只能看到问题本身和每个检索器返回的结果,目标是让最终答案更好。
整体流程
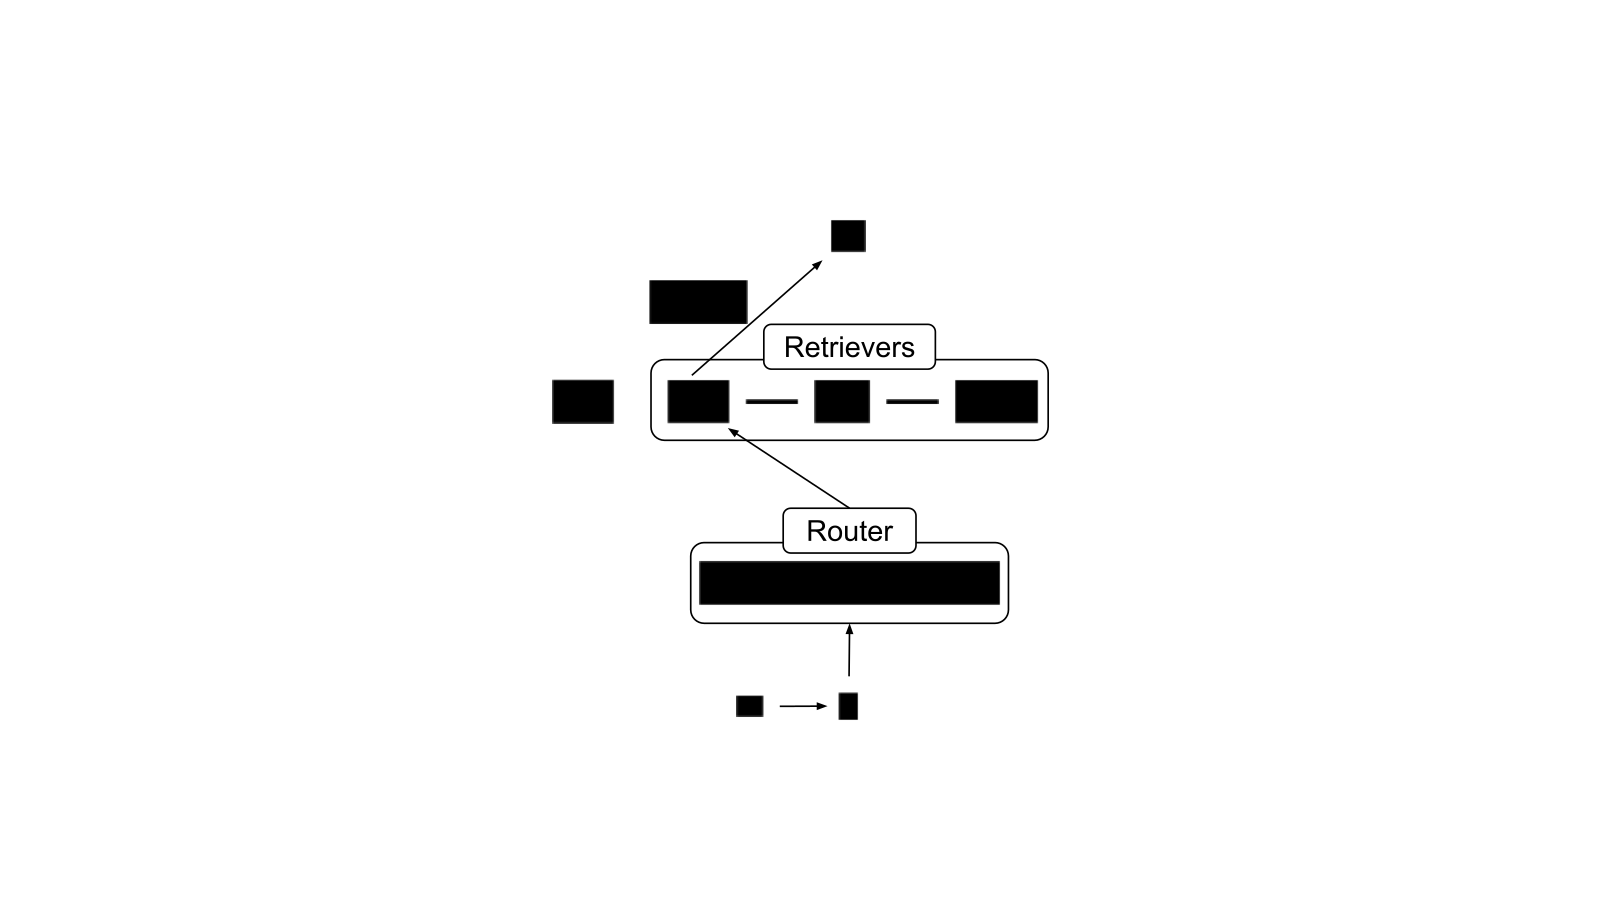
| 环节 | 具体设置 |
|---|---|
| 检索器池 | BM25 和 E5-base 两种基础检索,各自搭配“不重排”“分数正则化重排”“随机重排”,共六个,外加“不检索” |
| 语料 | FineWeb 抽样的 1,500 万篇网页,六个检索器共用 |
| 生成模型 | Falcon3-10B-Instruct,先在 think 标签里判断每段材料有没有用,再给出答案 |
| 训练标签 | 每个检索器让答案质量比不检索提高了多少,每题内部归一化到 0 到 1 |
| 路由器 | 排序模型,比较了单点、成对、整列三类训练方式共 11 个模型,最终用成对训练的 XGBoost |
| 数据 | 用合成工具 DataMorgana 生成问答,平衡数据集训练约 8,000 题、测试约 2,000 题 |
两种重排目标不同。分数正则化先算出前 k 篇文档两两之间的向量相似度,每篇只保留最像的 m 个邻居,再把每篇的分数换成邻居分数的加权平均,重复几轮,这样语义相近的一簇文档会一起被抬高,目的是提高检索质量。随机重排把原始分数当作抽样权重,不放回地一篇一篇抽:第一位从全部文档里按权重抽,第二位从剩下的文档里再按权重抽,直到排满,这样得到一份完整排序;一共生成 50 份这样的排序,再随机选一份使用。分数高的文档大概率仍在前面,但低分文档也有机会露出,目的是让不同文档得到更公平的曝光,之前的研究发现这样有时也能让答案更好。这样组合出来的六个检索器用的是同一个语料,差别只在检索方式上。
核心机制:标签怎么来,特征怎么算
先看标签。对每个训练问题,系统让生成模型各答一遍:不检索答一次,用六个检索器的结果各答一次。每个答案用答案质量指标打分,再减去不检索时的分数,得到每个检索器的“增益”。增益可以是负数,说明这个检索器帮了倒忙。
举个例子,一道题不检索时答案得 0.40 分,各检索器的结果如下(示意):
| 选项 | 答案得分 | 增益(减去 0.40) | 题内归一化 |
|---|---|---|---|
| BM25 | 0.70 | +0.30 | 1.00 |
| E5 | 0.55 | +0.15 | 0.57 |
| 不检索 | 0.40 | 0 | 0.14 |
| BM25 + 随机重排 | 0.35 | −0.05 | 0.00 |
题内归一化是把这道题里最差的选项映射到 0、最好的映射到 1。这样做是因为不同题目的难度差很多,有的题怎么答都只有 0.2 分,有的题随便答都有 0.8 分,归一化之后不同题目的标签才能放在一起训练。
作者比较了三种训练方式,成对训练表现最好。作者认为这是 XGBoost 成对版本表现最稳的原因:路由最终只取第一名,顺序比数值重要。
再看特征。路由器拿不到检索器内部信息,所以特征分两类。检索前特征只和问题有关:问题向量(E5 编码后用 PCA 降到 32 维)、问题长度、问题类型(关键词式还是自然语言)。检索后特征需要先拿到每个检索器的前 k 篇结果再计算:
| 特征 | 含义 | 它想捕捉什么 |
|---|---|---|
| OverallSim | 问题和结果平均向量的相似度 | 结果整体是否切题 |
| AvgSim / MaxSim | 问题和单篇结果相似度的平均值和最大值 | 有没有至少一篇很相关 |
| VarSim | 单篇相似度的方差 | 结果质量是否参差 |
| Moran 系数 | 在结果之间的相似度图上,看彼此相似的文档检索分数是否也接近 | 高分结果是否聚成一个主题,而不是零散命中 |
| CrossRetSim | 这个检索器的结果和其他检索器结果的平均相似度 | 它找到的东西是否和别人不一样 |
“不检索”这个选项没有检索后特征。XGBoost 这类树模型用训练集的中位数填上,神经网络模型则给它学一个专门的向量。
这里最值得注意的是成本:要算检索后特征,必须先把六个检索器都查一遍,再决定用哪个结果。所以这个路由器省不了检索的开销,它省的是“把哪份材料交给生成模型”的选择错误。如果选了不检索,省下的也只是生成时的上下文长度。
实验结果
测试分五个划分:平衡划分里训练和测试都包含全部五类问题;另外四个划分各留出一类问题只用于测试,用来看路由器在没见过的问题类型上表现如何。下表是用答案正确率指标(AC)训练和评估的结果。AC 把生成的答案和标准答案对比,综合事实陈述的重合程度和语义相似度给出 0 到 1 之间的连续分,所以表里的数字是平均质量分,不是答对比例:
| 方法 | 平衡 | 未见:多方面 | 未见:比较 | 未见:复杂 | 未见:开放式 |
|---|---|---|---|---|---|
| 每题都选对(上限) | 0.7948 | 0.7802 | 0.7831 | 0.7978 | 0.7852 |
| 最好的单一检索器 | 0.5776 | 0.5809 | 0.5723 | 0.5812 | 0.5784 |
| 免训练规则 MaxSim | 0.5872 | 0.5777 | 0.5753 | 0.5891 | 0.5775 |
| 成对 XGBoost | 0.5900 | 0.5769 | 0.5759 | 0.6017 | 0.5930 |
| 成对 SVMRank | 0.5329 | 0.5842 | 0.5695 | 0.5377 | 0.5791 |
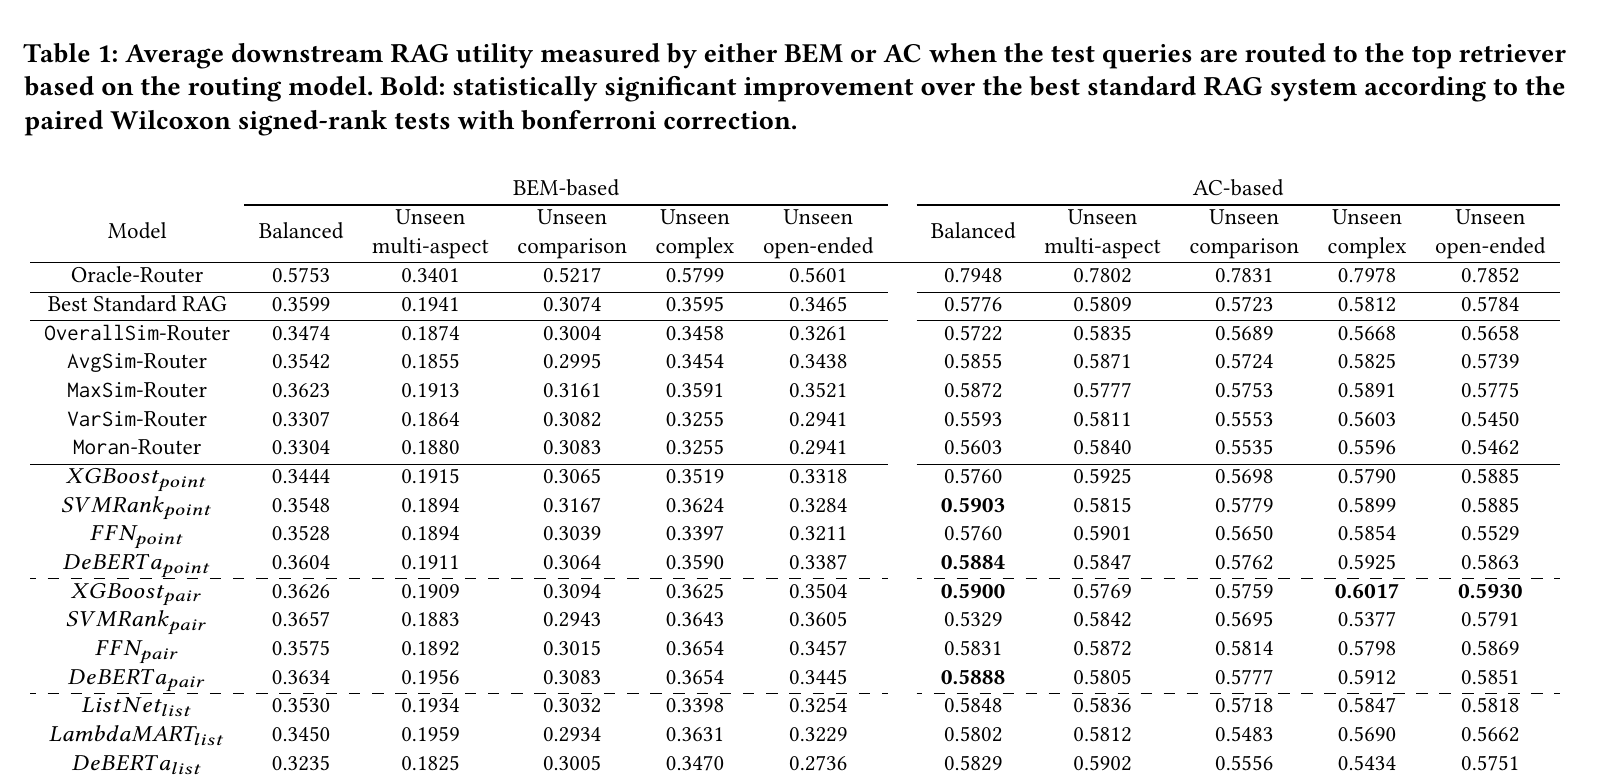
这张表可以读出三件事。第一,成对 XGBoost 在平衡划分上比最好的单一检索器高 0.0124,约 2%,而且在统计检验下显著,在没见过的复杂题和开放式题上也显著,说明学出来的路由确实有用。第二,它在多方面问题上反而略低于单一检索器,所以并不是在所有题型上都稳赢。第三,同样是成对训练,SVMRank 在平衡划分上掉到 0.5329,比单一检索器还差,因此模型选错了会比不路由更糟。
读这些数字时还要考虑测试集的规模。平衡划分有约 2,000 道测试题,四个未见划分只有约 400 到 800 题,比如比较题只有 385 道。在这么小的测试集上,0.01 左右的差距很容易被随机波动淹没,所以作者在每个比较上都做了统计检验,也正因为这样,很多数字上的提升最后都没能算作显著。
上限那一行最能说明问题。每题都选对能到 0.7948,比最好单一检索器高约 0.22,而最好的路由器只拿到了其中约 6%。这意味着检索器之间的互补空间很大,但现有特征还看不出哪道题该用哪个。
和免训练规则相比,学出来的路由器在数字上通常更好,但作者自己承认,经过多重比较校正后,这个差距在统计上不显著。最简单的 MaxSim 规则,也就是选“最相关的那篇结果相似度最高”的检索器,已经拿到了大部分收益。
另一个发现是标签指标的影响。用另一种答案质量指标 BEM 训练时(它用一个 BERT 分类器判断生成答案和标准答案在这个问题下是否等价,输出等价的概率),没有任何一个路由器相对单一检索器显著提升,平衡划分上最好的单一检索器是 0.3599,成对 XGBoost 也只有 0.3626。作者的解释是 AC 和人工判断更一致,所以学到的信号更干净。对实践的意义是,换一个评分指标,同样的方法可能就看不出效果。
我认为它的局限
第一,省不了检索成本。检索后特征要求先查完所有检索器,六个检索器就是六倍的检索开销,然后只用其中一份结果。论文在讨论里提到路由可以“只激活必要的检索器”,但他们的实现并做不到这一点。如果只用检索前特征,能否保住这约 2% 的提升,论文的实验没有覆盖。
第二,数据和环境都比较单一。问题全部是 DataMorgana 合成的,语料只有一个 1,500 万篇的网页集合,生成模型只有一个 10B 模型,检索器也只是两种基础检索加重排。真实系统里不同检索器常常对应不同的数据源,比如内部文档库、网页搜索、数据库,差异比这里大得多,路由收益可能更大,也可能特征完全失效。
第三,提升幅度小,而且对选择很敏感。平衡划分上 0.0124 的提升需要统计检验才能确认,换成 BEM 指标就消失了,换成成对 SVMRank 甚至变成负的。一个团队如果照着做,很可能需要先花不少精力调指标和模型,才能复现出正向结果。
一个 RAG 团队可以怎么试
- 先算上限:从线上抽几百条问题,让每个检索器和不检索各跑一遍,用答案质量指标打分,看每题都选对能比现在高多少。如果上限也只高一两个点,就不值得做路由。
- 检查“不检索”的胜率:统计有多少题不检索反而答得最好。如果比例不低,可以先只做“要不要检索”这一个二选一,成本和风险都更低。
- 先试免训练规则:比如按 MaxSim 选检索器。这篇论文里它已经拿到了大部分收益,而且不需要训练数据。
- 如果规则不够,再按论文的方式构造标签:增益用“比不检索好多少”,每题内部归一化,用成对排序训练树模型。同时用两种答案质量指标各训一次,看结论是否一致。
- 上线前算账:检索后特征要求查询所有检索器,延迟和费用要和收益一起评估;如果成本不能接受,先试只用检索前特征的版本。
一句话结论
把“不检索”放进候选、用“比不检索好多少”做标签,是这篇论文最值得借鉴的设计,但实测提升只有约 2%,离每题都选对的上限还差得很远。
| 维度 | 判断 |
|---|---|
| 问题重要性 | 中高。多检索器、多数据源的 RAG 越来越常见,选哪个检索器是真问题 |
| 新意 | 中。路由和排序学习都是老方法,按生成增益做标签、把不检索放进候选是主要贡献 |
| 证据强度 | 中低。提升小,依赖指标和模型选择,数据全部合成,学习方法相对免训练规则不显著 |
| 工程成本 | 中。模型很轻,但检索后特征要查所有检索器 |
| 值不值得试 | 值得先做上限分析和“要不要检索”的二选一,完整路由等上限足够大再上 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…