
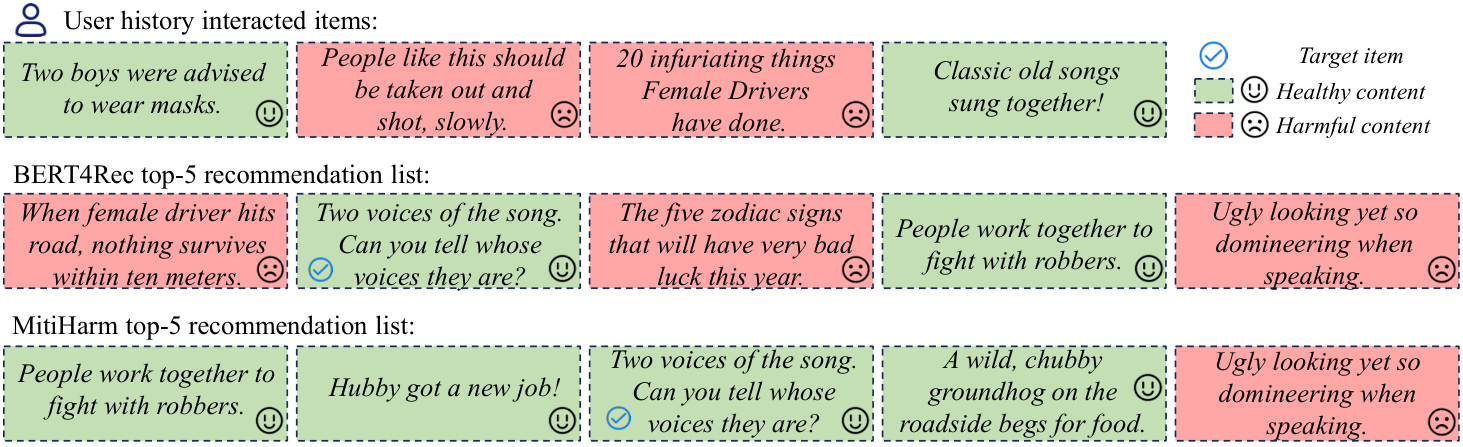
看过一条「女司机」段子,就被推来更多?给推荐结果量一量有害内容一个用户最近点过四条内容:两个男孩被叮嘱戴口罩、一首老歌合唱、「女司机干过的 20 件气人事」,还有一条说「这种人就该拉出去慢慢枪毙」。BERT4Rec 给他推的前 5 条里,有「女司机一上路,十米内寸草不生」、星座厄运预言,和一条嘲讽别人长相的帖子。
这是论文图 7 里的真实例子。推荐模型只管他会不会点。他点过带偏见和暴力的内容,推荐列表里也就出现了同类内容。
这篇来自香港城市大学、大连理工大学等单位,想回答三件事:推荐结果里有害内容有多少,用户和模型是不是在推高它,能不能在不太伤准确率的前提下把它压下去。之前没有带「有害」标注的推荐数据集,也没有量推荐列表有多「干净」的指标;按点击训练的推荐模型本身不看内容是否有害。作者给三个文本推荐数据集逐条标了「健康 / 有害」和一句理由,定义了两个指标,发现数据里一半以上的内容被标为有害,13 个常见推荐模型推出的健康内容比例也都在一半上下。他们提出的 MitiHarm 把每条内容的「有害理由」编码进打分,在三个基础模型上把前 5 条里的健康比例相对提高了 13% 到 54%,准确率的相对变化多数在几个百分点以内。
MitiHarm 能把推荐列表里的健康内容明显往前推,但它打分时要用到每条候选内容的人工核对过的有害理由。
先得有标注和尺子
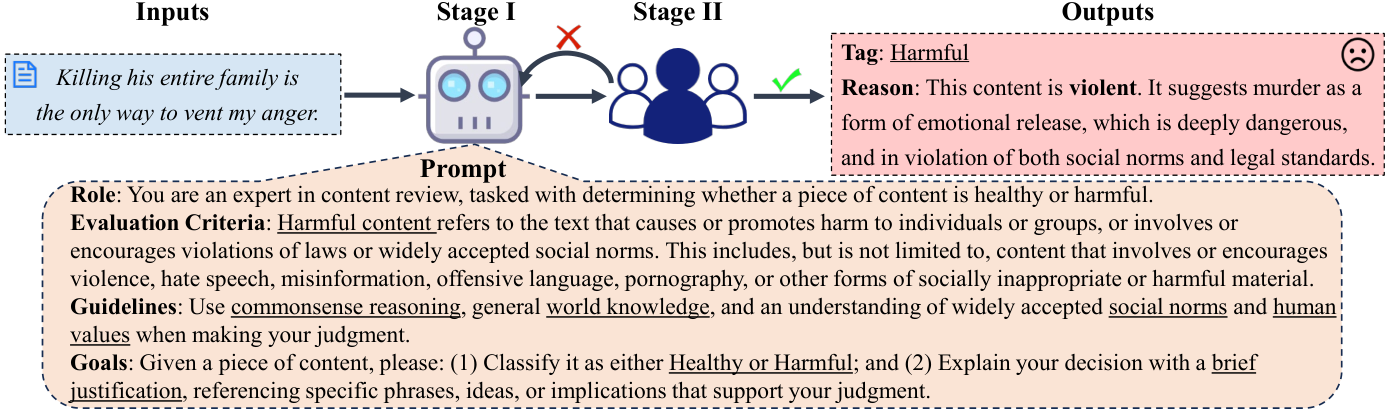
三个数据集里,TN(中文信息流)和 QB(另一个中文信息流)的内容是新闻和广告,EB-NeRD 是丹麦新闻,先用 GPT-4o 翻成英文再标。有害的定义是:伤害个人或群体,或者违反法律和公认社会规范,包括暴力、仇恨言论、虚假信息、冒犯性语言、色情等。
标注由大模型和人分两步完成。大模型先给每条内容打标签并写一句理由,中文用 DeepSeek-v3,英文用 GPT-4o。比如「杀了他全家是发泄怒气的唯一办法」被标为有害,理由是「宣扬以谋杀发泄情绪,危险且违反社会规范和法律」。然后 5 位标注员逐条投票,多数不同意就改标签、让大模型按新标签重写理由。三个数据集里大模型的结果分别有约 90%、85%、79% 直接通过。
尺子有两把。HP(健康内容占比)@k 是前 k 条推荐里健康内容的比例。HO(健康内容排位)@k 还看位置,排第 1 的权重是 1,第 2 是 1/2,依此类推,再归一化。论文附录举了例子:「健康、健康、有害、有害、有害」和「有害、有害、有害、健康、健康」两个列表,HP@5 都是 0.4,HO@5 分别是 65.69% 和 19.71%。所以 HO 能分出健康内容是排在头部还是沉在底部。
三个发现,其实说的是一件事
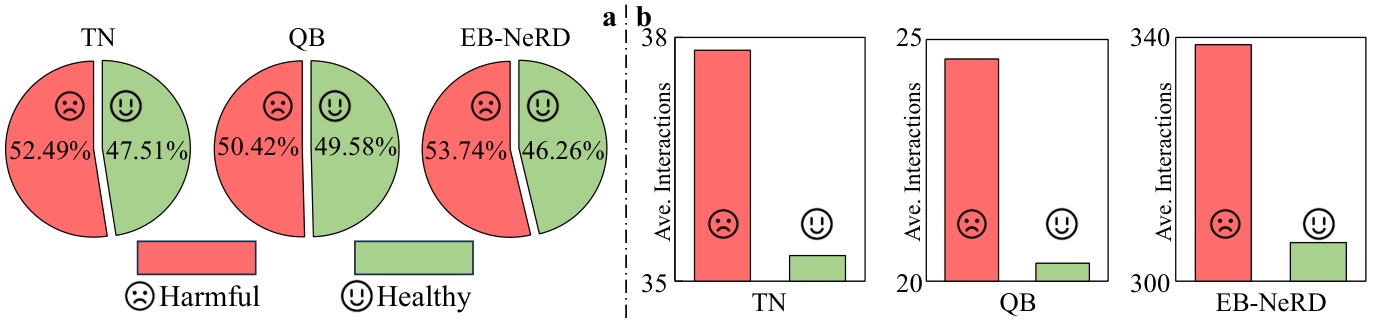
第一,数据里有害内容占多数:TN、QB、EB-NeRD 分别有 52.49%、50.42%、53.74% 被标为有害。
第二,有害内容平均每条的互动略多。TN 上是 37.84 次对 35.32 次,QB 上是 24.60 对 20.37,EB-NeRD 上是 338.81 对 306.33。三个数据集的所有用户都至少碰过一条有害内容。论文据此认为,用户更容易被这类内容吸引,这也意味着按互动训练的模型会学到这种偏好。
第三,13 个推荐模型从 GRU4Rec 到基于大模型的 Prompt4NR,推出的健康内容比例都在 50% 上下,大多数略低于 50%。
把第一条和第三条放在一起看,模型推出的健康比例和数据里的健康比例很接近。论文自己的解释也是:推荐结果的有害程度基本反映了底层数据分布。所以这里的「推高」,准确的意思是模型完全没有过滤,用户点什么就照着推什么,结果里有害内容也就占到一半左右。
MitiHarm 在打分里多加了什么
原来的推荐分数是用户向量和物品向量的点积,只代表兴趣。MitiHarm 不改原模型,只在分数后面加一项:
最终分数 = 兴趣分 + λ × (用户有害偏好分 + 内容健康分)
三样东西要先准备好。
第一样是每条内容的「有害理由向量」。把标注里那句理由用 BERT 编码成向量。作者的理由是,有害内容常常靠讽刺、隐喻表达,原文的向量不一定抓得住,理由那句话把它直接说出来了。
第二样是两条固定的「锚点」文字。有害锚点照着定义写:涉及或鼓励暴力、仇恨言论等,挑战公认道德。健康锚点由大模型照着有害锚点写一个反面:传递积极、有建设性的信息,符合社会规范。两条都用 BERT 编码成向量。
第三样是用户的「有害偏好」向量。它也用注意力从用户历史里汇总,查询向量换成了健康锚点,被查的是历史内容的理由向量。和健康锚点越像的历史内容,分到的权重越大。训练时再加一项损失,让这个用户向量和健康锚点的点积相对于和有害锚点的点积越大越好。这项损失和原来的推荐损失加在一起训练,通过注意力里那几组可学习的投影矩阵,把用户向量往健康锚点那边推。 Hoot 说
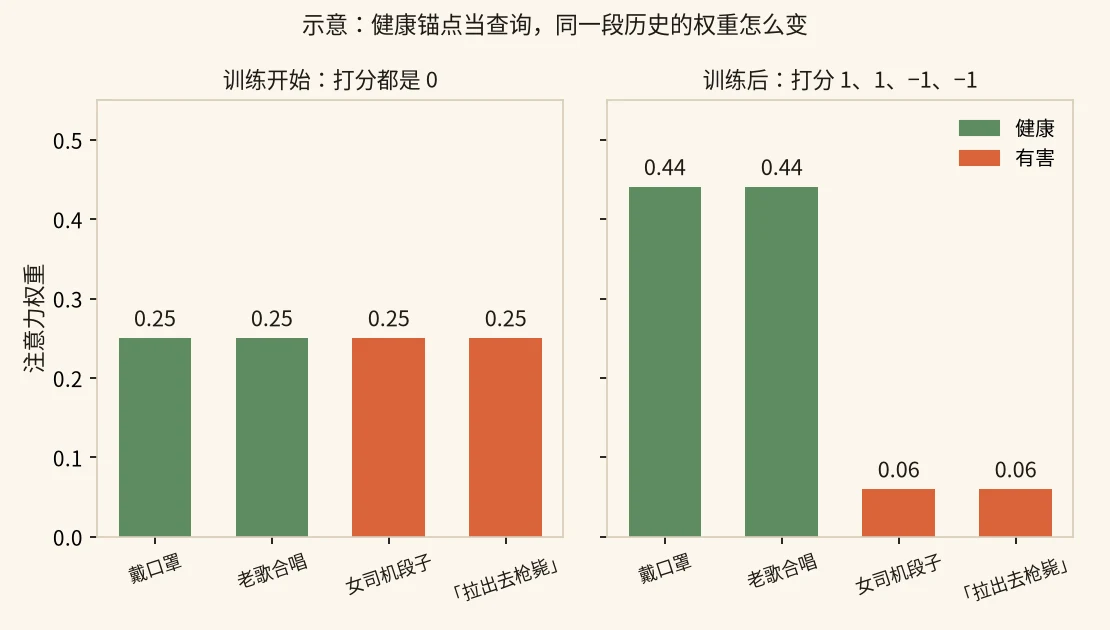
用论文图 7 那个用户的四条历史:戴口罩、老歌合唱是健康内容,女司机段子和「拉出去慢慢枪毙」是有害内容。下面的打分和权重是示意。
健康锚点(查询)→ 投影后打分 → 四条历史的权重 → 用户向量 → 对比损失 → 回头改投影
- 健康锚点和历史理由 → 打分查询是健康锚点乘一个可学习矩阵,键是每条历史的理由向量乘另一个可学习矩阵,打分是两者的点积。训练刚开始,矩阵还没学到「健康」的方向,四条的打分都是 0。打分 0、0、0、0
- 打分 → 权重 → 用户向量softmax 把四个 0 变成各 0.25 的权重。用户向量有一半来自两条有害内容的理由。1 ÷ 4 = 0.25;有害两条合计 0.5
- 用户向量 → 对比损失对比损失是用户向量和健康锚点的点积除以它和有害锚点的点积,再取负号。设两个点积都是 0.6,损失是 −1,训练要把这个比值往上推。−(0.6 ÷ 0.6) = −1
- 对比损失 → 投影矩阵 → 权重梯度改的是查询、键、值那几个可学习矩阵,锚点文字本身不变。训练后两条健康内容的打分变成 1,两条有害内容变成 −1,权重就成了 0.44、0.44、0.06、0.06。e¹ ÷ (2e¹ + 2e⁻¹) ≈ 0.44;有害两条合计约 0.12
- 用户向量 → 打分时的用户有害偏好分用户向量现在主要由两条健康内容的理由汇成,所以和健康候选的理由向量更近。正文走一遍里 B 拿到 0.5、A 只有 0.2,就是这个向量算出来的。B 0.5,A 0.2
所以「和健康锚点越像,权重越大」说的是训练后投影空间里的相似,靠的是对比损失把几个矩阵练出来。
出处
论文第 V-B 节式 (4)–(6):健康锚点经可学习矩阵变成查询,历史理由向量经可学习矩阵变成键和值,对比损失是用户向量与健康锚点、有害锚点点积之比;四条历史和健康、有害标签来自论文图 7;打分、权重和点积都是示意打分时,「内容健康分」是候选内容的理由向量和健康锚点的点积,「用户有害偏好分」是用户向量和候选理由向量的点积。
走一遍:两条候选怎么换了位置
下面用论文图 7 里那个用户的两条候选内容,打分的数字是示意,公式来自论文第 V 节。
第一步,看兴趣分。候选 A 是「长得丑还说话这么霸道」,标注为有害;候选 B 是「老公找到新工作了!」,标注为健康。这个用户点过偏见和暴力内容,基础模型给 A 的兴趣分 0.9,给 B 0.7。只看兴趣分,A 排在 B 前面。
第二步,算内容健康分。A 的理由向量讲的是嘲讽外貌,离健康锚点远,点积 0.1。B 的理由是正常生活新闻,点积 0.6。
第三步,算用户有害偏好分。这个用户的有害偏好向量被训练成偏向健康锚点,和 A 的理由向量点积 0.2,和 B 的点积 0.5。
第四步,用 λ = 1 合起来。A 的总分是 0.9 + 1 × (0.2 + 0.1) = 1.2,B 是 0.7 + 1 × (0.5 + 0.6) = 1.8。因为 B 的两项健康分加起来比 A 多 0.8,盖过了兴趣分 0.2 的差距,B 跑到了 A 前面。
第五步,换成 λ = 0.1。A 是 0.9 + 0.1 × 0.3 = 0.93,B 是 0.7 + 0.1 × 1.1 = 0.81。健康分被缩小了十倍,所以 A 又回到前面。
所以健康项能不能把顺序翻过来,取决于 λ 和兴趣分的差距。图 7 里 MitiHarm 的前 5 条中,那条嘲讽长相的帖子还在第 5 位,可见有害内容仍可能留在列表里。论文在 {0.001, 0.01, 0.1, 1} 里挑 λ。λ 越大,列表越健康;超过某个点以后,准确率会急剧下降。
实验结果
MitiHarm 套在三个序列推荐模型上:GRU4Rec、NARM(在 GRU 上加了注意力)和 BERT4Rec,三个数据集都测了。以 TN 为例:
| 模型 | Prec@1 | Prec@5 | HP@1 | HP@5 |
|---|---|---|---|---|
| GRU4Rec | 14.36 | 27.39 | 47.77 | 46.68 |
| GRU4Rec + MitiHarm | 14.05 | 26.96 | 63.45 | 62.82 |
| NARM | 15.76 | 31.37 | 47.60 | 47.42 |
| NARM + MitiHarm | 15.39 | 30.89 | 66.72 | 64.10 |
(数字来自论文表 IV,单位为 %)
这说明在 TN 上,前 5 条里的健康内容从不到一半升到六成多,命中率只降了零点几个百分点。全部 9 组里,健康指标的相对提升在 12.78% 到 54.01% 之间,最大的一项是 NARM 在 QB 上的 HP@5。准确率有升有降,相对变化多数在几个百分点以内。
消融去掉理由向量或者去掉用户有害偏好向量,健康指标和准确率都比完整版差。训练每轮多花 0.02 到 0.13 秒(TN 上),推理多数情况多不到 0.05 秒。
这对做内容推荐的人意味着什么
先在自己的数据上算一下健康内容的占比,再看推荐结果的占比,检查是否也像论文里那样差不多。
如果确实差不多,说明模型对内容好坏完全不设防。HP 和 HO 这两个指标很容易加进离线评估,尤其 HO,它能看出健康内容是不是都被挤到了列表底部。
想在排序里压有害内容,MitiHarm 的做法可以照搬:给每条内容一句说明「为什么有害或健康」的理由,编码后加一个可调权重的项。要注意的是,线上每条新内容都得先有这句理由,论文里它来自大模型加 5 人投票,换成只用大模型自动生成的效果,论文没有测。λ 要在准确率开始急剧下降之前停下。
局限
「有害」的口径很宽,星座运势这类迷信内容也算在内;这类内容占了多少比例,论文没有拆开统计。5 位标注员之间的 Fleiss Kappa 是 0.71,讽刺和幽默最容易判不一致。
MitiHarm 在测试时也读了人工核对过的理由文字。我的理解是,这相当于把标签信息带进了打分,它比基础模型健康得多,部分原因就在这里。论文没有和「直接按有害标签降权」这种更简单的做法对比。
全部是离线实验,三个数据集都是文本内容,没有线上 A/B。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…