
Meta 新一代广告召回引擎 Andromeda 把接近排序水平的模型用到了召回,对每个符合条件的广告都打分。新版把单个用户塔换成多个专门的用户塔作为专家,广告塔结合实时请求上下文编码,交互层用注意力门控按广告只激活最相关的几个专家,推理计算量比 2024 版少约 300 倍,效果接近排序模型。瓶颈从算力转到了显存带宽和网络传输,所以他们把每个用户和广告之间的取 embedding、跑交互模型、打分三步合进一个 GPU kernel,中间结果留在寄存器和共享内存里,不再反复写进显存;又把定向规则匹配、打分和取前 K 名放到同一台 GPU 机器上,只回传最终结果。这让系统能在同样延迟内给更多广告打分;2025 年以来,它让 Facebook 上的转化提升 2.4%。
做召回的团队值得读这篇,理由不在某个新模型,而在它把“召回该用多复杂的模型”这个问题换了一种问法:先算清楚每打一个广告分要搬多少字节,再决定模型能长多大。它给出的几组数字可以直接拿来对照自家系统:单张 GH200(英伟达的 Grace Hopper 超级芯片,CPU 和 GPU 封装在一起)上交互网络每秒打分超过 100 亿个广告,已经用到显存峰值带宽的约 85%;定向匹配每秒超过 1,000 亿个,比打分快一个数量级;把整条召回链路搬到一台 GPU 机器后,网络流量降了约 100 倍。需要留意的是,这是一篇工程博客,效果只给了“接近排序水平”的定性说法和一个跨两年的累计转化数字,模型细节也只到结构图的程度,复现要靠自己补。
它要解决什么问题?
召回要在几毫秒内从全部符合条件的广告里挑出几百上千个,所以模型一直比排序简单得多。这套分工在候选池不大时没问题,问题出在候选池暴涨之后。生成式 AI 素材工具让广告主快速做出了数以亿计的新广告,召回要筛的池子变大了很多。
用一个小例子看压力从哪来(示意)。一个用户打开信息流,符合定向条件的广告有 50 万个:
| 做法 | 召回打分的广告数 | 每个广告的模型 | 问题 |
|---|---|---|---|
| 早期双塔 | 50 万 | 点积,几十次乘加 | 快,但看不到用户和广告之间的细粒度交互 |
| 召回直接用排序模型 | 50 万 | 排序级网络 | 准,但单次请求的计算量要涨几个数量级 |
| 新版 Andromeda | 50 万 | 只激活少数专家的 MoE 交互 | 想在点积级的速度下拿到接近排序的效果 |
召回的质量对广告收入的影响被放大了:排序再准,也只能在召回给它的候选里挑,好广告在召回阶段被漏掉,后面就再也补不回来。所以 Meta 的目标很直接,在不按比例加 GPU 的前提下,让召回模型更接近排序模型。
整体结构
| 环节 | 做什么 |
|---|---|
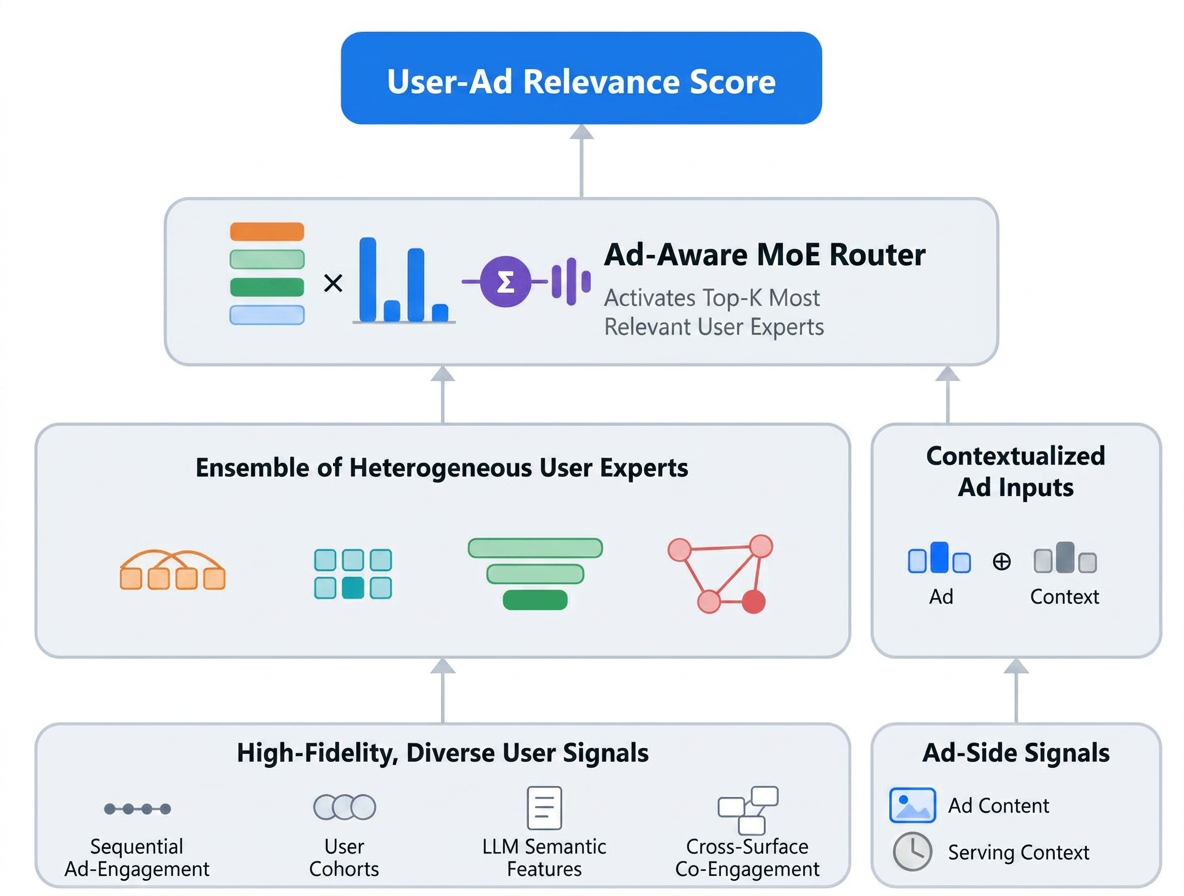
| 用户侧 | 多个专门的用户塔,各管一类信号:广告互动序列、用户群体表示、大模型提取的语义特征、跨产品的共同互动 |
| 广告侧 | 广告内容和实时请求上下文一起编码,交给交互层的是已经带了场景信息的广告表示 |
| 交互层 | 注意力门控网络,按当前广告选出最相关的前 K 个用户专家,只算这几个专家和广告的匹配,再合成一个分数 |
| 打分 kernel | 每个用户和广告组合的取 embedding、跑交互、打分在一个 GPU kernel 里一次做完 |
| 部署 | 定向匹配、打分、取前 K 名都放在同一台 GPU 服务器上,请求只带用户特征和定向条件,返回最终候选 |
模型:把 MoE 搬进召回
旧版召回是一个用户塔对一个广告塔,用户兴趣被压成一个向量。一个人既在看露营装备、又在比较信用卡,一个向量很难同时表达这两件事,点积打分也只能在这个压缩后的向量上比较。
新版把用户侧拆成一组专家。每个专家只吃一类信号,学一种用户兴趣的视角。打分时,路由器先看当前是哪个广告,再决定该听哪几个专家。还是那个用户(示意):假设有 6 个用户专家,路由器每次只选 2 个。
| 候选广告 | 路由器选中的专家 | 理由 |
|---|---|---|
| 一顶帐篷 | 广告互动序列、跨产品共同互动 | 最近点过户外广告,在其他产品里也看过露营内容 |
| 一张信用卡 | 用户群体表示、大模型语义特征 | 同龄同地区人群的转化规律,加上最近浏览内容的语义 |
每个广告只算 2 个专家,而不是 6 个,计算量大约少了三分之二,但每个广告看到的都是最相关的那部分用户兴趣。和大语言模型里的 MoE 相比,区别在于语言模型按 token 路由,这里按广告路由,同一个用户面对不同广告时被不同的专家代表。
博客给出的结果是,新模型的推理计算量比 2024 版召回模型少约 300 倍,效果接近典型“召回加排序”系统里排序模型的水平,单张 GH200 上每秒能给超过 100 亿个广告打分。300 倍听起来反常,模型更强计算反而更少,原因在 MoE 的稀疏激活:大部分专家对某个广告根本不参与计算。
系统:瓶颈为什么从算力变成了带宽
模型变轻以后,真正卡住吞吐的不再是乘加运算,而是数据搬运。2024 版每张卡每秒评估几千万个广告,新需求是每张卡每秒几十亿个,提高了两个数量级。
算一笔账就能看出问题(示意)。如果每个广告在两个 kernel 之间只留下 256 字节的中间结果,写进显存再读出来,每秒 100 亿个广告就是 2.56 TB 的写加 2.56 TB 的读。这个量和 GPU 显存带宽本身在同一量级,计算单元大部分时间在等数据。博客的说法是,多 kernel 流水线里,中间张量造成的显存流量达到每秒数 TB,成了主要瓶颈。
第一个改动是融合 kernel。2024 版只把模型内部的运算融合在一起,取 embedding 和打分之外的系统逻辑仍是单独的 kernel。新版把取 embedding、跑交互网络、打分全部塞进一个 kernel,中间结果只在寄存器和线程块共享内存里流转,从不写回显存。能做到这一点,前提正是模型计算量降了约 300 倍:模型够小,才装得进一个 kernel 的寄存器和共享内存预算。这是模型和系统互相成全的地方,模型设计时就考虑了它要怎么被执行。
第二个改动是把整条链路放到一台机器上。单独测,融合 kernel 已经能每秒处理几十亿个广告。但定向匹配和取前 K 名原本跑在本地 CPU 主机上,候选列表要经网络送到远端 GPU 打分。吞吐到了每秒几十亿,光是这些候选列表就把网络打满了。新做法反过来,请求只带用户特征和定向条件,发给一台 GPU 服务器,定向匹配、打分、取前 K 名全在本机做完,只回传最后的候选。网络流量因此减少约 100 倍,系统重新回到受 GPU 计算限制的状态。
这一步最难的是定向匹配。它要在几十类特征上执行广告主自定义的复杂规则,还要支持广告全天不断新建、修改、下线带来的实时索引更新。原有索引结构是为 CPU 设计的,搬到 GPU 上需要为并行执行重新设计,同时不能丢掉任何一条线上定向语义。
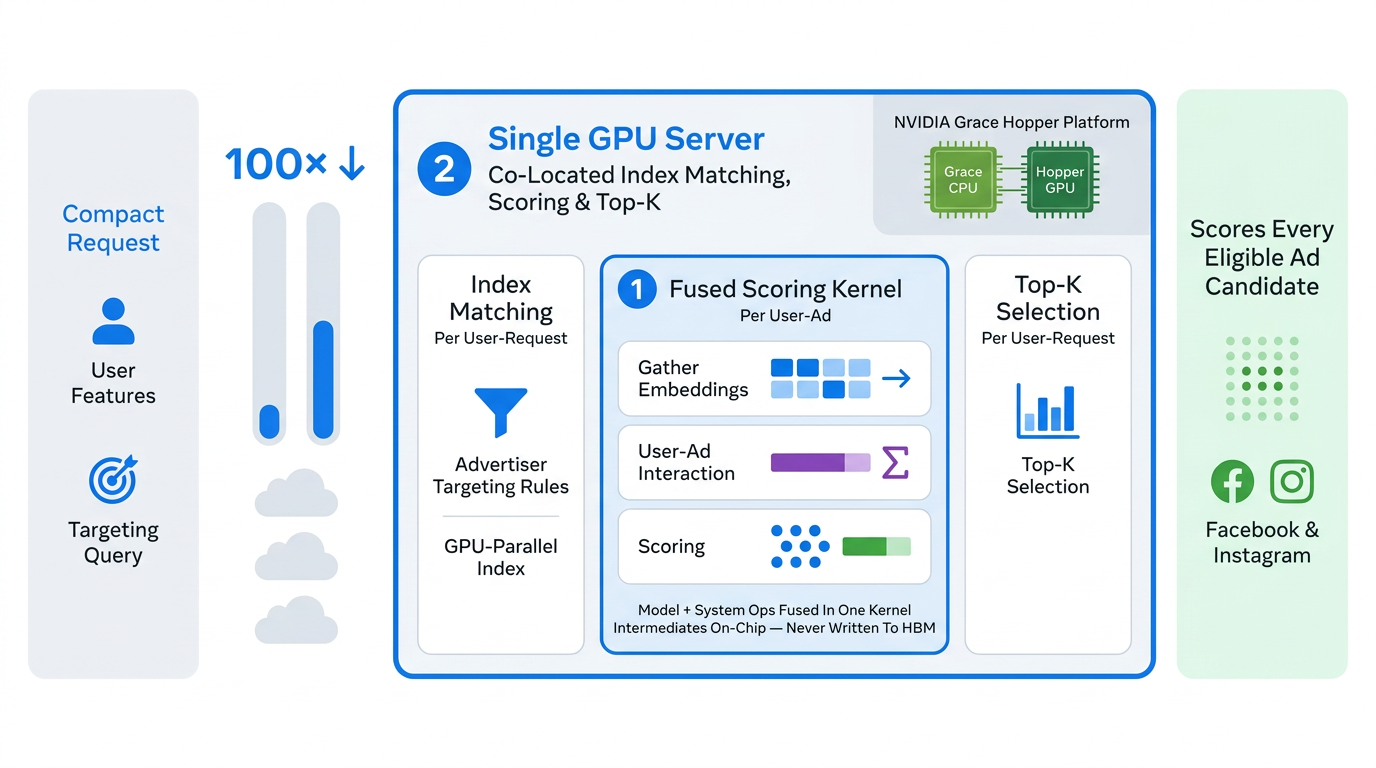
两项改动合在一起,线上流水线在单台 GPU 服务器上每秒处理超过 10 亿个广告,同时给候选池里每个符合条件的广告打分,是 2024 版的约 100 倍。
离硬件上限还有多远
吞吐到了每秒 10 亿以后,Meta 和 NVIDIA 在 2026 年初合作,把流水线的每个部件推向当前硬件的上限,回答“还剩多少空间给更大的模型”。
| 部件 | 优化后吞吐 | 提升 | 说明 |
|---|---|---|---|
| 交互网络(MoE 门控) | 每秒超过 100 亿 | 5.3 倍(原来每秒 24 亿) | 用到显存峰值带宽的约 85% |
| 交互网络 INT8 | 再快最多 2 倍 | 相对 FP16 版本 | 精度与 16 位相当 |
| 定向匹配 | 每秒超过 1,000 亿 | 2 倍以上 | 比打分快一个数量级 |
| 端到端流水线 | 基准测试约每秒 30 亿以上 | 线上(每秒超过 10 亿)的数倍 | 去掉部件之间的数据搬运和间接寻址 |
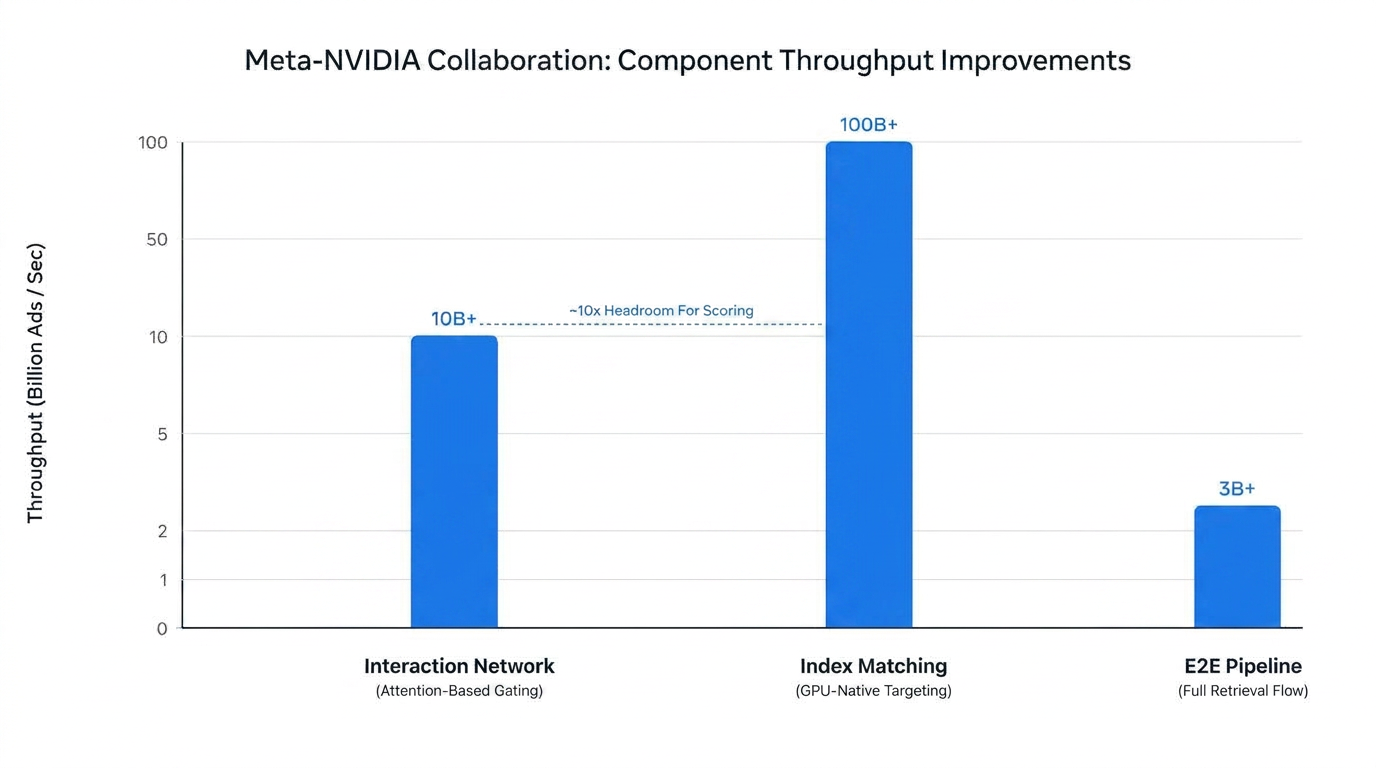
第一行最值得看。门控网络到了每秒 100 亿以上,耗时和同一硬件上最简单的点积打分 kernel 一样。这意味着在显存带宽受限的区间里,多出来的模型复杂度几乎是免费的:反正计算单元在等数据,多做一些乘加不会让它变慢。这也是“协同设计”最直接的证据。
第三行说明定向匹配不会成为瓶颈,它比打分快一个数量级,可以在多条召回通路上重复跑。第四行说明端到端还有空间:部件之间的数据搬运占了不小的一部分端到端延迟,改了数据布局之后,基准吞吐是线上的数倍。
我认为它的局限
第一,效果证据很薄。全文唯一的业务数字是 2025 年以来 Facebook 转化提升 2.4%,这是跨越多个版本的累计结果,无法分出 MoE 结构、融合 kernel、全量打分各自的贡献。“接近排序水平”也只是定性说法,离线指标、对比基线、相对排序模型还差多少,都要读者自己估。
第二,300 倍的计算量下降需要放在语境里看。比较对象是 2024 版召回模型,新模型的专家数、每次激活几个、每个专家多大都只停留在结构图上。别的团队无法据此判断,自己的召回模型换成 MoE 能省多少,只能自己实验。
第三,结论绑定在特定硬件上。“多出来的复杂度几乎免费”成立的前提是显存带宽受限,这在 GH200 上成立;博客自己也提到,换到 Grace Blackwell 后,CPU 和 GPU 的算力配比会显著影响端到端表现,结论要重新验证。没有这类硬件、或者召回量级只到每秒千万的团队,瓶颈很可能不在同一个地方。
一个推荐或广告团队可以怎么试
- 先测清楚现在卡在哪。用性能分析工具看召回打分阶段的显存带宽利用率和计算利用率;带宽接近打满而计算单元空闲,说明加模型复杂度的成本比想象中低。
- 算一笔每个候选的字节账:每打一个分要读写多少中间结果、要在网络上传多少数据。数字大的地方就是融合或合并部署的优先位置。
- 在离线评估里把单用户塔换成几个按信号类型划分的用户专家,加一个按广告选前 K 个专家的门控,K 取 1、2、4 对比召回率和计算量。
- 如果候选列表要跨机器传给打分服务,评估把定向过滤和取前 K 名搬到打分机器上,只回传最终候选,先看网络流量能降多少。
- 最后才考虑写融合 kernel,并用 INT8 做精度对照;这一步工程量最大,收益也最依赖前几步确认瓶颈确实是带宽。
一句话结论
这篇最值得借鉴的是先算清搬运成本、再决定模型大小的做法:当打分受显存带宽限制时,更复杂的交互模型可以几乎不增加耗时,召回和排序之间的效果差距就有了缩小的空间。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。候选池暴涨后,召回质量直接决定排序能看到什么 |
| 方法创新性 | 中高。召回 MoE、全融合 kernel 和单机全链路各自不算全新,组合起来并用带宽利用率证明“复杂度几乎免费”是新的 |
| 实验证据 | 中低。吞吐数字详细,效果只有定性描述和跨两年的累计转化 |
| 工程成本 | 很高。需要自研 GPU 定向索引、融合 kernel 和硬件厂商级别的优化 |
| 是否值得尝试 | 值得借鉴思路:先测带宽和网络字节账;照搬整套方案只适合召回量级到每秒数十亿的团队 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…