目录 · 7 节
1它到底在解决什么问题?2方法:给 MICE 接上 PLAID 存储3训练:从现成的 cross-encoder 改过来4结果:在速度和效果之间占了一个新位置5我认为的局限6一个团队可以怎么试7一句话结论
检索系统常用两种模型给候选文档打分:cross-encoder 把查询和文档拼在一起读,最准但每次查询都要把每个候选完整算一遍;ColBERT 这类“延迟交互”模型提前把文档逐词编码存好,查询时只做简单的相似度比对,很快但没那么准。MICE(一种“文档可预计算的 cross-encoder”)是介于两者之间的重排序结构,可以提前算好文档表示,但原论文没解决这些表示怎么存。这篇论文给出了存法 MICE-P:把文档的每个词向量压到 128 维,用 ColBERT 常用的 PLAID(一种多向量压缩索引)压缩格式存起来,查询时解压再打分。在 13 个公开检索数据集上,1.3 亿参数的 MICE-P 平均排序质量比同级 cross-encoder 只低 0.9 分,每条查询的耗时约为它的四分之一;比 PLAID 版 LateOn 高 0.9 分,但耗时约为它的 3 倍。
这是一篇短的工程论文,价值在于把“理论上可以预计算”的 MICE 真正做成了能跑的检索流水线,并且和 cross-encoder、ColBERT 在同一套训练数据和骨干模型下公平比较。它给想在 cross-encoder 和 ColBERT 之间找折中点的团队提供了一个新选项。但代价也很清楚:索引大小约为 LateOn 的 2 倍,还需要单独维护一个 SPLADE 召回索引;在另一个评测集 LoTTE 上,它没有赢过 LateOn。
它到底在解决什么问题?
先看两种主流打分方式的差别。cross-encoder 把查询和文档拼成一段文本送进模型,模型的每一层里查询词和文档词都能相互看到,所以最准。但文档表示依赖查询,无法提前算,每来一条查询就要对每个候选文档跑一遍完整模型。
ColBERT 反过来,文档和查询分开编码。文档的每个词向量可以离线算好存进索引,查询时只需编码查询,再对每个查询词找文档里最相似的那个词,把这些相似度加起来,这一步叫 MaxSim。它快,但查询和文档只在最后做一次简单比对,效果通常不如 cross-encoder。
MICE 想取两者之长。它把模型分成两段:前面若干层是“上下文化层”,查询和文档各自编码,文档这部分可以提前算好;后面几层是“交互层”,查询词用注意力去看已经冻结的文档词表示,比 MaxSim 能捕捉更丰富的匹配信号。原论文只在重排序里验证了效果,效率只做了理论分析,没有给出在整个文档库上存储和检索这些词表示的办法。
方法:给 MICE 接上 PLAID 存储
PLAID 是 ColBERT 常用的索引。它先用 k-means 把所有词向量聚成若干中心,每个词向量只存“最近的中心编号加上和中心的残差”,残差再量化成几个比特,这样能大幅压缩存储。
MICE-P 的改动有三点。第一,在上下文化层输出后加一个“瓶颈层”,用线性投影把每个文档词向量从模型维度压到 128 维,再做一次归一化,因为 PLAID 的实现要求向量归一化。第二,压好的向量用 PLAID 的残差格式存起来。查询时从存储里解压出候选文档的向量,再用一个线性层投影回原来的维度,交给交互层打分。第三,MICE-P 没有用 PLAID 自带的检索流程,因为它绑定了 MaxSim 打分;候选文档仍由一个单独的 SPLADE 模型召回前 100 条。
量化比特数是关键参数。作者在 5 个数据集上测了不同比特数相对不压缩的排序质量下降。
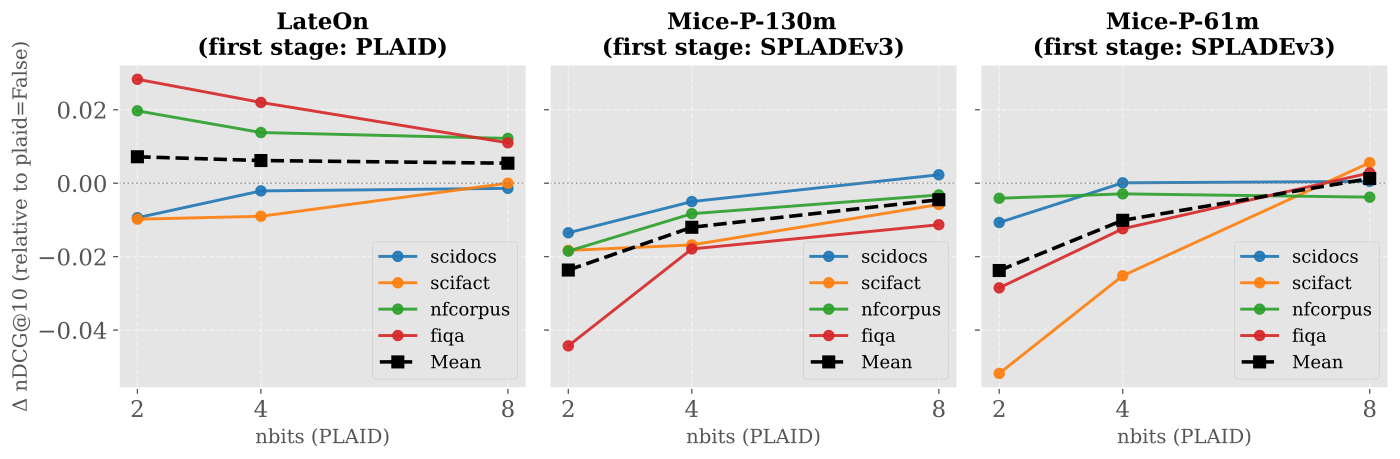
LateOn 压到 2 比特几乎不掉分。MICE-P 在 2 比特时平均下降超过 0.03(满分为 1),在 FiQA 和 ArguAna 上下降约 0.05,所以作者选了 4 比特。这意味着 MICE-P 每个向量要多占一倍的残差存储。我的猜测是,MICE-P 的交互层要用注意力细看每个文档词向量,对向量的精度更敏感;ColBERT 只取最相似的那个词,粗一点的近似影响不大。
训练:从现成的 cross-encoder 改过来
原版 MICE 是从预训练编码器直接蒸馏训练的。这篇论文换了一种做法:从已经训练好的 Ettin cross-encoder 出发,分两步改造。第一步,把 cross-encoder 的权重套进 MICE 结构,继续在排序任务上训练,让模型适应“前几层查询和文档互相看不到”的新结构。第二步,加上瓶颈层,只训练瓶颈层和交互层,冻结前面的上下文化层,因为作者发现梯度穿过新加的瓶颈层会把前面的层训坏。
训练数据是 1.43 亿条查询和段落对,每对都由一个更大的 cross-encoder 打了分,学生模型用均方误差去拟合这些分数。为了公平,作者用同一份数据、同样的 Ettin 骨干训练了自己的 ColBERT 版本。复现的是 6800 万参数的 Ettin cross-encoder,在 13 个数据集上的平均分是 58.0,和官方发布的同尺寸模型 58.1 基本一致,说明训练流程可靠。下表里的 Ettin cross-encoder 则是官方发布的 1.5 亿参数版本。
结果:在速度和效果之间占了一个新位置
主要评测用 BEIR13,也就是 BEIR 基准里去除了和训练数据重叠部分的 13 个数据集。为了让不同方案在同一把尺子上比较,指标统一用前 10 条的排序质量 nDCG@10,下表的分数乘了 100。延迟在 DBPedia-Entity 数据集上测量,它有 100 万篇文档和 349 条查询,取 5 次运行的平均。表里的延迟是从论文图 2 读出的近似值。另一个评测集 LoTTE 由论坛问答组成,常用来评估 ColBERT 类模型,这里作为领域外的补充。
| 方案 | 参数量 | BEIR13 平均分 | LoTTE 平均分 | 每条查询延迟 |
|---|---|---|---|---|
| Ettin cross-encoder(SPLADE 召回后重排) | 1.5 亿 | 58.8 | 59.1 | 约 830 毫秒 |
| MICE-P,不用 PLAID 存储 | 1.3 亿 | 58.5 | 58.5 | 约 545 毫秒 |
| MICE-P,用 PLAID 存储 | 1.3 亿 | 57.9 | 57.4 | 约 200 毫秒 |
| LateOn(ColBERT 类,用 PLAID 检索) | 1.49 亿 | 57.0 | 58.2 | 约 60 毫秒 |
| LateOn(SPLADE 召回后重排) | 1.49 亿 | 58.6 | 61.3 | 约 860 毫秒 |
上表说明,用 PLAID 存储后 MICE-P 在 BEIR13 上只比不压缩版低 0.6 分,延迟却从约 545 毫秒降到约 200 毫秒。和 cross-encoder 比,它损失 0.9 分,速度快约 4 倍;和 PLAID 版 LateOn 比,它高 0.9 分,但慢约 3 倍。在论文的效果和延迟散点图上,它填补了 LateOn 和 cross-encoder 之间的空白区域。作者还给出,不压缩时 MICE 的计算量约为对应 cross-encoder 的 60%。
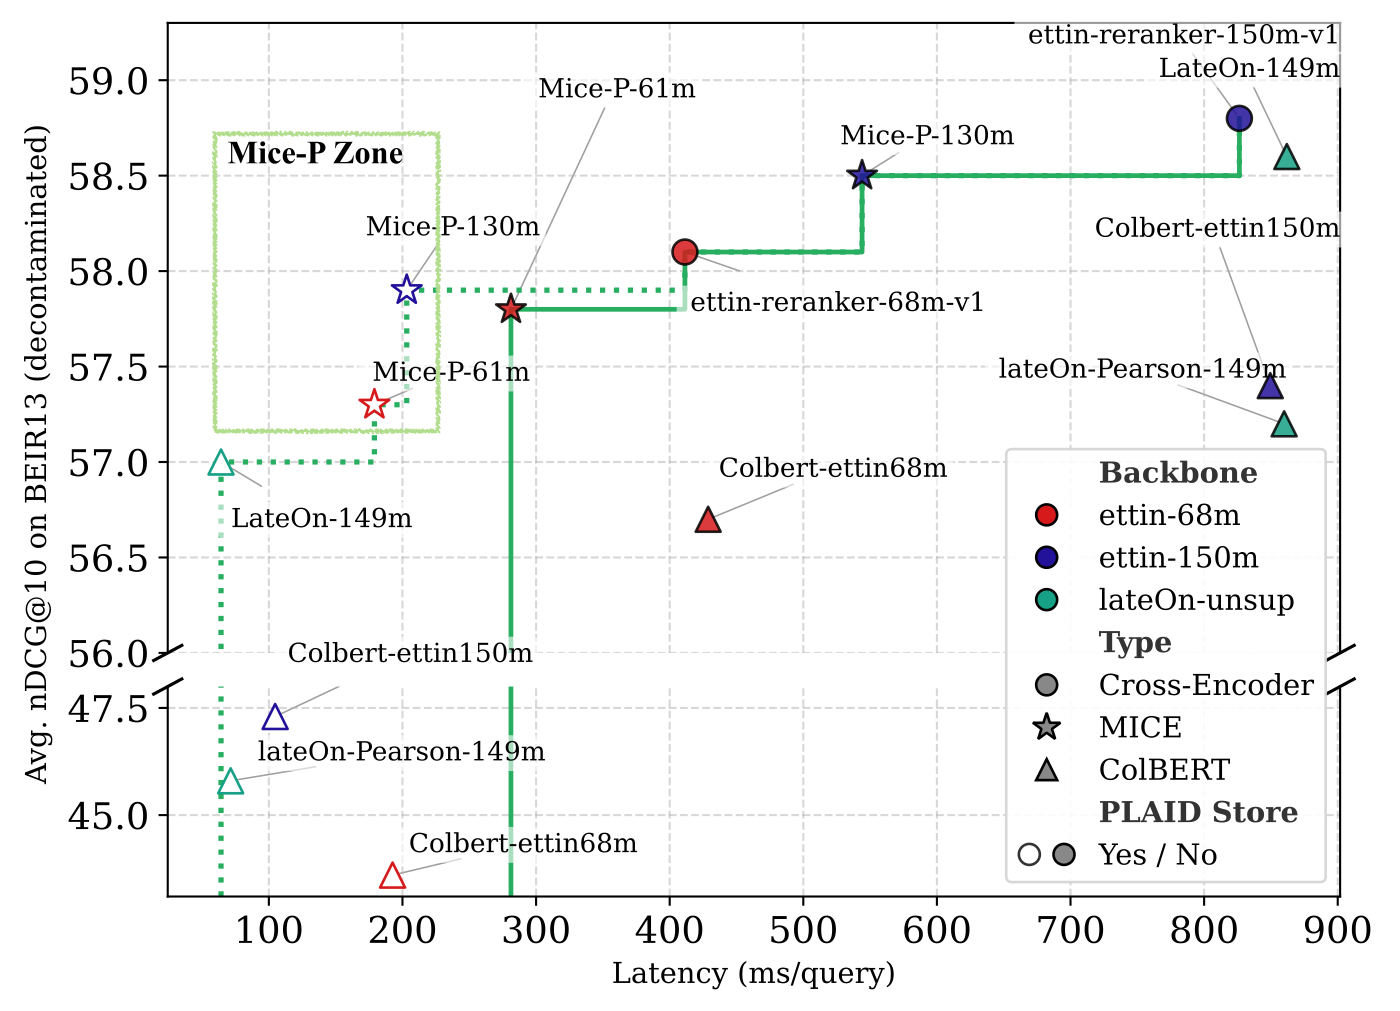
还有一个附带发现。作者自己训练的 ColBERT 模型在 SPLADE 召回后重排时表现不错,但改用 PLAID 自己做召回时大幅下降,1.5 亿参数版从 57.4 掉到 47.3。官方 LateOn 降得少得多。作者推测原因是自己的 ColBERT 用了只拟合分数的损失函数,没有用对比学习和难负例,词向量的分布不够分散,PLAID 的聚类召回因此失效。
我认为的局限
第一,存储翻倍。在 500 万文档的 Climate-FEVER 上,MICE-P 的总索引是 100.1 GB,其中 PLAID 存储 90.2 GB、SPLADE 索引 9.9 GB;LateOn 是 51.8 GB。主要原因是 MICE-P 需要 4 比特量化而不是 2 比特。
第二,优势不稳定。在 LoTTE 上,PLAID 存储版 MICE-P 得 57.4,低于 PLAID 版 LateOn 的 58.2,也低于重排版 LateOn 的 61.3。所以“比 ColBERT 更准”的结论目前只在 BEIR13 上成立。
第三,还不是真正的一体化检索。召回仍依赖单独的 SPLADE,系统里要维护两套索引。作者也把“直接用 PLAID 召回”列为后续工作。
一个团队可以怎么试
- 如果线上用 cross-encoder 重排、延迟压力大,可以把 MICE-P 当作替代方案评估:同样从 SPLADE 或其他召回取前 100 条,比较延迟和排序质量。
- 先在自己的数据上测量化比特数,论文显示 MICE-P 对 2 比特很敏感,4 比特更稳。
- 评估时同时看两类数据集,避免只在一个评测集上占优。
- 作者公开了代码、配置和全部模型,可以直接从 Ettin cross-encoder 按两步训练法改造。
一句话结论
MICE-P 让“文档可预计算的 cross-encoder”真正跑了起来,在 BEIR13 上做到接近 cross-encoder 的效果、约四分之一的耗时,代价是索引约大一倍、还要额外的召回索引。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中。效果和速度的折中是检索系统的长期问题 |
| 方法创新性 | 中低。主要是把已有的 MICE 和 PLAID 组合起来,加上训练技巧 |
| 实验证据 | 中。同骨干、同数据的公平对比,但只测了一个数据集的延迟,LoTTE 上不占优 |
| 工程成本 | 中。需要维护 SPLADE 和 PLAID 两套索引,存储约为 ColBERT 的 2 倍 |
| 是否值得尝试 | cross-encoder 延迟太高的团队值得试 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…