目录 · 9 节
1它到底在解决什么问题?2先看全景:不确定性集中在第一位3机制:一次注意力,四个 MLP4主实验:效果持平,吞吐快近 9 倍5消融:哪些部件不能省6换成 7B 大模型当教师会怎样7我认为它的局限8一个推荐团队可以怎么试9一句话结论和评价分享 SHARE

做生成式推荐、正在为 beam search 解码延迟发愁的团队值得读。生成式推荐把每个物品表示成几个离散码组成的 Semantic ID(SID),推理时要逐位生成、每位都跑一遍 Transformer 解码器,beam 越宽越慢。这篇的核心思想一句话:SID 的不确定性几乎都集中在前一两位,后面几位只剩一两个合法选择,所以不需要每一步都跑注意力;只在开头对用户历史做一次注意力读出,之后每一位用一个独立的小 MLP、输入“用户上下文 + 已生成的前缀”来预测,再从原 Transformer 蒸馏训练。在 3 个 Amazon 数据集上,它的 NDCG@10 和教师模型 TIGER 持平或略高,吞吐快 8.74 倍,显存峰值降 95.7%。我认为这个观察和做法都很干净,但实验用的教师只有 459 万参数、物品只有约 2.5 万个;换成 7B 的 LC-Rec 当教师时,它只能恢复教师 83% 到 98% 的效果,工业规模下的收益还要自己验证。
它到底在解决什么问题?
先看一个示意场景。一个短视频平台用生成式推荐做召回:每个物品的 SID 是 4 位码,每位从 256 个码里选;要给一个用户出前 10 个候选,beam 宽度设成 50。解码时每一位都要对 50 条 beam 各跑一遍 4 层 Transformer 解码器,4 位下来就是 4×50×4=800 次解码器层计算,每次还要对用户历史做一遍交叉注意力。而传统的双塔或序列模型,一次前向就能给出前 K 个结果。
加速大模型推理的常见办法,搬到这里都不太合适:
| 办法 | 在生成式推荐里的问题 |
|---|---|
| 投机解码(小模型起草、大模型验证) | 要同时验证并排序几十条候选序列;教师本来就很小时,起草模型的开销摊不薄 |
| 多 token 并行、非自回归解码 | 通常要联合微调教师,或依赖特定的 SID 生成方式 |
| 蒸馏成更小的 Transformer | 模型变小了,但逐位解码的计算结构没变 |
作者注意到生成式推荐和大模型生成的一个关键区别:输出很短、长度固定,而且合法的码组合非常有限。
先看全景:不确定性集中在第一位
作者统计了合法前缀之后,下一位平均还有几个合法选择。在 Instruments 数据集(约 2.5 万个物品)上,4 位的平均分支数是 256、约 38、2.2、约 1.2,另外两个数据集几乎一样。也就是说,第一位是真正的 256 选 1;定了前两位,剩下基本就确定了。
作者用两组实验验证“解码器太重了”:
| 实验(Instruments) | NDCG@10 | 相对教师或基线 |
|---|---|---|
| TIGER 教师(4 层解码器) | 0.0323 | — |
| 前 3 位由教师生成,1 层学生只预测第 4 位 | 0.0323 | 持平 |
| 4 位全由 1 层学生预测 | 0.0318 | -1.5% |
| 1 层学生去掉前缀自注意力 | 0.0310 | 相对 1 层学生 -5.4% |
| 1 层学生去掉对用户历史的交叉注意力 | 0.0131 | 相对 1 层学生 -60.0% |
这说明两件事:解码器的深度大部分是多余的,1 层就差不多;但“看用户历史”和“看已生成的前缀”这两样信息不能丢,尤其是前者。所以目标很明确:保留这两种信息,同时去掉每一步都重复做的注意力计算。
机制:一次注意力,四个 MLP
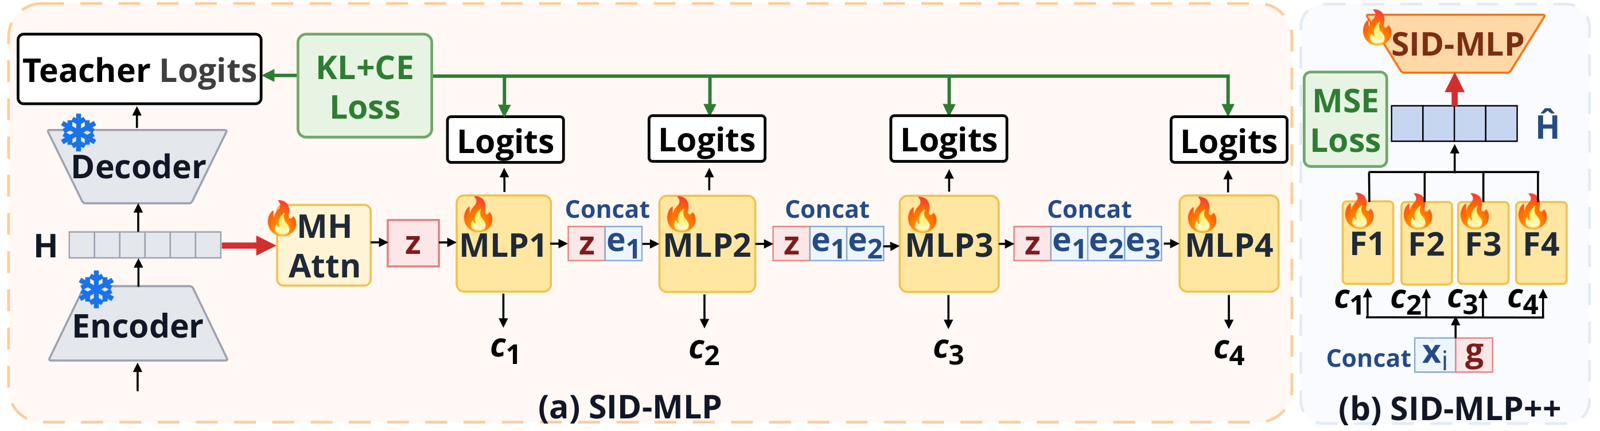
第一步,对用户历史只做一次注意力读出。冻结的 TIGER 编码器把用户历史编码成一串隐状态。Sid-Mlp 先把这串隐状态取平均、投影成一个查询向量,用它对整串隐状态做一次多头注意力,再接一层前馈网络,得到上下文向量 z。z 只算一次,之后所有位、所有 beam 都复用它。原来的解码器在每一位、每条 beam、每一层都要对用户历史做交叉注意力,这部分开销从“位数 × beam 宽度 × 层数”次降到 1 次。
第二步,每一位一个专属的 MLP。预测第 t 位时,把 z 和前面已生成的 t−1 位的嵌入拼接起来,送进第 t 个 MLP(一个隐藏层),输出 256 个码的分数。嵌入直接取自教师,不训练。用前面的场景手算一遍:第 1 位输入只有 z;第 2 位输入是 [z; e(第 1 位)];第 3 位是 [z; e(第 1 位); e(第 2 位)];第 4 位再多拼一个。50 条 beam 在每一位都只是一次批量矩阵乘法,不需要维护 KV 缓存,也没有循环状态要复制和搬运。
为什么每位要用不同的 MLP?因为每一位的码分布完全不同。消融显示,4 位共享一个 MLP,NDCG@10 掉 6% 到 10%。为什么前缀要拼接而不是相加?相加会丢掉顺序,掉 2% 到 3%。
第三步,从教师蒸馏。训练时冻结 TIGER 编码器,只训练那一次注意力读出和 4 个 MLP。每一位的损失是两项加权:一项是和教师在这一位输出分布的 KL 散度(带温度),另一项是和真实码的交叉熵。训练时前缀用真实的 SID(teacher forcing),所以 4 位可以并行算。推理时用带约束的 beam search:根据物品到 SID 的固定映射建一张合法前缀表,不存在的前缀直接剪掉。 Hoot 说

训练:teacher forcing
- 第 1 位
- z → MLP₁
- 第 2 位
- [z; e(真码₁)] → MLP₂
- 第 3、4 位
- 同样拼真码
- 4 位之间
- 互不等待,一次并行算
每位的损失 = 对教师分布的 KL + 对真码的交叉熵。
推理:约束 beam search
- 第 1 位
- z → MLP₁ → 256 个分数,留 50 条
- 第 2 位
- 50 条各拼自己的码₁ → 50 × 256 = 12800 个候选
- 剪枝
- 查合法前缀表,没有物品的前缀直接删,再留 50
- 第 3、4 位
- 必须等上一位,逐位重复
前缀可能偏离真实值:某条 beam 第 1 位选错但仍合法,MLP₂ 收到的就不是这个样本的真实前缀,而训练时它只见过真实前缀。
第 2 列的逐位过程是按正文描述画的示意;每位 256 个码、50 条 beam 取自正文。脚注“前缀可能偏离真实值”是我们的提醒,论文没有讨论。 出处: 论文 Sid-Mlp:一次注意力读出 z,第 t 位 MLP 输入 [z; e(前 t−1 位)];训练 teacher forcing + KL 蒸馏 + 交叉熵;推理带合法前缀表的约束 beam search
Sid-Mlp++ 进一步把编码器也换掉:每层先对所有 token 的状态取平均,得到一个全局向量,再把每个 token 的状态和这个全局向量拼接,按它是第几位码交给 4 个 MLP 中对应的一个做残差更新。直接用输出分布蒸馏训练这个编码器不稳定,所以分两步:先用均方误差拟合教师编码器的隐状态,再冻结它、训练后面的 Sid-Mlp。
主实验:效果持平,吞吐快近 9 倍
数据集是 Amazon Reviews 2023 的三个类目,每个约 2.5 万个物品。教师是 TIGER(4 层 T5、459 万参数)。吞吐按批大小 32、beam 宽度 50 测端到端每秒样本数;加速比相对于开了 KV 缓存的 TIGER,因为这是教师在实际部署时的合理配置,比不开缓存的版本(0.75 倍)更难超越。Sid-Mlp 的指标是 3 个随机种子的平均。
| 方法 | 吞吐(样本/秒) | 加速比 | Instruments N@10 | Scientific N@10 | Games N@10 |
|---|---|---|---|---|---|
| TIGER(带 KV 缓存) | 424 | 1.00× | 0.0323 | 0.0243 | 0.0512 |
| Mamba2 解码器 | 517 | 1.22× | 0.0326 | 0.0247 | 0.0496 |
| AtSpeed-S(投机解码) | 286 | 0.68× | 0.0323 | 0.0243 | 0.0512 |
| EARN(压缩编码器状态) | 822 | 1.94× | 0.0319 | 0.0239 | 0.0486 |
| NEZHA(自起草) | 3,082 | 7.27× | 0.0308 | 0.0212 | 0.0467 |
| Sid-Mlp | 3,706 | 8.74× | 0.0332 | 0.0250 | 0.0512 |
| Sid-Mlp++ | 4,347 | 10.25× | 0.0327 | 0.0244 | 0.0486 |
这说明加速主要来自去掉重复的解码器计算,而不是模型变小。几个对照很有说服力:投机解码反而更慢,因为教师只有 459 万参数、只解 4 步,起草和验证的开销摊不开;Mamba2 这类线性复杂度的序列模型也只快 1.2 倍,因为每一步都要为每条 beam 更新、复制、收集循环状态,搬状态的时间占了大头;NEZHA(让模型自己起草后续码的加速方法)快了 7 倍多,但在 Scientific 上 NDCG@10 掉了约 13%。Sid-Mlp 在三个数据集上都不低于教师,Instruments 上还略高;按我的理解,这和教师软标签在稀疏的合法 SID 空间里起到的平滑作用有关,作者在消融里也给了佐证:去掉 KL 项只用真实码训练,掉 2.7% 到 6.6%。
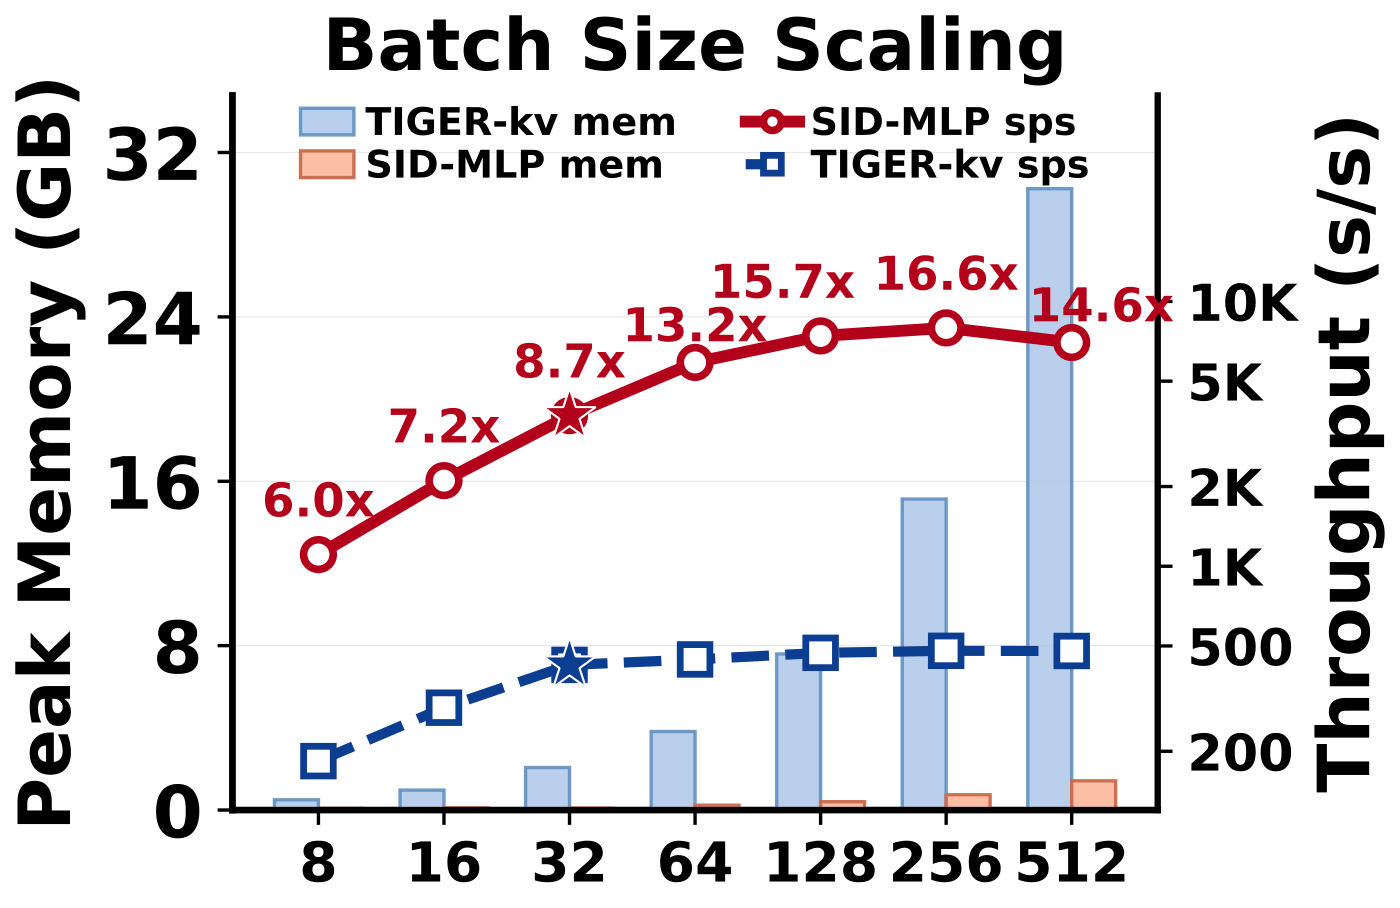
上图说明,主表里的 8.74 倍是在批大小 32 下测的,批越大差距越大,因为 Sid-Mlp 在拿到上下文之后只剩批量矩阵乘法。beam 宽度从 10 加到 50 时,TIGER 的吞吐掉了 37%,Sid-Mlp 基本不变。换成用 RQ-KMeans、RQ-VAE 等三种不同方法生成 SID 的教师,Sid-Mlp 都能恢复教师 99.6% 到 102.9% 的 NDCG@10。
消融:哪些部件不能省
| 变体 | Instruments N@10 变化 | Scientific | Games |
|---|---|---|---|
| 不输入前缀,4 位都只看 z 并行预测 | -72.0% | -65.5% | -64.3% |
| 4 位共享一个 MLP(前缀相加) | -9.3% | -10.0% | -6.1% |
| 去掉那一次多头注意力,改成平均后线性投影 | -4.8% | -6.4% | -3.1% |
| 每一位都重新做一次注意力读出 | -0.4% | -0.3% | +0.7% |
| 去掉 KL 蒸馏,只用真实码训练 | -2.7% | -4.0% | -6.6% |
这张表说明最关键的是前缀:没有它,模型就退化成“猜 4 个互不相关的码”,掉六到七成。其次是那一次多头注意力,换成简单平均会掉 3% 到 6%。而每一位都重做注意力几乎没有收益,这正好印证了作者的出发点:注意力只需要做一次。
换成 7B 大模型当教师会怎样
为了回应“教师太小”的疑问,作者在附录里把同样的结构接到 LC-Rec 上。LC-Rec 是用 LLaMA-2 7B 做的生成式推荐,有 32 层。适配方法是:从冻结模型的第 8 层取用户历史各 token 的键和值,从最后一层取提示最后一个 token 的隐状态当查询,再用可学习的线性层把 4096 维投影到 768 维,后面的 MLP、约束 beam search 和损失都不变。为什么取第 8 层?作者引用了已有观察:大模型较深的层对历史 token 的注意力很稀疏、冗余,早期层保留的历史信息更完整。
| 指标 | Sid-Mlp 接 LC-Rec | NEZHA 接 LC-Rec |
|---|---|---|
| 可训练参数 | 4410 万(教师的 0.6%) | 68 亿 |
| 恢复教师效果 | 83.3% 到 97.5% | 65.0% 到 82.7% |
| 端到端吞吐加速 | 17.9 倍 | — |
这说明在大教师上,这套结构依然比同类方法省得多、保留得多,但已经不再是“无损”。端到端吞吐只有每秒 38 个样本,因为 7B 模型的预填充(把整段提示过一遍)仍然要跑;只看解码阶段能快 1262.8 倍,意味着瓶颈完全转移到了编码一侧。
我认为它的局限
第一,规模太小。教师只有 459 万参数,每个数据集约 2.5 万个物品,所以第 3、4 位几乎只剩一个选择。工业物品库常有上千万物品,后几位的分支数会大得多,“只有第一位难”这个前提要重新测。上一节 7B 教师的结果已经显示,教师一换成大模型,它就不再是无损的。
第二,Sid-Mlp++ 的收益不划算。它比 Sid-Mlp 只多快约 17%(10.25 倍对 8.74 倍),但在 Games 上 NDCG@10 从 0.0512 掉到 0.0486,约 5%。这说明编码器才是承载用户历史信息的地方,替换它的代价比替换解码器大得多,所以在大多数场景,保留教师编码器更稳妥。
第三,评测是离线 GPU 吞吐。主表的加速比在批大小 32 下测得,换个批大小就会是 6 倍到 16.6 倍之间的另一个数;线上延迟还取决于请求能否攒批、编码器占总耗时的比例等,这些都要在自己的服务上测。
一个推荐团队可以怎么试
- 先在自己的物品库上统计每一位 SID 的平均分支数。如果后几位也有几十个选择,这个方法的前提就不成立,收益会打折扣。
- 冻结现有生成式模型的编码器,按论文的结构加一次多头注意力读出和每位一个单隐藏层的 MLP,用教师的输出分布加真实码训练。代码已开源。
- 先离线比较 NDCG 或 Recall,再在线上服务的真实批大小和 beam 宽度下测延迟和显存。
- 效果持平后,再考虑是否值得进一步替换编码器。
一句话结论和评价
这篇最值得带走的是:SID 的难度集中在第一位,所以对用户历史的注意力只需要做一次,之后每一位用一个看着前缀的小 MLP 就够了,在小规模数据上能做到效果不降、吞吐快近 9 倍。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。解码延迟是生成式推荐上线的主要障碍之一 |
| 方法创新性 | 中高。先量化分支数再据此简化结构,思路清楚;具体部件都很简单 |
| 实验证据 | 中。对照全面、消融细致、有 3 个种子;但教师和物品库都很小 |
| 工程成本 | 低。冻结教师,只训练一次注意力和 4 个 MLP,代码开源 |
| 是否值得尝试 | 值得,先测自己物品库的分支数 |
| 适用场景 | SID 较短、物品库不太大的生成式召回;物品库很大时要先验证 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…