分享 SHARE

这篇是美团外卖推荐团队 2025 年 5 月的技术博客,适合正在考虑把排序模型换成 Meta GR(生成式推荐)那类 Transformer 架构的团队读。它的核心思想一句话:沿用 Meta 的 HSTU 序列编码结构,但不扔掉原来 DLRM(深度学习推荐模型,即传统的“特征拼接加多层网络”排序模型)里的交叉特征,同时把同一个用户的所有曝光压成一行训练数据。结果是单样本前向推理的计算量(博客的口径是线上给一个候选打一次分)涨到原来的 65 倍,训练成本却和原模型持平,外卖首页列表订单量提升 1.22%,团队称这是近两年单次优化里最大的收益。2025 年 4 月底已在外卖首页、频道页、小程序全量。
它解决什么问题?
美团外卖的排序模型已经按 DLRM 范式迭代了近十年。博客把这段历史分成两个阶段。2018 到 2022 年主要加大“交叉模块”,也就是把场景、用户画像、行为序列、候选商家的特征拼在一起,交给 MoE、DCN 这类网络学习非线性组合。问题是加到一定程度收益就不明显,而且训练多花一倍算力,推理也要多花一倍。2023 年转向加大“用户模块”:先用场景和画像生成多个 query,对行为序列做注意力,再接一个 16 个专家的 MoE。用户模块对同一个用户只算一次、再广播给所有候选,所以推理成本只涨 24%,模型计算量涨了 182%,订单量提升 0.60%。
但团队认为两条路都碰到了天花板:主要靠多层网络(MLP)学特征共现,注意力用得少;训练成本高,优化空间小。Meta 的 GR 用一个统一的 Transformer 读完整的用户行为序列,正好解决这两个问题。可完全照搬 GR 又不行,因为它不用任何交叉特征。外卖的特点是点击率低、复购率高,“这个用户在这家店下过几单”这类统计交叉特征非常重要。博客的实验显示,MTGR-small 去掉交叉特征后,CTR GAUC 下降 1.25 个百分点,CTCVR GAUC(点击并下单的分用户 AUC)下降 0.91 个百分点。作为对比,最大的 MTGR-large 相对旧模型的整体提升是 1.53 和 2.88 个百分点,可见交叉特征的分量。
所以 MTGR(Meituan Generative Recommendation,美团生成式推荐)选的是“混合式”路线:用生成式的数据组织和 HSTU 编码,但直接对每个曝光商家输出点击率和转化率,并保留全部旧特征。
模型怎么搭
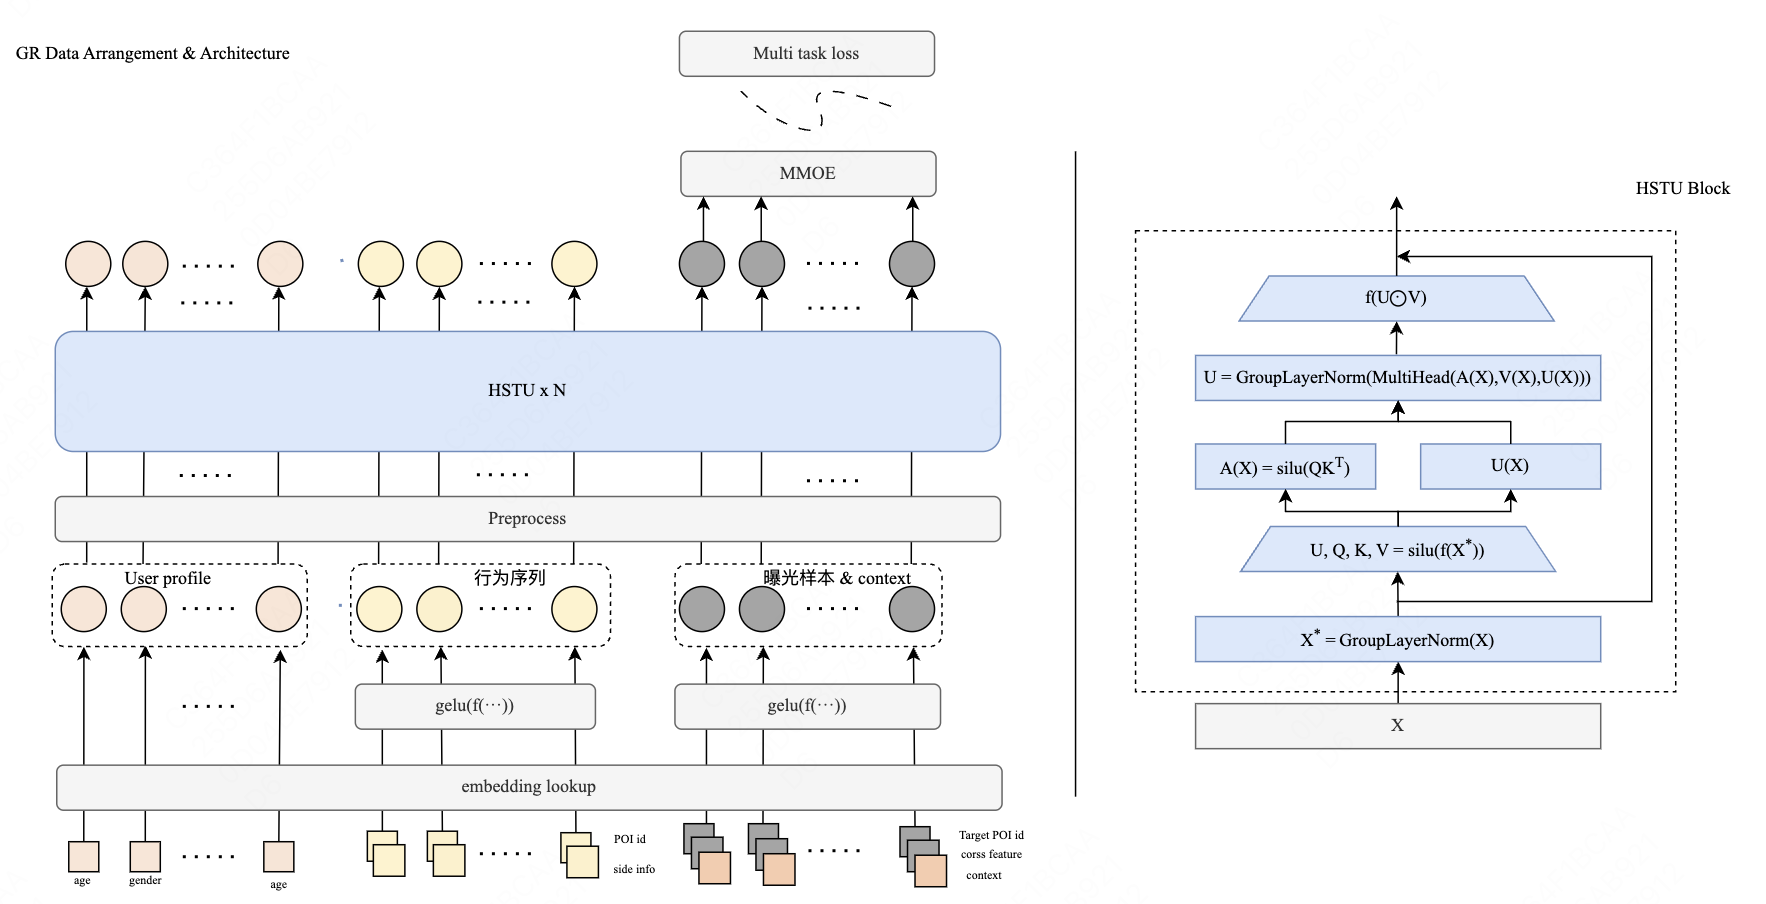
先把一条样本拆成 token。用户画像里的每个特征(登录频次、购买频次等)各是一个 token。行为序列里的每个商家,把商家 ID 和它的附加信息(品类标签、品牌、历史订单数、当次停留时长等)的 embedding 拼起来,经过一个非线性映射变成一个 token。每个待打分的曝光商家也一样,把商家 ID、附加信息、交叉特征、时间地点等场景信息拼成一个 token。交叉特征就这样跟着候选商家进了模型。
接下来用 HSTU 统一编码这些 token。HSTU 是 Meta 为推荐设计的 Transformer 变体,每一层先用一个线性层加 SiLU 激活,从输入同时得到 U、Q、K、V 四组向量。注意力权重是 SiLU(QKᵀ),不做 softmax 归一化;用它对 V 加权求和,聚合结果做归一化后,再和门控向量 U 逐元素相乘,最后经过一个线性层输出。MTGR 在它上面改了两处。
第一处是 Group LayerNorm。为什么需要?普通大模型的 token 都是词,处在同一个语义空间;MTGR 的 token 有用户画像、行为、候选商家几类,数值分布差别很大。Group LayerNorm 给每类 token 一套自己的归一化参数,让它们先对齐到可比的尺度再交互。去掉它,MTGR-small 的 CTR GAUC 和 CTCVR GAUC 分别下降 0.17 和 0.18 个百分点。
第二处是动态混合掩码,解决的是“训练时偷看未来”的问题,下一节单独讲。
模型尺寸的设置也值得一提。加深加宽模型的同时,embedding 维度也跟着放大:一个 token 由 k 个特征拼成,每个特征的 embedding 维度设成 d_model 除以 k 附近的整数。比如 d_model 是 768、一个 token 由 4 个特征组成,每个特征大约 192 维。
训练数据怎么组织,掩码怎么设
传统 DLRM 的训练数据是一个曝光一行。示意例子:某用户当天被曝光了 20 家店,行为序列长 1000,DLRM 要存 20 行,每行都带一份同样的 1000 长序列,训练时也要把这份序列重复编码 20 遍,序列长短不一时还要补齐(padding)。MTGR 把同一个用户的 20 个曝光压成一行:1000 个行为 token 加 20 个候选 token 一起编码,用户这部分只算一次;再配合变长张量(JaggedTensor)和变长 HSTU 算子,彻底去掉补齐带来的无效计算。
压成一行之后就有了新问题:同一天的曝光有先有后,用户当天的实时行为也有先有后。下午 6 点的曝光如果在训练时“看到”了晚上 8 点的点击,就是穿越。为此数据里保存了每个行为和每个曝光的原始时间戳,用来生成掩码。
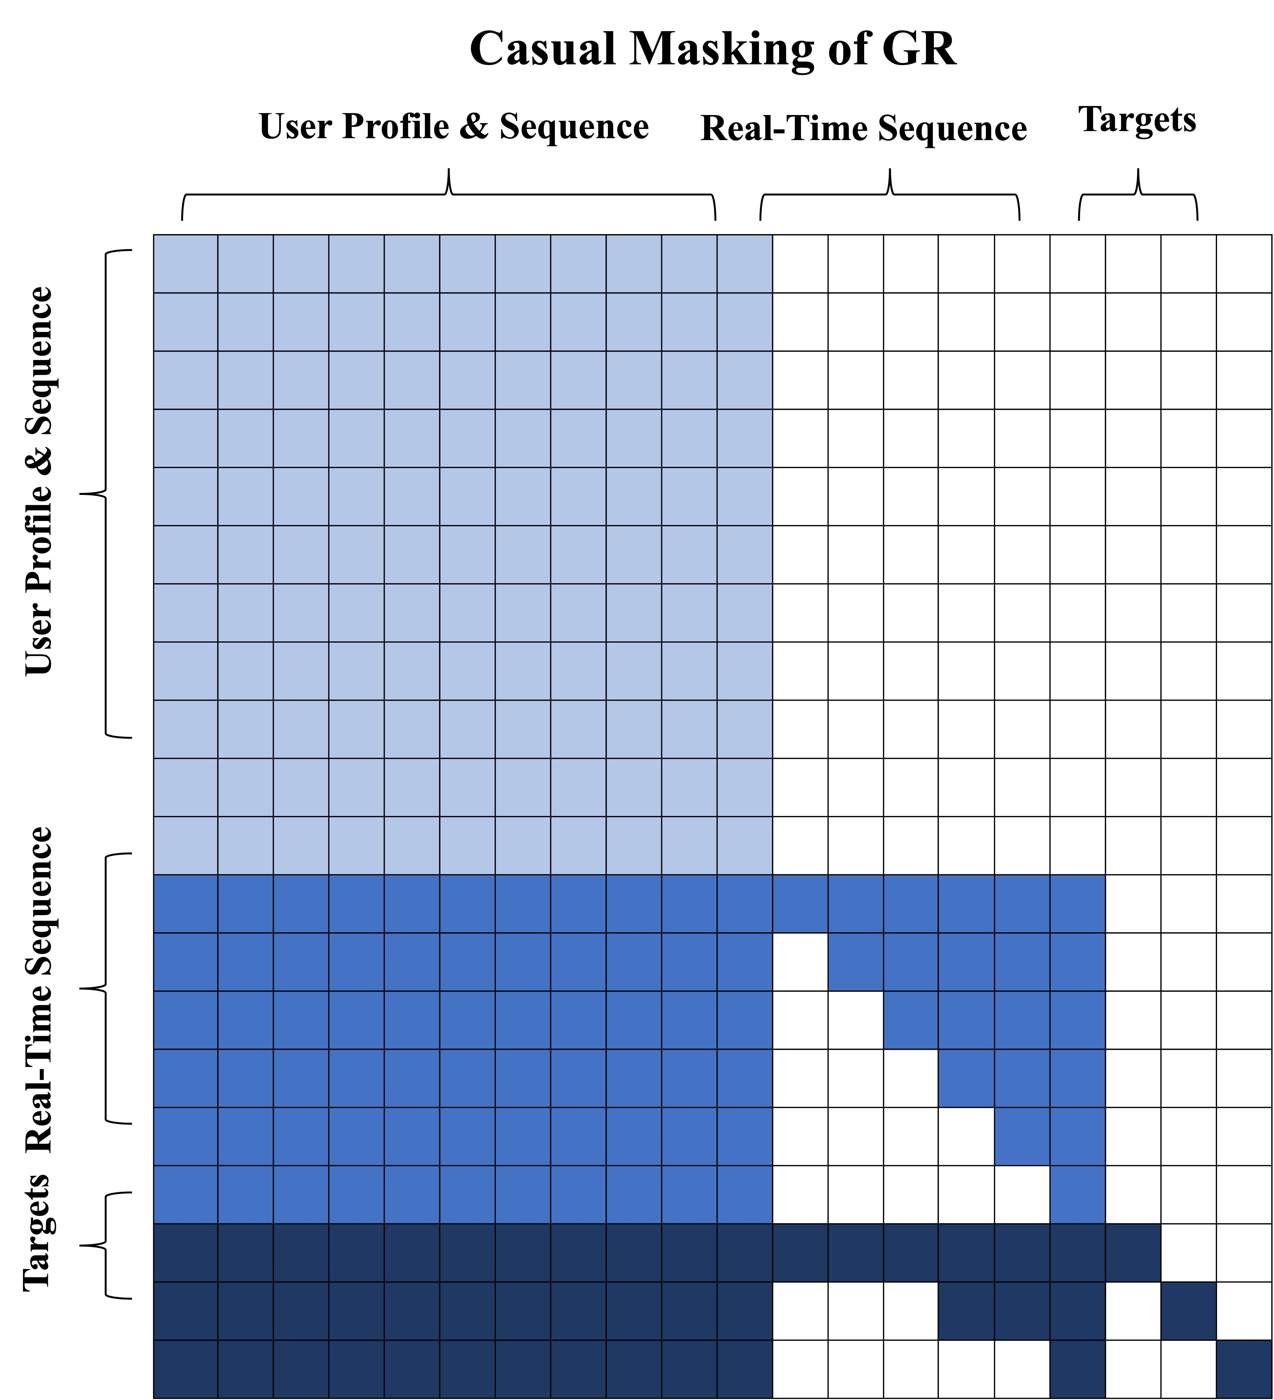
掩码把 token 分成三类,各用一种规则:
| token 类别 | 能看到什么 | 为什么这样设 |
|---|---|---|
| 历史画像和行为序列 | 彼此全部可见,看不到当天实时行为和曝光 | 这些都是今天之前的信息,不存在穿越 |
| 当天实时行为 | 全部历史,加上比自己更早的实时行为 | 因果掩码,配合时间戳过滤未来事件 |
| 待打分的曝光 | 全部历史,加上发生在自己之前的实时行为,曝光之间互不可见 | 保证较早的曝光看不到较晚的行为 |
按图中的例子,最晚的那个曝光能看到全部实时行为;较早的曝光,只能看到发生在它之前的那几个。和普通的因果掩码相比,动态混合掩码让 MTGR-small 的 CTR GAUC 提高 0.12 个百分点、CTCVR GAUC 提高 0.16 个百分点。原因是历史部分不必再按顺序遮挡,HSTU 可以像编码器一样双向读完整段历史。
计算量涨了 65 倍,训练成本怎么压住
这部分是博客最有工程价值的地方。训练引擎 MTGR-Training 基于 Meta 开源的 TorchRec,补了动态哈希表、梯度累积,稠密部分借用大模型社区的 FSDP、Megatron 这类模型并行方案。其中两项优化最关键。
一是手写算子。团队参照 FlashAttention 的思路写了基于 Cutlass 的融合 HSTU 算子,减少显存读写,并且直接支持变长序列,单算子比 Triton 版本快 2 到 3 倍。
二是变长序列的负载均衡。样本按用户组织,而用户序列长度是长尾分布:少数人很长,多数人很短。固定每卡 batch 大小时,分到长序列的卡要算很久,同步训练里其他卡只能干等。博客的做法是让每张卡的 batch 大小随序列长度变化,保证每卡的 token 总数基本相同,再按各卡的 batch 大小对梯度加权,保证结果和固定 batch 等价。博客的示意是两张卡、原本每卡 4 个用户,序列偏短的那张卡改成装 5 个用户,两张卡就都满载了。
训练成本对比(博客表 5,不做任何序列采样时,单天样本的训练开销):
| 模型 | 单样本前向计算量(GFLOPs) | 单天训练成本(GPU 小时) |
|---|---|---|
| DLRM 基线 | 0.86 | 42.6 |
| MTGR-small | 9.11 | 28.4 |
| MTGR-middle | 18.59 | 49.6 |
| MTGR-large | 55.76 | 89.6 |
这张表说明用户粒度压缩的威力:计算量是基线 10 倍的 small,训练反而更便宜;计算量 65 倍的 large,训练成本约为基线的 2.1 倍。博客说的“与 DLRM 持平”,是 large 再加上 GR 原论文的随机长度(Stochastic Length)采样之后的结果。这个做法是训练时对较长的用户序列随机抽一段子序列来缩短输入,线上打分仍用完整序列;作者称这样做离线和线上效果基本无损。
推理端用 TensorRT 加 Triton Inference Server。特征传输改成先在内存里拼成一整块、一次拷贝到 GPU 再拆开,这一步耗时从 7.5 毫秒降到 12 微秒,整体延迟从 19 毫秒降到 12 毫秒,吞吐提升 38%。CUDA Graph 让吞吐再涨 13%,改用 FP16 半精度推理让吞吐涨 50%,博客称精度几乎无损。最终推理资源反而省了 12%,原因是 MTGR 的推理开销对候选数量不敏感:DLRM 要把候选切成多片并行算来压延迟,MTGR 一片就够。可以这样理解:一次请求里,用户画像和上千个行为 token 只编码一次,所有候选共享这部分结果;候选 token 之间互不可见,多几十个候选只是多几十个 token,相比上千的行为序列增量很小。DLRM 的用户模块虽然也只算一次,但交叉模块和后面的网络要为每个候选单独过一遍,候选越多算得越多。
结果
三个尺寸的 MTGR 和线上最好的 DLRM(也就是“加大用户模块”那一版)对比(博客表 6):
| 模型 | 层数和宽度 | 计算量(GFLOPs) | 离线 CTR GAUC | 离线 CTCVR GAUC | 线上 PV_CTR | 线上 UV_CTCVR |
|---|---|---|---|---|---|---|
| MTGR-small | 3 层,512 维 | 9.11 | +0.36pp | +1.54pp | +1.04% | +0.04% |
| MTGR-middle | 5 层,768 维 | 18.59 | +0.71pp | +1.82pp | +2.29% | +0.62% |
| MTGR-large | 15 层,768 维 | 55.76 | +1.53pp | +2.88pp | +1.90% | +1.02% |
离线指标随尺寸单调上升,这是博客说“验证了 Scaling Law”的依据。线上的用户级下单转化率(UV_CTCVR)也是单调的,从几乎不变升到 1.02%。但页面级点击率(PV_CTR)并不单调,middle 比 large 还高 0.39 个百分点。large 和 small、middle 的序列最大长度也不同(1k 对 3k),所以三个点并不是只改了模型尺寸。
离线还试过 22 层、1024 维、计算量约为 DLRM 160 倍的模型,效果更好,但受推理性能限制没有上线。另外,DLRM 基线已在线上持续学习两年多,MTGR 只用了 2024 年 10 月之后约半年的数据。
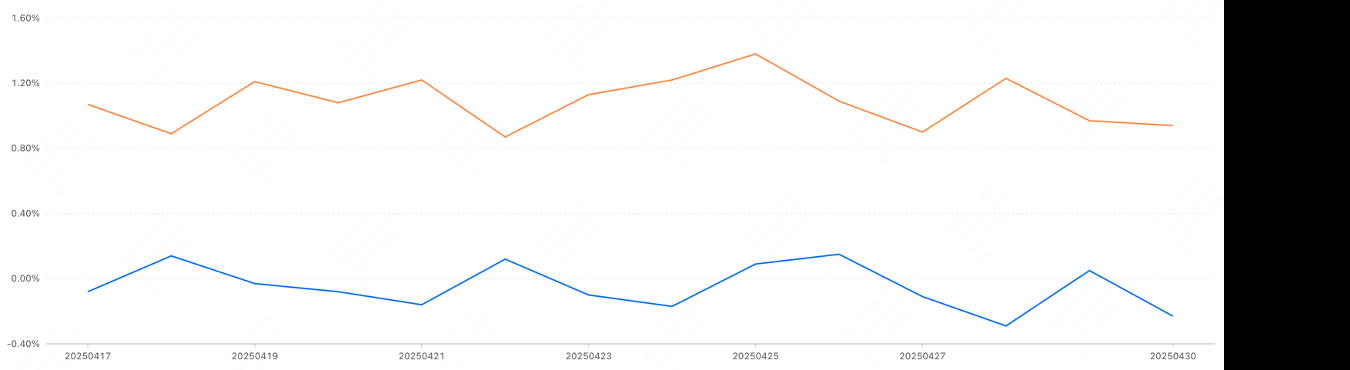
从 A/B 曲线看,MTGR-large 每天的订单提升在 0.9% 到 1.4% 之间,AA(空白对照)曲线在正负 0.3% 以内波动,两条线没有交叉,所以收益明显高于噪声。
局限
第一,这是技术博客,不是论文。消融只在 MTGR-small 上做、每项只报一个数字,看不出多次训练之间的波动范围。
第二,“Scaling Law”的证据比较薄。只有三个尺寸,而且 large 换了序列长度;线上点击率不随尺寸单调。更准确的说法是“三个尺寸下离线指标单调上升”。
第三,几个关键数字需要对着口径读。开头的订单量 +1.22% 来自 A/B 期间的订单曲线,表 6 里 large 的 UV_CTCVR 是 +1.02%,两者是不同指标。训练成本“持平”依赖随机长度采样,不采样时是 2.1 倍。
第四,收益里分不清有多少来自架构。MTGR 同时换了数据组织、编码结构、掩码,还加了 Group LayerNorm;表里只单独测了交叉特征、Group LayerNorm 和掩码三项。
一个排序团队可以怎么试
- 先改数据组织:把同一用户的曝光按天压成一行,并保存行为和曝光的时间戳。博客的数据表明,光这一步就能让 10 倍计算量的模型训练比原来更便宜。
- 换 HSTU 时保留交叉特征,把它们拼进候选 token。复购型业务尤其不要丢。博客里 small 去掉交叉特征后,CTR GAUC 掉了 1.25 个百分点,和 large 相对旧模型的全部 CTR GAUC 提升(1.53)差不多大。
- 按 token 类别设 Group LayerNorm,按“历史全可见、实时行为因果、曝光只看之前”设掩码。
- 先在 small 尺寸上把训练流水线和负载均衡跑通,再加深模型;上线前用 AA 曲线确认收益高于日常波动。
结论与评价
MTGR 最有价值的结论是:生成式架构可以和传统特征体系共存,在高复购的业务里,保留交叉特征比“纯序列”更重要;而用户粒度的数据压缩,是让计算量涨几十倍却不至于把训练成本翻几十倍的关键。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。传统排序模型加大后收益递减,是各家都遇到的问题 |
| 方法创新性 | 中。主体是 HSTU,新意在保留交叉特征、Group LayerNorm 和按时间戳的混合掩码 |
| 实验证据 | 中。有清楚的 A/B 曲线和资源账,但消融只在小模型上、每项一个数,Scaling 证据只有三个点 |
| 工程成本 | 高。需要变长算子、动态 batch、TensorRT 推理链路和按用户重组的数据流水线 |
| 是否值得尝试 | 值得,尤其是用户压缩和掩码设计可以单独借鉴 |
| 适用场景 | 用户行为序列长、复购多、交叉统计特征很重要的本地生活和电商推荐 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…