目录 · 9 节
1它到底在解决什么问题?2整体结构:三个分支加两条训练约束3第三个分支 EFGC:按业务把特征分组再交叉4分支互教:只在意见不一的样本上,由判对的带判错的5适度差异:两个分支的向量能"转"到彼此6这套方案真的更好吗?7我认为它的局限8一个推荐/搜索团队可以怎么试9结论
做排序的团队值得读,因为它指出了多分支模型一个常被忽略的浪费:各分支擅长的样本不同,训练时却从不互相学。CTR 模型常把几种特征交叉网络并排摆在一起,最后把各分支的输出平均或拼接,训练时各分支互不相干。淘宝拍立淘(拍照搜商品)团队让三个分支在训练中互相纠错:同一条样本上,一个分支判对了用户点不点、另一个判错了,就用判对那个的预测去带判错的那个。另加一项约束,要求一个分支的中间向量乘上一个正交矩阵(相当于换一套坐标轴)后,接近另一个分支的向量,这样两支可以各用各的坐标轴,但哪些样本彼此相似要保持一致。线上 A/B 中点击率从 10.37% 提到 10.46%,GMV 相对提升 1.62%。多分支的收益不只来自多放几个分支,还来自让它们在彼此出错的样本上互相纠正。
我会建议做精排的同学花半小时读完。理由有两条:两条训练约束都只是加在损失里的项,不改线上推理结构;论文还附了损失函数的 TensorFlow 代码,复现门槛低。要打折扣的地方也很清楚:线上收益里混着一个新分支的贡献,后面会拆开说。
它到底在解决什么问题?
DCNv2 这类模型有两个分支:一个 MLP 隐式学交叉,一个 CrossNet 显式学交叉,最后把两边结果合起来。两边各练各的,合并时也只是平均或拼接。问题在于,不同分支擅长的样本并不一样。
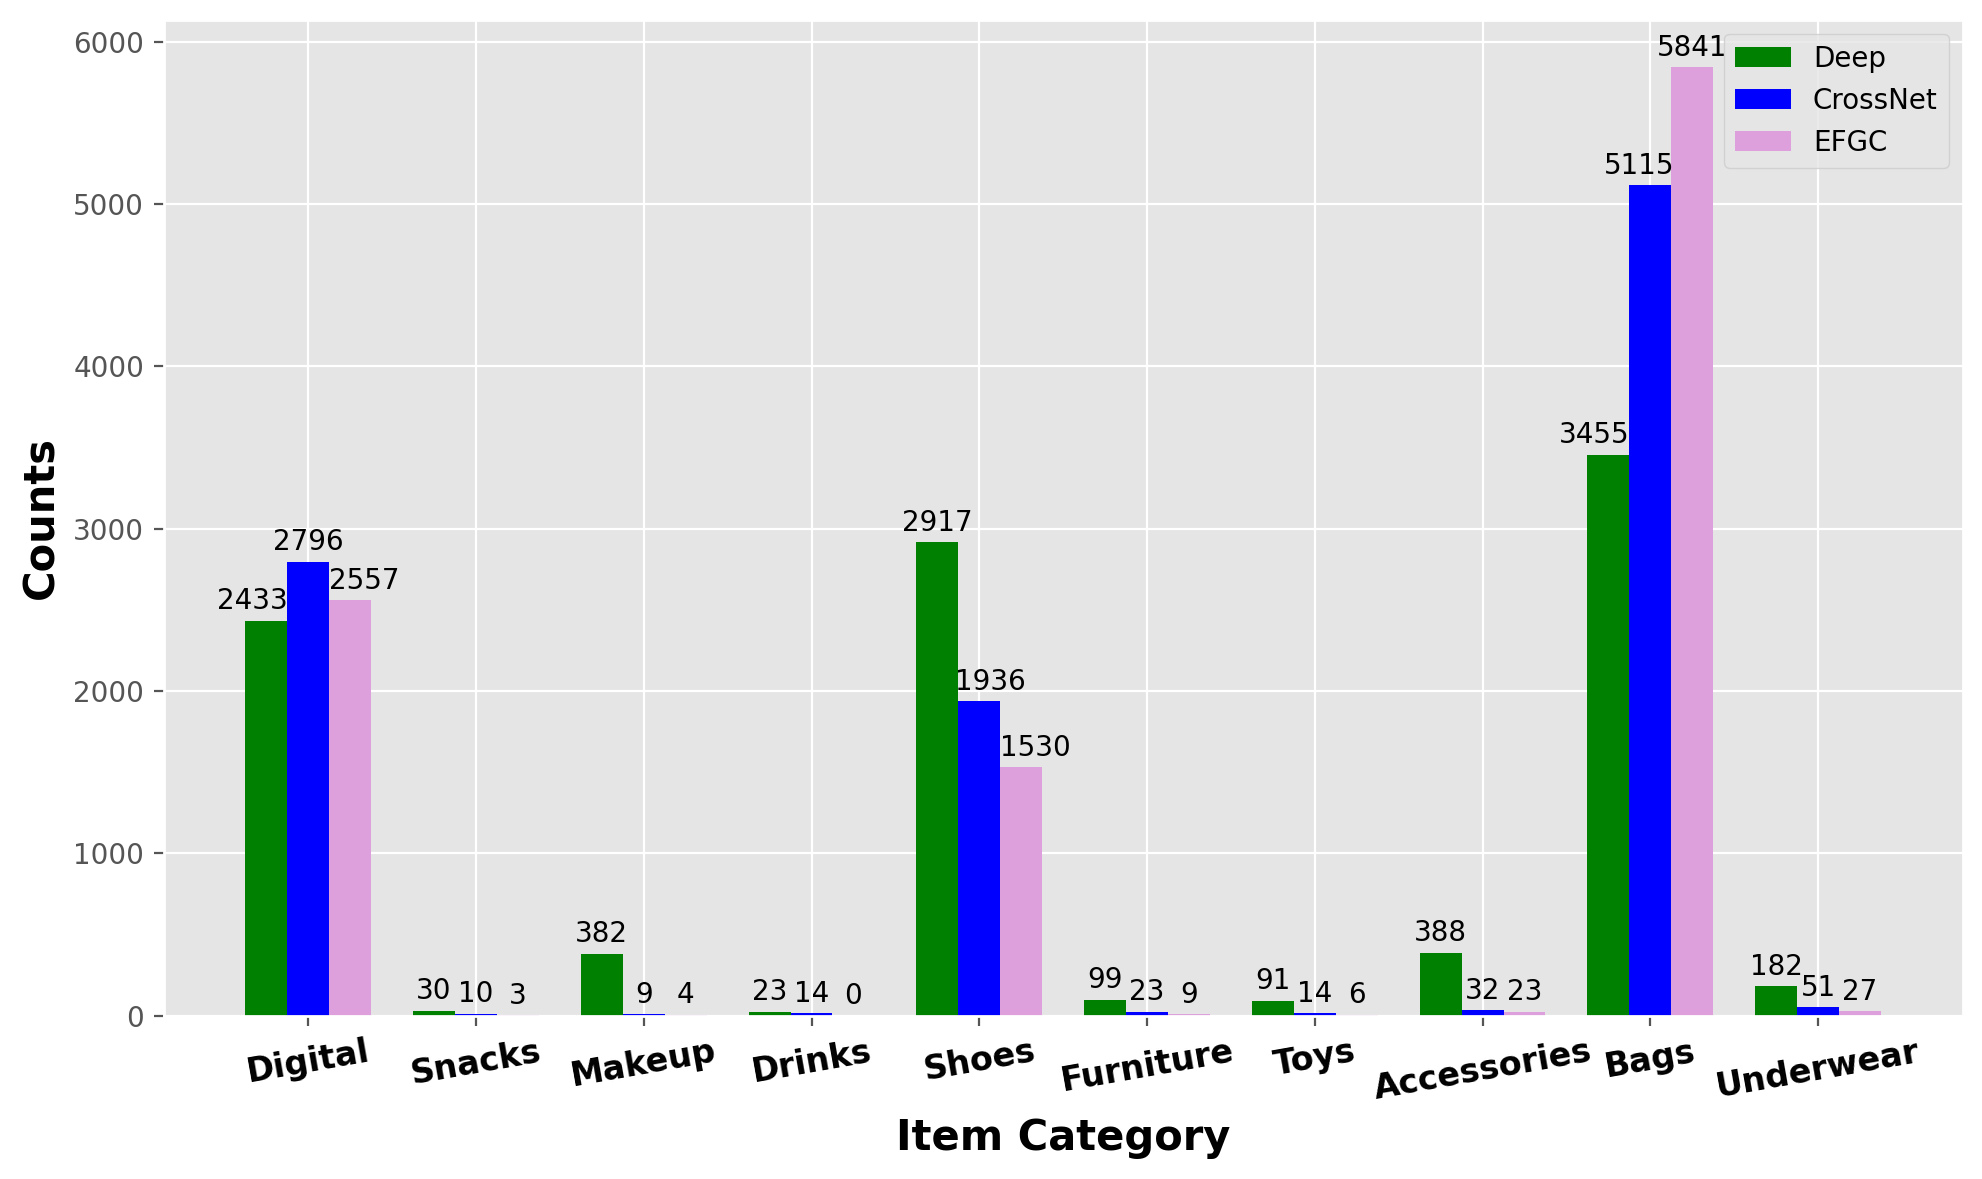
论文在拍立淘数据上做了一个直观的统计:每个分支各挑出预测最准的 1 万条样本(logloss 最低),看它们落在哪些类目。下图里的 EFGC(论文新加的分支,按业务把特征分组再交叉,后面细讲)是三个分支之一。箱包类在 EFGC 分支里有 5841 条,在 Deep 分支里只有 3455 条;鞋类反过来,Deep 有 2917 条,EFGC 只有 1530 条。也就是说,同一份数据上,不同分支学得好的样本是两拨人。
用一个示意的例子把问题演一遍。用户拍了一张包的照片,排序模型要给三件候选商品打点击率:
| 候选(示意) | 真实是否点击 | Deep 预测 | CrossNet 预测 | EFGC 预测 | 三支平均 |
|---|---|---|---|---|---|
| 同款黑色托特包 | 点击 | 0.30 | 0.35 | 0.70 | 0.45 |
| 相似款棕色包 | 未点击 | 0.60 | 0.55 | 0.20 | 0.45 |
| 包挂件 | 未点击 | 0.10 | 0.10 | 0.05 | 0.08 |
前两行里,只有 EFGC 判对了,另外两支都判反了。直接平均后,两件商品分数一样,排不出先后。更麻烦的是训练时,Deep 和 CrossNet 只能从真实标签里学,看不到"旁边那个分支在这条样本上已经对了"。论文要做的,就是把这个信号用起来。
整体结构:三个分支加两条训练约束
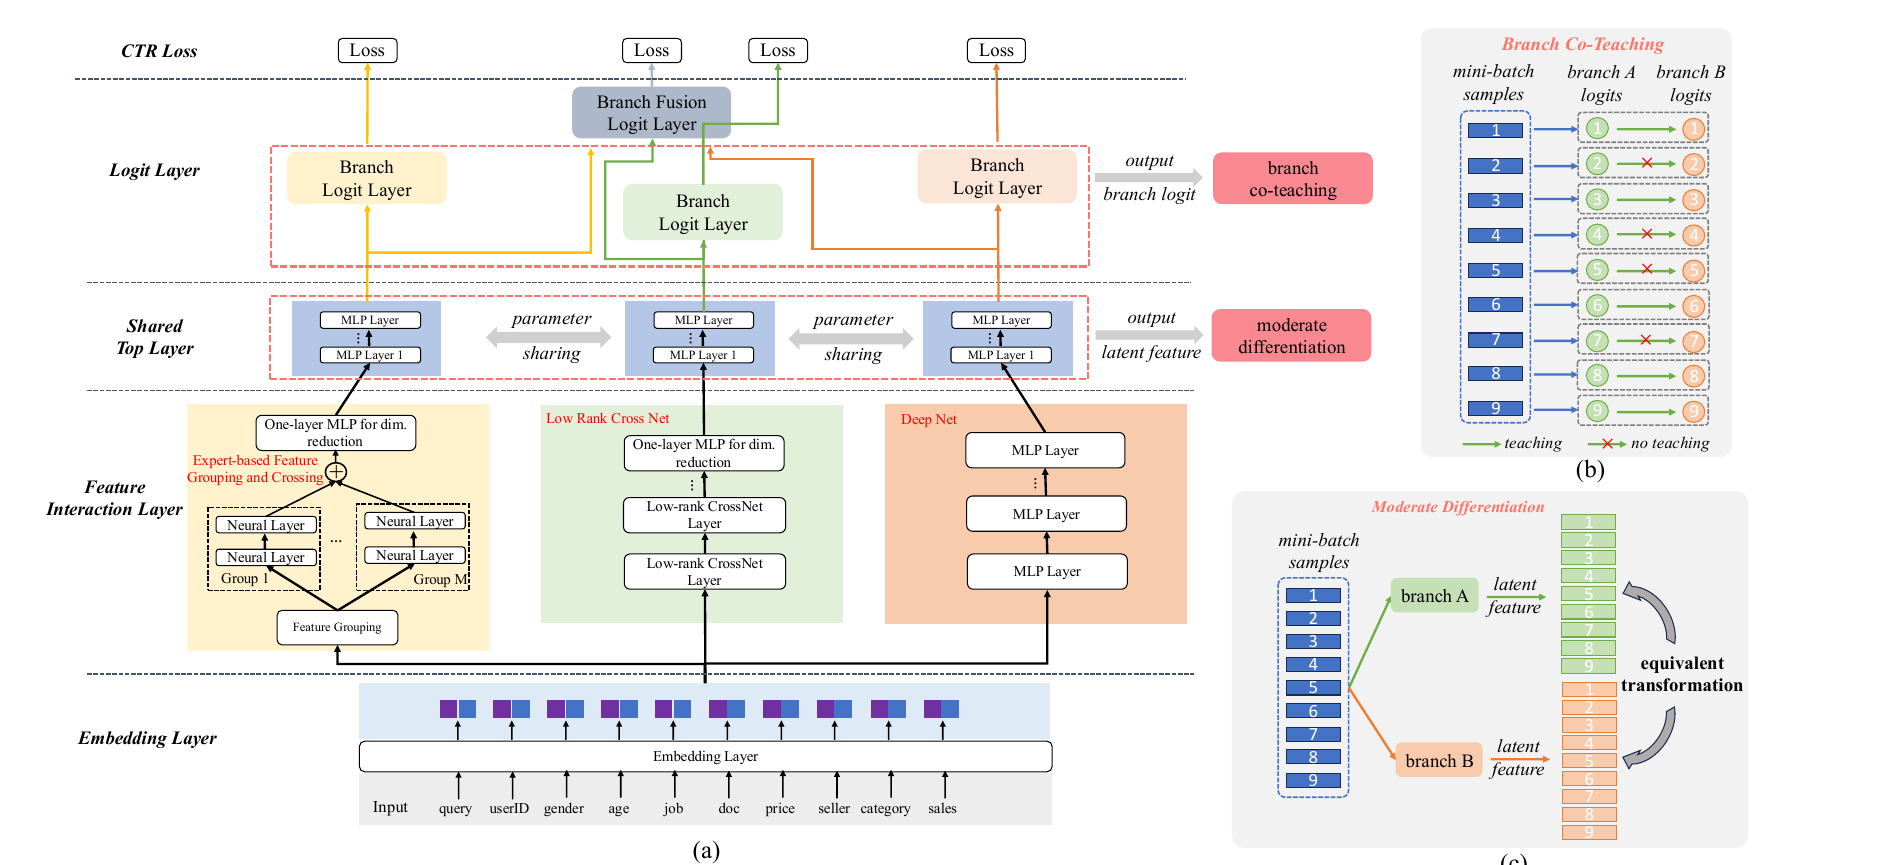
整条流程可以概括成下面这张表:
| 步骤 | 输入 | 产出 |
|---|---|---|
| embedding 层 | 192 个特征域 | 每个域一个 embedding |
| 三个分支 | EFGC 吃分好组的 embedding,Deep 和 CrossNet 吃全部拼接 | 三个分支各一个向量 |
| 共享顶层 | 三个分支向量,用同一套 MLP 参数 | 三个 128 维向量,处在同一个空间 |
| logit 层 | 每个分支各有一个,另有一个吃三支平均后的向量 | 四个点击概率 |
| 训练损失 | 四个概率、三个向量、真实标签 | 四个 BCE + 分支互教 + 适度差异 |
最终打分用的是融合 logit 层的输出:三支的向量先取平均,再过这一层,论文的融合就是为了做最终预测。其余三个分支各自的概率只用于训练。
关键分工是:三个分支负责学不同的交叉方式,两条额外损失负责让它们在训练中互相影响。下面拆开讲。
第三个分支 EFGC:按业务把特征分组再交叉
为什么要再加一个分支?Deep 和 CrossNet 都把 192 个域的 embedding 一股脑拼起来,任意两个域之间都可能学出交叉。可很多交叉没用,比如商品标题和商品类目放一起,对个性化排序帮助不大。
EFGC 先由人按业务挑出想强调的匹配关系,再把对应的域分到一组,只在组内交叉。拍立淘一共设了 7 组,例如:query 图片和商品图片一组,学视觉上像不像;用户画像和商品属性一组,学用户偏好什么价位、什么品牌;userID 和 itemID 一组,学个人对具体商品的偏好。每组拼接后送进自己的一个两层 MLP,7 组的输出再拼起来,经一层全连接降维。
一个小例子:假如用户画像里有"消费档次=中",商品属性里有"价格=300 元",这两个域只要分在同一组,这组的 MLP 就专门学"中档用户对 300 元商品点不点"。它们不会被另外 190 个域稀释。作者也说明了它和人工特征工程的区别:特征工程造出新的输入特征,比如用户对某品牌的点击次数;EFGC 不造特征,只规定谁和谁交叉,交叉的形式由 MLP 学。
分支互教:只在意见不一的样本上,由判对的带判错的
为什么不直接让分支互相蒸馏?因为训练早期每个分支都还不准,在所有样本上互相当老师,等于互相灌噪声。论文的做法是先按样本挑出"一个对、一个错"的情况,只在这些样本上教。
怎么判对错?每个分支在每条样本上都有一个点击概率 p,和真实标签算 BCE。BCE 小于 −log(0.5),约 0.693,就算这个分支在这条样本上学好了。这个阈值换个说法就是:预测站在 0.5 的哪一边,和真实标签一致就算对。
判定是按每条样本、每一对分支、每一步训练重新做的,没有固定的老师。三个分支两两成对,共三对。对每一对,如果一支对、另一支错,就用对的那支的概率当软标签,对错的那支算一个交叉熵;对的那支的概率当软标签时不回传梯度,这一项损失只沿错的那支的输出往回更新。不过三支共用 embedding 和顶层,这次更新仍会间接影响对的那支之后的预测。两支都对或都错的样本,这一对不产生互教损失,各学各的。最后按被选中的分歧对数取平均。 Hoot 说

- 阈值 0.693:−ln 0.70 ≈ 0.357 小于它,EFGC 算对;−ln 0.30 ≈ 1.204 大于它,Deep 算错,所以这条样本由 EFGC 教 Deep。
用的是正文示意表第一行:点击样本,EFGC 给 0.70、Deep 给 0.30(示意)。 出处: 论文 §3.4.1 式 10–12(stop gradient、−log(0.5) 阈值)、§3.3 式 8(共享顶层)、附录 D 代码
用上面示意表的第一行算一遍(数字是示意):真实是点击,EFGC 给 0.70,BCE = −ln 0.70 ≈ 0.357,小于 0.693,算对;Deep 给 0.30,BCE = −ln 0.30 ≈ 1.204,大于 0.693,算错。于是 Deep 在这条样本上多一个目标:把预测往 0.70 拉。第三行的包挂件,三支都给了 0.1 以下,都算对,这条样本不参与互教。
这里有一个值得读者自己推一下的地方:拍立淘的点击率在 10% 左右,大多数样本是未点击,各分支通常都给低于 0.5 的分数,都算对。所以互教真正起作用的样本,主要是某个分支把未点击的样本打到 0.5 以上,或者把点击样本打对了而另一支没打对的少数情况。这是我按阈值的定义推出来的,试用时值得先统计一下被选中样本的比例。
适度差异:两个分支的向量能"转"到彼此
为什么还要这一条?三个分支用同一个标签、同一批样本训练,很容易越学越像,最后三支给出几乎一样的向量,多分支就白放了。可如果硬把它们推远,又会破坏它们共有的、对预测有用的那部分信息。
论文的办法是:给每一对分支学一个 128×128 的矩阵 W,要求一个分支的向量乘上 W 后接近另一个分支的向量,同时要求 W 近似正交,也就是 W 的转置就是它的逆。损失写成:
其中 、 是同一条样本在两个分支共享顶层后的向量,K 是分支数(这里是 3)。第一项要求 经变换后对上 ,第二项要求变换过去再转回来还是原来的 。这一项只在实际出现的样本向量上检查,所以 W 是在这些向量上近似正交,不是严格的全空间正交。
注意它不是要求两支的向量相互垂直,也不是直接把它们拉近。正交矩阵相当于换一套坐标轴:两个分支可以各用各的坐标轴,但同一个 W 要对一个 batch 里所有样本都成立。拿两条样本 A、B 举个示意的二维例子:在分支 1 里 A=(1,0)、B=(0,1),在分支 2 里 A=(0,1)、B=(−1,0),把分支 1 整体转 90 度就完全对上,损失为 0,虽然两支的数值完全不同。如果分支 2 里 A 和 B 都是 (0,1),那么任何旋转都不可能同时对上两条样本,损失就大于 0。它约束的是样本之间谁和谁相似要一致,坐标怎么摆由各分支自己定。论文给出的理由正是正交变换保持向量内积,在 W 近似正交的范围内,这个性质近似成立。
要说清的是,这条损失本身不会把两支推开:两支完全相同、W 取单位矩阵时,损失也是 0。它的作用是放宽,和直接要求两支向量相等比,它允许两支差一个旋转。分支之间的差异,论文归因于三支结构不同,以及互教只在分歧样本上发生。论文给的佐证是训练收敛后 W 和单位矩阵的距离一直不为 0,作者把它读作各分支保持了差异。但这条约束只在样本向量上起作用,W 偏离单位矩阵并不能直接证明两支向量不同,更直接的检查是看两支向量本身的距离。这条约束的权重只有 0.1。
三个分支的 BCE、融合输出的 BCE,加上 0.1 倍的互教损失和 0.1 倍的适度差异损失,一起端到端训练,不需要预训练老师。
这套方案真的更好吗?
离线实验用拍立淘 12 个月和 24 个月两份数据,最大的一份有 3959.9 亿条样本,最后 7 天做验证和测试。主结果(AUC 越高越好):
| 模型 | 12 个月 AUC | 24 个月 AUC |
|---|---|---|
| DNN | 0.7423 | 0.7569 |
| DCNv2 | 0.7461 | 0.7559 |
| EnKD | 0.7450 | 0.7541 |
| FinalMLP | 0.7427 | 0.7556 |
| 只用 EFGC | 0.7490 | 0.7600 |
| MBCnet | 0.7522 | 0.7642 |
在 24 个月数据上,最强的基线是单个 DNN,比 DCNv2 和 FinalMLP 还高。这说明数据量足够大时,花哨的交叉结构不一定占优;MBCnet 仍是表中最高的 0.7642。只用 EFGC 一个分支就已经超过所有基线,说明按业务分组本身就有用。
消融更能说明两条损失各自的作用。在 12 个月数据上,两条损失都去掉时 AUC 是 0.7443,只去掉互教是 0.7510,只去掉适度差异是 0.7506,都加上是 0.7522。两条损失单独都有贡献,一起去掉掉得最多。
方向比有没有更要紧。论文把互教改成"所有样本都互教",AUC 掉到 0.5772;改成"错的教对的",掉到 0.4933,比随机还差。把适度差异改成"尽量拉远"或"尽量拉近",AUC 分别是 0.7176 和 0.7285,都低于完整版的 0.7522。老师必须是在这条样本上判对的那一支,反过来教会把模型带坏。
线上 A/B 的基线是此前在线的 DCNv2,用 24 个月数据训练。点击率从 10.37% 到 10.46%,按 query 统计的成交笔数相对 +1.49%,GMV 相对 +1.62%。新增的 EFGC 分支多了 220 万参数,延迟只多了 1ms,GPU 使用率多 2%。互教和适度差异只在训练时计算,所以线上成本主要就是这一个分支。2024 年 8 月起已全量上线。
我认为它的局限
第一,线上收益分不清来源。线上基线 DCNv2 只有两个分支,MBCnet 多了 EFGC 又多了两条损失。离线 24 个月数据上,三个分支都在、只去掉两条损失时 AUC 是 0.7609,加上后是 0.7642;保留两条损失、去掉 EFGC 分支是 0.7548。离线看两部分都有贡献。A/B 没有单测"DCNv2 + 两条损失",没法知道只加损失能拿到多少线上收益。
第二,几组对照数字不太正常。"所有样本都互教"的 AUC 只有 0.5772,"错的教对的"只有 0.4933,远低于单个 DNN 的 0.7423。论文对全样本互教的解释是会引入噪声监督,但 AUC 跌到这个程度,更像是这两种改法让训练崩了,所以它们不太算公平的对照。另外在 24 个月数据上,两条损失都去掉是 0.7609,反而比只去掉适度差异的 0.7603 高,两条损失的贡献在大数据上不太稳定。
第三,只在拍立淘私有数据上测过,没有公开数据集结果。判对判错的阈值固定在 0.5,而这个场景点击率只有 10% 左右,换到点击率更低的场景,被选来互教的样本会怎么变,是试用前要先弄清的事。
一个推荐/搜索团队可以怎么试
- 先在现有的双分支模型(比如 DCNv2)上只加互教损失,权重从 0.1 起。这一步不改结构、不增加线上成本,看离线 AUC 是否稳定提升。
- 同时记录每个 batch 里被选中互教的样本比例。如果比例极低,说明阈值 0.5 在你的点击率下几乎不起作用,再考虑调阈值。
- 再加适度差异损失,同时画出 W 和单位矩阵的距离,以及两支向量之间的距离。如果 W 一直贴着单位矩阵、两支向量的距离也接近 0,说明分支学成了一样。
- 最后才考虑加一个按业务分组的 EFGC 分支。这一步要人工设计分组,线上多一个分支的开销,收益也要单独做 A/B 才能分清。
结论
最值得带走的一点:多分支模型的分支之间不该只在最后平均一下,可以在训练时按样本挑出分歧,让判对的去教判错的。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。多分支 CTR 模型很常见,分支之间怎么配合确实少有人讨论 |
| 方法创新性 | 中。互教和正交变换都有先例,新在按分歧挑样本、组合用在 CTR 分支上 |
| 实验证据 | 中。数据规模大、有线上 A/B,但只有私有数据,部分对照数字异常 |
| 工程成本 | 低。两条损失只在训练时算;EFGC 分支线上多 1ms |
| 是否值得尝试 | 值得。先只加互教损失,成本最低,最容易验证 |
| 适用场景 | 已有多个并行分支的精排模型,电商搜索和推荐都适用 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…